🧠 关键要点
要推断 RNA 速率(RNA velocity),所研究发育过程的时间尺度必须与 RNA 分子的半衰期相当。胰腺内分泌发生满足这一条件,而阿尔茨海默病或帕金森病等长期疾病则不满足。同样,RNA velocity 分析也不适用于缺乏(成熟)细胞类型间转变的稳态系统,例如外周血单个核细胞(Peripheral Blood Mononuclear Cells, PBMCs)。
只有当底层模型假设(大致)成立时,才能稳健、可靠地推断 RNA velocity。可以检查相图(phase portrait)是否呈现预期的杏仁形,以验证这些假设。若某个基因包含多段明显不同的动力学,应谨慎开展 RNA velocity 分析,并可能需要按单条谱系对数据取子集。
传统上,人们将高维 RNA velocity 向量投影到数据的低维表示上进行可视化。然而,用这种方式验证假设可能出错并产生误导,因为投影得到的速度流高度依赖于:(1) 纳入的基因数量;(2) 所选的绘图参数。此外,低维嵌入(embedding)边界处的投影质量会下降。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: rna_velocity
channels:
  - defaults
  - conda-forge
dependencies:
  - conda-forge::python=3.13
  - conda-forge::ipykernel=7.2.0
  - conda-forge::scvelo=0.3.3
  - pip
  - pip:
      - lamindb
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
单细胞数据集使我们能够以高分辨率研究早期发育等生物学过程。不过,由于分析的是单细胞而非整个组织,例如细胞表型特征随时间的变化就无法被追踪。这一点源于单细胞测序方案的破坏性:一个细胞一旦被测序就会被破坏,因此无法在之后的时间点再次测量它的特征。值得注意的是,实验技术不仅无法在不同时间测量细胞的总体谱,也无法测量这些变化发生的快慢。要恢复细胞在发育全景中所处的时间位置,可以借助 轨迹推断(Trajectory Inference, TI)。然而,经典 TI 方法不提供有方向的动态信息,通常也不利用转录组 读段(Read) 和相似性之外的信息。
对 RNA velocity 建模
细胞转录组谱的变化由一连串事件触发。概括而言,DNA 经转录产生未剪接前体 mRNA(precursor messenger RNA, pre-mRNA)。未剪接的 pre-mRNA 既包含参与翻译的外显子(exon),也包含不编码蛋白质的内含子(intron)。这些非编码区域会经历剪接, 即被移除并形成已剪接的成熟 信使 RNA(messenger RNA, mRNA)。虽然单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)方案无法在多个时间点捕获转录组,但其中包含区分未剪接与已剪接 mRNA Read 所需的信息 Manno et al., 2018Srivastava et al., 2019He et al., 2022Melsted et al., 2021。
识别未剪接与已剪接 Read 后,就可以建立描述剪接动力学(splicing kinetics)的动态模型 Zeisel et al., 2011 并基于单细胞数据推断相应的模型参数。模型描述的已剪接 RNA 变化称为 RNA 速率(RNA velocity)Manno et al., 2018。目前的 RNA velocity 模型假设以下基因特异的模型
其中转录速率(transcription rate)为 、剪接速率(splicing rate)为 ,已剪接 RNA 的降解速率(degradation rate)为 。虽然每个基因的动力学彼此独立建模,但为简化记号,下文将略去下标 。
为什么未剪接 Count 能揭示细胞的未来状态
已剪接 mRNA 反映细胞当前表达什么。未剪接 Count 则提供方向信息,因为转录本总是先处于未剪接状态,随后才被剪接。
这些方程描述了一个“队列”:转录以 的速率填充未剪接 RNA 池;剪接以 的速率将其转入已剪接 RNA 池;降解再以 的速率清空该 RNA 池。如果不受扰动,两个 RNA 池会趋于固定比例。刚开启表达的基因会积累多于该比例所允许的未剪接转录本,其已剪接水平即将上升;刚关闭表达的基因则会出现相反的短缺。RNA velocity 正是相对于这一比例的偏离。
尽管动力系统的参数估计已有充分研究,但传统推断算法要求每个观测的时间已知,因此无法用于从 scRNA-seq 数据推断 RNA velocity 及其模型参数。
参数推断
单细胞测量是快照数据,因此无法相对时间作图。相反,经典的 RNA velocity 方法依赖于研究每个细胞特异的二元组(tuple) ,即每个基因的未剪接与已剪接 RNA。这些二元组的集合构成相图(phase portrait)。若转录、剪接和降解速率均为常数,相图会呈杏仁形:上弧对应诱导阶段,下弧对应抑制阶段。然而,真实数据含有噪声,直接绘制未剪接 Count 与已剪接 Count 的关系无法恢复预期的杏仁形,因此需要先平滑数据。传统做法是在细胞间相似性图上,对每个细胞邻域内的基因表达取平均。
稳态模型
估计 RNA velocity 的第一种尝试,假设基因之间相互独立,且底层动力学由上述模型支配。此外,它还假设:(1) 动力学已达到平衡,(2) 速率为常数,(3) 所有基因共享同一个剪接速率。下文中,我们将把这一模型称为 稳态模型(steady-state model)(因为第一个假设)。稳态本身位于相图的右上角(诱导阶段)及其原点(抑制阶段)。基于这些极端分位数, 稳态模型 用线性回归(linear regression)拟合来估计稳态比值。RNA velocity 随后被定义为相对于该拟合的残差。
尽管 稳态模型 能在某些系统中成功恢复发育方向,但其能力本质上受模型假设限制。最容易不成立的两个假设是:所有基因共享同一剪接速率,以及实验期间能够观测到平衡态。在这些情况下,推断结果会出错。此外, 稳态模型 只考虑了数据的一个子集,而且只推断稳态比值,并不推断每个模型参数。
EM 模型
为了克服 稳态模型的局限性,人们提出了若干扩展。其中最常用的是 期望最大化(expectation-maximization, EM) 模型,已在 scVelo 中实现 Bergen et al., 2020。 EM 模型 不再假设系统已达到稳态,也不再假设各基因共享同一剪接速率。此外,它利用所有数据点推断完整参数集,以及剪接模型中基因和细胞特异的潜在时间(latent time)。该算法使用 EM 框架估计参数。期望步(expectation step, E-step)中的未观测变量是每个细胞的时间和状态(诱导、抑制或稳态),其余模型参数均在 最大化步(maximization step, M-step)中推断。
虽然 EM 模型 不再依赖 稳态模型 的关键假设,因而适用范围更广,但推断出的 RNA velocity 仍可能与既有生物学知识相违背 Bergen et al., 2021,Barile et al., 2021。造成这种失败的原因主要有两方面:一方面, EM 模型 仍然假设速率为常数。因此,一旦这些假设不成立——例如在红系成熟过程中—— Barile et al., 2021,推断就会出错。另一方面,所提出的模型和它的前身一样,依赖于相图。因此,只要基因的相图不符合预期形状,该算法本质上就不适用、会失效。
胰腺内分泌发生中的 RNA velocity 推断
为了给出一个如何推断 RNA velocity 的实际例子,我们分析胰腺中的内分泌发育过程 Bastidas-Ponce et al., 2019。在该系统中,前内分泌细胞(Ductal,Ngn3 low EP,Ngn3 high EP,Pre-endocrine)可发育为四类内分泌细胞(Alpha,Beta,Delta,Epsilon)。这里,我们使用 scVelo Bergen et al., 2020 来推断 RNA velocity。
环境设置
import warnings

warnings.filterwarnings("ignore", category=DeprecationWarning)
import lamindb as ln
import scanpy as sc
import scvelo as scv
ln.track("LNBj60hdG1tm")→ loaded Transform('LNBj60hdG1tm0000', key='rna_velocity.ipynb'), re-started Run('epuf25HOG55kJ58q') at 2026-02-16 22:06:34 UTC
→ notebook imports: lamindb==2.1.2 scanpy==1.11.5 scvelo==0.3.3
常规设置
scv.settings.set_figure_params("scvelo")数据加载
要使用 scVelo 推断 RNA velocity,需要将未剪接和已剪接 Count 存入 AnnData 的 layers 槽。建议传入完整 Count, 即未经处理的数据,交由 scVelo 流程。
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="trajectory/rna_velocity.h5ad", is_latest=True
)
adata = af.load()
adata
AnnData object with n_obs × n_vars = 3696 × 27998
obs: 'clusters_coarse', 'clusters', 'S_score', 'G2M_score'
var: 'highly_variable_genes'
uns: 'clusters_coarse_colors', 'clusters_colors', 'day_colors', 'neighbors', 'pca'
obsm: 'X_pca', 'X_umap'
layers: 'spliced', 'unspliced'
obsp: 'distances', 'connectivities'数据预处理
由于 scRNA-seq 数据噪声大且稀疏,必须先对数据做预处理,才能用以下方法推断 RNA velocity: 稳态 或 EM 模型。第一步,我们过滤掉在未剪接和已剪接 RNA 中都表达不足的基因(这里将最低 Count 阈值设为 20)。接着,对未剪接和已剪接 RNA 分别做细胞大小归一化(normalization),相应 Count 存放在 adata.X 中,并做 log1p 变换以减小离群值的影响。接下来,我们还会识别并筛选高变基因(highly variable gene, HVG)(这里选取的基因数为 2000)。
scv.pp.filter_and_normalize(adata, min_shared_counts=20, n_top_genes=2000)Filtered out 20801 genes that are detected 20 counts (shared).
Normalized count data: X, spliced, unspliced.
Extracted 2000 highly variable genes.
Logarithmized X.
/Users/seohyon/miniconda3/envs/rna_velocity/lib/python3.11/site-packages/scvelo/preprocessing/utils.py:705: DeprecationWarning: `log1p` is deprecated since scVelo v0.3.0 and will be removed in a future version. Please use `log1p` from `scanpy.pp` instead.
  log1p(adata)
到目前为止,数据预处理与经典的 scRNA-seq 流程类似。对于 RNA velocity,我们还会额外用每个细胞邻域内的平均表达对观测做平滑。这一步可以使用 scVelo 的 moments 函数。
sc.tl.pca(adata)
sc.pp.neighbors(adata)
scv.pp.moments(adata, n_pcs=None, n_neighbors=None)
computing moments based on connectivities
finished (0:00:00) --> added
'Ms' and 'Mu', moments of un/spliced abundances (adata.layers)
在典型流程中,我们会对数据聚类、推断细胞类型,并在二维嵌入(embedding)中把数据可视化。幸运的是,对于胰腺数据,这些信息已经提前算好,可以直接使用。
scv.pl.scatter(adata, basis="umap", color="clusters")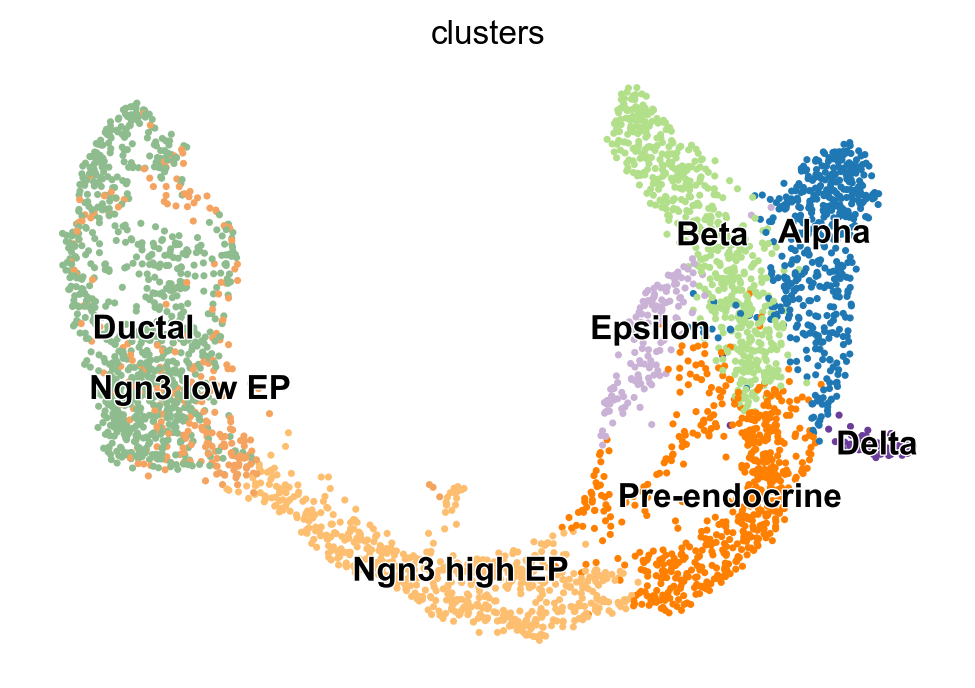
RNA velocity 推断—— 稳态模型
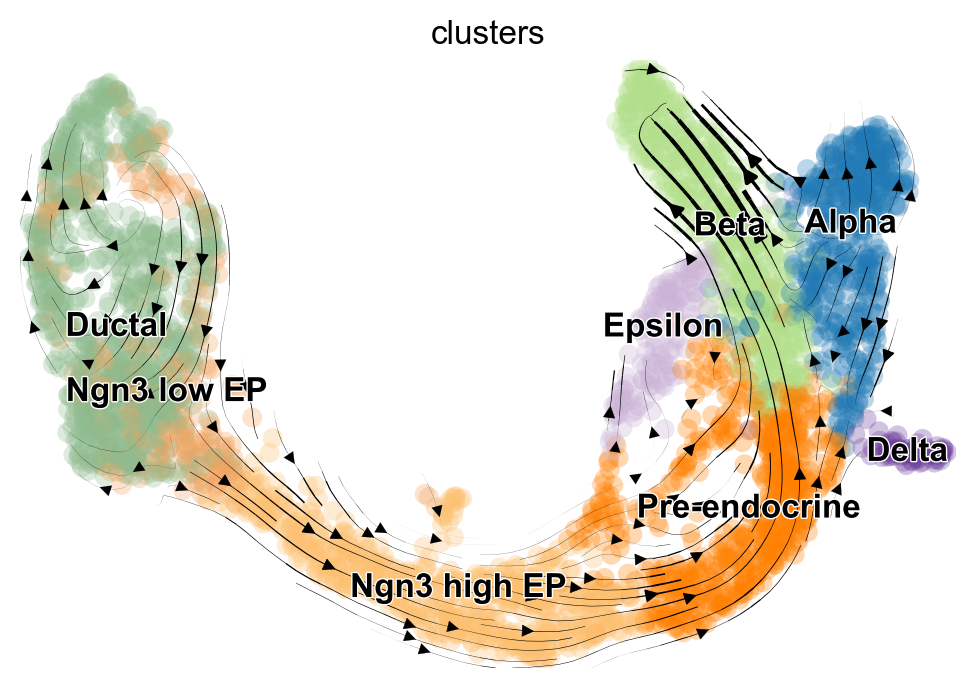
第一步,我们在稳态模型下计算 RNA velocity。在这种情况下,我们调用 scVelo 的 velocity 函数,并设置 mode="deterministic"。
scv.tl.velocity(adata, mode="deterministic")computing velocities
finished (0:00:00) --> added
'velocity', velocity vectors for each individual cell (adata.layers)
尽管我们并不鼓励对“把高维速度向量投影到数据低维表示上”的结果做过度解读,scVelo 提供了一种便捷的实现方式。
scv.tl.velocity_graph(adata, n_jobs=8)
scv.pl.velocity_embedding_stream(adata, basis="umap", color="clusters")
computing velocity graph (using 8/8 cores)
finished (0:00:16) --> added
'velocity_graph', sparse matrix with cosine correlations (adata.uns)
computing velocity embedding
finished (0:00:00) --> added
'velocity_umap', embedded velocity vectors (adata.obsm)
RNA velocity 推断—— EM 模型
要使用 EM 模型,首先要推断剪接动力学参数;这一步由 scVelo 的 recover_dynamics 函数完成。此步骤可能需要一些时间。
scv.tl.recover_dynamics(adata, n_jobs=8)recovering dynamics (using 8/8 cores)
finished (0:02:11) --> added
'fit_pars', fitted parameters for splicing dynamics (adata.var)
剪接模型的参数是通过最大化某个似然来推断的。为了研究 scVelo 最有把握地拟合了哪些基因,我们可以考察相应的相图,以及推断出的轨迹(用紫色绘制)和稳态比值(紫色虚线)。这里,所示五个基因中有三个(Pcsk2,Top2a,Ppp1r1a)的相图呈现(部分)杏仁形。我们观察到明显的转变,要么发生在单一细胞类型内部(Top2a,Ppp1r1a),要么发生在多个细胞类型之间(Pcsk2,从 Pre-endocrine 到 Alpha 和 Beta)。而对于 Nfib,我们观察到两个细胞群处于稳态。这很可能是对 Ngn3 low/high EP 细胞周围的表型流形采样不足所造成的假象。同样,Ghrl 在 Epsilon 细胞中高表达,尽管由于该聚类很小,这样的细胞只有少数几个。虽然目前的最佳实践仅限于手工分析模型拟合及其可信度,但最近提出的方法有助于把这一过程自动化(见“新方向”)。在这里,Nfib 和 Ghrl 会被赋予较低的置信度分数。
top_genes = adata.var["fit_likelihood"].sort_values(ascending=False).index
scv.pl.scatter(adata, basis=top_genes[:5], color="clusters", frameon=False)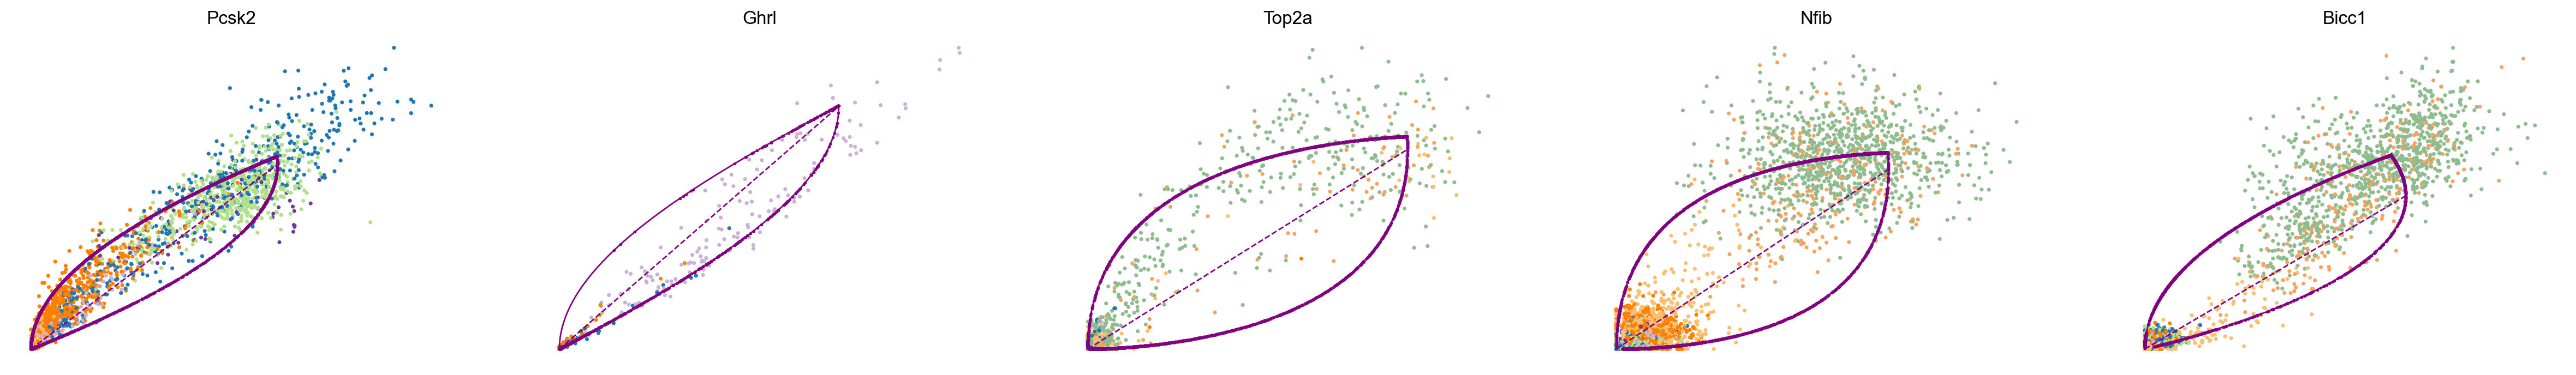
动力学速率估计完成后(对应 fit_alpha,fit_beta,fit_gamma 等列,位于 adata.obs 中),即可计算 RNA velocity 及其在二维 统一流形近似与投影(uniform manifold approximation and projection, UMAP) 嵌入上的投影。
scv.tl.velocity(adata, mode="dynamical")
scv.tl.velocity_graph(adata, n_jobs=8)
scv.pl.velocity_embedding_stream(adata, basis="umap")
computing velocities
finished (0:00:04) --> added
'velocity', velocity vectors for each individual cell (adata.layers)
computing velocity graph (using 8/8 cores)
finished (0:00:05) --> added
'velocity_graph', sparse matrix with cosine correlations (adata.uns)
computing velocity embedding
finished (0:00:00) --> added
'velocity_umap', embedded velocity vectors (adata.obsm)
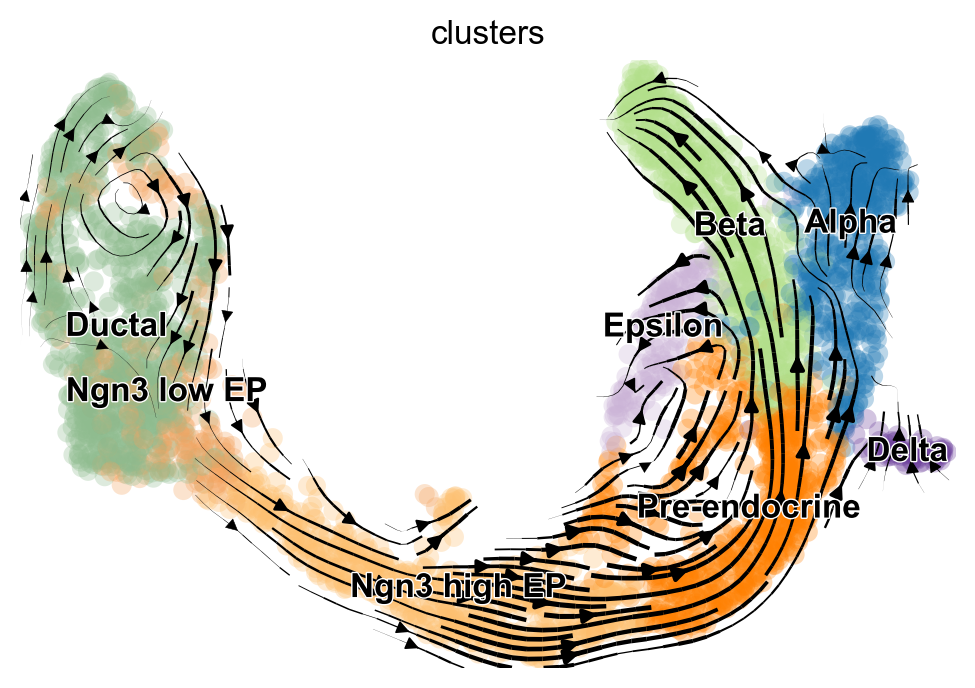
根据这些 2D 投影, EM 模型 更忠实地捕捉了 Ductal 细胞中的细胞周期(cell cycle)。此外, 稳态模型 的投影显示出从 Alpha 到 Pre-endocrine 细胞的“回流”。不过,要进行严格的定量分析,我们建议使用 CellRank 等下游工具 Lange et al., 2022 来评估模型之间的差异并得出结论。
新方向
尽管 RNA velocity 已成功应用于许多系统,但模型仍有局限。若模型假设不成立,便可能得到错误结果 Bergen et al., 2021Barile et al., 2021;将高维速度向量投影到数据的低维表示上也可能造成误导。为克服这些问题,人们开发了多种工具。例如,CellRank Lange et al., 2022 利用推断出的速度场预测细胞未来可能的状态。该算法直接处理数据的高维表示,从而避开嵌入中具有误导性的速度流。另一项近期研究则试图提高低维嵌入本身的质量 Marot-Lassauzaie et al., 2022。
为放宽当前 RNA velocity 推断中的假设,人们提出了多种新方法 Qiao & Huang, 2021Marot-Lassauzaie et al., 2022Chen et al., 2022Riba et al., 2022Gu et al., 2022Gu et al., 2022,Gayoso et al., 2022。例如,这些方法试图不再假设速率为常数 Chen et al., 2022Gu et al., 2022、使用原始 Count Gu et al., 2022,或者在变分推断(variational inference, VI)框架中重新表述推断方法,从而量化估计值的不确定性 Gayoso et al., 2022。此外,为判断能否在单个基因或整个数据集层面可靠开展 RNA velocity 分析,人们也提出了不同的评估流程 Zheng et al., 2022Gayoso et al., 2022。
- Manno, G. L., Soldatov, R., Zeisel, A., Braun, E., Hochgerner, H., Petukhov, V., Lidschreiber, K., Kastriti, M. E., Lönnerberg, P., Furlan, A., Fan, J., Borm, L. E., Liu, Z., van Bruggen, D., Guo, J., He, X., Barker, R., Sundström, E., Castelo-Branco, G., … Kharchenko, P. V. (2018). RNA velocity of single cells. Nature, 560(7719), 494–498. 10.1038/s41586-018-0414-6
- Srivastava, A., Malik, L., Smith, T., Sudbery, I., & Patro, R. (2019). Alevin efficiently estimates accurate gene abundances from dscRNA-seq data. Genome Biology, 20(1). 10.1186/s13059-019-1670-y
- He, D., Zakeri, M., Sarkar, H., Soneson, C., Srivastava, A., & Patro, R. (2022). Alevin-fry unlocks rapid, accurate and memory-frugal quantification of single-cell RNA-seq data. Nature Methods, 19(3), 316–322. 10.1038/s41592-022-01408-3
- Melsted, P., Booeshaghi, A. S., Liu, L., Gao, F., Lu, L., Min, K. H., da Veiga Beltrame, E., Hjörleifsson, K. E., Gehring, J., & Pachter, L. (2021). Modular, efficient and constant-memory single-cell RNA-seq preprocessing. Nature Biotechnology, 39(7), 813–818. 10.1038/s41587-021-00870-2
- Zeisel, A., Köstler, W. J., Molotski, N., Tsai, J. M., Krauthgamer, R., Jacob-Hirsch, J., Rechavi, G., Soen, Y., Jung, S., Yarden, Y., & Domany, E. (2011). Coupled pre-mRNA and mRNA dynamics unveil operational strategies underlying transcriptional responses to stimuli. Molecular Systems Biology, 7(1), 529. 10.1038/msb.2011.62
- Bergen, V., Lange, M., Peidli, S., Wolf, F. A., & Theis, F. J. (2020). Generalizing RNA velocity to transient cell states through dynamical modeling. Nature Biotechnology, 38(12), 1408–1414. 10.1038/s41587-020-0591-3
- Bergen, V., Soldatov, R. A., Kharchenko, P. V., & Theis, F. J. (2021). RNA velocity—current challenges and future perspectives. Molecular Systems Biology, 17(8). 10.15252/msb.202110282
- Barile, M., Imaz-Rosshandler, I., Inzani, I., Ghazanfar, S., Nichols, J., Marioni, J. C., Guibentif, C., & Goettgens, B. (2021). Coordinated changes in gene expression kinetics underlie both mouse and human erythroid maturation. Genome Biology, 22(1). 10.1186/s13059-021-02414-y
- Bastidas-Ponce, A., Tritschler, S., Dony, L., Scheibner, K., Tarquis-Medina, M., Salinno, C., Schirge, S., Burtscher, I., Boettcher, A., Theis, F., Lickert, H., & Bakhti, M. (2019). Massive single-cell mRNA profiling reveals a detailed roadmap for pancreatic endocrinogenesis. Development. 10.1242/dev.173849
- Lange, M., Bergen, V., Klein, M., Setty, M., Reuter, B., Bakhti, M., Lickert, H., Ansari, M., Schniering, J., Schiller, H. B., Pe’er, D., & Theis, F. J. (2022). CellRank for directed single-cell fate mapping. Nature Methods, 19(2), 159–170. 10.1038/s41592-021-01346-6
- Marot-Lassauzaie, V., Bouman, B. J., Donaghy, F. D., Demerdash, Y., Essers, M. A. G., & Haghverdi, L. (2022). Towards reliable quantification of cell state velocities. PLOS Computational Biology, 18(9), e1010031. 10.1371/journal.pcbi.1010031
- Qiao, C., & Huang, Y. (2021). Representation learning of RNA velocity reveals robust cell transitions. Proceedings of the National Academy of Sciences, 118(49). 10.1073/pnas.2105859118
- Chen, Z., King, W. C., Hwang, A., Gerstein, M., & Zhang, J. (2022). Single-cell transcriptomic deep velocity field learning with neural ordinary differential equations. Science Advances, 8(48). 10.1126/sciadv.abq3745
- Riba, A., Oravecz, A., Durik, M., Jiménez, S., Alunni, V., Cerciat, M., Jung, M., Keime, C., Keyes, W. M., & Molina, N. (2022). Cell cycle gene regulation dynamics revealed by RNA velocity and deep-learning. Nature Communications, 13(1). 10.1038/s41467-022-30545-8
- Gu, Y., Blaauw, D., & Welch, J. D. (2022). Bayesian Inference of RNA Velocity from Multi-Lineage Single-Cell Data. bioarXiv. 10.1101/2022.07.08.499381