🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: gene-regulatory-networks

channels:
  - conda-forge
  - anaconda
dependencies:
  - conda-forge::python=3.9
  - conda-forge::scanpy=1.9
  - conda-forge::leidenalg
  - conda-forge::jupyterlab
  - conda-forge::jupyter_server=1.18.1
  - conda-forge::umap-learn>=0.5
  - conda-forge::pynndescent
  - conda-forge::numpy==1.21.5 # specific conflict between loompy as numba requires numpy < 1.24
  - conda-forge::numba
  - pip
  - pip:
      - pyscenic
      - nbmake==0.5
      - loompy
      - MulticoreTSNE
  - anaconda:cytoolz
研究动机
完成单细胞基因组学数据预处理后,可以结合基因组背景,解析观测到的特征(feature)之间的关系。基因转录受到启动子(promoter)、增强子(enhancer)等顺式调控元件(cis-regulatory element, CRE)及其结合因子的共同调节;这些元件通过影响转录机器的募集与活性,调控每个基因产生的 RNA 数量。
基因调控网络(Gene Regulatory Network, GRN)用图表示基因表达的调控关系。其中, 转录因子(Transcription Factor, TF)是调控转录的蛋白质,而非编码它们的基因本身。TF 可作用于启动子、增强子等 DNA 调控元件,影响靶基因的转录速率;若靶基因也编码调控因子,还可能形成间接的下游调控级联。顺式调控(cis-regulation)指 DNA 调控元件对同一 DNA 分子上基因的作用,反式调控(trans-regulation)指 TF 等可扩散因子的作用,两者不能简单等同于直接与间接调控。在计算上,GRN 推断方法可利用基因表达的协同变化,并结合可用的染色质可及性(chromatin accessibility)等 feature,识别与 TF 相关的候选模块。这些关联本身并不能证明调控关系。受同一个 TF 调控的一组靶基因称为 调节子(regulon)。
除协同变化外,一些方法还整合 TF 在基因组中的结合位置、已报道的 TF–靶基因关系等先验知识,用它们约束或引导网络中边的推断。与图像识别等任务相比,GRN 推断缺少充分且易于验证的真实调控标签,因此不少方法使用各自建立的基准,主要在真实数据上比较性能。不同生物系统中的参考网络往往不完整,社区尚缺少公认且可一致复用的金标准(gold standard);GRN 推断方法的泛化能力仍是调控基因组学中的研究问题。
本章展示生成 GRN 的基本流程(pipeline),选择软件依赖较少、便于运行和检查结果的方法。受基准测试条件限制,这些推荐并不意味着所选工具适用于所有场景或始终表现最佳。可以先以它们为起点,在现有数据和计算资源允许的范围内探索候选网络,再结合生物学背景评估结果。
从公共数据收集 TF 调节子
TF 调节子的注释可来自学术研究、汇编这些研究的数据库,以及 ENCODE 等联盟项目。对于真核生物,可先查看 TRRUST Han et al., 2015,DoRothEA Garcia-Alonso et al., 2019,KnockTF Feng et al., 2020 等数据库。对于原核生物,RegulonDB Santos-Zavaleta et al., 2018 是常用的参考数据库。
TF 调节子的局限
TF 调节子的适用范围和可信度受数据来源及实验读出影响。若参考调节子来自不同细胞类型,就需要谨慎判断其关系是否适用于当前系统。还应区分调控位置与因果层级: 顺式(cis)描述 DNA 调控元件对同一 DNA 分子上基因的作用, 反式(trans)描述 TF 等可扩散因子的调控作用;两者不等同于直接和间接调控。仅凭下游表达变化构建的调节子,可能混入间接响应。应优先使用来自相近生物系统的调节子;若缺少合适参考,需警惕不匹配的先验带来的解释偏倚。
利用 RNA 数据推断 GRN
我们将使用单细胞调控网络推断与聚类(Single-Cell Regulatory Network Inference and Clustering, SCENIC)分析单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)数据,并预测 TF 调节子。具体来说,本章应用 SCENIC Aibar et al., 2017 分析 NeurIPS 2021 数据集中的一个批次,再解读结果。主要处理步骤改编自 SCENIC 的 核心教程
分析目标
本笔记本通过推断 GRN 来解读 scRNA-seq 数据,得到 TF 与靶基因之间的候选关联,并利用这些关系解释细胞分化、状态转变或扰动等背景下的基因表达变化。
数据集说明
下文实际分析的是 NeurIPS 2021 骨髓单个核细胞(Bone Marrow Mononuclear Cell, BMMC)数据,代码读取 openproblems_bmmc_multiome_genes_filtered.h5ad。原文此处引用的研究涉及健康供体和 COVID-19 患者的外周血单个核细胞(Peripheral Blood Mononuclear Cell, PBMC),并非下文加载的数据集 Schulte-Schrepping et al., 2020。
环境设置
import warnings

warnings.filterwarnings("ignore")


from pathlib import Path

import loompy as lp
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import scanpy as sc
import seaborn as sns
准备 NeurIPS 数据集
这里使用的数据已在前几章完成预处理,共有 69,249 个细胞,注释为 22 种细胞类型。为减少跨批次差异的影响,本章仅用标记为 s1d1 的批次演示 GRN 推断;该批次包含 6,224 个细胞,标签编码采样站点和供体信息,并不是一种细胞类型。
加载完整数据集
adata = sc.read_h5ad("../../data/openproblems_bmmc_multiome_genes_filtered.h5ad")
adata.shape
(69249, 129921)使用 GEX 标签,仅保留 RNA 表达模态的 feature。
rna = adata[:, adata.var.feature_types == "GEX"]
del adata
sc.pp.log1p(rna)
rna.obs.batch.value_counts()
s4d8 9876
s4d1 8023
s3d10 6781
s1d2 6740
s1d1 6224
s2d4 6111
s2d5 4895
s3d3 4325
s4d9 4325
s1d3 4279
s2d1 4220
s3d7 1771
s3d6 1679
Name: batch, dtype: int64rna.shape(69249, 13431)这里先标记高变基因(Highly Variable Gene, HVG),供后续筛选使用,以减少下游计算量。也可以保留全部基因,但通常需要更多内存和运行时间。仅计算高变标记并不会自动缩减表达矩阵。
sc.pp.highly_variable_genes(rna, batch_key="batch", flavor="seurat")sc.set_figure_params(facecolor="white")下面展示所有供体细胞基于基因表达计算的嵌入(Embedding)。数据尚未进行批次校正(batch correction),图中的分组与 batch 标签关系明显,可能掩盖细胞类型之间的结构。该标签同时包含采样站点与供体信息,因此不能把分离现象全部归因于供体差异。
sc.pl.embedding(rna, "GEX_X_umap", color=["cell_type", "batch"])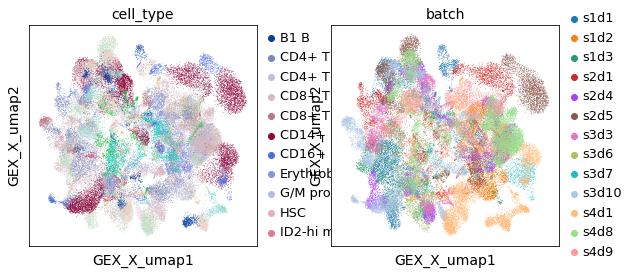
接下来只查看 s1d1 批次中的细胞。限定在同一批次内后,可以结合已有细胞类型注释,检查各聚类(clustering)对应的群体。
adata_batch = rna[rna.obs.batch == "s1d1", :]
sc.pl.embedding(adata_batch, "GEX_X_umap", color=["cell_type", "batch"])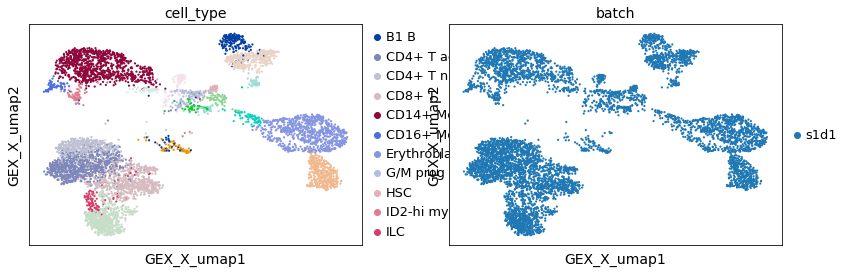
准备 SCENIC
本流程使用 loompy 将基因表达矩阵写为 loom 文件,作为 pySCENIC 的输入。另一个输入文件 allTFs_hg38.txt 列出编码 TF 的基因符号,用于指定推断 TF–靶基因关联时的候选调控因子。
## this file has to be downloaded if not found
!wget -nc https://raw.githubusercontent.com/aertslab/SCENICprotocol/master/example/allTFs_hg38.txt
File ‘allTFs_hg38.txt’ already there; not retrieving.
tfs_path = "allTFs_hg38.txt"loom_path = "data/neurips_processed_input.loom"
loom_path_output = "data/neurips_processed_output.loom"
tfs = [tf.strip() for tf in open(tfs_path)]建议先检查参考 TF 列表中有多少基因出现在输入数据里。若覆盖率较低,可排查 AnnData 基因注释表 .var 中的标识符:例如输入使用 Ensembl ID,而参考列表使用基因符号,或物种与基因名大小写规范不一致。原文建议以约 50% 的覆盖率作为排查线索,但这只是经验参考,不能作为所有数据集通用的质量阈值。
# as a general QC. We inspect that our object has transcription factors listed in our main annotations.
print(
    f"%{np.sum(adata_batch.var.index.isin(tfs))} out of {len(tfs)} TFs are found in the object"
)
1160 out of 1797 TFs are found in the object
若要保留全部 feature,将标志位 use_hvg 设为 False。
use_hvg = True
if use_hvg:
    mask = (adata_batch.var["highly_variable"] is True) | adata_batch.var.index.isin(
        tfs
    )
    adata_batch = adata_batch[:, mask]
默认意图是保留 HVG 与 TF 基因的并集;关闭筛选则保留全部 feature。注意,上面的 is True 是对象身份比较,不能逐基因判断高变标记;复用时应改用逐元素布尔掩码,否则筛选结果只保留 TF 列表中的基因。随后,为选定的 NeurIPS 批次创建 loom 文件。若这一步报错,请检查 Gene、CellID 等属性名及其内容是否正确。
row_attributes = {
    "Gene": np.array(adata_batch.var.index),
}
col_attributes = {
    "CellID": np.array(adata_batch.obs.index),
    "nGene": np.array(np.sum(adata_batch.X.transpose() > 0, axis=0)).flatten(),
    "nUMI": np.array(np.sum(adata_batch.X.transpose(), axis=0)).flatten(),
}

lp.create(loom_path, adata_batch.X.transpose(), row_attributes, col_attributes)
生成 loom 文件后,运行 pyscenic 推断 TF 与靶基因之间的候选关联。GRNBoost 根据表达数据估计有向边的重要性权重,输出表汇总这些关联及其权重。方向来自预测模型中 TF 与靶基因的角色,不等于已经证实了调控因果关系。
下面一些步骤需要指定并行工作进程数(num_workers)。可根据可用计算资源调整。
num_workers = 3outpath_adj = "adj.csv"
if not Path(outpath_adj).exists():
!pyscenic grn {loom_path} {tfs_path} -o $outpath_adj --num_workers {num_workers}查看 TF–靶基因关联表的前几行。
results_adjacencies = pd.read_csv("adj.csv", index_col=False, sep=",")
print(f"Number of associations: {results_adjacencies.shape[0]}")
results_adjacencies.head()
# associations: 683484
绘制重要性权重的分布,有助于检查数值范围并选择探索性筛选阈值。下方代码画的是权重的 log10 值:横轴负值表示原始权重小于 1,正值表示大于 1,并不表示负调控和正调控。分布右尾的较大权重可用于优先检查 TF 与潜在靶基因的关联,但这些候选关系仍需额外证据支持。
plt.hist(np.log10(results_adjacencies["importance"]), bins=50)
plt.xlim([-10, 10])
(-10.0, 10.0)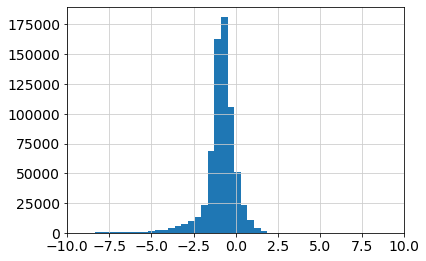
TF 识别的 DNA 基序(motif)可为 TF–靶基因关系提供序列层面的支持。接下来使用转录起始位点(Transcription Start Site, TSS)周围区域的基序排名数据库,并结合基序与 TF 的对应注释,对共表达网络进行筛选。该数据库覆盖 TSS 上下游各 10 kb 的区域,并不只限于狭义的启动子。
下载 Aerts 实验室预先计算的 TSS 周围区域基序排名数据库。
!wget -nc https://resources.aertslab.org/cistarget/databases/homo_sapiens/hg38/refseq_r80/mc9nr/gene_based/hg38__refseq-r80__10kb_up_and_down_tss.mc9nr.genes_vs_motifs.rankings.featherFile ‘hg38__refseq-r80__10kb_up_and_down_tss.mc9nr.genes_vs_motifs.rankings.feather’ already there; not retrieving.
# ranking databases
db_glob = "*feather"
db_names = " ".join(map(str, Path().glob(db_glob)))
下载基序与 TF 的对应注释表。
!wget -nc https://resources.aertslab.org/cistarget/motif2tf/motifs-v9-nr.hgnc-m0.001-o0.0.tblFile ‘motifs-v9-nr.hgnc-m0.001-o0.0.tbl’ already there; not retrieving.
# motif databases
motif_path = "motifs-v9-nr.hgnc-m0.001-o0.0.tbl"
结合基序排名数据库与基序–TF 注释,对先前的候选边进行剪枝,保留具有相应基序富集证据的调节子。在普通个人计算机上,这一步可能需要数分钟。
if not Path("reg.csv").exists():
    !pyscenic ctx adj.csv \
        {db_names} \
        --annotations_fname {motif_path} \
        --expression_mtx_fname {loom_path} \
        --output reg.csv \
        --mask_dropouts \
        --num_workers {num_workers} > pyscenic_ctx_stdout.txt
探索候选结果时,可先按重要性或相对贡献排序,再结合分布选择高分位阈值,优先查看信号较强的关系。这样的筛选有助于缩小候选范围,但不能替代统计或实验验证。
计算每个细胞检测到的基因数的若干分位数,供后续设置 AUCell 参数时参考。
import numpy as np

n_genes_detected_per_cell = np.sum(adata_batch.X > 0, axis=1)
percentiles = pd.Series(n_genes_detected_per_cell.flatten().A.flatten()).quantile(
    [0.01, 0.05, 0.10, 0.50, 1]
)
print(percentiles)
0.01 101.0
0.05 144.0
0.10 171.0
0.50 259.0
1.00 1387.0
dtype: float64
下面的直方图展示每个细胞检测到的基因数分布,可辅助设置下一步的参数 --auc_threshold。参数 --auc_threshold 的默认值为 0.05,表示在每个细胞中按表达量排序后,取全部输入基因的前 5%。图中标注的 144 是检测基因数分布的第 5 百分位数,并非默认阈值固定选取的基因数。应结合该分布和输入基因总数选择阈值,尽量避免将未检出的基因纳入积分范围;修改阈值也会影响 AUCell 分数。
fig, ax = plt.subplots(1, 1, figsize=(8, 5), dpi=100)
sns.distplot(n_genes_detected_per_cell, norm_hist=False, kde=False, bins="fd")
for i, x in enumerate(percentiles):
    fig.gca().axvline(x=x, ymin=0, ymax=1, color="red")
    ax.text(
        x=x,
        y=ax.get_ylim()[1],
        s=f"{int(x)} ({percentiles.index.values[i] * 100}%)",
        color="red",
        rotation=30,
        size="x-small",
        rotation_mode="anchor",
    )
ax.set_xlabel("# of genes")
ax.set_ylabel("# of cells")
fig.tight_layout()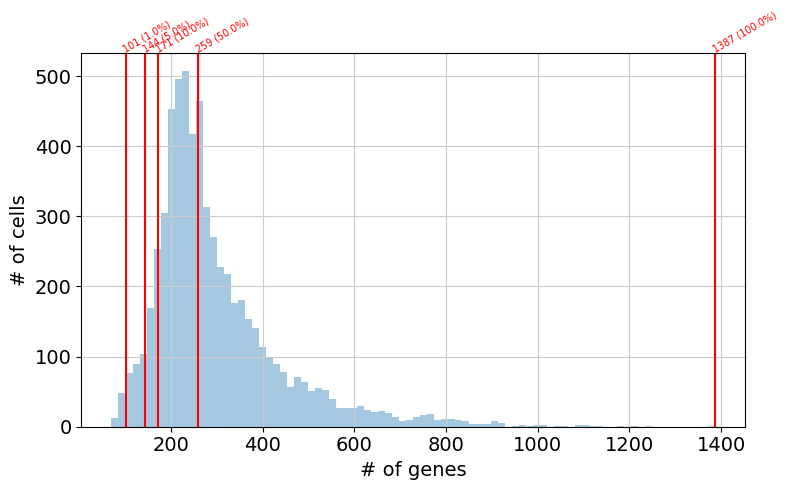
AUCell 为每个细胞中的每个调节子计算恢复曲线下面积(Area Under the Recovery Curve, AUC),衡量该调节子的靶基因是否富集在细胞表达排名的前端。AUC 可作为调节子活性的相对指标,但不直接测量 TF 蛋白活性,也不同于分类器的 ROC AUC。
根据这一步得到的“细胞 × TF 调节子”AUC 矩阵,可以重新计算 Embedding。
if not Path(loom_path_output).exists():
    !pyscenic aucell $loom_path \
        reg.csv \
        --output {loom_path_output} \
        --num_workers {num_workers} > pyscenic_aucell_stdout.txt
# collect SCENIC AUCell output
lf = lp.connect(loom_path_output, mode="r+", validate=False)
auc_mtx = pd.DataFrame(lf.ca.RegulonsAUC, index=lf.ca.CellID)
lf.close()import anndata as ad
ad_auc_mtx = ad.AnnData(auc_mtx)
sc.pp.neighbors(ad_auc_mtx, n_neighbors=10, metric="correlation")
sc.tl.umap(ad_auc_mtx)
sc.tl.tsne(ad_auc_mtx)WARNING: You’re trying to run this on 247 dimensions of `.X`, if you really want this, set `use_rep='X'`.
Falling back to preprocessing with `sc.pp.pca` and default params.
将 auc_mtx 中的调节子 AUC 转换为低维坐标,用于可视化细胞之间的关系。
adata_batch.obsm["X_umap_aucell"] = ad_auc_mtx.obsm["X_umap"]
adata_batch.obsm["X_tsne_aucell"] = ad_auc_mtx.obsm["X_tsne"]
下面的统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)图显示,基于 SCENIC 调节子分数计算的 Embedding 仍能分开多数已有细胞类型,提示这些分数保留了与细胞身份相关的信息。二维分离本身并不能验证调控关系。
sc.pl.embedding(adata_batch, basis="X_umap_aucell", color="cell_type")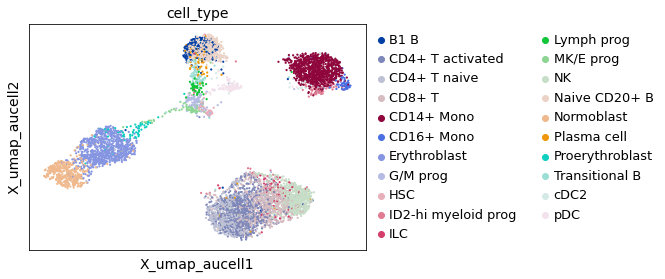
基于调节子分数的 t 分布随机邻域嵌入(t-distributed Stochastic Neighbor Embedding, t-SNE)图也显示,多数细胞类型能够分开。
sc.pl.embedding(adata_batch, basis="X_tsne_aucell", color="cell_type")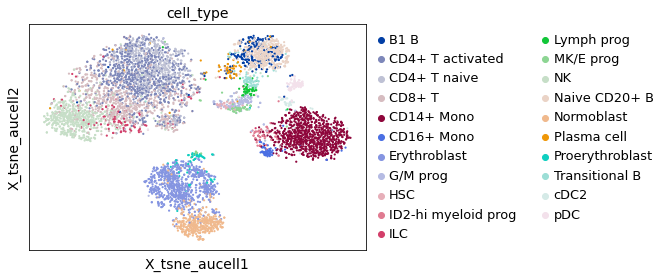
结果解读
import seaborn as snsauc_mtx["cell_type"] = adata_batch.obs["cell_type"]
mean_auc_by_cell_type = auc_mtx.groupby("cell_type").mean()对每个 TF 调节子,取其在各细胞类型中的最高平均 AUC,再据此选择前 N 个调节子用于热图展示。
top_n = 50
top_tfs = mean_auc_by_cell_type.max(axis=0).sort_values(ascending=False).head(top_n)
mean_auc_by_cell_type_top_n = mean_auc_by_cell_type[
    [c for c in mean_auc_by_cell_type.columns if c in top_tfs]
]
选出这些调节子后,可以查看它们在单个细胞中的 AUC,也可以按细胞类型汇总平均 AUC,如下方蓝色热图所示。这里展示的是根据靶基因表达推断的调节子活性,而非直接测得的 TF 活性。
sns.clustermap(
    mean_auc_by_cell_type_top_n,
    figsize=[15, 6.5],
    cmap="Blues",
    xticklabels=True,
    yticklabels=True,
)
<seaborn.matrix.ClusterGrid at 0x7fc377ccce10>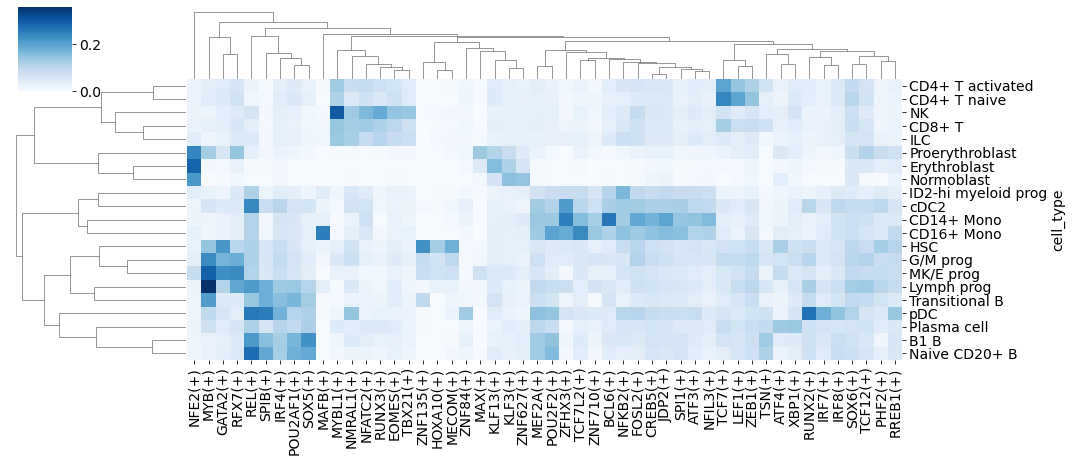
若蓝色热图提示某些调节子与特定细胞类型相关,可进一步检查编码相应 TF 的基因表达,作为补充证据。下方先提取 TF 基因名,再用 Scanpy 绘制红色表达热图。TF 的 RNA 表达量与其蛋白调控活性并不等同。
tf_names = top_tfs.index.str.replace(r"\(\+\)", "")
adata_batch_top_tfs = adata_batch[:, adata_batch.var_names.isin(tf_names)]
sc.pl.matrixplot(
adata_batch,
tf_names,
groupby="cell_type",
cmap="Reds",
dendrogram=True,
figsize=[15, 5.5],
standard_scale="group",
)WARNING: dendrogram data not found (using key=dendrogram_cell_type). Running `sc.tl.dendrogram` with default parameters. For fine tuning it is recommended to run `sc.tl.dendrogram` independently.
WARNING: You’re trying to run this on 2785 dimensions of `.X`, if you really want this, set `use_rep='X'`.
Falling back to preprocessing with `sc.pp.pca` and default params.
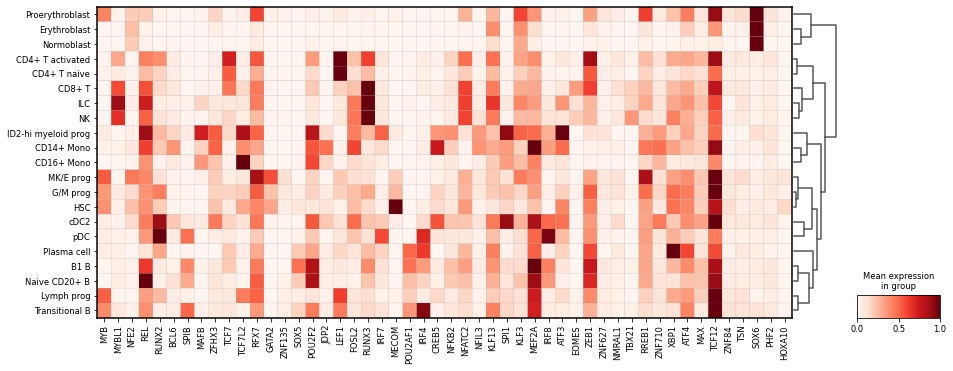
对照各细胞类型的调节子 AUC 与 TF 基因表达,可以检查两类信号是否一致。例如,图中浆细胞样树突状细胞(plasmacytoid Dendritic Cell, pDC)中的 RUNX2、CD16+ 单核细胞中的 TCF7L2,以及活化 CD4+ T 细胞中的 LEF1,均呈现相应的表达与调节子活性关联。这些观察可用于复核已有知识和提出新假设;确立具体调控关系仍需其他证据。
测验
理论
SCENIC
- Han, H., Shim, H., Shin, D., Shim, J. E., Ko, Y., Shin, J., Kim, H., Cho, A., Kim, E., Lee, T., Kim, H., Kim, K., Yang, S., Bae, D., Yun, A., Kim, S., Kim, C. Y., Cho, H. J., Kang, B., … Lee, I. (2015). TRRUST: a reference database of human transcriptional regulatory interactions. Sci. Rep., 5, 11432.
- Garcia-Alonso, L., Holland, C. H., Ibrahim, M. M., Turei, D., & Saez-Rodriguez, J. (2019). Benchmark and integration of resources for the estimation of human transcription factor activities. Genome Res., 29(8), 1363–1375.
- Feng, C., Song, C., Liu, Y., Qian, F., Gao, Y., Ning, Z., Wang, Q., Jiang, Y., Li, Y., Li, M., Chen, J., Zhang, J., & Li, C. (2020). KnockTF: A comprehensive human gene expression profile database with knockdown/knockout of transcription factors. Nucleic Acids Res., 48(D1), D93–D100.
- Santos-Zavaleta, A., Sánchez-Pérez, M., Salgado, H., Velázquez-Ramı́rez, D. A., Gama-Castro, S., Tierrafrı́a, V. H., Busby, S. J. W., Aquino, P., Fang, X., Palsson, B. O., Galagan, J. E., & Collado-Vides, J. (2018). A unified resource for transcriptional regulation in Escherichia coli K-12 incorporating high-throughput-generated binding data into RegulonDB version 10.0. BMC Biol., 16(1), 91.
- Aibar, S., González-Blas, C. B., Moerman, T., Huynh-Thu, V. A., Imrichova, H., Hulselmans, G., Rambow, F., Marine, J.-C., Geurts, P., Aerts, J., van den Oord, J., Atak, Z. K., Wouters, J., & Aerts, S. (2017). SCENIC: single-cell regulatory network inference and clustering. Nat. Methods, 14(11), 1083–1086.
- Schulte-Schrepping, J., Reusch, N., Paclik, D., Baßler, K., Schlickeiser, S., Zhang, B., Krämer, B., Krammer, T., Brumhard, S., Bonaguro, L., De Domenico, E., Wendisch, D., Grasshoff, M., Kapellos, T. S., Beckstette, M., Pecht, T., Saglam, A., Dietrich, O., Mei, H. E., … (DeCOI), D. C.-19 O. I. (2020). Severe COVID-19 Is Marked by a Dysregulated Myeloid Cell Compartment. Cell, 182(6), 1419-1440.e23. 10.1016/j.cell.2020.08.001