⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: surface-protein
channels:
  - conda-forge
dependencies:
  - python=3.13
  - scanpy=1.12
  - muon=0.1.9
  - python-igraph=1.0.0
  - ipykernel=7.2.0
  - pip==26.0.1
  - pip:
      - lamindb==2.3.1
      - harmonypy==0.0.9
      - ipywidgets==8.1.8
🗄️ 获取数据和笔记本
本书使用 lamindb 存储、共享和加载数据集与笔记本,托管实例为 theislab
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
按照 说明注册并登录
验证你的设置
下面用 Python API 检查连接;命令行方式可使用
lamin connect:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
运行后应显示最多 100 条已保存的数据集记录。
访问数据集(Artifact)
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
加载后的对象可直接在内存中分析。如需指定数据版本,可调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")中的 ID。访问笔记本(Transform)
加载笔记本:
lamin load <notebook url>该命令将笔记本下载到当前工作目录。与
Artifacts类似,可通过指定 ID 获取旧版本。
研究动机
表面蛋白的特征(feature)矩阵难以直接用表格理解,可通过降维(dimensionality reduction)构建通常为二维的嵌入(Embedding),展示抗体衍生标签(Antibody-Derived Tags, ADTs)数据。本章使用与 RNA 分析类似的方法,包括统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)。t 分布随机邻域嵌入(t-distributed stochastic neighbor embedding, t-SNE)、UMAP 的可视化局限同样适用:图中群体的距离、面积或分离程度不能直接等同于生物学差异大小。
ADT 面板中的 feature 通常已在实验设计时 预先 选定,因此常不需要复杂的高变 feature 筛选,但仍应去除不适用于下游分析的对照或低质量标记。对于含数百个蛋白或细胞较多的数据,可用主成分分析(Principal Component Analysis, PCA)压缩维度,降低近邻计算成本。
本章及随后的批次校正(batch correction)、注释章节聚焦 ADT。联合使用 RNA 与 ADT 的方法见 配对整合,两种模态可为更细致的细胞注释提供互补信息。
环境设置
import warnings

import muon as mu
import scanpy as sc

warnings.filterwarnings("ignore")
sc.settings.verbosity = 0
sc.set_figure_params(
    dpi=80,
    facecolor="white",
    frameon=False,
)

import lamindb as ln

ln.track()
→ connected lamindb: theislab/sc-best-practices
→ found notebook dimensionality_reduction.ipynb, making new version -- anticipating changes
→ created Transform('liGMVGre4G5H0008', key='dimensionality_reduction.ipynb'), started new Run('aPuKLGSFDouWhxAx') at 2026-07-29 11:09:07 UTC
→ notebook imports: lamindb-core==2.3.1 muon==0.1.9 scanpy==1.12.3
• recommendation: to identify the notebook across renames, pass the uid: ln.track("liGMVGre4G5H")
加载数据
加载前一章保存的 MuData 对象,参见 Doublet 检测:
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="surface-protein/cite_doublet_detection.h5mu", is_latest=True
)
mdata = af.load()
mdata本例后续步骤不再使用原始 Count,因此删除当前对象中的 counts 层。若需要回查或重新归一化(normalization),仍应保留前面保存的原始数据文件。
del mdata["prot"].layers["counts"]同型对照(isotype controls)主要用于估计非特异性背景,不作为目标蛋白参与本例的生物学降维。它们在 背景去噪与缩放(denoised and scaled by background, dsb) 中的用途见 归一化 章节;完成该步骤后,从用于降维的蛋白集合中移除这些对照。
mdata["prot"].var.index[:50]Index(['CD86-1', 'CD274-1', 'CD270', 'CD155', 'CD112', 'CD47-1', 'CD48-1',
'CD40-1', 'CD154', 'CD52-1', 'CD3', 'CD8', 'CD56', 'CD19-1', 'CD33-1',
'CD11c', 'HLA-A-B-C', 'CD45RA', 'CD123', 'CD7-1', 'CD105', 'CD49f',
'CD194', 'CD4-1', 'CD44-1', 'CD14-1', 'CD16', 'CD25', 'CD45RO', 'CD279',
'TIGIT-1', 'Mouse-IgG1', 'Mouse-IgG2a', 'Mouse-IgG2b', 'Rat-IgG2b',
'CD20', 'CD335', 'CD31', 'Podoplanin', 'CD146', 'IgM', 'CD5-1', 'CD195',
'CD32', 'CD196', 'CD185', 'CD103', 'CD69-1', 'CD62L', 'CD161'],
dtype='object')isotype_controls = ["Mouse-IgG1", "Mouse-IgG2a", "Mouse-IgG2b", "Rat-IgG2b"]
temp = (
mdata["prot"].var.loc[~mdata["prot"].var.index.isin(isotype_controls), :].index
) # Select all proteins except isotype controls.应用上述蛋白列表,去除同型对照。
mu.pp.filter_var(data=mdata["prot"], var=temp.tolist())过滤后的蛋白模态不再包含这些同型对照。
mdata["prot"]AnnData object with n_obs × n_vars = 105907 × 136
obs: 'donor', 'batch', 'n_genes_by_counts', 'log1p_n_genes_by_counts', 'total_counts', 'log1p_total_counts', 'n_genes', 'n_counts', 'outliers', 'doublets_markers'
var: 'gene_ids', 'feature_types', 'n_cells_by_counts', 'mean_counts', 'log1p_mean_counts', 'pct_dropout_by_counts', 'total_counts', 'log1p_total_counts'
uns: 'doublets_markers_colors'PCA 与 UMAP
当前保留 136 个蛋白标记,下面使用 PCA 构建低维表示。
sc.pp.pca(mdata["prot"], svd_solver="arpack", random_state=0)绘制各主成分(Principal Components, PCs)的解释方差比,参考肘部位置选择保留数量:
sc.pl.pca_variance_ratio(mdata["prot"], n_pcs=50)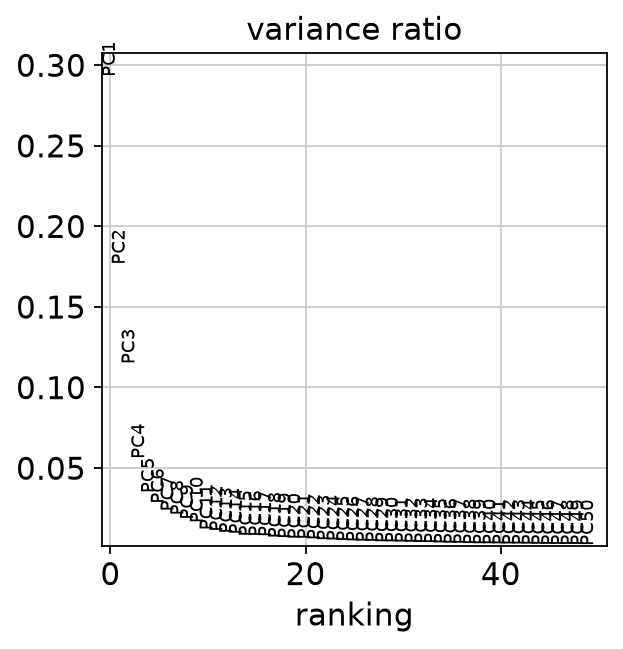
本例保留前 20 个 PC;图中后续主成分的方差贡献较小。这是结合该数据作出的选择,并非固定规则。接着基于这些 PC 构建邻接图,再计算 UMAP 以展示细胞。
sc.pp.neighbors(mdata["prot"], n_pcs=20, random_state=0)sc.tl.umap(mdata["prot"], random_state=0)二维 Embedding 可按供体和批次着色,用于初步检查批次效应(batch effect)。群体分离可能来自技术因素,也可能包含供体间真实生物学差异,需要结合标记和实验设计判断。
sc.pl.umap(mdata["prot"], color=["donor", "batch"])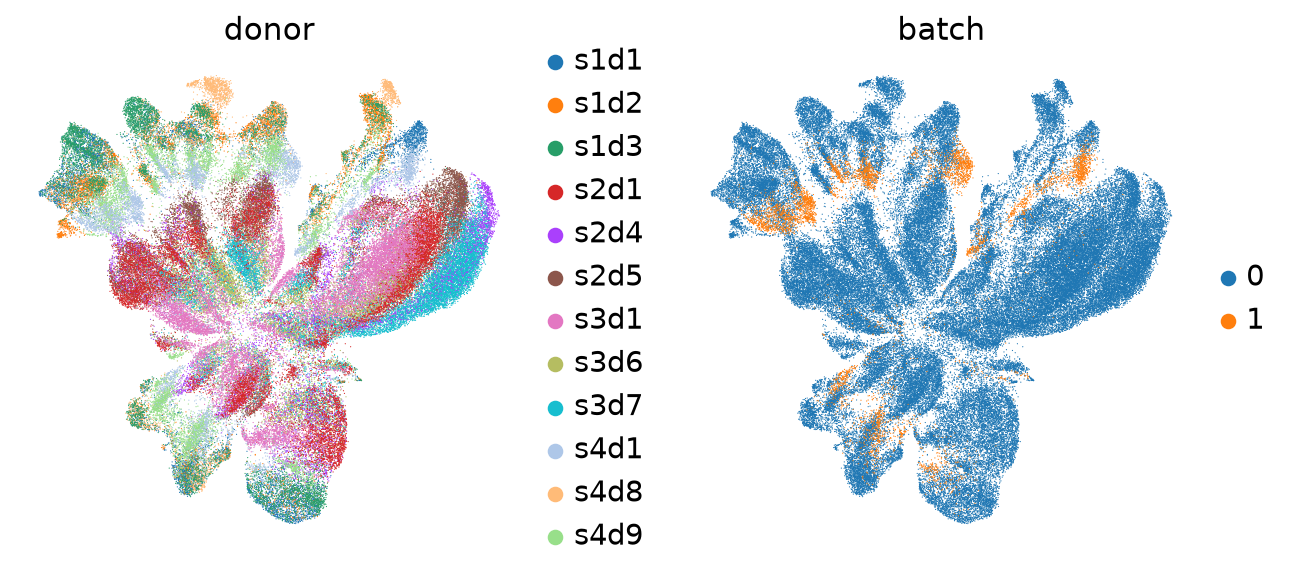
本例部分供体和批次的细胞形成分离群体,提示需要进一步评估批次校正。先绘制 CD3、CD4 和 CD8,检查已知 T 细胞群体的分布。
sc.pl.umap(mdata["prot"], color=["CD4-1", "CD8", "CD3"])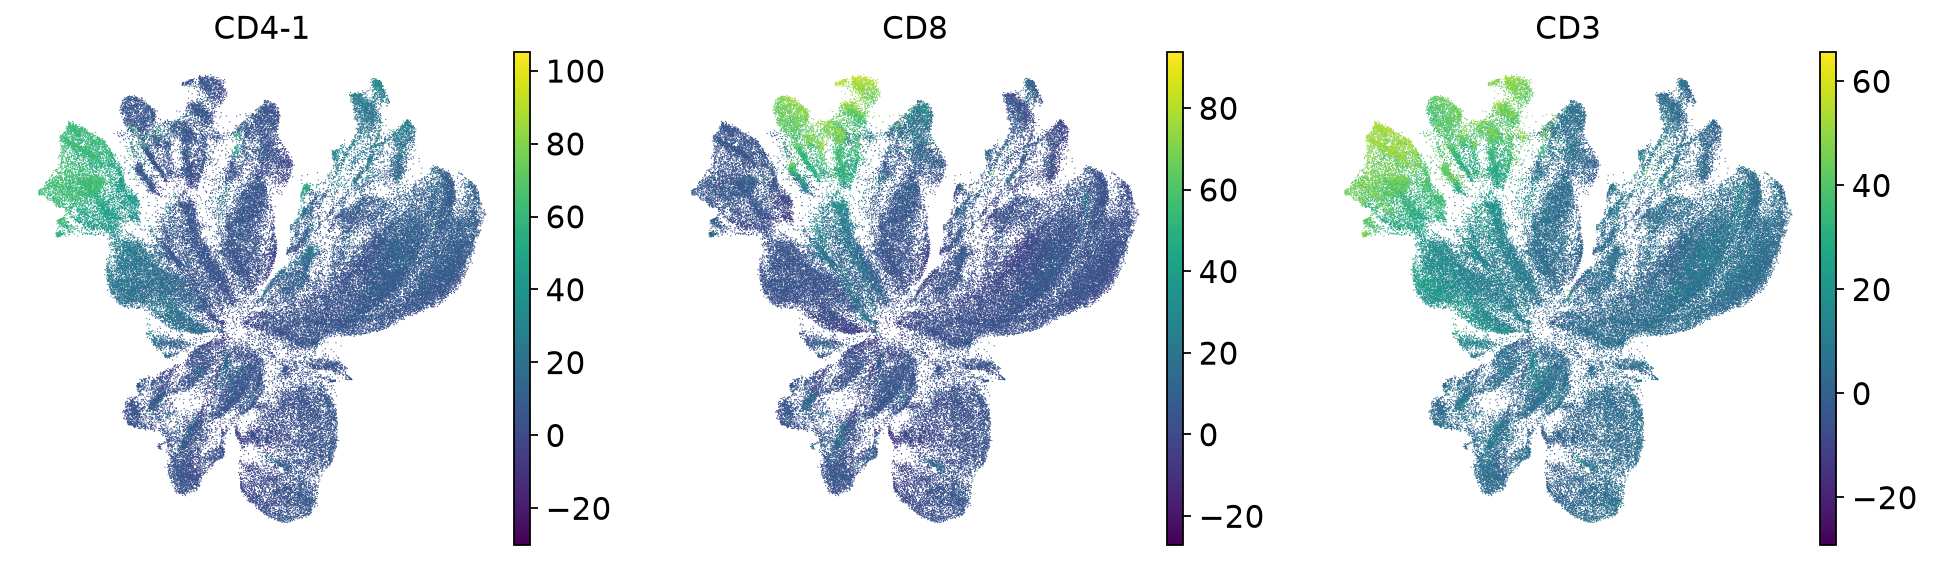
CD4 T 细胞分成多个供体相关的小群体,提示供体因素影响了表示。若分析目标是跨供体识别共有细胞类型,可尝试校正技术差异;但不能假定所有供体差异都是批次效应,也不应强行消除真实细胞状态差异。
af_dimensionality_reduction = ln.Artifact.from_mudata(
    mdata,
    key="surface-protein/cite_dimensionality_reduction.h5mu",
    description="CITE-seq data after dimensionality reduction",
)
af_dimensionality_reduction.save()
输出
→ creating new artifact version for key 'surface-protein/cite_dimensionality_reduction.h5mu' in storage 's3://lamin-eu-central-1/VPwcjx3CDAa2'
... uploading 9DWigMKiH7zGL1jy0005.h5mu:  0.0%
... uploading 9DWigMKiH7zGL1jy0005.h5mu: 100.0%
• replacing the existing cache path /var/cache/user/marchena/.cache/lamindb/lamin-eu-central-1/VPwcjx3CDAa2/surface-protein/cite_dimensionality_reduction.h5mu
Artifact(uid='9DWigMKiH7zGL1jy0005', key='surface-protein/cite_dimensionality_reduction.h5mu', description='CITE-seq data after dimensionality reduction', suffix='.h5mu', kind='dataset', otype='MuData', size=1406205468, hash='xlfiRsibE4hRwwkE6fVkTq', n_files=None, n_observations=105907, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=113, schema_id=None, created_by_id=7, created_at=2026-07-29 11:10:27 UTC, is_locked=False, version_tag=None, is_latest=True)ln.finish()输出
• please hit CTRL + s to save the notebook in your editor .... still waiting .....
.................. ✓
! returning transform  with same hash & key: Transform(uid='liGMVGre4G5H0007', key='dimensionality_reduction.ipynb', description='Dimensionality Reduction', kind='notebook', hash='9AXoWZ-LnjdIoeh_N7xjtQ', reference=None, reference_type=None, environment=None, plan=None, branch_id=1, created_on_id=1, space_id=1, created_by_id=7, created_at=2026-07-29 10:31:37 UTC, is_locked=False, version_tag=None, is_latest=False)
• new latest Transform version is: liGMVGre4G5H0007
→ finished Run('aPuKLGSFDouWhxAx') after 2m at 2026-07-29 11:11:09 UTC
→ go to: https://lamin.ai/theislab/sc-best-practices/transform/liGMVGre4G5H0007
→ to update your notebook from the CLI, run: lamin save /groups/nils/members/javier/single-cell-best-practices/jupyter-book/surface_protein/dimensionality_reduction.ipynb