🧠 关键要点
富集分析(enrichment analysis)需要三类输入:分子测量值(molecular readouts)、先验知识(prior knowledge)和推断方法(inference method)。分析既可在单个细胞层面开展,也可在细胞群体层面开展。
使用基因集(gene set)进行分析,假定基因表达能够反映蛋白质活性。调控足迹(footprint)则为基因赋予带正负号的权重,以反映下游调控效应,因此更贴合转录组学数据。
开展富集分析前,应过滤成员过少的基因集(通常指基因数不足 10–15 个的基因集),并对数据进行恰当的归一化(normalization)。
通常优先选择竞争性检验(competitive test),因为它只需一组基因层面的统计量,且结果受样本变化的影响比自包含检验(self-contained test)小。
富集结果对基因集选择的敏感程度高于对统计方法选择的敏感程度,因此应尝试多个资源,并比较所得结果是否一致。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: gsea

channels:
  - conda-forge

dependencies:
  - python=3.14.6
  - squidpy=1.8.2
  - scanpy=1.12.3
  - pip
  - pip:
      - "decoupler[full]==2.2.0"
      - lamindb==2.9.1
      - scikit-misc==0.5.2
🗄️ 获取数据和笔记本
本书使用 lamindb 存储、共享和加载数据集与笔记本,使用的是 theislab/sc-best-practices 实例。本书的免费托管由以下团队提供:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
查找数据集,请访问 Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
查找笔记本,请访问 Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)让我们以前所未有的深度认识分子层面的变异。然而,在特定生物学背景下,观测到的变异可能涉及数百个基因,因此所得高维数据仍难以解读。
基因集富集分析(Gene Set Enrichment Analysis, GSEA) 可将高维分子测量数据概括为具有可解释性的生物学过程或通路等条目,帮助我们理解分析结果,并提出有关作用机制的假设。GSEA 也称为通路分析、富集分析(enrichment analysis)、基因集(gene set)分析或功能分析,本章交替使用这些名称。
功能分析需要以下三类输入:
分子测量值(molecular readouts):包含基因表达量或基因层面统计量(如对数倍数变化、检验统计量)的矩阵。
先验知识(prior knowledge):与生物学过程(如上皮–间质转化、代谢)或调控通路(如 丝裂原活化蛋白激酶(mitogen-activated protein kinase, MAPK) 信号通路)相关的基因集或调控足迹(footprint)集合。
推断方法(inference method):根据分子数据计算基因集“富集”得分的统计方法。
背景知识
基因集资源
基因集是根据既有研究和/或实验整理出的基因列表,其中的基因已知参与某一生物学过程;这些基因集保存在先验知识数据库中。分子特征数据库(Molecular Signatures Database, MSigDB)Subramanian et al., 2005Liberzon et al., 2011 是最全面的此类数据库,包含 9 类基因集资源。常用的资源包括 C5,即基因本体(Gene Ontology, GO)基因集;以及 C2,即从已发表研究中整理出的基因特征集合。C2 中的基因特征通常与特定组织或条件等背景有关,也包括 KEGG 和 REACTOME 的基因特征。Hallmark 集合旨在减少基因集之间的冗余;免疫学研究则常用 C7 集合。这些特征主要来自 bulk 测序数据,刻画的是连续表型。近年来,随着 scRNA-seq 数据集广泛开放,一些数据库开始提供经过整理的 标记基因(marker gene) 列表。这些列表来自已发表的单细胞研究,用于界定 细胞类型,覆盖多种组织和物种。这类数据库包括 CellMarker Zhang et al., 2019 和 PanglaoDB Franzén et al., 2019。除使用数据库提供的标记基因列表外,也可以根据自己的数据或公开数据自行整理。
通路基因集收录了编码该通路蛋白质成员的基因,这些成员已得到实验验证。使用此类基因集进行富集分析,假定基因表达量、蛋白质丰度和蛋白质活性之间高度相关。尽管存在这一假设,多数基因集仍能给出可靠的得分,因为其中的成员通常受到协同调控 Szalai & Saez-Rodriguez, 2020。调控足迹则收录某一过程激活时,在其下游发生表达变化的基因,因此更贴合转录组学数据。调控足迹通常为每个基因指定相互作用权重,表示调控的强度和方向(正值表示激活,负值表示抑制)。这一思路已用于转录因子(Transcription Factor, TF)、激酶和酶的研究 Dugourd & Saez-Rodriguez, 2019。常见调控足迹数据库包括用于信号通路的 PROGENy Schubert et al., 2018、用于配体响应特征的 CytoSig Jiang et al., 2021,以及用于转录因子的 DoRothEA Garcia-Alonso et al., 2019。与基因集一样,调控足迹也可以由研究者根据数据自行整理,例如通过构建 基因调控网络(Gene Regulatory Network, GRN)。
在单细胞数据中的应用
在 scRNA-seq 数据分析中,富集分析通常针对单个 细胞簇 中的 细胞 或单种细胞类型分别开展。例如,可以在每种细胞类型内比较未处理与处理后细胞的基因表达变化,再利用所得基因统计量判断哪些生物学过程的调控发生了异常 Squair et al., 2021Crowell et al., 2020。在复杂实验设计中,也可以评估富集,同时考虑 批次效应(batch effect)、个体间差异、性别、小鼠模型的品系差异等因素(最佳实践参见 差异基因表达分析(Differential Gene Expression, DGE)一章)。
富集方法也可以直接应用于单个细胞的基因表达数据,将高维表达数据归纳为一组可解释的潜变量,进而探索这些变量的变化。这种由先验知识驱动的降维(dimensionality reduction)方法可捕捉单细胞层面的转录异质性与变异,在保留生物学意义的同时,提高群体比较的统计效能。与其他由数据驱动的降维方法相比,例如 主成分分析(Principal Component Analysis, PCA) 或因子分析,富集方法估计出的潜变量并不一定相互独立。
多数富集方法最初为 bulk RNA-seq 开发,但也适用于单细胞数据。Holland et al. (2020) 发现,这些方法在模拟 scRNA-seq 数据上表现良好;部分方法甚至优于专为 scRNA-seq 分析设计的工具,尽管单细胞数据存在 漏检(dropout),且 文库(library) 较小。Holland 等人还指出,富集推断对基因集(即所用先验知识)的选择比对统计方法的选择更敏感。这可能是因为生物学过程具有背景特异性:例如,一种细胞类型中的 TF–靶基因关系可能与另一种细胞类型或组织不同。让基因集适配具体生物学背景有多种策略,例如推断 基因调控网络,或在因子分析中引入先验信息,如 Muvi Qoku & Buettner, 2022 和 Spectra Kunes et al., 2022。
与 Holland 等人的结论不同,Zhang et al. (2020) 发现,针对单细胞数据开发的工具,特别是 Pagoda2,在准确性、稳定性和可扩展性方面优于部分针对 bulk 数据的方法。功能推断工具本身不会处理批次效应,也不会处理研究目标之外的其他生物学变异,因此数据分析人员需要确保 差异基因表达分析 步骤已正确完成。
富集方法
多数富集方法基于超几何检验(hypergeometric test)、秩统计量,或通过置换对似然进行经验估计。无论采用何种统计方法,其假设检验均可分为竞争性检验(competitive test)和自包含检验(self-contained test)两大类;这一区分由以下研究提出:Goeman & Bühlmann (2007)。竞争性检验考察集合内的基因是否比集合外的基因排名更高,比较时通常使用大小相同的基因集合。由于抽样单位是基因,只需单个样本或一次对比所得的统计量向量即可开展检验。自包含基因集检验以研究对象为抽样单位,因此每组需要多个样本,但无需集合外的基因。它考察待检验基因集中的基因是否存在差异表达,而不考虑数据集中测量的其他基因。竞争性检验只依赖一个由基因层面统计量组成的向量,自包含方法则受样本数限制,因此富集分析最常使用竞争性检验 Mathur et al., 2018。近期的一项 基准评测(benchmark) Geistlinger et al., 2020 表明,自包含方法可能非常敏感:即使基因集中只有一个差异表达基因,也可能将其判为富集。竞争性方法则检验集合内的差异表达是否超过背景水平,条件可能更严格,也更接近“富集”的直观含义;与自包含方法相比,它们往往能稳定地将相关基因集排在更靠前的位置。不过,两类方法各有优缺点;它们的零假设不同,主要影响的是如何解读基因集富集结果。实践中,竞争性方法因结果稳定而更为常用;自包含方法的结果甚至可能因移除一个样本而明显改变。因此,本章仅使用竞争性方法。
常见的竞争性富集方法包括简单的超几何检验或单侧 Fisher 精确检验(Fisher's exact test)(如 Enrichr Chen et al., 2013 所用的方法)、GSEA 算法 Subramanian et al., 2005 及其快速实现 fgsea Korotkevich et al., 2021、基因集变异分析(Gene Set Variation Analysis, GSVA)Hänzelmann et al., 2013、VISION DeTomaso et al., 2019、AUCell Aibar et al., 2017、Pagoda2 Fan et al., 2016Lake et al., 2018、camera(如 limma 中的实现 Ritchie et al., 2015),scDECAF 以及简单的组合 Z 分数 Lee et al., 2008。如前所述,采用自包含假设检验的计算工具相对较少,代表包括差异检验框架 limma 中的 roast 和 fry Ritchie et al., 2015。这些方法使用线性模型,并通过经验贝叶斯方法(empirical Bayes method)调整检验统计量 Smyth, 2005。多数方法用于差异基因表达检验的 下游分析,而 limma 框架中的 camera、roast 和 fry 则以样本层面的基因表达数据为起点。有关这些方法的详细说明,参见 limma 用户手册。
有些富集方法在推断得分时可以使用调控足迹,也就是能够纳入基因权重。常见的此类竞争性方法包括 VIPER Alvarez et al., 2016、单变量线性模型(Univariate Linear Model, ULM)和多变量线性模型(Multivariate Linear Model, MLM)Badia-i-Mompel et al., 2022。自包含富集方法中的 fry 和 roast 也支持基因权重。
富集分析框架将多种富集方法整合在同一工具中,提供统一的数据格式,以及用于获取先验知识资源的便捷函数,从而方便用户对数据尝试不同方法。这类框架包括 Piano Väremo et al., 2013 和 EGSEA Alhamdoosh et al., 2016(均可在 R 中使用),以及 decoupler Badia-i-Mompel et al., 2022(同时支持 R 和 Python)。
| 方法 | 零假设类型 | 是否支持基因权重 | 参考文献 |
|---|---|---|---|
| Fisher 精确检验 | 竞争性检验 | 否 | Chen et al., 2013 |
| GSEA | 竞争性检验 | 否 | Subramanian et al., 2005Korotkevich et al., 2021 |
| GSVA | 竞争性检验 | 否 | Hänzelmann et al., 2013 |
| VISION | 竞争性检验 | 否 | DeTomaso et al., 2019 |
| AUCell | 竞争性检验 | 否 | Aibar et al., 2017 |
| Pagoda2 | 竞争性检验 | 否 | Fan et al., 2016Lake et al., 2018 |
| camera | 竞争性检验 | 否 | Ritchie et al., 2015 |
| Z 分数 | 竞争性检验 | 否 | Lee et al., 2008 |
| roast | 自包含检验 | 是 | Ritchie et al., 2015 |
| fry | 自包含检验 | 是 | Ritchie et al., 2015 |
| VIPER | 竞争性检验 | 是 | Alvarez et al., 2016 |
| ULM | 竞争性检验 | 是 | Badia-i-Mompel et al., 2022 |
| MLM | 竞争性检验 | 是 | Badia-i-Mompel et al., 2022 |
技术注意事项
过滤基因数过少的基因集
常见做法是在预处理时,排除与数据中检测到的基因或筛选出的高变基因(Highly Variable Gene, HVG)重叠过少的基因集。Zhang et al. (2020) 发现,随着基因覆盖程度(即通路或基因集中的基因数)降低,单细胞方法和 bulk 方法的性能都会下降。Holland et al. (2020) 也发现,基因集过小会降低 bulk 测序富集方法在单细胞数据上的性能。这些研究共同表明,在功能分析中,过滤成员过少的基因集是有益的,例如排除不足 10 个或 15 个基因的集合。Damian & Gorfine (2004) 认为,这与基因集大小对方差的影响有关:较小的基因集中,基因方差更容易偏大;较大的基因集中,基因方差则往往较小。这会影响富集检验统计量的准确性。Zhang 等人还发现,对基因表达测量值采用何种归一化(normalization)处理,也会影响通路分析。
数据归一化
单细胞实验中的读段(Read)计数(Count)通常在预处理 流程(pipeline) 的早期就完成归一化,以确保不同文库大小的细胞之间,测量值具有可比性。Zhang et al. (2020) 发现,使用 SCTransform Hafemeister & Satija, 2019 和 scran Lun et al., 2016 进行归一化,通常能提高单细胞和 bulk 富集评分工具的性能。他们发现,归一化方法的选择尤其会影响 AUCell(一种基于秩的方法)和 Z 分数(将数据变换为均值为 0、标准差为 1)的表现。
不同条件之间的功能分析
准备并探索数据
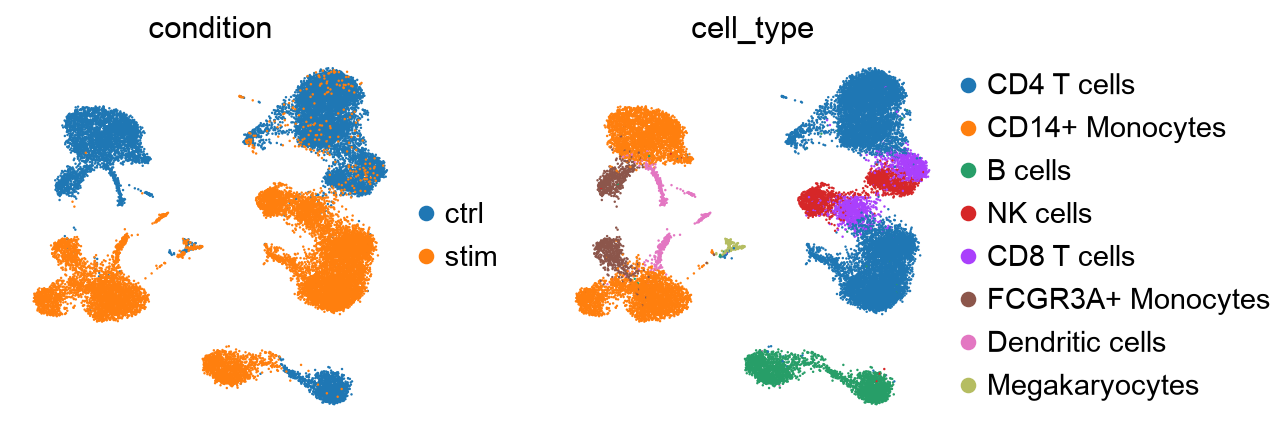
首先下载约含 2.5 万个外周血单个核细胞(Peripheral Blood Mononuclear Cells, PBMC)的数据集,并按照标准的 Scanpy 工作流,对 Read Count 归一化并选取高变基因。数据集包含未处理的人 PBMC,以及经干扰素 β(interferon beta,记作 IFN-)刺激的人 PBMC Kang et al., 2018。我们基于 4,000 个高变基因的统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)表示,探索数据中的变异模式。
import decoupler as dc
import lamindb as ln
import matplotlib.pyplot as plt
import scanpy as sc
import squidpy as sq

sc.set_figure_params(figsize=(3, 3), frameon=False)

ln.connect("theislab/sc-best-practices")
ln.track()
输出
→ loaded Transform('zTql6b4pzLB30002', key='gsea_pathway.ipynb'), re-started Run('BBv1A3z2d7rChepQ') at 2026-08-14 12:13:30 UTC
→ notebook imports: decoupler==2.2.0 lamindb-core==2.9.1 matplotlib==3.11.1 scanpy==1.12.3 squidpy==1.8.2
• tip: to identify the notebook across renames, pass the uid: ln.track("zTql6b4pzLB3")
adata = ln.Artifact.get(
    key="conditions/differential_gene_expression.h5ad",
).load()
adata
AnnData object with n_obs × n_vars = 24673 × 15706
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'label', 'cluster', 'cell_type', 'replicate', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters'
var: 'name'
obsm: 'X_pca', 'X_umap'
layers: None (.X)# Storing the counts for later use
adata.layers["counts"] = adata.X.copy()
# Renaming label to condition
adata.obs = adata.obs.rename({"label": "condition"}, axis=1)
# Normalizing
sc.pp.normalize_total(adata)
sc.pp.log1p(adata)# Finding highly variable genes using count data
sc.pp.highly_variable_genes(
adata, n_top_genes=4000, flavor="seurat_v3", subset=False, layer="counts"
)当前对象已包含 UMAP 和 PCA 嵌入(Embedding),但这些表示已校正掉刺激条件的影响,这不符合本次分析的目的。因此,我们将重新计算它们。
sc.pp.pca(adata)
sc.pp.neighbors(adata)
sc.tl.umap(adata)
sc.pl.umap(
adata,
color=["condition", "cell_type"],
frameon=False,
ncols=2,
)
检索基因集
基因集可以从各自的数据库下载,通常以 基因矩阵转置格式(Gene Matrix Transposed, GMT) 存储。也可以通过封装接口从数据库获取基因集。下面演示如何使用 decoupler 获取 MSigDB 数据(该接口借助元数据库 OmniPath Türei et al., 2021):
# Retrieving via python
msigdb = dc.op.resource("MSigDB", organism='human')

# Get reactome pathways
reactome = msigdb.query("collection == 'reactome_pathways'")
# Filter duplicates
reactome = reactome[~reactome.duplicated(("geneset", "genesymbol"))]
为使教程结果保持稳定,我们使用固定版本的基因集集合。下面下载并读取 MSigDB 的 C2 集合中 REACTOME 通路对应的 GMT 文件:
gmt = ln.Artifact.get(
    key="conditions/gsea_pathway/c2.cp.reactome.v7.5.1.symbols.gmt",
).cache()

reactome = dc.pp.read_gmt(gmt)
reactome下面按代码保留成员数严格大于 15 且严格小于 500 的基因集,以减少过小或过大集合可能带来的噪声。这些阈值并无统一标准,应根据具体研究问题调整。建议先查看基因集大小的分布,判断是否存在异常值。
geneset_size = reactome.groupby("source").size()
reactome = reactome.loc[
    [15 < geneset_size.loc[gset] < 500 for gset in reactome["source"]]
]
reactome单细胞层面的基因集评分
如前所述,可以对每个细胞单独计算基因集分数:评分依据该细胞自身的基因表达,无需比较其他细胞的表达。
使用 AUCell 对基因集评分
下面通过 AUCell 方法演示这一思路 Aibar et al., 2017;调用接口来自 decoupler。
dc.mt.aucell(
    data=adata,
    net=reactome,
    raw=False,
)

adata
AnnData object with n_obs × n_vars = 24673 × 15706
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'condition', 'cluster', 'cell_type', 'replicate', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters'
var: 'name', 'highly_variable', 'highly_variable_rank', 'means', 'variances', 'variances_norm'
uns: 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'condition_colors', 'cell_type_colors'
obsm: 'X_pca', 'X_umap', 'score_aucell'
varm: 'PCs'
obsp: 'distances', 'connectivities'
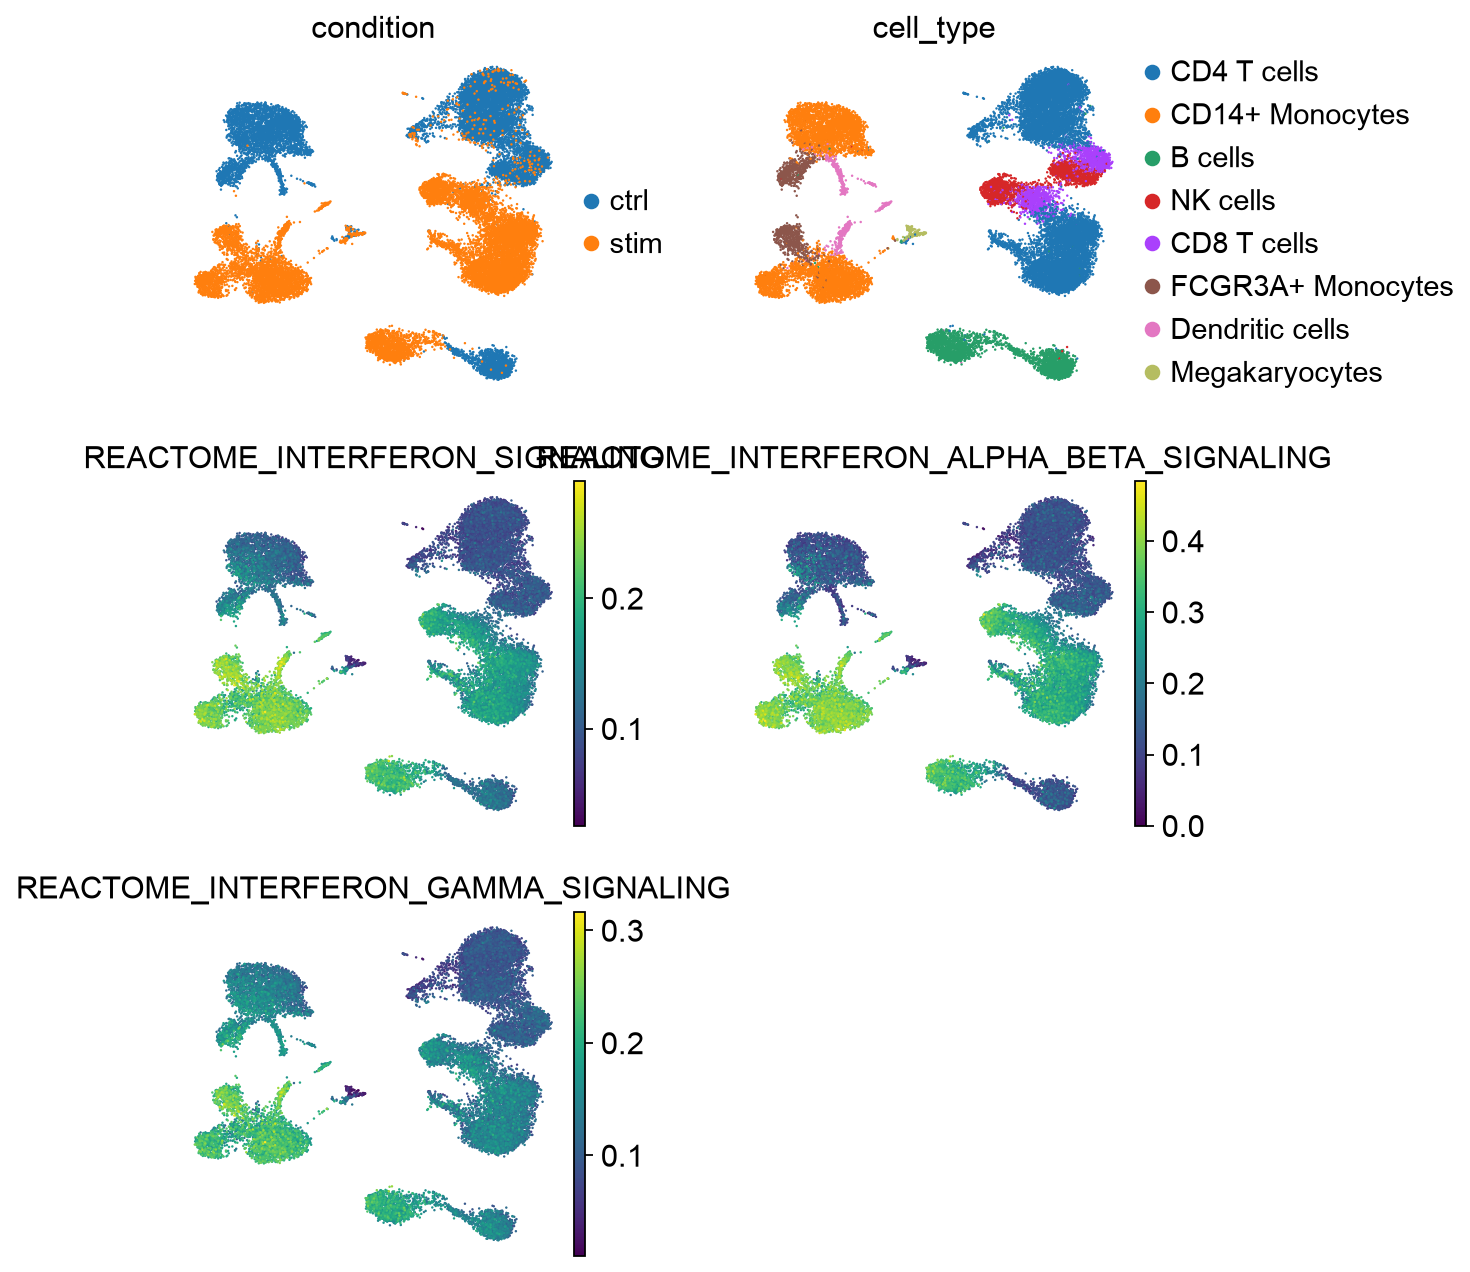
layers: None (.X), 'counts'现在,将与干扰素相关的 REACTOME 通路分数写入 obs 字段(位于 AnnData 对象中),并在 UMAP 图上展示每个细胞的通路分数:
ifn_pathways = [
    "REACTOME_INTERFERON_SIGNALING",
    "REACTOME_INTERFERON_ALPHA_BETA_SIGNALING",
    "REACTOME_INTERFERON_GAMMA_SIGNALING",
]

adata.obs[ifn_pathways] = adata.obsm["score_aucell"][ifn_pathways]
sc.pl.umap(
adata,
color=["condition", "cell_type"] + ifn_pathways,
frameon=False,
ncols=2,
wspace=0.3,
)
也可以用小提琴图展示分数的分布:
sc.pl.stacked_violin(
    adata,
    var_names=ifn_pathways,
    groupby=["cell_type", "condition"],
    swap_axes=True,
    figsize=(12, 3),
)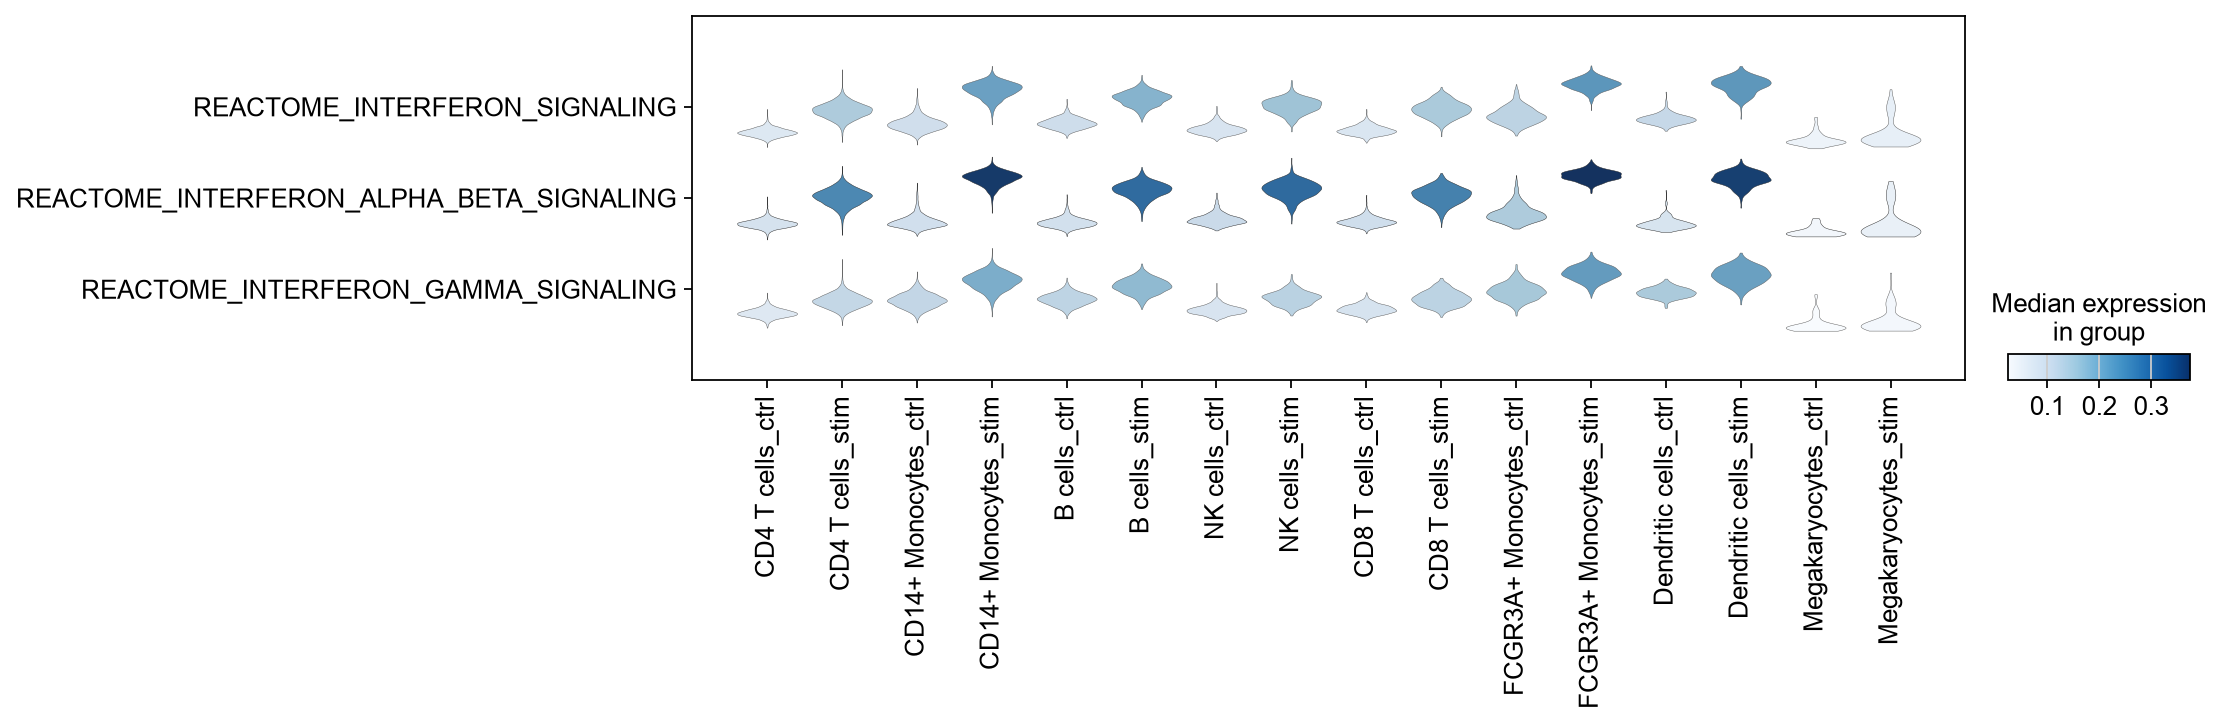
AUCell 对已知参与干扰素信号传导的通路,在 IFN 刺激细胞中给出较高分数;巨核细胞是符合预期的例外。对照细胞的这些通路分数普遍较低,说明 AUCell 基因集评分反映了预期的生物学变化。
使用 ULM 对调控足迹评分
除了基因集,我们也可以利用调控足迹推断分数。这里使用 PROGENy 数据库 Schubert et al., 2018。获取该资源可使用 decoupler:
# Retrieving via python
progeny = dc.op.progeny(organism='human', top=100)
同样,为保持教程结果稳定,下面使用固定版本的数据。
progeny = ln.Artifact.get(key="conditions/gsea_pathway/progeny.parquet").load()
progeny在这份资源中,每个基因都有与对应通路关联的权重,反映调控方向(正向或负向)及其重要程度。
下面使用 decoupler 中的 ULM 方法估计通路分数;该方法能够利用基因集的权重:
dc.mt.ulm(
    data=adata,
    net=progeny,
    raw=False,
)
adata
AnnData object with n_obs × n_vars = 24673 × 15706
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'condition', 'cluster', 'cell_type', 'replicate', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters', 'REACTOME_INTERFERON_SIGNALING', 'REACTOME_INTERFERON_ALPHA_BETA_SIGNALING', 'REACTOME_INTERFERON_GAMMA_SIGNALING'
var: 'name', 'highly_variable', 'highly_variable_rank', 'means', 'variances', 'variances_norm'
uns: 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'condition_colors', 'cell_type_colors'
obsm: 'X_pca', 'X_umap', 'score_aucell', 'score_ulm', 'padj_ulm'
varm: 'PCs'
obsp: 'distances', 'connectivities'
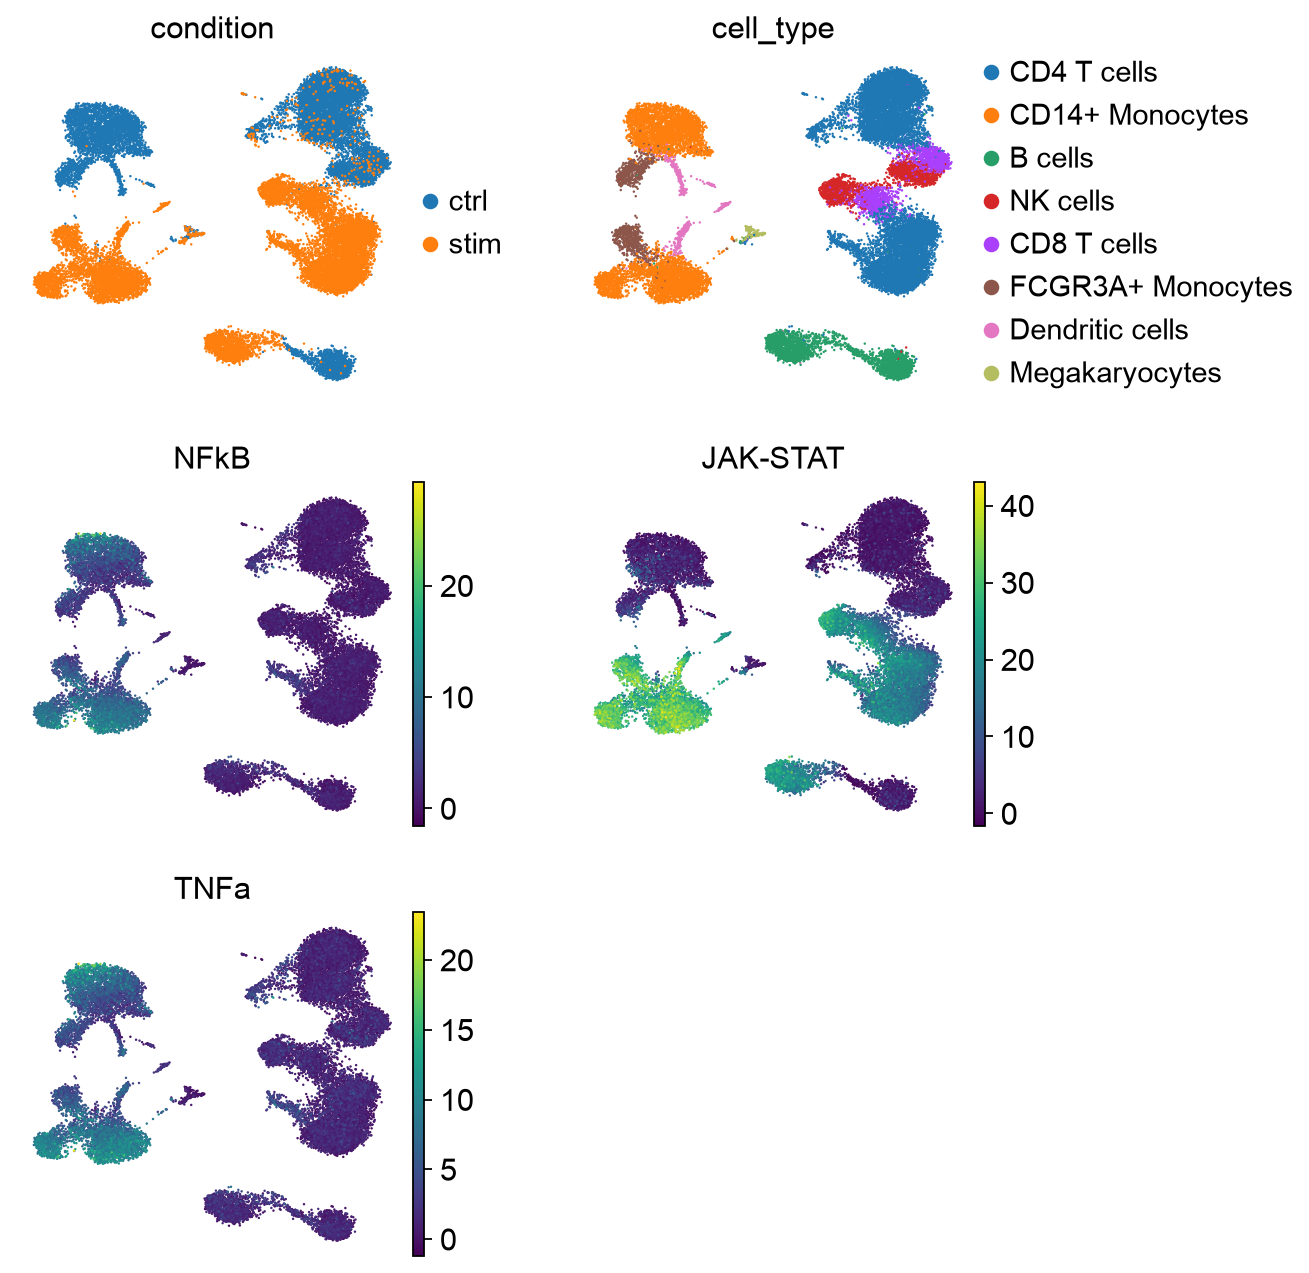
layers: None (.X), 'counts'接下来,将 PROGENy 中与免疫相关的通路分数写入 AnnData 对象的 obs 字段,并在 UMAP 图上展示每个细胞的通路分数:
imun_pathways = ["NFkB", "JAK-STAT", "TNFa"]

adata.obs[imun_pathways] = adata.obsm["score_ulm"][imun_pathways]
sc.pl.umap(
adata,
color=["condition", "cell_type"] + imun_pathways,
frameon=False,
ncols=2,
wspace=0.3,
)
与前面一样,也可以用小提琴图展示分数分布:
sc.pl.stacked_violin(
    adata,
    var_names=imun_pathways,
    groupby=["cell_type", "condition"],
    swap_axes=True,
    figsize=(12, 3),
)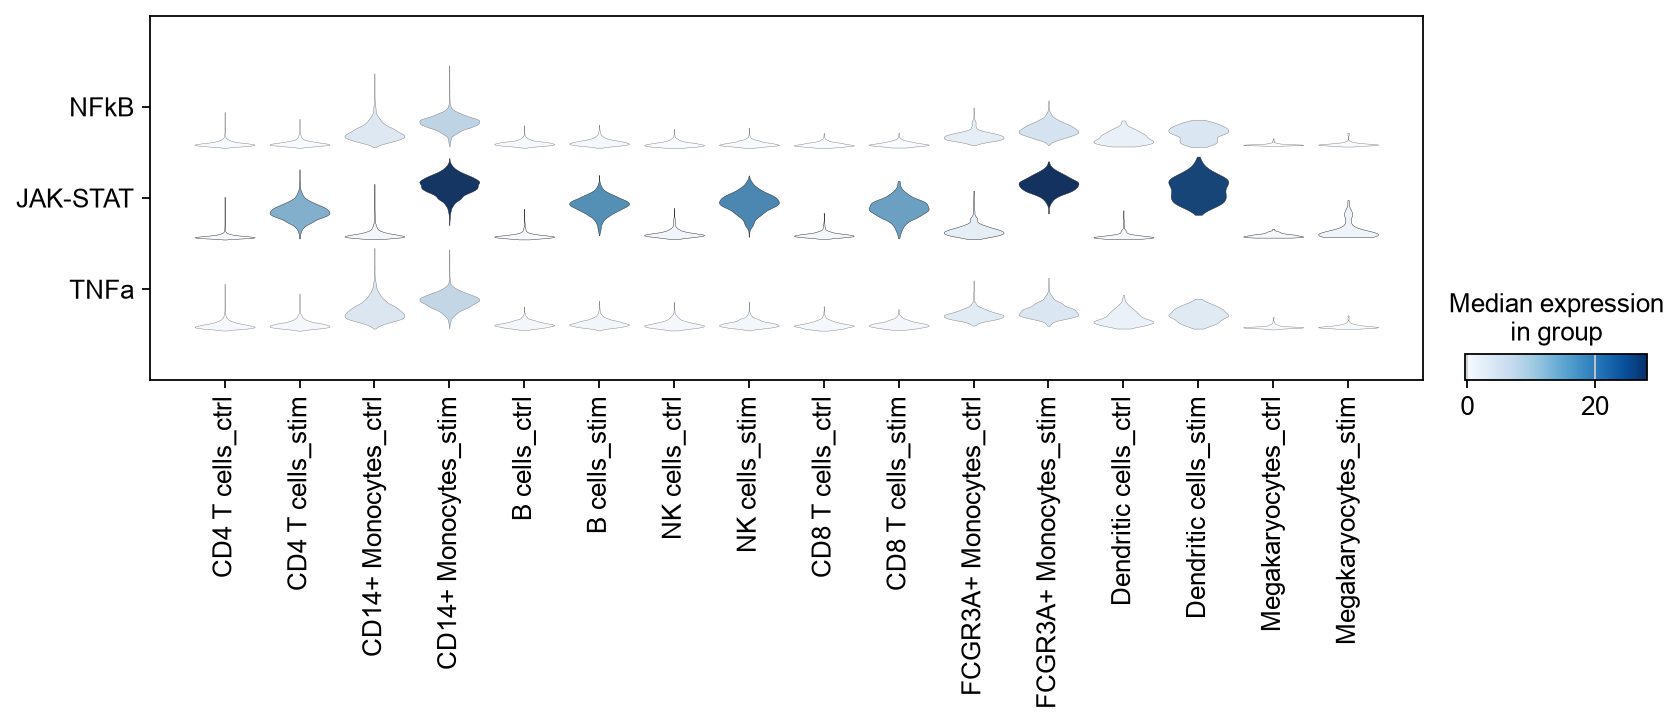
本例中,分数最高的是 Janus 激酶–信号转导与转录激活因子通路(Janus Kinase–Signal Transducer and Activator of Transcription, JAK–STAT)。该通路可由结合受体的干扰素触发,例如 IFN-。其他免疫通路 核因子 κB(nuclear factor kappa B, NF-κB) 和 肿瘤坏死因子 α(tumor necrosis factor alpha, TNF-α) 整体变化较小。已知 IFN 相关通路理应排在前列,因此 AUCell 与 ULM 的结果相互吻合,符合预期的生物学响应。
细胞群体对比的富集评分
前面计算的是单个细胞的功能条目分数,现在转向细胞群体之间的比较。为此,先按样本与细胞类型的组合汇总为伪 bulk(pseudobulk),再对这些 pseudobulk 数据进行 DGE 分析,避免把细胞当作独立生物学重复而夸大统计显著性 Squair et al., 2021。DGE 分析使用 pydeseq2 完成。
因此,这一步直接承接 DGE 分析流程。如果尚未对数据开展 DGE 分析,可参阅 DGE 分析章节 了解详情。本教程直接加载此前计算的 CD14+ 单核细胞在不同条件间的 DGE 结果。
res_df = ln.Artifact.get(
    key="conditions/differential_gene_expression/res_df_CD14_Monocytes.parquet"
).load()
res_df虽然可以选用多种统计量,但建议优先使用标准化检验统计量(文中称为 t-values),而不是 log2FCs。类似 t-values 的统计量同时反映变化幅度与估计的不确定性。下面将这些 t-values 对应的数据(本例实际为 DESeq2 的 Wald 统计量(Wald statistic),所在列名为 "stat")转换为宽矩阵格式,以便传入 decoupler。
res_df = res_df.set_index("variable")
data = res_df[["stat"]].T.rename(index={"stat": "stim.vs.ctrl"})
data使用 GSEA 对基因集评分
准备好基因统计量后,就可推断通路分数;这里采用的 GSEA 实现 Subramanian et al., 2005 来自 decoupler。运行 dc.mt.gsea 会返回富集分数和经 Benjamini–Hochberg 校正(Benjamini–Hochberg correction, BH)的 p 值。
score, padj = dc.mt.gsea(data=data, net=reactome)

mask = (padj.T < 0.05).iloc[:, 0]
score = score.loc[:, mask]
score接下来展示正向和负向富集最明显的通路。
fig = dc.pl.barplot(data=score, name="stim.vs.ctrl", top=15, return_fig=True)

ax = fig.axes[0]
ax.tick_params(axis="y", labelsize=8)
plt.show()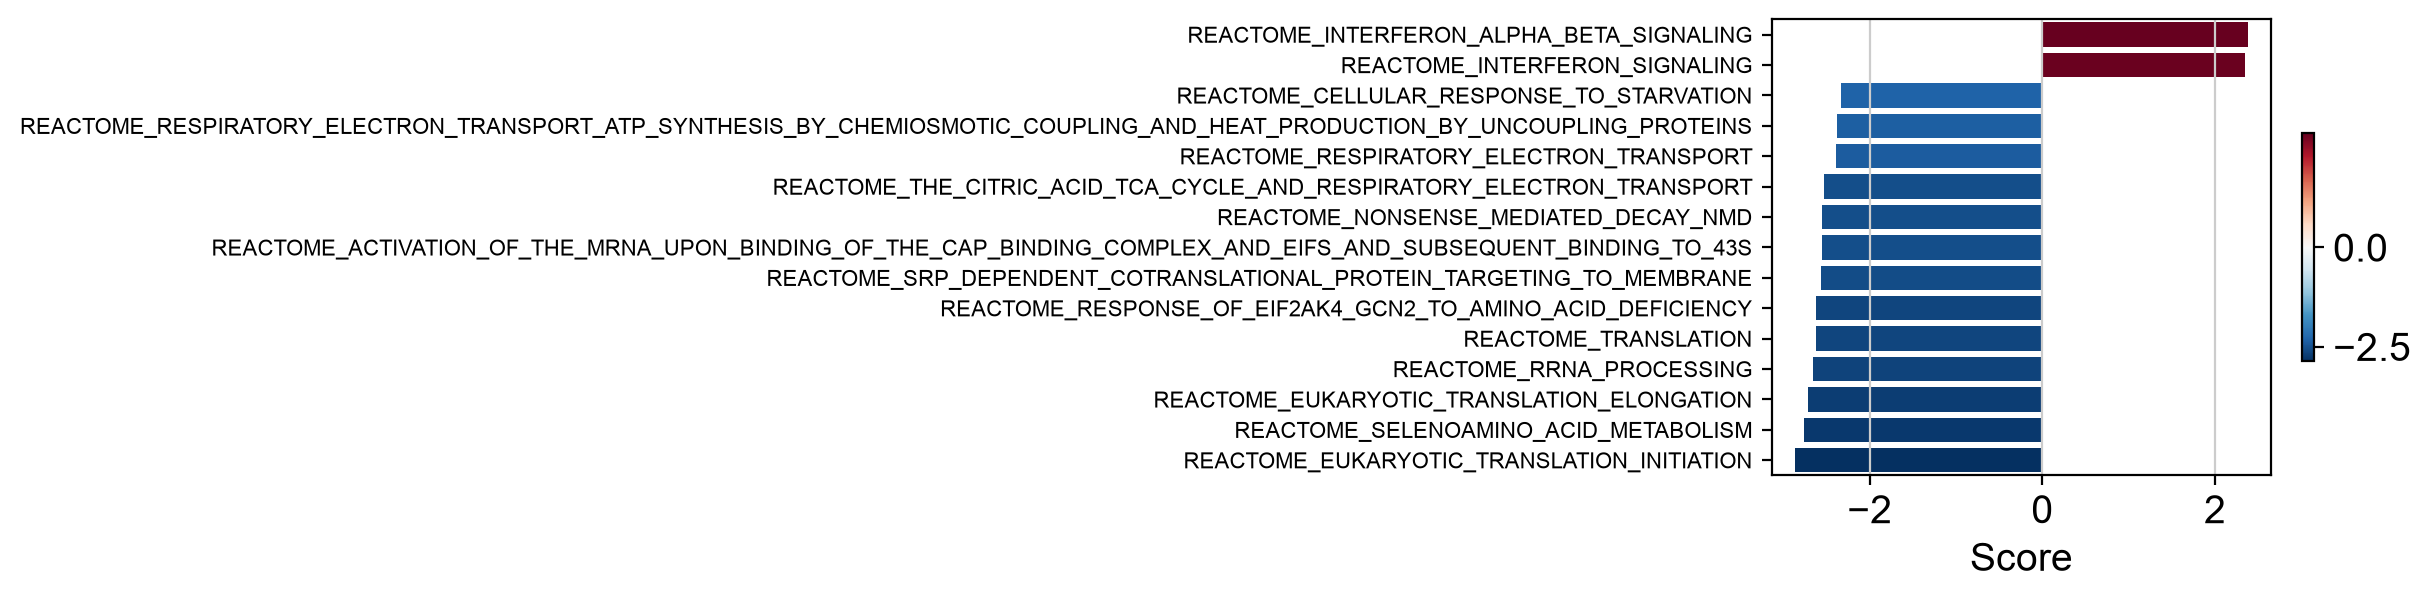
纵轴为通路,横轴为 GSEA 富集分数。分数带有正负号:正分表示通路相关基因倾向上调,负分表示倾向下调;绝对值越大,富集越强。图中按方向和幅度选取前 15 条通路。大多数干扰素相关通路确实呈正向富集,与预期方向一致。
使用 ULM 对调控足迹评分
再次使用 DGE 结果,但这次将 PROGENy 调控足迹与 ULM 方法结合。
score, padj = dc.mt.ulm(data=data, net=progeny)
mask = (padj.T < 0.05).iloc[:, 0]
score.loc[:, mask]与 GSEA 类似,ULM 返回带正负号的富集分数,以及经 Benjamini–Hochberg 方法校正的 p 值。分数反映上调或下调的方向与程度。虽然本例仅 JAK-STAT 和 NFkB 的结果显著,下面仍展示所用 PROGENy 数据中全部 13 条通路:
dc.pl.barplot(
    data=score,
    name="stim.vs.ctrl",
)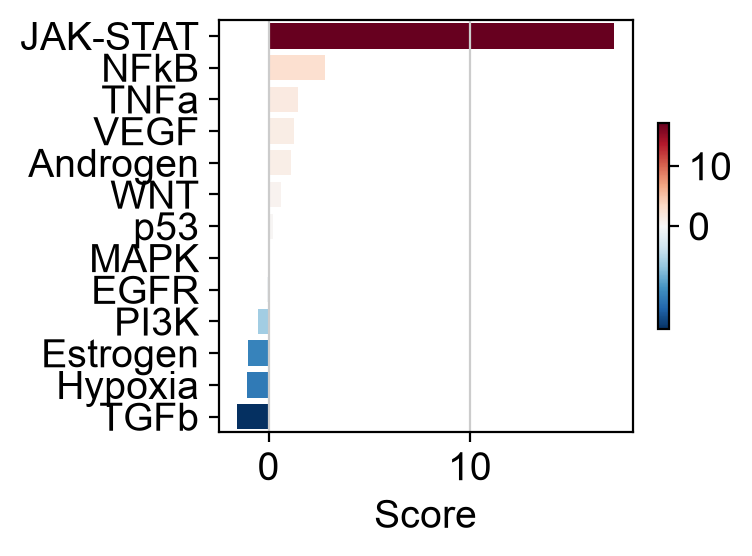
与前一节一致,JAK–STAT 是由干扰素诱导的通路(例如 IFN-);与对照相比,它在受刺激的 CD14+ 单核细胞中分数最高。
沿伪时间的富集评分
组学分析不局限于处理组与对照组等离散分组之间的比较。细胞分化、疾病进展和发育等许多生物过程是连续的,此时需要评估各个 feature 及其富集分数随这些过程变化的 轨迹。
本节所用的成人骨髓数据集 Setty et al., 2019 来自 此前的伪时间(pseudotime)排序章节;根据该章结论,我们采用 Palantir 推断的 伪时间 开展后续分析。
adata = ln.Artifact.get(key="trajectories/pseudotemporal/bonemarrow_result.h5ad").load()
adata
AnnData object with n_obs × n_vars = 5780 × 11975
obs: 'clusters', 'palantir_pseudotime', 'palantir_diff_potential', 'dpt_pseudotime'
var: 'palantir', 'n_counts', 'highly_variable', 'means', 'dispersions', 'dispersions_norm'
uns: 'clusters_colors', 'diffmap_evals', 'hvg', 'iroot', 'log1p', 'neighbors', 'palantir_branch_probs_cell_types', 'pca'
obsm: 'MAGIC_imputed_data', 'X_diffmap', 'X_pca', 'X_tsne', 'palantir_branch_probs'
varm: 'PCs'
obsp: 'connectivities', 'distances'
layers: 'spliced', 'unspliced', None (.X)这里使用 GRN 对 TF 评分,而不再使用代表特定通路的基因集。TF 是能够结合 DNA 并调控靶基因表达的蛋白质,既可促进也可抑制转录。由于 TF 的转录本水平往往不能直接反映其实际活性,我们通过靶基因的富集情况评估 TF 活性 Badia-i-Mompel et al., 2023。GRN 记录 TF 与靶基因之间的调控关系,因此能更准确地反映调控活性。同样,分数的正负号与大小反映 TF 活性升高或降低的方向与程度。更多细节见 基因调控网络章节。
为此,使用 CollecTRI 网络。这是一份经整理的综合资源,包含 TF 及其靶基因 Müller-Dott et al., 2023。可以通过 decoupler 按如下方式获取该网络:
collectri = dc.op.collectri(organism="human")与前面一样,为保持教程结果稳定、便于复现,下面使用固定版本的网络。
collectri = ln.Artifact.get(key="conditions/gsea_pathway/collectri.parquet").load()
collectri运行 ulm 方法即可计算 TF 分数。
dc.mt.ulm(data=adata, net=collectri)随后可将分数提取为一个新的 AnnData 对象。
score = dc.pp.get_obsm(adata=adata, key="score_ulm")
score
AnnData object with n_obs × n_vars = 5780 × 598
obs: 'clusters', 'palantir_pseudotime', 'palantir_diff_potential', 'dpt_pseudotime'
uns: 'clusters_colors', 'diffmap_evals', 'hvg', 'iroot', 'log1p', 'neighbors', 'palantir_branch_probs_cell_types', 'pca'
obsm: 'MAGIC_imputed_data', 'X_diffmap', 'X_pca', 'X_tsne', 'palantir_branch_probs', 'score_ulm', 'padj_ulm'
layers: None (.X)接下来,识别与所推断伪时间相关的 TF。
tfs = dc.tl.rankby_order(
    adata=score,
    order="palantir_pseudotime",
    stat="dcor",
)
tfs提取与伪时间相关性排名前 5 的 TF 标记。
top_tfs = tfs.head(5)["name"].to_list()
top_tfs
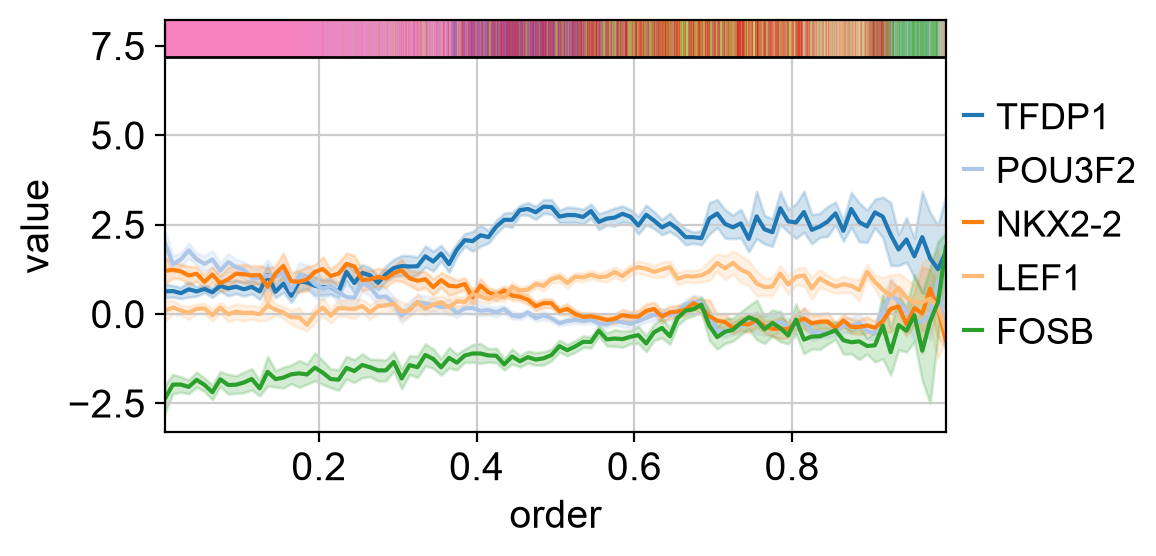
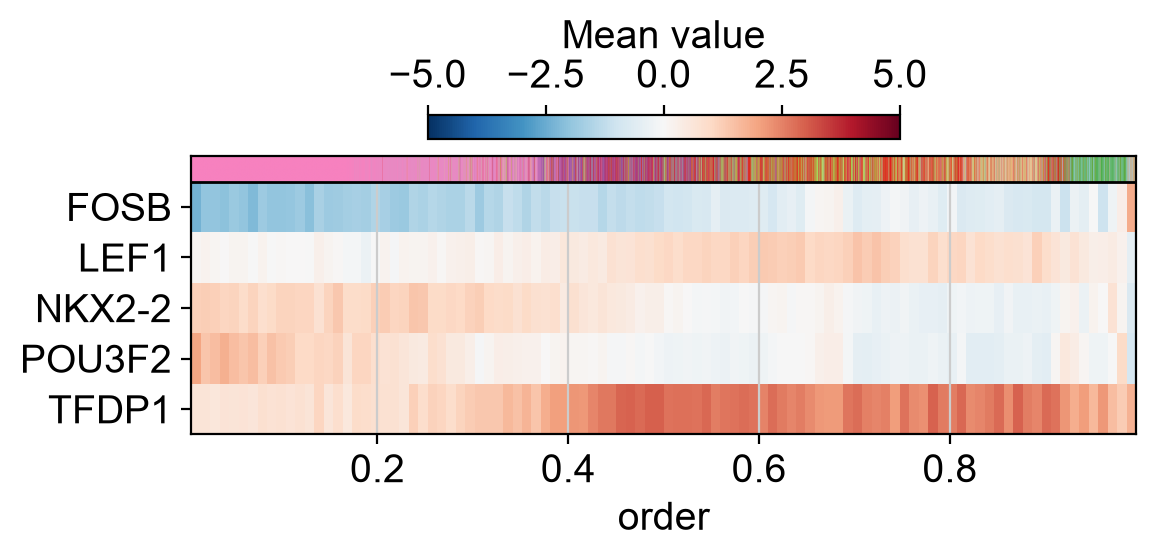
['TFDP1', 'POU3F2', 'NKX2-2', 'LEF1', 'FOSB']并将结果可视化。
score.obs["clusters"].unique()['Ery_1', 'HSC_1', 'Mono_1', 'Precursors', 'Mega', 'HSC_2', 'Mono_2', 'Ery_2', 'DCs', 'CLP']
Categories (10, object): ['HSC_1', 'HSC_2', 'Ery_1', 'Mono_1', ..., 'Mono_2', 'DCs', 'Ery_2', 'Mega']sc.pl.tsne(
score,
color=top_tfs + ["clusters", "palantir_pseudotime"],
ncols=2,
color_map="gnuplot2",
)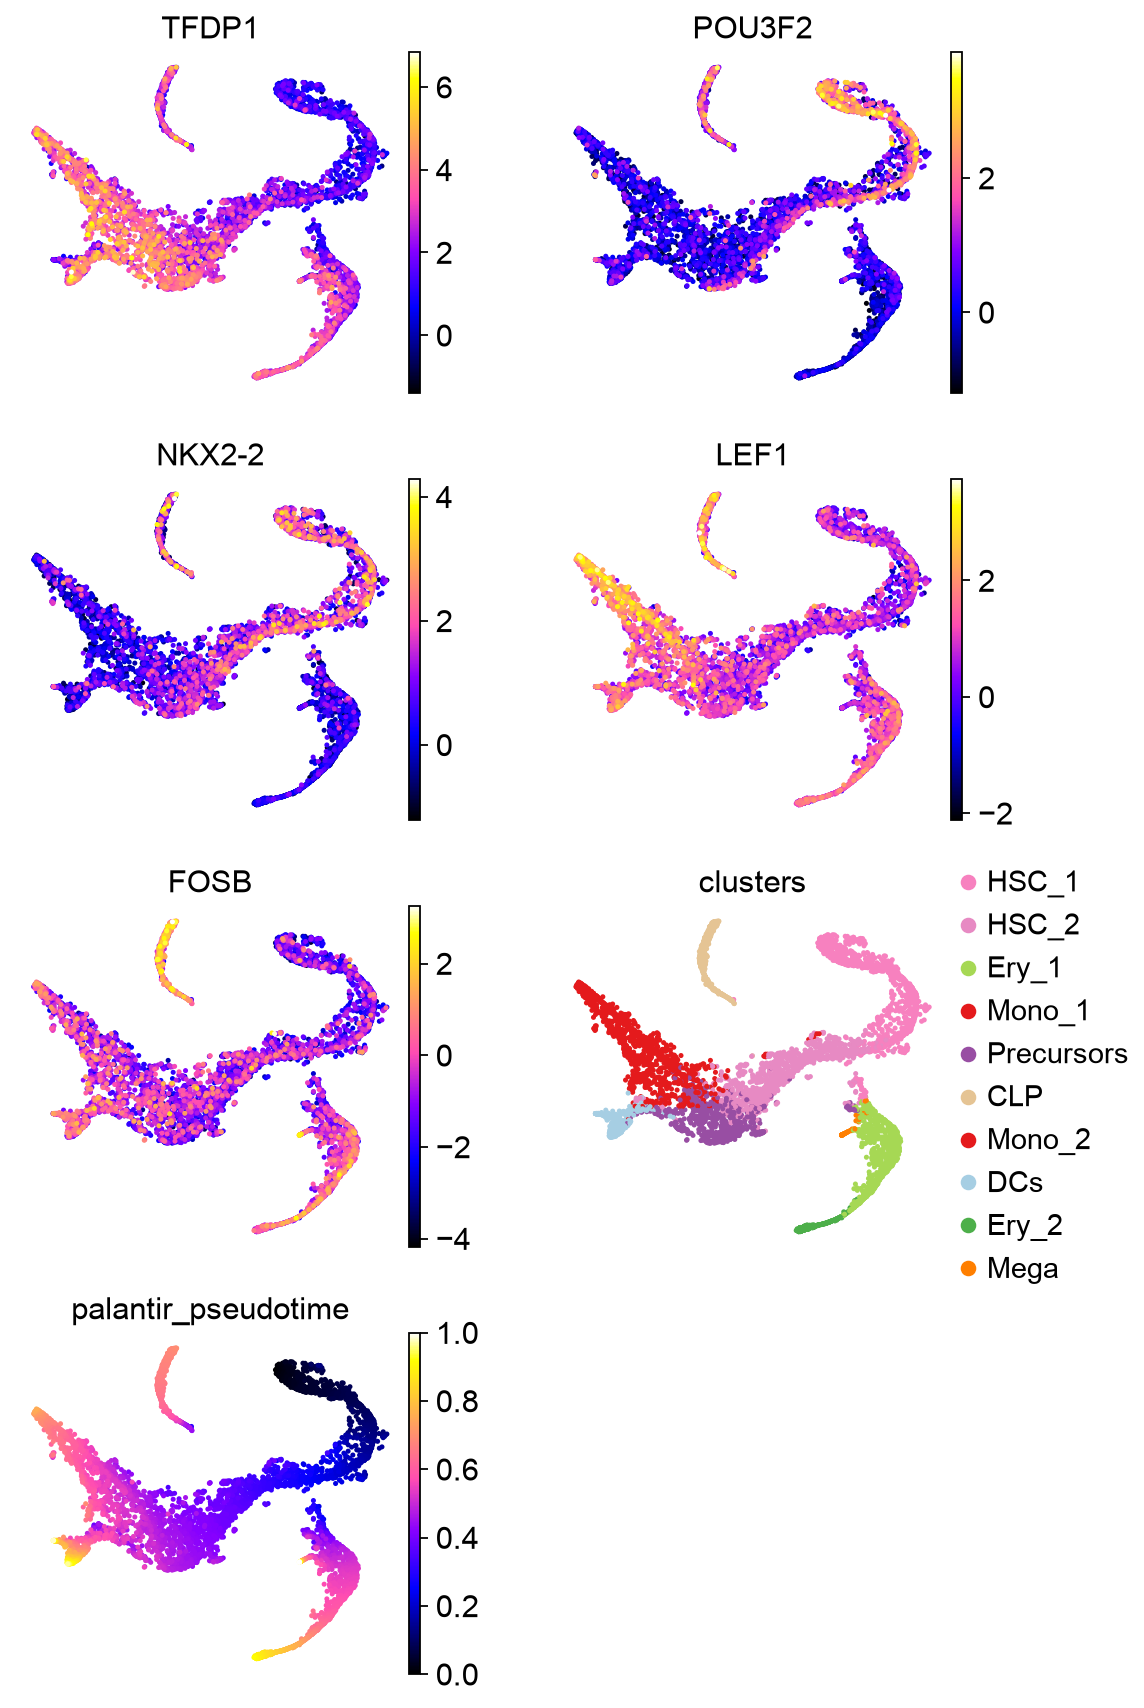
例如,LEF-1 在淋巴细胞分化中发挥关键作用 Petropoulos et al., 2008,因此它在共同淋巴祖细胞(Common Lymphoid Progenitor, CLP)中的活性升高具有生物学依据。FOSB 是 AP-1 的一个亚基,参与造血前体细胞向成熟血细胞的功能发育,其作用也支持了伪时间后期活性升高的结果 Liebermann et al., 1998。
在绘制更复杂的图形之前,先按细胞的排序分箱,以便展示。
bin_tfs = dc.pp.bin_order(
    adata=score,
    order="palantir_pseudotime",
    names=top_tfs,
    label="clusters",
)
bin_tfs结果可以绘制为折线图。
dc.pl.order(
    df=bin_tfs,
    mode="line",
    figsize=(6, 3),
)
也可以绘制为矩阵图。
dc.pl.order(
    df=bin_tfs,
    mode="mat",
    kw_order={"vmin": -5, "vmax": +5, "cmap": "RdBu_r"},
    figsize=(6, 3),
)
此外,可以沿轨迹绘制指定 TF 的靶基因表达,以帮助理解得到的富集分数。
dc.pl.order_targets(
    adata=adata,
    net=collectri,
    label="clusters",
    source="FOSB",
    order="palantir_pseudotime",
)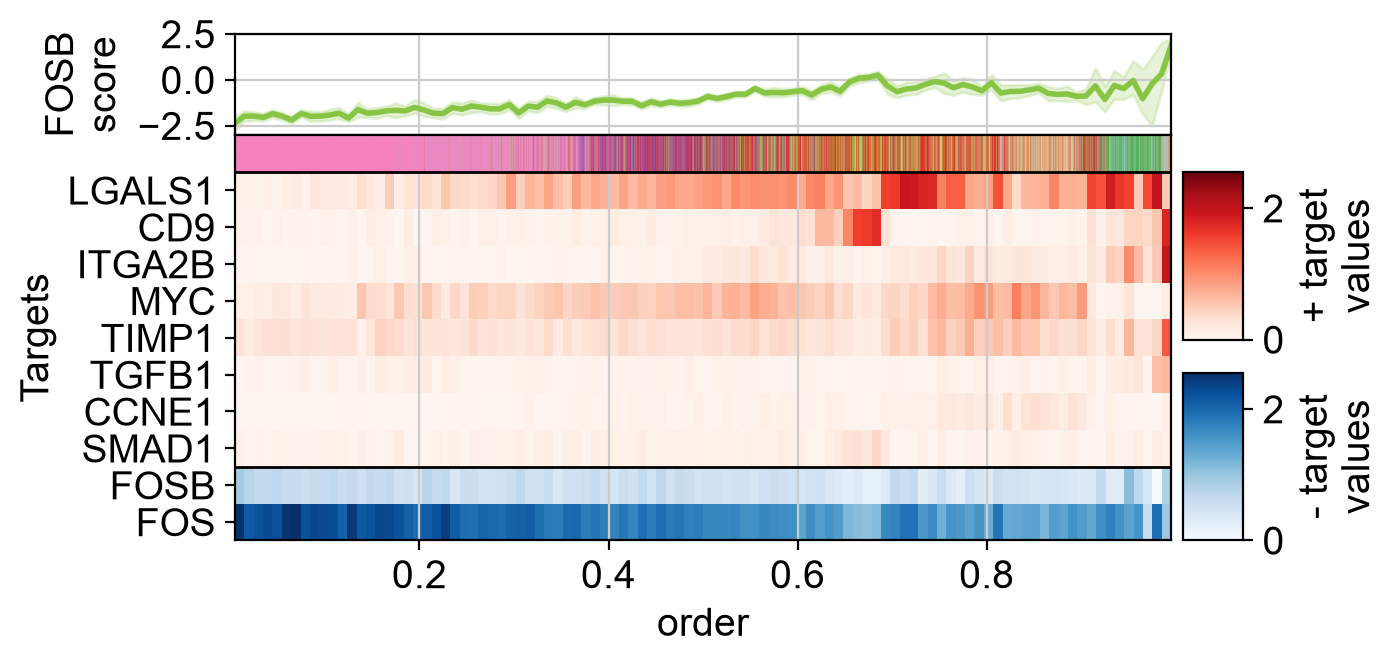
沿轨迹前进,FOSB 正向调控的靶基因表达升高,而其抑制的靶基因表达降低,因而富集分数发生变化。这表明该 TF 的推断活性从轨迹起点的较低水平升至终点的较高水平。
空间富集分析
最后,富集分析也可用于空间转录组学(spatial transcriptomics)数据。本例使用 Visium 对慢性活动性多发性硬化病灶进行测量,获得约 4,000 个空间捕获点(spot)(每个点相当于一个小型 bulk 样本),覆盖约 1.5 万个基因 Lerma-Martin et al., 2024。这里再次使用 CollecTRI 刻画 TF 活性,并将结果置于组织的空间背景中解读。
adata = ln.Artifact.get(key="conditions/gsea_pathway/msvisium.h5ad").load()
adata
AnnData object with n_obs × n_vars = 3839 × 14940
obs: 'array_row', 'array_col', 'niches'
uns: 'spatial'
obsm: 'spatial'
layers: None (.X)下面先将数据归一化,再存入一个层,供后续使用。
sc.pp.normalize_total(adata, target_sum=1e4)
sc.pp.log1p(adata)

adata.layers["norm"] = adata.X.copy()
可以查看存储于 obs 中的 spot 元数据。
adata.obs数据集还包含原始论文提供的组织 注释:
灰质(Grey Matter, GM)
病灶核心(Lesion Core, LC)
病灶边缘(Lesion Rim, LR)
斑块周围白质(PeriPlaque White Matter, PPWM)
血管浸润区(Vascular Infiltrating, VI)
可以展示苏木精–伊红染色(hematoxylin and eosin staining, H&E)图像,以及不同注释区域(niche)。
adataAnnData object with n_obs × n_vars = 3839 × 14940
obs: 'array_row', 'array_col', 'niches'
uns: 'spatial', 'log1p'
obsm: 'spatial'
layers: None (.X), 'norm'sq.pl.spatial_scatter(adata, color=[None, "niches"], size=1.5, ncols=1)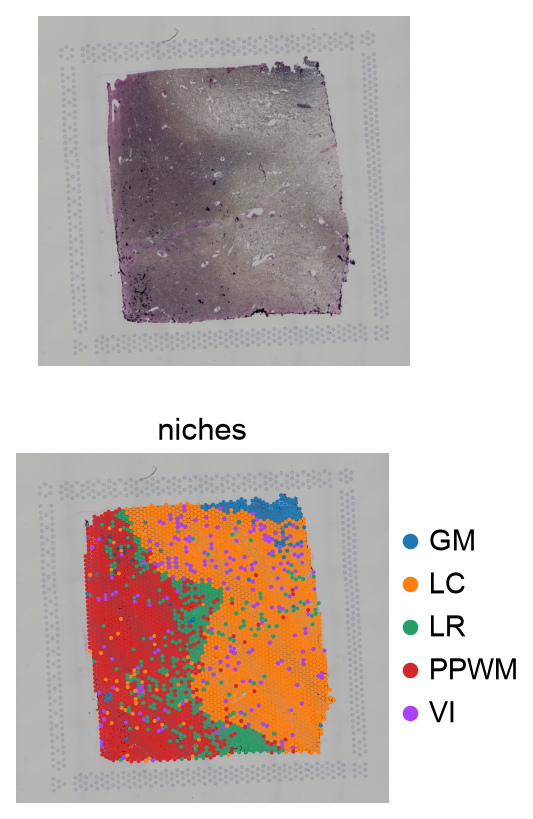
空间加权
空间数据通常较为 稀疏。为此,可以利用空间邻近点的表达水平 插补 目标点的基因表达 Dimitrov et al., 2024。具体而言,先为各 spot 计算空间权重,再将权重应用于基因表达值,从而平滑数据。
dc.pp.knn(adata, key="spatial", bw=100, cutoff=0.1)随后可以展示分配给各 spot 的空间权重。
# Plot the spatial weights of one spot
adata.obs["conn"] = adata.obsp["spatial_connectivities"][0].toarray().ravel()
sq.pl.spatial_scatter(adata, color="conn", size=1.5)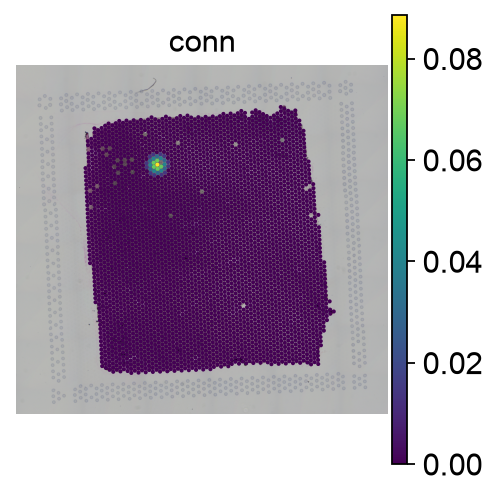
对于一个给定 spot,其自身位置的空间权重最大,其他位置的权重随距离增大而减小。调整带宽(bw)可以扩大或缩小考虑的空间范围。接下来对基因表达值进行空间加权。
# Update X with spatially weighted gene exression
adata.X = adata.obsp["spatial_connectivities"].dot(adata.X)
可以将原始的对数归一化 Count 与经过空间变换的值并排展示。
genes = ["MOG", "CD163", "IGKC"]

# Log-normalized counts
sq.pl.spatial_scatter(adata, color=genes, size=1.5, layer="norm")

# Spatially weighted gene expression
sq.pl.spatial_scatter(adata, color=genes, size=1.5)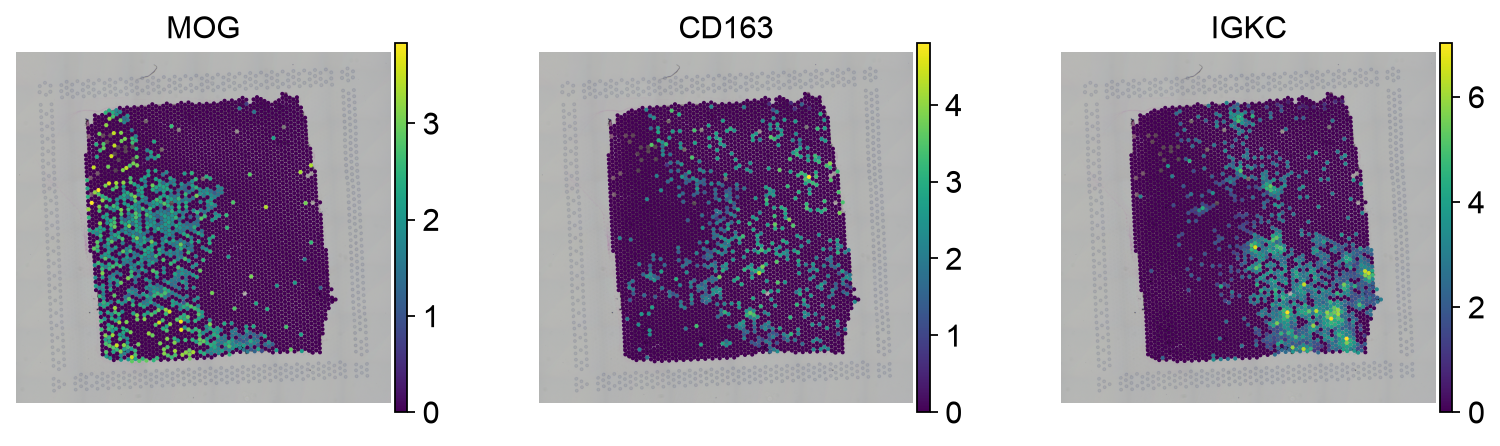
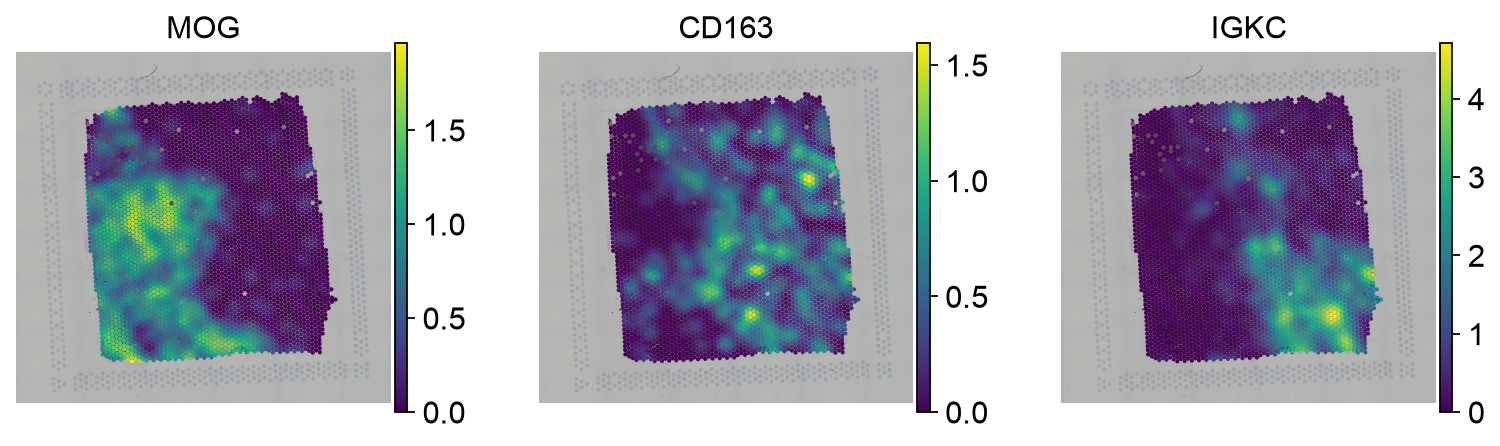
平滑后,如果一个 spot 周围的其他 spot 也表达同一基因,其数值通常会高于周围缺乏高表达邻点的 spot;后者即使自身原先表达较高,也可能因平滑而降低。
这些基因的表达呈现出空间分区。
评分
现在再次使用 ulm 方法,结合此前加载的 collectri 计算 TF 分数。
dc.mt.ulm(data=adata, net=collectri)然后提取分数。
score = dc.pp.get_obsm(adata=adata, key="score_ulm")
score
AnnData object with n_obs × n_vars = 3839 × 660
obs: 'array_row', 'array_col', 'niches', 'conn'
uns: 'spatial', 'log1p', 'niches_colors'
obsm: 'spatial', 'score_ulm', 'padj_ulm'
layers: None (.X)将得到的分数可视化。
tf = "RFX5"
sq.pl.spatial_scatter(
    score,
    color=[tf, "niches"],
    cmap="RdBu_r",
    vcenter=0,
    size=1.5,
    title=[f"{tf} score", "niches"],
)
sc.pl.violin(score, keys=tf, groupby="niches", rotation=90, ylabel=f"{tf} score")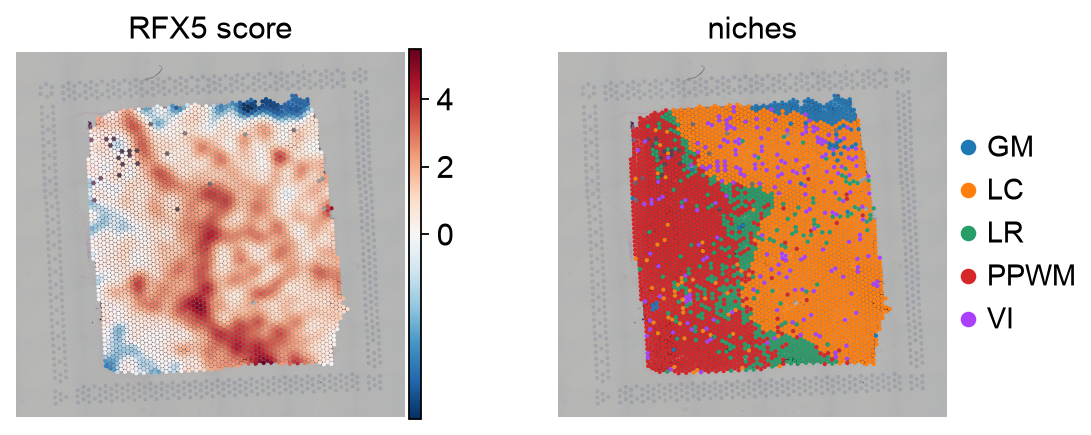
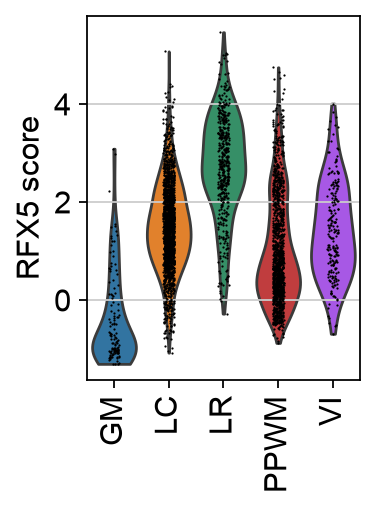
本例中,抗原呈递细胞的关键调控因子 RFX5 呈现明显的空间模式:病灶边缘(LR)的推断活性高于组织的其他区域。这与抗原呈递细胞分布在该区域、吞噬来自病灶核心的细胞碎片这一已知现象一致。
还可以将其与 RFX5 基因的实际表达值进行比较。
tf = "RFX5"
sq.pl.spatial_scatter(
    adata, color=[tf, "niches"], size=1.5, title=[f"{tf} expression", "niches"]
)
sc.pl.violin(adata, keys=tf, groupby="niches", rotation=90, ylabel=f"{tf} expression")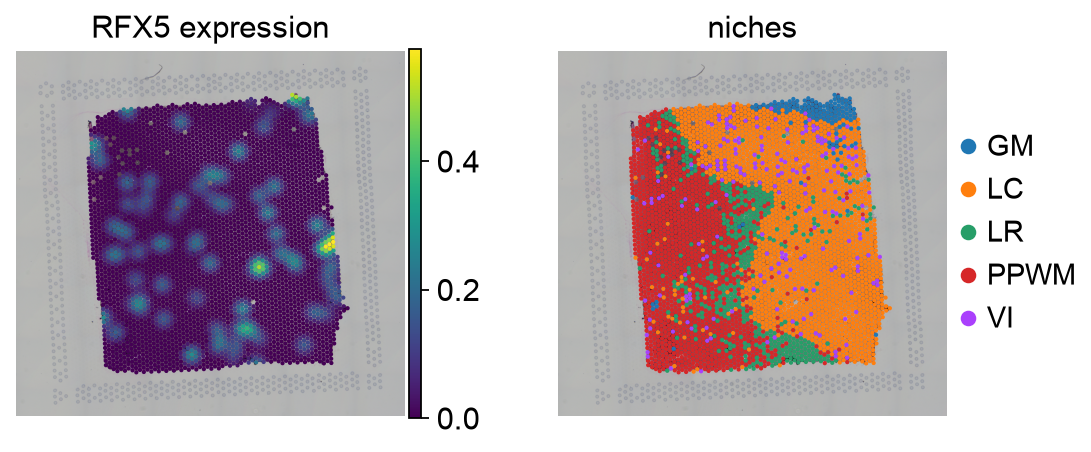
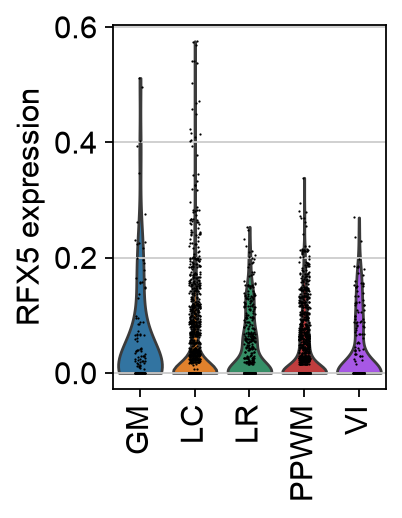
相比之下,RFX5 的表达分散于组织各处,未呈现清晰的空间模式。TF 的转录本表达往往较零散,仅凭表达量难以判断它是否在细胞中活跃,这也说明富集分数有助于生物学解读 Badia-i-Mompel et al., 2023。
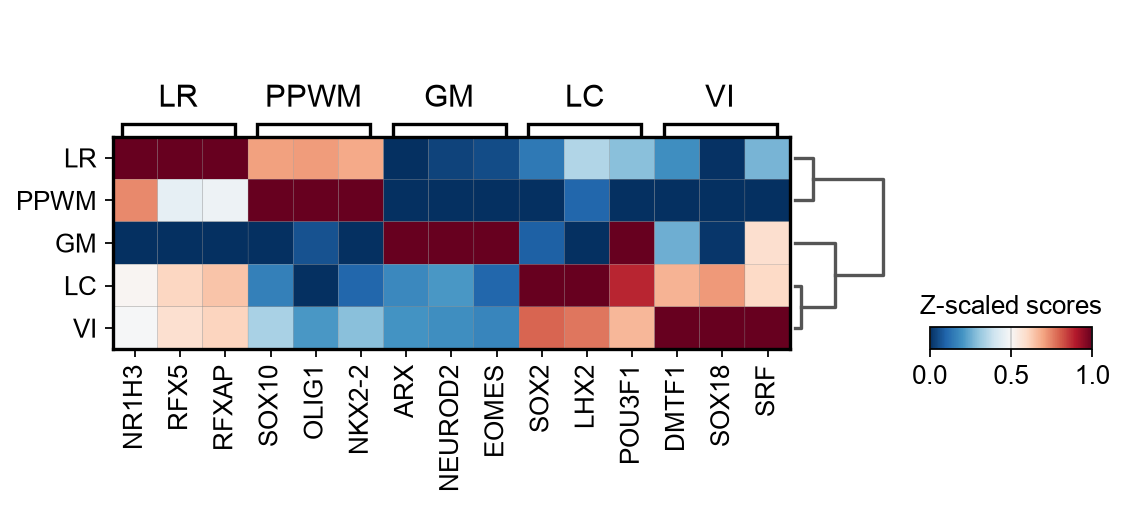
接下来,识别每个区域的 TF 标记。
df = dc.tl.rankby_group(
    adata=score, groupby="niches", reference="rest", method="t-test_overestim_var"
)
df = df[df["stat"] > 0.0]
df提取每个区域排名前 3 的 TF 标记。
n_markers = 3
source_markers = (
    df.groupby("group", observed=False)
    .head(n_markers)
    .drop_duplicates("name")
    .groupby("group", observed=False)["name"]
    .apply(lambda x: list(x))
    .to_dict()
)
source_markers
{'GM': ['ARX', 'NEUROD2', 'EOMES'],
'LC': ['SOX2', 'LHX2', 'POU3F1'],
'LR': ['NR1H3', 'RFX5', 'RFXAP'],
'PPWM': ['SOX10', 'OLIG1', 'NKX2-2'],
'VI': ['DMTF1', 'SOX18', 'SRF']}绘制得到的标记。
sc.tl.dendrogram(adata=score, groupby="niches")
sc.pl.matrixplot(
    adata=score,
    var_names=source_markers,
    groupby="niches",
    dendrogram=True,
    standard_scale="var",
    colorbar_title="Z-scaled scores",
    cmap="RdBu_r",
)
也可以通过分数的分布,单独考察某个 TF。
tf = "OLIG1"
sq.pl.spatial_scatter(
    score,
    color=[tf, "niches"],
    cmap="RdBu_r",
    vcenter=0,
    size=1.5,
    title=[f"{tf} score", "niches"],
)
sc.pl.violin(score, keys=[tf], groupby="niches", rotation=90, ylabel=f"{tf} score")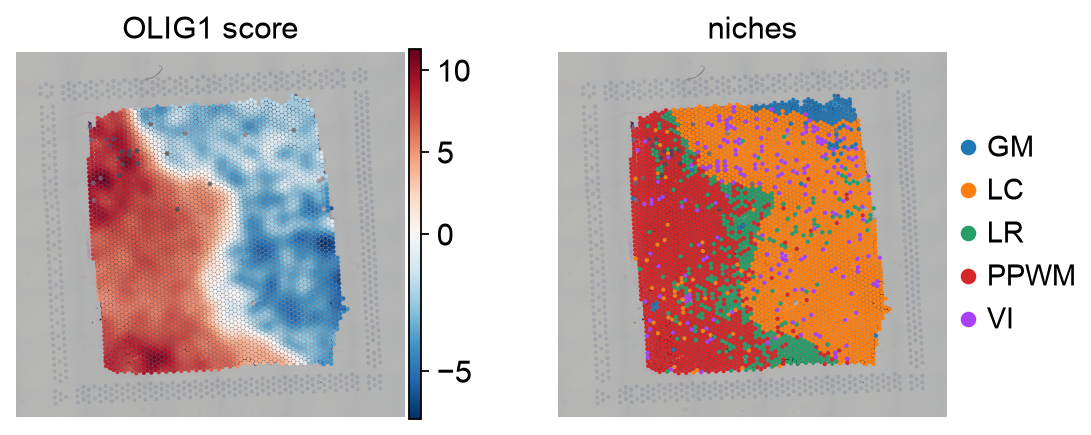
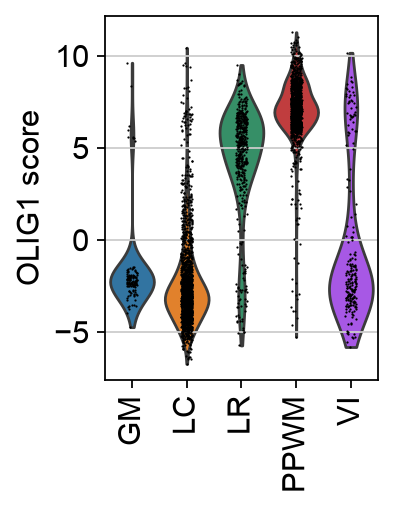
这里展示的是 OLIG1 的推断活性。OLIG1 是少突胶质细胞的已知 TF 标记,这些细胞存在于斑块周围白质(PPWM)。
基因集之间的冗余
关系密切的基因集通常有较多重叠,原因可能是它们属于同一本体体系,或描述了功能相近的生物过程。例如,本数据集中,REACTOME_INTERFERON_ALPHA_BETA_SIGNALING 和 REACTOME_INTERFERON_SIGNALING 都呈现富集;前者描述更具体的免疫反应,后者描述更广泛的免疫信号。此类重叠会影响基因集在富集结果中的排名。解读时应关注所研究生物系统的整体状态;本例明确提示免疫信号传导可能正在发生。此外,可根据研究问题选择适合的基因集与调控足迹资源,以减少潜在假阳性。富集分析框架通过提供具有不同零假设的检验,并将先验知识纳入计算方法,帮助解释生物学结果。
另见
本章主要改编自 decoupler 教程。更多细节请参阅相应的教程示例。
选择题
贡献者
我们衷心感谢以下人员的贡献:
作者
Soroor Hediyeh-Zadeh
Pau Badia-i-Mompel
Isaac Virshup
Luis Heinzlmeier
审阅者
Lukas Heumos
Anastasia Litinetskaya
- Subramanian, A., Tamayo, P., Mootha, V. K., Mukherjee, S., Ebert, B. L., Gillette, M. A., Paulovich, A., Pomeroy, S. L., Golub, T. R., Lander, E. S., & others. (2005). Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proceedings of the National Academy of Sciences, 102(43), 15545–15550.
- Liberzon, A., Subramanian, A., Pinchback, R., Thorvaldsdóttir, H., Tamayo, P., & Mesirov, J. P. (2011). Molecular signatures database (MSigDB) 3.0. Bioinformatics, 27(12), 1739–1740.
- Zhang, X., Lan, Y., Xu, J., Quan, F., Zhao, E., Deng, C., Luo, T., Xu, L., Liao, G., Yan, M., & others. (2019). CellMarker: a manually curated resource of cell markers in human and mouse. Nucleic Acids Research, 47(D1), D721–D728.
- Franzén, O., Gan, L.-M., & Björkegren, J. L. (2019). PanglaoDB: a web server for exploration of mouse and human single-cell RNA sequencing data. Database, 2019.
- Szalai, B., & Saez-Rodriguez, J. (2020). Why do pathway methods work better than they should? FEBS Letters, 594(24), 4189–4200.
- Dugourd, A., & Saez-Rodriguez, J. (2019). Footprint-based functional analysis of multiomic data. Current Opinion in Systems Biology, 15, 82–90.
- Schubert, M., Klinger, B., Klünemann, M., Sieber, A., Uhlitz, F., Sauer, S., Garnett, M. J., Blüthgen, N., & Saez-Rodriguez, J. (2018). Perturbation-response genes reveal signaling footprints in cancer gene expression. Nature Communications, 9(1), 1–11.
- Jiang, P., Zhang, Y., Ru, B., Yang, Y., Vu, T., Paul, R., Mirza, A., Altan-Bonnet, G., Liu, L., Ruppin, E., Wakefield, L., & Wucherpfennig, K. W. (2021). Systematic investigation of cytokine signaling activity at the tissue and single-cell levels. Nature Methods, 18(10), 1181–1191.
- Garcia-Alonso, L., Holland, C. H., Ibrahim, M. M., Turei, D., & Saez-Rodriguez, J. (2019). Benchmark and integration of resources for the estimation of human transcription factor activities. Genome Research, 29(8), 1363–1375.
- Squair, J. W., Gautier, M., Kathe, C., Anderson, M. A., James, N. D., Hutson, T. H., Hudelle, R., Qaiser, T., Matson, K. J. E., Barraud, Q., Levine, A. J., La Manno, G., Skinnider, M. A., & Courtine, G. (2021). Confronting false discoveries in single-cell differential expression. Nature Communications, 12(1), 5692.
- Crowell, H. L., Soneson, C., Germain, P.-L., Calini, D., Collin, L., Raposo, C., Malhotra, D., & Robinson, M. D. (2020). muscat detects subpopulation-specific state transitions from multi-sample multi-condition single-cell transcriptomics data. Nature Communications, 11(1), 6077.
- Holland, C. H., Tanevski, J., Perales-Patón, J., Gleixner, J., Kumar, M. P., Mereu, E., Joughin, B. A., Stegle, O., Lauffenburger, D. A., Heyn, H., & others. (2020). Robustness and applicability of transcription factor and pathway analysis tools on single-cell RNA-seq data. Genome Biology, 21(1), 1–19.
- Qoku, A., & Buettner, F. (2022). Encoding Domain Knowledge in Multi-view Latent Variable Models: A Bayesian Approach with Structured Sparsity. arXiv.
- Kunes, R. Z., Walle, T., Nawy, T., & Pe’er, D. (2022). Supervised discovery of interpretable gene programs from single-cell data. bioRxiv.
- Zhang, Y., Ma, Y., Huang, Y., Zhang, Y., Jiang, Q., Zhou, M., & Su, J. (2020). Benchmarking algorithms for pathway activity transformation of single-cell RNA-seq data. Computational and Structural Biotechnology Journal, 18, 2953–2961.