⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: preprocessing
channels:
  - bioconda
  - conda-forge
dependencies:
  - conda-forge::ipywidgets=8.1.5
  - conda-forge::leidenalg=0.10.2
  - conda-forge::numba=0.61.0
  - conda-forge::python=3.12.9
  - conda-forge::r-base=4.3.3
  - conda-forge::r-soupx=1.6.2
  - conda-forge::r-sctransform=0.4.1
  - conda-forge::r-glmpca=0.2.0
  - conda-forge::rpy2=3.5.11
  - conda-forge::scanpy=1.11.1
  - conda-forge::session-info=1.0.0
  - bioconda::anndata2ri=1.3.2
  - bioconda::bioconductor-scdblfinder=1.16.0
  - bioconda::bioconductor-scry=1.14.0
  - bioconda::bioconductor-scran=1.30.0
  - bioconda::bioconductor-glmgampoi=1.14.0
  - pip
  - pip:
      - lamindb[bionty,jupyter]
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
至此,我们已经从数据集中移除了低质量细胞、背景游离 RNA(ambient RNA) 污染和双细胞(Doublet),数据现在以计数矩阵(count matrix)的形式存在,承载于一个 numeric matrix of shape cells x genes。这些计数代表着 单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq) 实验中一个分子的捕获、逆转录(reverse transcription, RT)和 测序 过程。其中每一步都会给相同细胞的测量计数深度(count depth)带来一定的变异,因此计数数据中细胞间基因表达的差异,可能仅仅源于采样效应。这意味着数据集(以及由此得到的计数矩阵)仍然包含差异很大的方差项。分析这样的数据集往往颇具挑战,因为许多统计方法都假定数据具有均匀的方差结构。
伽马-泊松分布
理论与经验均支持采用伽马–泊松分布(gamma–Poisson distribution)对 唯一分子标识符(unique molecular identifier, UMI) 数据建模,其二次均值–方差关系为 ,其中均值为 ,过度离散(overdispersion)参数为 。当 ,这就是泊松分布(Poisson distribution),而 描述的是在泊松分布之上额外的方差。
归一化(normalization)旨在通过把可观测的方差缩放到指定范围,来校正数据集中由采样效应变化所带来的原始计数差异。实践中会用到多种复杂程度各异的归一化技术。
Ahlmann-Eltze 和 Huber 最近发表的一项基准研究 Ahlmann-Eltze & Huber, 2023 比较了 22 种不同的归一化算法。值得注意的是,目前仍缺乏一项同时比较归一化对各种不同下游分析任务影响的基准研究。我们建议分析人员谨慎选择归一化方法,并始终结合后续的分析任务来评估。
本章将介绍三种归一化技术:移位对数(shifted logarithm)变换、scran 归一化和解析式皮尔逊残差(analytic Pearson residuals)。移位对数有助于稳定方差,适用于后续降维(dimensionality reduction)和识别 差异表达基因。scran 经过了广泛测试,常用于 批次 校正(batch correction)任务;而解析式皮尔逊残差则非常适合用于选择具有生物学变异性的基因,以及识别稀有细胞类型。
我们首先导入所有所需的 Python 软件包,并加载我们已过滤低质量细胞、去除环境 RNA 并对双细胞进行评分后的数据集。
import logging

import lamindb as ln
import numpy as np
import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro
import scanpy as sc
import seaborn as sns
from matplotlib import pyplot as plt
from rpy2.robjects import numpy2ri, pandas2ri
from rpy2.robjects.conversion import localconverter
from scipy.sparse import issparse

# Suppress verbose logging from Scanpy
sc.settings.verbosity = 0

# Set figure parameters for clean, minimal plots
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

assert ln.setup.settings.instance.slug == "theislab/sc-best-practices"

ln.track()

rcb.logger.setLevel(logging.ERROR)


%load_ext rpy2.ipython
输出
→ connected lamindb: theislab/sc-best-practices
→ loaded Transform('Z95qTilYUzGh0000'), re-started Run('fPEduYxk...') at 2025-05-30 16:34:38 UTC
→ notebook imports: lamindb==1.3.2 matplotlib==3.10.1 numpy==2.1.3 rpy2==3.5.11 scanpy==1.11.1 scipy==1.14.1 seaborn==0.13.2
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="preprocessing_visualization/s4d8_quality_control.h5ad", is_latest=True
)
adata = af.load()
adata
AnnData object with n_obs × n_vars = 14814 × 20223
obs: 'n_genes_by_counts', 'log1p_n_genes_by_counts', 'total_counts', 'log1p_total_counts', 'pct_counts_in_top_20_genes', 'total_counts_mt', 'log1p_total_counts_mt', 'pct_counts_mt', 'total_counts_ribo', 'log1p_total_counts_ribo', 'pct_counts_ribo', 'total_counts_hb', 'log1p_total_counts_hb', 'pct_counts_hb', 'outlier', 'mt_outlier', 'soupx_groups', 'scDblFinder_score', 'scDblFinder_class'
var: 'gene_ids', 'feature_types', 'genome', 'interval', 'mt', 'ribo', 'hb', 'n_cells_by_counts', 'mean_counts', 'log1p_mean_counts', 'pct_dropout_by_counts', 'total_counts', 'log1p_total_counts', 'n_cells'
layers: 'counts', 'soupX_counts'我们现在可以查看在质量控制(quality control, QC)阶段就已经计算好的原始计数的分布情况。这一步在标准的单细胞分析流程中可以省略,但有助于理解不同的归一化概念。
p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False)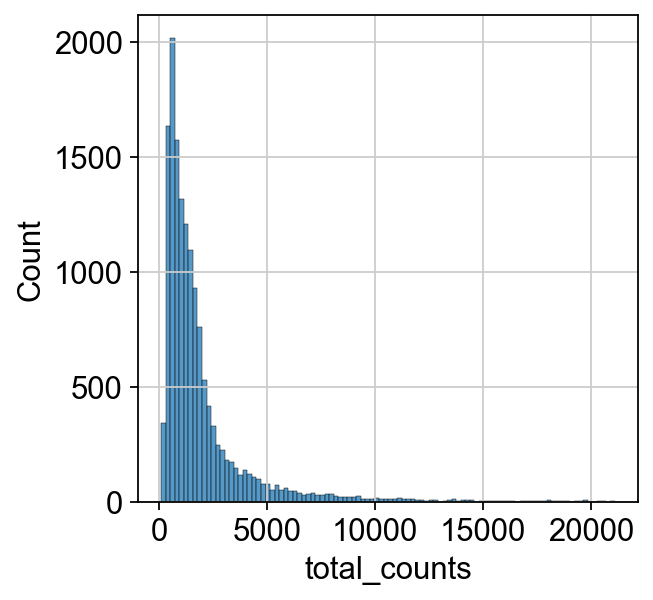
移位对数
我们要介绍的第一种归一化技术是移位对数,它基于 德尔塔方法(delta method)Dorfman, 1938。delta 方法应用一个非线性函数 作用于原始计数 ,目的是使整个数据集上的方差更为接近。
移位对数通过以下方式来解决这一问题:
,其中 为原始计数, 为所谓的大小因子(size factor),而 描述一个伪计数(pseudocount)。每个细胞的大小因子都会被确定,以考虑采样效应和不同细胞大小所带来的变化。某个细胞 的大小因子可以通过下式计算:
,其中 为不同基因的索引,而 描述目标总和。从数据中确定大小因子有多种不同的方法。本节我们将采用 scanpy 的默认做法,其中 为数据集中的中位数原始计数深度。许多分析模板会为目标总和( )指定固定值,例如 ,或 从而得到通常所说的每百万计数(counts per million, CPM)值。对初学者而言,这些固定值或许显得随意,但可能导致远高于单细胞数据中通常水平的过度离散。
移位对数是一种快速的归一化技术,在揭示数据集潜在结构方面优于其他方法(尤其是在随后进行主成分分析(principal component analysis, PCA)时),也有助于稳定方差,便于后续降维和识别差异表达基因。下面来看如何将这种归一化方法应用于数据集。在 scanpy 中,可以方便地通过运行 pp.normalize_total,其中 target_sum=None。我们将 inplace 参数设为 False,因为我们想在本教程中探索三种不同的归一化技术。第二步使用缩放后的计数,我们由此得到了第一个归一化的计数矩阵。
scales_counts = sc.pp.normalize_total(adata, target_sum=None, inplace=False)
# log1p transform
adata.layers["log1p_norm"] = sc.pp.log1p(scales_counts["X"], copy=True)
现在我们可以查看应用移位对数后计数分布发生了怎样的变化,并将其与我们原始(但已过滤)数据集的总计数进行比较。
fig, axes = plt.subplots(1, 2, figsize=(10, 5))
p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")
p2 = sns.histplot(adata.layers["log1p_norm"].sum(1), bins=100, kde=False, ax=axes[1])
axes[1].set_title("Shifted logarithm")
plt.show()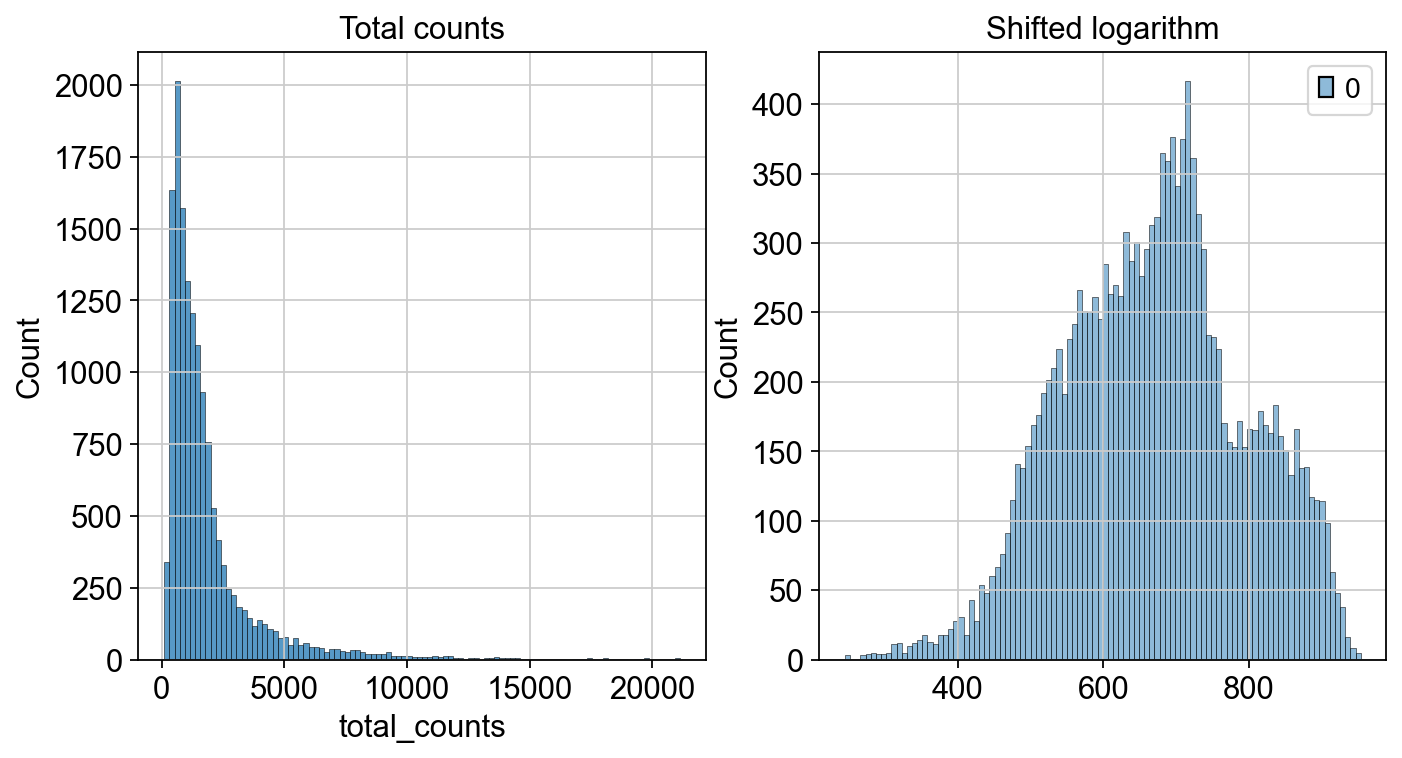
第二种归一化方法同样基于 delta 方法,即 scran 基于池化(pooling)的大小因子估计方法。scran 遵循与移位对数相同的原理,通过计算 ,其中 为原始计数, 为大小因子,而 描述一个伪计数。现在唯一的区别在于,scran 利用一种解卷积(deconvolution)方法,基于对细胞池中各基因的线性回归(linear regression)来估计大小因子。这种方法旨在更好地解释数据集中所有细胞之间计数深度的差异。
细胞被划分到若干池中,scran 利用对各基因的线性回归来估计基于池的大小因子。scran 在批次校正任务上经过了广泛测试,可以方便地通过相应的 R 包调用。
scran 基于池化的大小因子估计方法
scran 估计单细胞大小因子的方法是:先把细胞池化(把多个细胞的计数相加,合并成一个“伪样本”或“池”),将它们组成相互重叠的分组以降低噪声;再通过逐基因的比较(借助线性回归)为这些池计算大小因子;然后用一个去卷积步骤,从池化的估计中推断出单个细胞的大小因子。这种方法通过利用细胞之间共享的信息,改善了稀疏单细胞 RNA-seq 数据的归一化效果。
from scipy.sparse import csr_matrix%%R
library(scran)
library(BiocParallel)scran 需要一个粗略的聚类(clustering)输入来提升大小因子估计的性能。在本教程中,我们采用一种简单的预处理方法,以较低的分辨率对数据进行聚类,从而为大小因子估计提供输入。基本的预处理包括:假设所有大小因子都相等(按文库大小(library size)归一化为每百万计数——CPM),并对计数数据做对数变换。
# Preliminary clustering for differentiated normalisation
adata_pp = adata.copy()
sc.pp.normalize_total(adata_pp)
sc.pp.log1p(adata_pp)
sc.pp.pca(adata_pp, n_comps=15)
sc.pp.neighbors(adata_pp)
sc.tl.leiden(
    adata_pp, key_added="groups", flavor="igraph", n_iterations=2, directed=False
)
我们现在把 data_mat 和我们计算出的分组一并添加到 R 环境中。
# IMPORTANT: scran's computeSumFactors requires raw counts (not normalized or log-transformed).
# adata_pp.X is log-normalized and used only for clustering, so we pass the original counts here instead.
data_mat = adata.layers["counts"].T
# convert to CSC if possible. See https://github.com/MarioniLab/scran/issues/70
if issparse(data_mat):
    if data_mat.nnz > 2**31 - 1:
        data_mat = data_mat.tocoo()
    else:
        data_mat = data_mat.tocsc()
    # Convert sparse matrix to dense numpy array
    data_mat = data_mat.toarray()

with localconverter(ro.default_converter + numpy2ri.converter):
    ro.globalenv["data_mat"] = data_mat

with localconverter(ro.default_converter + pandas2ri.converter):
    ro.globalenv["input_groups"] = adata_pp.obs["groups"]
现在我们也可以删除 AnnData 对象的副本了,因为运行 scran 所需的所有对象我们都已获得。
del adata_pp我们现在根据先前计算出的细胞分组来计算大小因子。
%%R -o size_factors

size_factors = sizeFactors(
    computeSumFactors(
        SingleCellExperiment(
            list(counts=data_mat)),
            clusters = input_groups,
            min.mean = 0.1,
            BPPARAM = MulticoreParam()
    )
)
我们将 size_factors 保存到 .obs,现在便能够对数据进行归一化,随后再应用 log1p 变换。
adata.obs["size_factors"] = size_factors
scran = adata.X / adata.obs["size_factors"].values[:, None]
scran_logged = np.log1p(scran)
adata.layers["scran_normalization"] = csr_matrix(scran_logged)
fig, axes = plt.subplots(1, 2, figsize=(10, 5))
p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")
p2 = sns.histplot(
adata.layers["scran_normalization"].sum(1), bins=100, kde=False, ax=axes[1]
)
axes[1].set_title("log1p with Scran estimated size factors")
plt.show()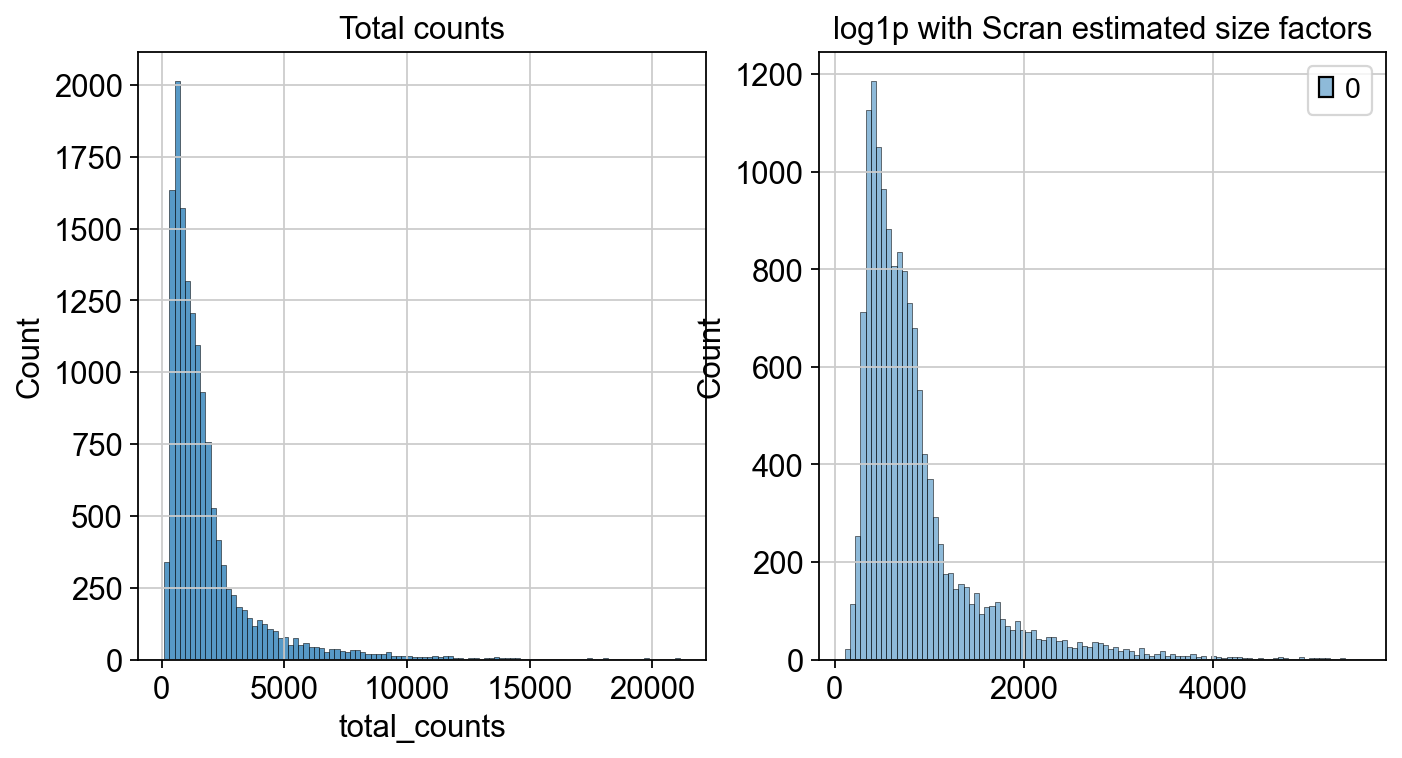
解析式皮尔逊残差
本章介绍的第三种归一化技术是皮尔逊残差(Pearson residual)的解析近似。提出这一技术的动机在于观察到:scRNA-seq 数据中细胞间的变异,可能被生物学异质性与技术效应所混淆。该方法利用“正则化负二项回归(negative binomial regression)”的皮尔逊残差,来对数据中的技术噪声建模,并在一个广义线性模型(generalized linear model, GLM)中显式地把计数深度作为协变量(covariate)纳入。Germain et al., 2020 在一项对不同归一化技术的独立比较中表明,该方法在去除采样效应影响的同时,保留了数据集中的细胞异质性。值得注意的是,解析式皮尔逊残差不需要诸如加伪计数或对数变换之类的下游启发式步骤。此外,Lause et al., 2021 和 Klebanoff, 2023 建议把近似的解析式皮尔逊残差,作为单细胞 RNA-seq UMI 数据一种稳健而有效的归一化方法。该方法的输出是归一化后的值,可正可负。某个细胞–基因的负残差,表示相对于该基因的平均表达和该细胞的测序深度,观测到的计数比预期少;正残差则相应地表示计数更多。解析式皮尔逊残差已在 scanpy 中实现,可直接在原始计数矩阵上计算。
皮尔逊残差
皮尔逊残差是统计建模中用于评估“模型预测值与观测数据吻合程度”的一种度量。它在考虑模型下预期变异性的前提下,告诉你预测偏离了多远。
皮尔逊残差由以下公式给出:
其中:
为观测值
是模型对该观测的预测值
是该观测的估计方差
analytic_pearson = sc.experimental.pp.normalize_pearson_residuals(adata, inplace=False)
adata.layers["analytic_pearson_residuals"] = csr_matrix(analytic_pearson["X"])
fig, axes = plt.subplots(1, 2, figsize=(10, 5))
p1 = sns.histplot(adata.obs["total_counts"], bins=100, kde=False, ax=axes[0])
axes[0].set_title("Total counts")
p2 = sns.histplot(
adata.layers["analytic_pearson_residuals"].sum(1), bins=100, kde=False, ax=axes[1]
)
axes[1].set_title("Analytic Pearson residuals")
plt.show()The history saving thread hit an unexpected error (OperationalError('unable to open database file')).History will not be written to the database.
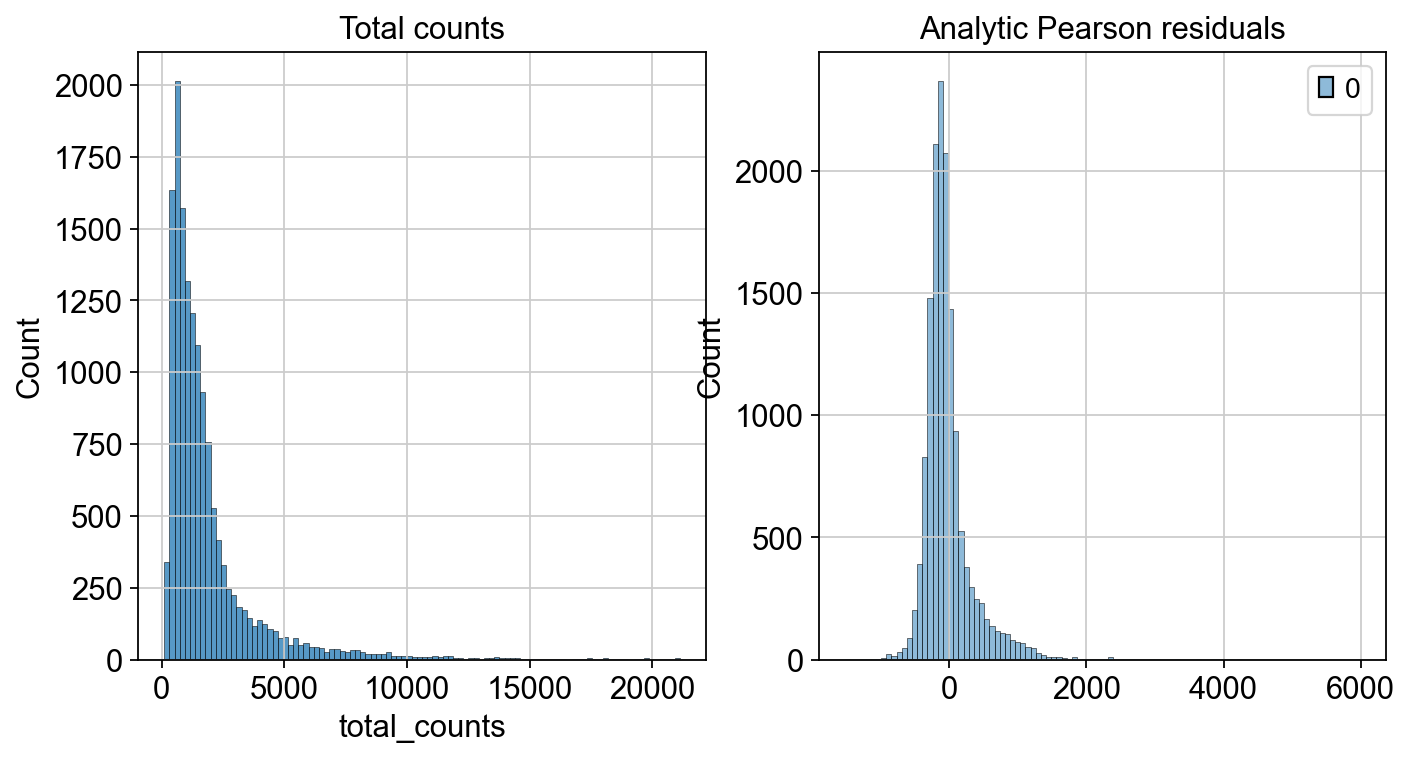
我们对数据集应用了不同的归一化技术,并将它们作为单独的层保存到 AnnData 对象中。根据下游分析任务的不同,使用以不同方式归一化的层并评估结果,可能更为有利。
下面的代码用于把 adata 对象保存到我们的数据库中。
af = ln.Artifact.from_anndata(
    adata,
    key="preprocessing_visualization/s4d8_normalization.h5ad",
    description="anndata after three different normalization methods",
).save()
af
输出
→ returning existing artifact with same hash: Artifact(uid='p24SHFvXmfAdGrmj0001', is_latest=True, key='preprocessing_visualization/s4d8_normalization.h5ad', description='anndata after three different normalization methods', suffix='.h5ad', otype='AnnData', size=4513935737, hash='RcwGlB0RnlhvsbrB7fBM46', space_id=1, storage_id=1, run_id=8, created_by_id=5, created_at=2025-04-25 15:23:43 UTC); to track this artifact as an input, use: ln.Artifact.get()
Artifact(uid='p24SHFvXmfAdGrmj0001', is_latest=True, key='preprocessing_visualization/s4d8_normalization.h5ad', description='anndata after three different normalization methods', suffix='.h5ad', otype='AnnData', size=4513935737, hash='RcwGlB0RnlhvsbrB7fBM46', n_observations=14814, space_id=1, storage_id=1, run_id=8, created_by_id=5, created_at=2025-04-25 15:23:43 UTC)- Ahlmann-Eltze, C., & Huber, W. (2023). Comparison of Transformations for Single-Cell RNA-Seq Data. Nature Methods. 10.1038/s41592-023-01814-1
- Dorfman, R. (1938). A note on the! d-method for finding variance formulae. Biometric Bulletin.
- Germain, P.-L., Sonrel, A., & Robinson, M. D. (2020). pipeComp, a general framework for the evaluation of computational pipelines, reveals performant single cell RNA-seq preprocessing tools. Genome Biology, 21(1), 227. 10.1186/s13059-020-02136-7
- Lause, J., Berens, P., & Kobak, D. (2021). Analytic Pearson Residuals for Normalization of Single-Cell RNA-Seq UMI Data. Genome Biology, 22(1), 258. 10.1186/s13059-021-02451-7
- Klebanoff, V. (2023). Normalization and gene selection for single-cell RNA-seq UMI data using sampling-adjusted sums of squares of Pearson residuals with a Poisson model. bioRxiv. 10.1101/2023.12.21.572783