🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: cellcell
channels:
  - conda-forge
  - bioconda
dependencies:
  - conda-forge::python=3.12.12
  - conda-forge::r-base=4.4.*
  - conda-forge::rpy2=3.6
  - conda-forge::scanpy=1.11.5
  - conda-forge::scikit-misc
  - bioconda::anndata2ri==1.1
  - bioconda::bioconductor-complexheatmap
  - bioconda::bioconductor-limma
  - conda-forge::pip
  - r-seurat
  - r-dplyr
  - r-tidyr
  - r-ggplot2
  - r-purrr
  - r-diagrammer
  - r-mlrmbo
  - r-dicekriging
  - r-hmisc
  - r-remotes
  - r-randomforest
  - r-diffobj
  - r-rstatix
  - r-ggpubr
  - pip:
      - adjusttext==0.7.3
      - decoupler==1.3.3
      - liana==0.1.6
      - mizani==0.8.1
      - palettable==3.3.0
      - plotnine==0.10.1
      - bbknn
本章介绍利用单细胞转录组数据推断细胞间通讯(Cell–Cell Communication, CCC)的基本概念与假设,并演示两类互补思路:一类根据配体–受体(ligand–receptor)表达推断候选相互作用,另一类进一步纳入接收细胞的下游响应。
研究动机
细胞通过感知环境或自身产生的信号作出响应。在多细胞生物中,这种动态协调参与细胞凋亡、迁移等过程,对组织稳态和疾病发展都很重要。CCC 研究常关注蛋白质介导的相互作用,典型情形是分泌配体与细胞膜上的相应受体结合。通讯还涉及分泌酶、细胞外基质蛋白和转运蛋白,以及依赖直接接触的细胞黏附与缝隙连接(gap junction)等机制 Armingol et al., 2021。外部信号通常会在接收细胞中引发下游响应,例如激活信号通路、改变转录因子(Transcription Factor, TF)的活性。TF 是调控基因转录的蛋白质。这些响应可改变接收细胞的功能,并通过其与微环境的后续相互作用继续传播。传统研究常借助邻近标记蛋白质组学、共免疫沉淀和酵母双杂交筛选等实验,获取分子相互作用的证据 Armingol et al., 2021。随着转录组测量技术发展和成本下降,研究者得以在识别细胞类型之外,进一步系统探索细胞之间的关系 Almet et al., 2021。因此,基于单细胞数据的 CCC 推断逐渐成为常用分析,为体内细胞间相互作用提出可供验证的系统层面假设。
方法
利用单细胞转录组推断 CCC 的工具大致可分为两类:一类侧重预测配体–受体相互作用(例如 Efremova et al., 2020Jin et al., 2021Raredon et al., 2022Hou et al., 2020);另一类进一步结合潜在通讯引起的细胞内响应(例如 Wang et al., 2019Browaeys et al., 2020Hu et al., 2021)。两类方法都以基因表达近似反映蛋白质丰度,通常先通过聚类(clustering)和注释,将细胞划分为有生物学意义的群体,相关步骤见“注释”章。随后,在成对细胞群之间指定发送方与接收方,利用它们表达的配体、受体等分子,推断候选通讯事件。
分子之间可能发生哪些相互作用,通常由先验知识数据库提供。配体或受体还可能由不同亚基组成异源多聚体复合物(heteromeric protein complex);不同亚基组合可产生不同响应,因此不能仅凭单个亚基的表达判断完整复合物是否可用。已有研究表明,纳入复合物信息可减少假阳性预测 Efremova et al., 2020Jin et al., 2021Liu et al., 2022。建模细胞内信号的方法还利用接收细胞的功能响应,因此需要额外的先验,例如细胞内蛋白质相互作用网络或基因调控关系。
近期研究发现,更换方法或先验数据库后,得到的 CCC 候选结果可能缺乏一致性 Dimitrov et al., 2022Wang et al., 2022Liu et al., 2022,解读时因此需要考虑方法和资源的依赖性。该领域还缺少充分的真实标签(ground truth)Armingol et al., 2021Almet et al., 2021,难以完整描述大量细胞与分子之间复杂、动态的相互作用。尽管如此,部分独立评估发现,在所测试的场景中,CCC 方法对噪声具有一定稳健性 Dimitrov et al., 2022Wang et al., 2022Liu et al., 2022,结果也可与细胞内信号或空间测量等其他模态的证据相互印证 Dimitrov et al., 2022Liu et al., 2022。
本章先介绍常用的配体–受体推断思路,以 CellPhoneDB Efremova et al., 2020 和 LIANA Dimitrov et al., 2022 演示分析。随后介绍 NicheNet,展示如何结合接收细胞的下游响应,评估候选配体 Browaeys et al., 2020。最后讨论单细胞转录组 CCC 推断的共同假设、局限,以及提高预测可信度的途径。为便于说明,本章仅概括主要思路;更多已有和新兴方法见 展望 一节。
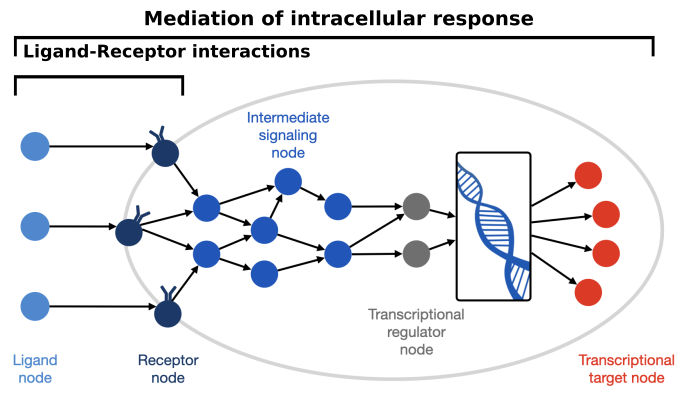
图 22.1:细胞间通讯概览。
环境设置
# python libs
import decoupler as dc
import liana as li
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import scanpy as sc
import seaborn as sns
import session_info
# Setting up R dependencies
import anndata2ri
anndata2ri.activate()
%load_ext rpy2.ipython%%R
suppressPackageStartupMessages({
library(reticulate)
library(ggplot2)
library(tidyr)
library(dplyr)
library(purrr)
library(tibble)
})# figure settings
sc.settings.set_figure_params(dpi=200, frameon=False)
sc.set_figure_params(dpi=200, facecolor="white")
sc.set_figure_params(figsize=(5, 5))案例研究
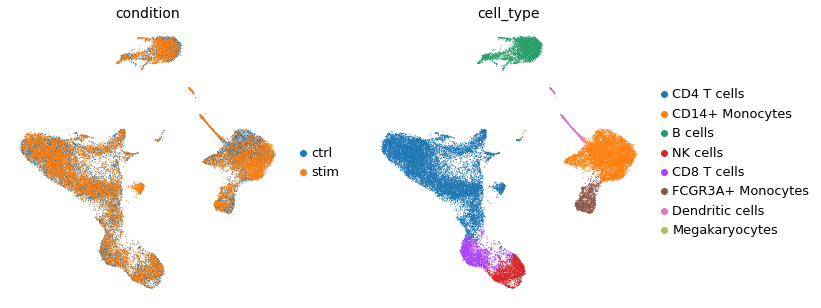
本例使用 Kang 研究中约 25,000 个外周血单个核细胞(Peripheral Blood Mononuclear Cell, PBMC)的数据。研究者从同一批 8 位狼疮患者采集细胞,将每位供体的细胞分别置于未刺激和干扰素 β(interferon beta, IFN-β)刺激条件下,再进行单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)Kang et al., 2018。本教程聚焦这些 PBMC 之间可能发生的通讯,将其作为待检验的生物学假设;这不意味着它们与样本外其他细胞的相互作用不存在。
首先下载经过预处理的数据。
# Read in
adata = sc.read(
    "kang_counts_25k.h5ad", backup_url="https://figshare.com/ndownloader/files/34464122"
)

# Store the counts for later use
adata.layers["counts"] = adata.X.copy()
接着进行基本的质量控制(Quality Control, QC),过滤低质量细胞和低表达基因。更完整的检查流程见 质量控制 一章。
sc.pp.filter_cells(adata, min_genes=200)
sc.pp.filter_genes(adata, min_cells=3)
# Store the counts for later use
adata.layers["counts"] = adata.X.copy()
# Rename label to condition, replicate to patient
adata.obs = adata.obs.rename({"label": "condition", "replicate": "patient"}, axis=1)
# assign sample
adata.obs["sample"] = (
adata.obs["condition"].astype("str") + "&" + adata.obs["patient"].astype("str")
)为便于比较各细胞类型的表达,先将每个细胞的总计数(Count)归一化(normalization)到同一目标值,再进行 log1p 变换。总量归一化发生在对数变换之前。更多说明和其他归一化方案见 归一化 一章,可根据数据特点选择合适的方法。
# log1p normalize the data
sc.pp.normalize_total(adata)
sc.pp.log1p(adata)
本例暂将 B 细胞、CD4 T 细胞等视为信号发送方,将 CD8 T 细胞、自然杀伤细胞(Natural Killer Cell, NK cell)等视为接收方,用于提出具体的分析问题。这只是案例中的角色设定;实际通讯具有动态性和多向性,同一种细胞也可同时发送与接收信号。角色应由研究假设决定,不能视为这些细胞类型固定不变的功能。
adata.obs["cell_type"].cat.categoriesIndex(['CD4 T cells', 'CD14+ Monocytes', 'B cells', 'NK cells', 'CD8 T cells',
'FCGR3A+ Monocytes', 'Dendritic cells', 'Megakaryocytes'],
dtype='object')下面用预先计算好的统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)展示数据中的细胞群体。
sc.pl.umap(adata, color=["condition", "cell_type"], frameon=False)/home/dbdimitrov/anaconda3/envs/cellcell/lib/python3.10/site-packages/scanpy/plotting/_tools/scatterplots.py:364: UserWarning: No data for colormapping provided via 'c'. Parameters 'cmap' will be ignored
/home/dbdimitrov/anaconda3/envs/cellcell/lib/python3.10/site-packages/scanpy/plotting/_tools/scatterplots.py:364: UserWarning: No data for colormapping provided via 'c'. Parameters 'cmap' will be ignored
配体–受体推断
首先通过 LIANA 调用 CellPhoneDB v2 的配体–受体推断方法 Efremova et al., 2020。
这里只分析 IFN-β 刺激条件下的细胞,并将不同供体的刺激样本合并用于推断。原文所称的“稳态”分析,是指在单一条件中推断候选相互作用,并不证明细胞处于生物学稳态,也不直接检验条件间的通讯差异。跨条件比较需要额外的方法与实验设计,相关思路见 展望 一节。
adata_stim = adata[adata.obs["condition"] == "stim"].copy()
adata_stim
AnnData object with n_obs × n_vars = 12301 × 15701
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'condition', 'cluster', 'cell_type', 'patient', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters', 'n_genes', 'sample'
var: 'name', 'n_cells'
uns: 'log1p', 'condition_colors', 'cell_type_colors'
obsm: 'X_pca', 'X_umap'
layers: 'counts'# import cellphonedb method via liana
from liana.method import cellphonedbCellPhoneDB 是常用的 CCC 工具之一。它根据发送方的配体表达和接收方的受体表达,计算相互作用强度(magnitude)分数;这里使用的是编码相应蛋白质的基因表达量。若配体或受体为多亚基复合物,则用其中平均表达量最低的亚基代表该复合物,再汇总配体与受体的平均表达。方法还通过置换细胞群标签构建零分布,计算 p 值,作为细胞类型组合特异性(specificity)的指标。该 p 值衡量表达模式相对于置换背景的异常程度,并不是相互作用真实存在的概率。
这里按预先注释的细胞类型分组,得到的 CCC 统计量也依赖这一分组粒度及注释质量。
cellphonedb(
    adata_stim, groupby="cell_type", use_raw=False, return_all_lrs=True, verbose=True
)
输出
Using `.X`!
Converting mat to CSR format
227 features of mat are empty, they will be removed.
/home/dbdimitrov/anaconda3/envs/cellcell/lib/python3.10/site-packages/pandas/core/indexing.py:1728: ImplicitModificationWarning: Trying to modify attribute `.obs` of view, initializing view as actual.
0.46 of entities in the resource are missing from the data.
Generating ligand-receptor stats for 12301 samples and 15474 features
100%|██████████| 1000/1000 [00:22<00:00, 45.07it/s]
默认情况下,结果直接写入 AnnData 对象的 .uns['liana_res']。
查看 CellPhoneDB 的结果表:
adata_stim.uns["liana_res"].head()结果表同时包含配体端与受体端的信息。其中,ligand 和 receptor 通常表示相互作用的两个分子实体。CCC 并不限于分泌信号,但为统一表格命名,这里仍将两端称为 ligand 和 receptor。
对于多亚基复合物,ligand 和 receptor 列记录相应复合物中平均表达量最低的亚基;*_complex 列则记录完整复合物,亚基名称之间的分隔符为下划线 _。
source和target列分别表示每个候选相互作用的发送方与接收方细胞类型。*_props:相应细胞类型中,表达该分子的细胞所占比例。LIANA 使用表达比例阈值过滤配体、受体及其亚基,默认阈值为 0.1,即要求相应细胞类型中至少 10% 的细胞表达。这是群体层面推断的筛选假设,未达阈值并不证明相互作用是假阳性。本例设置 return_all_lrs=True,因此未通过过滤的条目仍可返回,但会被赋予最低优先级的分数,不能与通过过滤的结果等同解释。
*_means:该分子在相应细胞类型中的平均表达量。lr_means:配体与受体平均表达量的汇总,用于衡量相互作用的 强度cellphone_pvals:通过置换细胞标签得到的 p 值,用于衡量相互作用的 特异性
LIANA 中的配体–受体方法都会返回 ligand,receptor,source,以及 target 这些基本信息列。其他列随方法的假设和评分函数而变化,因此不同方法的分数不能直接混用。许多方法从两个方面评价候选相互作用:一方面是表达所支持的 强度,另一方面是该相互作用对某一发送方–接收方组合的 特异性。
可视化探索
下面用点图(dotplot)展示结果。每行表示一个优先筛选出的配体–受体组合;列标签标出发送方(上)和接收方(下),每个点对应特定细胞类型组合中的候选相互作用。
li.pl.dotplot(
    adata=adata_stim,
    colour="lr_means",
    size="cellphone_pvals",
    inverse_size=True,  # we inverse sign since we want small p-values to have large sizes
    # We choose only the cell types which we wish to plot
    source_labels=["CD4 T cells", "B cells", "FCGR3A+ Monocytes"],
    target_labels=["CD8 T cells", "CD14+ Monocytes", "NK cells"],
    # since cpdbv2 suggests using a filter to FPs
    # we can filter the interactions according to p-values <= 0.01
    filter_fun=lambda x: x["cellphone_pvals"] <= 0.01,
    # as this type of methods tends to result in large numbers
    # of predictions, we can also further order according to expression magnitude
    orderby="lr_means",
    orderby_ascending=False,  # we want to prioritize those with highest expression
    top_n=20,  # and we want to keep only the top 20 interactions
    figure_size=(9, 5),
    size_range=(1, 6),
)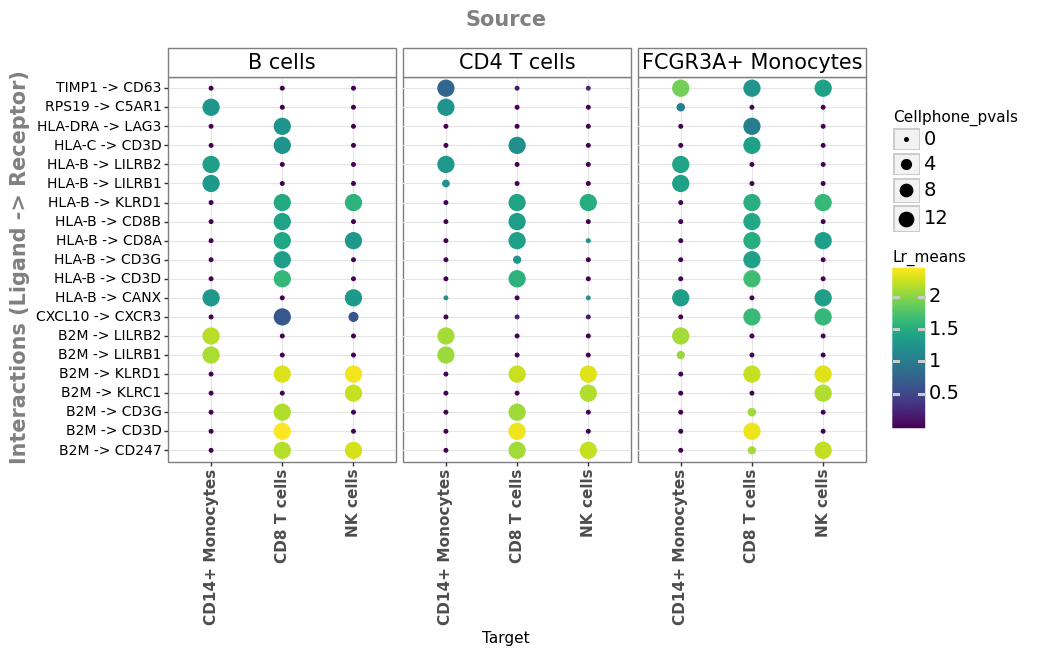
<ggplot: (8783502753003)>图中得到了一组在 IFN-β 刺激条件下具有表达支持的候选相互作用。由于这里只分析刺激组,尚不能据此判断它们是否由 IFN-β 特异性诱导。
相互作用的强度和特异性随细胞类型组合而变化。例如,本例中 HLA-B 与 CD8A/B 相关的候选信号主要出现在以 CD8 T 细胞为接收方的组合中,与相应基因的表达模式相符。这是当前数据与分组下的结果,不能泛化为其他细胞类型绝不参与这些相互作用。
用 LIANA 汇总配体–受体推断结果
不同配体–受体方法的结果可能不一致。评估候选相互作用时,可检查它是否获得多种方法的支持,或直接关注不同方法共同给出较高优先级的结果。为此,下面调用 LIANA 的 rank_aggregate 方法 Dimitrov et al., 2022,汇总各方法的排名,得到共识分数。该分数用于比较候选相互作用的优先级,不是相互作用真实存在的生物学概率。
先查看 LIANA 提供的配体–受体方法:
li.method.show_methods()随后运行 Rank_Aggregate:它依次调用所选方法,再汇总结果,生成共识排名。
from liana.method import rank_aggregaterank_aggregate(
adata_stim, groupby="cell_type", return_all_lrs=True, use_raw=False, verbose=True
)输出
Using `.X`!
Converting mat to CSR format
227 features of mat are empty, they will be removed.
/home/dbdimitrov/anaconda3/envs/cellcell/lib/python3.10/site-packages/pandas/core/indexing.py:1728: ImplicitModificationWarning: Trying to modify attribute `.obs` of view, initializing view as actual.
0.46 of entities in the resource are missing from the data.
Generating ligand-receptor stats for 12301 samples and 15474 features
Assuming that counts were `natural` log-normalized!
Running CellPhoneDB
100%|██████████| 1000/1000 [00:05<00:00, 171.04it/s]
Running Connectome
Running log2FC
Running NATMI
Running SingleCellSignalR
Running CellChat
100%|██████████| 1000/1000 [01:59<00:00, 8.35it/s]
查看 LIANA 的 rank_aggregate 输出:
adata_stim.uns["liana_res"].drop_duplicates(
    ["ligand_complex", "receptor_complex"]
).head()结果表保留各方法的分数,具体对应关系可查上表。此外,每个候选相互作用还得到 magnitude_rank 和 specificity_rank,分别汇总各方法对相互作用 强度 和 特异性 的排名。以 CellPhoneDB 为例,lr_mean 和 cellphone_pvals 分别参与这两个维度的汇总;前者在原文此处记为 lr_mean,实际输出列名为 lr_means。两个聚合排名分数都是越小表示优先级越高,不能沿用原始表达分数越大越优先的方向。
下面仍用点图展示结果,这次依据多种方法的聚合排名进行筛选和排序。
li.pl.dotplot(
    adata=adata_stim,
    colour="magnitude_rank",
    size="specificity_rank",
    inverse_colour=True,  # we inverse sign since we want small p-values to have large sizes
    inverse_size=True,
    # We choose only the cell types which we wish to plot
    source_labels=["CD4 T cells", "B cells", "FCGR3A+ Monocytes"],
    target_labels=["CD8 T cells", "CD14+ Monocytes", "NK cells"],
    # since the rank_aggregate can also be interpreted as a probability distribution
    # we can again filter them according to their specificity significance
    # yet here the interactions are filtered according to
    # how consistently highly-ranked is their specificity across the methods
    # filterby="specificity_rank",
    # filter_lambda=lambda x: x <= 0.05,
    filter_fun=lambda x: x["specificity_rank"] <= 0.05,
    # again, we can also further order according to magnitude
    orderby="magnitude_rank",
    orderby_ascending=True,  # prioritize those with lowest values
    top_n=20,  # and we want to keep only the top 20 interactions
    figure_size=(9, 5),
    size_range=(1, 6),
)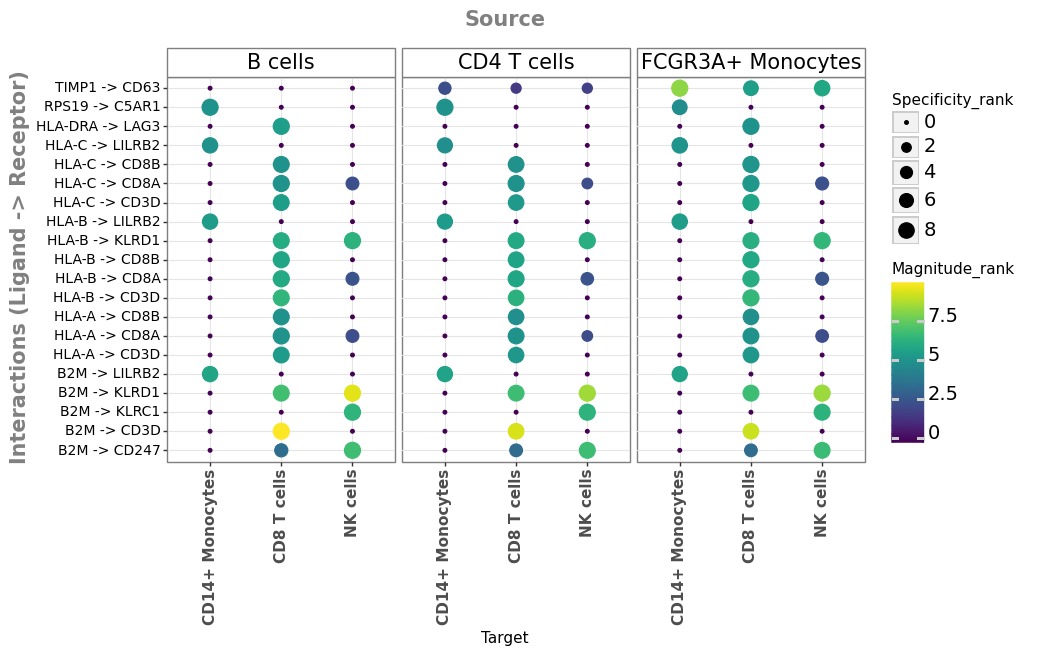
<ggplot: (8783489520283)>CellPhoneDB 和 LIANA 给出的候选相互作用可能符合已有生物学知识,但其功能意义仍需验证。这类方法可系统扫描许多细胞类型组合,无需事先指定单个候选;相应地,输出列表也常很长。大量候选并不等于已确认的通讯事件,仍需要结合研究问题确定实验验证的优先顺序。
选择实验靶点前,建议结合特定条件下的领域知识,例如感兴趣的细胞类型、受体及已知信号机制,并寻找蛋白质丰度、空间共定位或下游信号等独立证据。相关分析可参考 基因集富集和通路分析 和 空间 CCC 章节(原文标注为待补充)。
用 NicheNet 研究与表达变化相关的细胞间信号
NicheNet 将 细胞内信号响应纳入模型,用于研究可能引发这些响应的 细胞间相互作用 Browaeys et al., 2020。
NicheNet 推断配体与潜在下游靶基因之间的关联 Browaeys et al., 2020。其基本设想是:发送细胞产生配体,配体结合接收细胞上的受体后,信号沿细胞内网络传递,影响 TF 及其靶基因。因此,可以利用配体–靶基因的预测关系,为正在发生的 CCC 提出假设;也可检查某个配体的预测靶基因在接收细胞响应基因集中是否 富集(enrichment),作为该配体可能参与响应的线索。NicheNet 因而有两类用途:(1)预测已表达配体的潜在靶基因;(2)根据其靶基因与接收细胞响应的匹配程度,对候选配体及相应相互作用排序。后一种评估称为“配体活性(ligand activity)”,类似于从靶基因推断 TF 活性;它并非直接测得的配体蛋白活性(见 基因集富集和通路分析)。
NicheNet 需要配体–靶基因先验,但现有数据库并未完整记录这些关系。因此,它整合配体–受体、细胞内信号传导和基因调控三层知识,为每个配体–靶基因对计算调控潜力(regulatory potential),表示先验网络对该调控关系的支持程度。具体而言,它以一个配体为种子,在整合后的信号网络上运行个性化 PageRank(Personalized PageRank, PPR),用网络扩散分数描述信号到达不同调控因子的潜在程度。与配体连接更紧密的节点通常获得较高分数,但分数还受边权和网络拓扑影响,并非仅由最短路径距离决定。对所有配体重复计算后,得到配体–调控因子矩阵,再与调控因子–靶基因的权重矩阵相乘,形成配体–靶基因调控潜力矩阵 Browaeys et al., 2020。若先验网络支持某配体通过信号传导影响某靶基因的调控因子,该配体–靶基因对就可能获得较高分数。这些分数是网络模型中的支持度,不能视为已测得的因果效应;NicheNet 还需结合当前数据的表达信息,筛选候选配体并预测相关靶基因。
要根据接收细胞的响应评估配体活性,需要先指定一组可能受 CCC 影响的基因。NicheNet 作者建议,在处理组与对照组等条件比较中定义这一基因集,并明确哪些表达变化可能部分来自细胞间信号。本例比较同一批供体的未刺激与 IFN-β 刺激细胞,使用接收细胞中的差异表达结果建立候选响应基因集。
有关基于下游响应足迹(footprint)的活性推断,可参阅 基因集富集和通路分析 一章的相关部分,以及 NicheNet 的 教程 和方法论文 Browaeys et al., 2020。
加载 NicheNet 先验知识
本例需要以下两类先验:
ligand_target_matrix:配体–靶基因调控潜力矩阵。权重来自先验网络,用于评估候选配体及其潜在靶基因。
lr_network:配体–受体相互作用数据库。与当前表达数据结合后,用于筛选发送方表达的配体、接收方表达的受体及其候选连接。
下面从 Zenodo 下载这两项资源  ,可能需要几分钟。
%%R
# load NicheNet (NicheNet is only available on GitHub)
suppressPackageStartupMessages({
    if(!require(nichenetr)) remotes::install_github("saeyslab/nichenetr", upgrade = "never")
})
%%R
# Increase timeout threshold
options(timeout=600)
# Load PK
ligand_target_matrix <- readRDS(url("https://zenodo.org/record/7074291/files/ligand_target_matrix_nsga2r_final.rds"))
lr_network <- readRDS(url("https://zenodo.org/record/7074291/files/lr_network_human_21122021.rds"))还可使用 OmnipathR 软件包,根据现有数据和生物学背景调整 NicheNet 的先验网络。
步骤 1:指定发送方与接收方细胞类型
本例将 CD4 T 细胞、B 细胞和 FCGR3A+ 单核细胞设为候选发送方,将 CD8 T 细胞设为接收方,允许多个发送群体共同影响接收群体。
sender_celltypes = ["CD4 T cells", "B cells", "FCGR3A+ Monocytes"]
receiver_celltypes = ["CD8 T cells"]
步骤 2:筛选 可能 影响接收细胞的配体
与前面的配体–受体方法类似,这里先按表达比例筛选候选基因。辅助函数将某细胞类型中至少 10% 的细胞有非零表达,作为该基因通过筛选的条件,即 props >= 0.1。这只是经验阈值,可根据数据调整。此处传入完整 adata,因此表达比例汇总了对照与刺激条件;多个发送类型的已表达基因随后取并集。
# Helper function to obtain sufficiently expressed genes
from functools import reduce


def get_expressed_genes(adata, cell_type, expr_prop):
    # calculate proportions
    temp = adata[adata.obs["cell_type"] == cell_type, :]
    a = temp.X.getnnz(axis=0) / temp.X.shape[0]
    stats = (
        pd.DataFrame({"genes": temp.var_names, "props": a})
        .assign(cell_type=cell_type)
        .sort_values("genes")
    )

    # obtain expressed genes
    stats = stats[stats["props"] >= expr_prop]
    expressed_genes = stats["genes"].values

    return expressed_genes
sender_expressed = reduce(
np.union1d,
[
get_expressed_genes(adata, cell_type=cell_type, expr_prop=0.1)
for cell_type in sender_celltypes
],
)
receiver_expressed = reduce(
np.union1d,
[
get_expressed_genes(adata, cell_type=cell_type, expr_prop=0.1)
for cell_type in receiver_celltypes
],
)将这些表达基因与 NicheNet 网络取交集,仅保留发送方表达的配体,且该配体在接收方有至少一个通过表达筛选的受体。得到的是候选配体集合,仍不能据此确认通讯已发生。
%%R -i sender_expressed -i receiver_expressed
# get ligands and receptors in the resource
ligands <- lr_network %>% pull(from) %>% unique()
receptors <- lr_network %>% pull(to) %>% unique()

# only keep the intersect between the resource and the data
expressed_ligands <- intersect(ligands, sender_expressed)
expressed_receptors <- intersect(receptors, receiver_expressed)

# filter the network to only include ligands for which both the ligand and receptor are expressed
potential_ligands <- lr_network %>%
  filter(from %in% expressed_ligands & to %in% expressed_receptors) %>%
  pull(from) %>% unique()
步骤 3:定义接收细胞的响应基因集
响应基因集的定义是 NicheNet 分析中最关键的一步,因为它规定了哪些变化需要由候选配体解释。例如,可将接收细胞在两种条件之间的 差异表达基因(Differentially Expressed Gene, DEG) 视为可能受发送方配体影响的基因;若细胞分化可能由其他细胞诱导,也可比较分化细胞与祖细胞。本例还有一个重要限制:外源 IFN-β 可直接刺激接收细胞,因此 DEG 不一定由样本中其他细胞产生的配体驱动。后续分析用于提出候选解释,不能将这些表达变化全部归因于内源性 CCC。
接下来用 decoupler 按样本和细胞类型汇总原始 Count,生成 伪 bulk(pseudobulk) 表达谱,再以样本为单位进行差异表达分析。
表达支持不足的基因会使倍数变化估计不稳定,因此需要过滤。本章所用 decoupler 1.3.3 在每种细胞类型内,要求基因在至少 3 个样本中由超过 10% 的细胞表达;这对应 min_smpls=3 和 min_prop=0.1。原始 Count 从 counts 层读取。更多 pseudobulk 与差异表达说明见 归一化 和 差异基因表达分析 章节。
# Get pseudo-bulk profile
pdata = dc.get_pseudobulk(
    adata,
    sample_col="sample",
    groups_col="cell_type",
    min_prop=0.1,
    min_smpls=3,
    layer="counts",
)
保留 pseudobulk 原始 Count 的副本,再将各样本的总 Count 归一化到 10,000,并进行 log1p 变换。
# Storing the raw counts
pdata.layers["counts"] = pdata.X.copy()

# Does PC1 captures a meaningful biological or technical fact?
pdata.obs["lib_size"] = pdata.X.sum(1)

# Normalize
sc.pp.normalize_total(pdata, target_sum=1e4)
sc.pp.log1p(pdata)
# check how this looks like
pdata
AnnData object with n_obs × n_vars = 108 × 4412
obs: 'condition', 'cell_type', 'patient', 'sample', 'lib_size'
uns: 'log1p'
layers: 'counts'随后通过 decoupler 调用 scanpy 的 Student t 检验(Student's t-test),在每种细胞类型内部比较刺激组与对照组。这里是简化演示:虽以 pseudobulk 样本为单位,检验并未建模同一供体的配对关系。正式分析应选择能表达实验设计、供体效应和其他协变量的方法。
logFCs, pvals = dc.get_contrast(
    pdata,
    group_col="cell_type",
    condition_col="condition",
    condition="stim",
    reference="ctrl",
    method="t-test",
)
先用 CD14+ 单核细胞演示火山图(volcano plot),再将差异分析结果整理成长表,仅保留真正用于 NicheNet 的接收类型——CD8 T 细胞。后续从中选择上调的候选响应基因。
# Visualize those for e.g. CD14+ Monocytes
dc.plot_volcano(logFCs, pvals, "CD14+ Monocytes", top=15, sign_thr=0.05, lFCs_thr=1)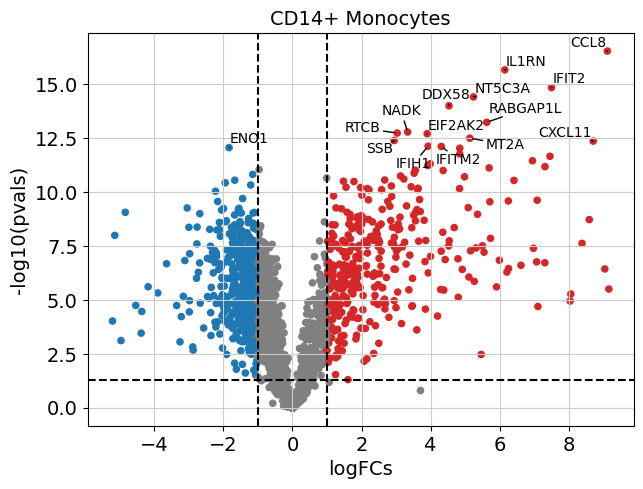
# format results
deg = dc.format_contrast_results(logFCs, pvals)
# only keep the receiver cell type(s)
deg = deg[np.isin(deg["contrast"], receiver_celltypes)]
deg.head()用接收细胞差异分析表中保留的基因定义背景集合,再以 pvals <= 0.05 且 logFCs > 1 选择响应基因集。这里 logFCs 表示 Scanpy 估计的 log2 倍数变化(log2 fold change, log2FC);decoupler 1.3.3 返回的 pvals 是原始 p 值,format_contrast_results 另将多重检验校正值存入 adj_pvals。下方筛选没有使用校正值,因此只能作为探索性基因集,不能声称已控制错误发现率(False Discovery Rate, FDR)。
# define background of sufficiently expressed genes
background_genes = deg["name"].values

# only keep significant and positive DE genes
deg = deg[(deg["pvals"] <= 0.05) & (deg["logFCs"] > 1)]
# get geneset of interest
geneset_oi = deg["name"].values
步骤 4:估计 NicheNet 配体活性
NicheNet 根据先验调控潜力,评估哪些配体更能解释响应基因集:若某配体赋予较高调控潜力的基因,更常属于接收细胞的响应基因集,则该配体会获得较高优先级。这与 富集分析 的思路相近。工具提供受试者工作特征曲线下面积(Area Under the Receiver Operating Characteristic Curve, AUROC)、皮尔逊相关(Pearson correlation)系数等指标;本例实际按精确率–召回率曲线下面积(Area Under the Precision–Recall Curve, AUPR)排序,即代码中的 aupr。分数描述对所选基因集的解释能力,不代表配体活性的直接测量或因果概率 Browaeys et al., 2020。
%%R -i geneset_oi -i background_genes -o ligand_activities

ligand_activities <- predict_ligand_activities(geneset = geneset_oi,
                                               background_expressed_genes = background_genes,
                                               ligand_target_matrix = ligand_target_matrix,
                                               potential_ligands = potential_ligands)

ligand_activities <- ligand_activities %>%
  arrange(-aupr) %>%
  mutate(rank = rank(desc(aupr)))

# show top10 ligand activities
head(ligand_activities, n=10)
# A tibble: 10 × 6
test_ligand auroc aupr aupr_corrected pearson rank
<chr> <dbl> <dbl> <dbl> <dbl> <dbl>
1 PTPRC 0.801 0.116 0.0882 0.168 1
2 HLA-F 0.781 0.104 0.0765 0.188 2
3 HLA-A 0.776 0.0941 0.0662 0.180 3
4 HLA-B 0.766 0.0864 0.0586 0.162 4
5 HLA-E 0.767 0.0856 0.0578 0.129 5
6 CCL5 0.762 0.0812 0.0534 0.0527 6
7 CD48 0.762 0.0786 0.0508 0.106 7
8 B2M 0.753 0.0755 0.0477 0.121 8
9 HLA-DRA 0.730 0.0694 0.0416 0.111 9
10 CXCL10 0.736 0.0678 0.0400 0.0803 10
步骤 5:提取并展示高优先级配体的候选靶基因
%%R -o vis_ligand_target
top_ligands <- ligand_activities %>%
  top_n(15, aupr) %>%
  arrange(-aupr) %>%
  pull(test_ligand) %>%
  unique()

# get regulatory potentials
ligand_target_potential <- map(top_ligands,
                               ~get_weighted_ligand_target_links(.x,
                                                                 geneset = geneset_oi,
                                                                 ligand_target_matrix = ligand_target_matrix,
                                                                 n = 500)
                              ) %>%
    bind_rows() %>%
    drop_na()

# prep for visualization
active_ligand_target_links <-
  prepare_ligand_target_visualization(ligand_target_df = ligand_target_potential,
                                      ligand_target_matrix = ligand_target_matrix)

# order ligands & targets
order_ligands <- intersect(top_ligands,
                           colnames(active_ligand_target_links)) %>% rev() %>% make.names()
order_targets <- ligand_target_potential$target %>%
  unique() %>%
  intersect(rownames(active_ligand_target_links)) %>%
  make.names()
rownames(active_ligand_target_links) <- rownames(active_ligand_target_links) %>%
  make.names() # make.names() for heatmap visualization of genes like H2-T23
colnames(active_ligand_target_links) <- colnames(active_ligand_target_links) %>%
  make.names() # make.names() for heatmap visualization of genes like H2-T23

vis_ligand_target <- active_ligand_target_links[order_targets, order_ligands] %>%
  t()

# convert to dataframe, and then it's returned to py
vis_ligand_target <- vis_ligand_target %>%
    as.data.frame() %>%
    rownames_to_column("ligand") %>%
    as_tibble()
# convert dot to underscore and set ligand as index
vis_ligand_target["ligand"] = vis_ligand_target["ligand"].replace(
r"\.", "_", regex=True
)
vis_ligand_target.set_index("ligand", inplace=True)
# keep only columns where at least one gene has a regulatory potential >= 0.05
vis_ligand_target = vis_ligand_target.loc[
:, vis_ligand_target[vis_ligand_target >= 0.05].any()
]
vis_ligand_target.head()展示候选配体及其调控靶基因
fig, ax = plt.subplots(1, 1, figsize=(15, 5))
sns.heatmap(vis_ligand_target, xticklabels=True, ax=ax)
plt.show()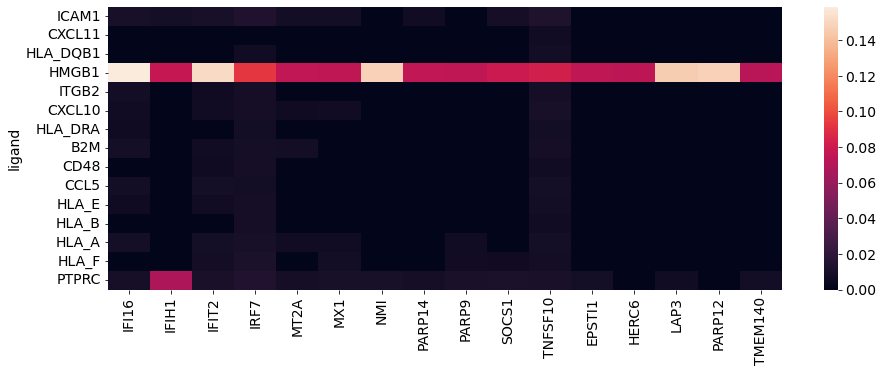
上图汇总优先候选配体及其潜在靶基因。代码先按 AUPR 选择前 15 个配体;top_n 会保留并列值,因此实际数量可能超过 15。随后在响应基因集中提取高调控潜力的靶基因,并只保留至少与一个配体的调控潜力达到 0.05 的基因列。热图颜色表示先验网络的调控潜力,不是实测效应量;高分候选仍需独立验证。
结合 NicheNet 与配体–受体推断结果
两类方法回答的问题不同,可以相互补充。CellPhoneDB、LIANA 等方法根据发送方和接收方的配体–受体表达,筛选单一条件下的候选相互作用;NicheNet 则结合先验网络与接收细胞的表达变化,评估哪些配体可能解释观察到的响应。NicheNet 高度依赖先验,但并非只用先验、不用当前表达数据。工具选择应服从研究问题,也可将两类证据结合,缩小实验验证范围。
例如,先取 NicheNet 优先级最高的三个配体,再关注包含这些配体、且指向同一接收细胞类型的配体–受体组合。
下面按 head(3) 提取三个配体,再与 LIANA 结果对照;原文此处写“前五个”,与代码不符。后面的绘图代码也有两处需要修正后才能用于预期分析:ligand_complex 是字符串列,不能与 0.01 作数值比较,应按是否属于 ligand_oi 筛选;magnitude_rank 越小优先级越高,应按升序选择。此处保留上游代码,不能将其原样执行视为已经完成了这一步筛选和可视化。
ligand_oi = ligand_activities.head(3)["test_ligand"].valuesligand_oiarray(['PTPRC', 'HLA-F', 'HLA-A'], dtype=object)li.pl.dotplot(
adata=adata_stim,
colour="lr_means",
size="cellphone_pvals",
inverse_size=True, # we inverse sign since we want small p-values to have large sizes
# We choose only the cell types which we wish to plot
source_labels=sender_celltypes,
target_labels=receiver_celltypes,
# keep only those ligands
# filterby="ligand_complex",
# filter_lambda=lambda x: np.isin(x, ligand_oi),
filter_fun=lambda x: x["ligand_complex"] <= 0.01,
# as this type of methods tends to result in large numbers
# of predictions, we can also further order according to
# expression magnitude
orderby="magnitude_rank",
orderby_ascending=False, # we want to prioritize those with highest expression
top_n=25, # and we want to keep only the top 25 interactions
figure_size=(9, 9),
size_range=(1, 6),
)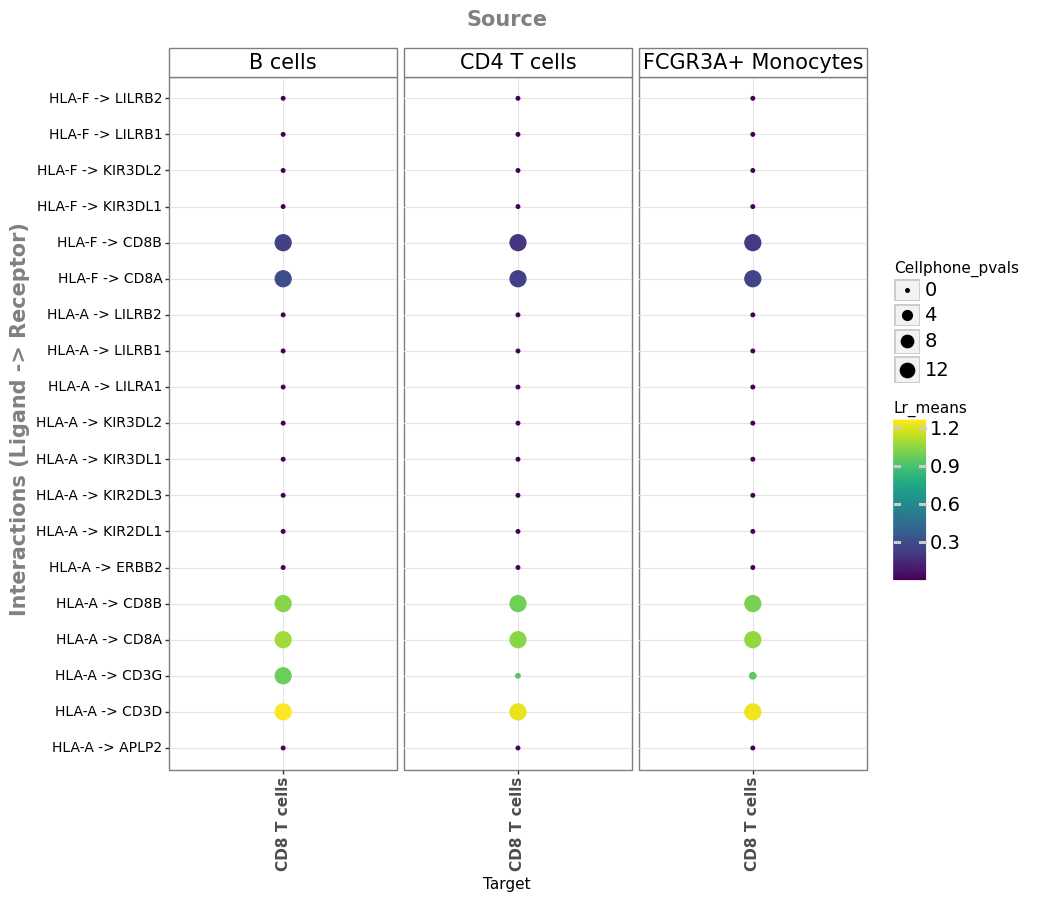
<ggplot: (8783461218238)>修正上述筛选和排序后,可检查 NicheNet 候选配体对应哪些 LIANA 相互作用,并提出它们可能通过特定细胞类型组合传递信号的假设。原文举出的数据库候选为 HLA-A -> CD3G;该记录本身并不证明两者直接结合。即使同一配体与 IFN-β 刺激后的表达响应相关,其作用也可能因接收细胞的受体和下游网络而不同,仍需结合独立证据验证。
本例使用 NicheNet 和 LIANA 组合分析。近年来也有工具将配体–受体表达与细胞内响应等思路整合到同一框架中(例如 Zhang et al., 2021Zhang et al., 2021Baruzzo et al., 2022)。
关键要点
假设与局限
本章方法都尝试从单细胞转录组中筛选具有生物学意义的候选通讯,因此依赖基因表达能够反映潜在相互作用的假设。但发送方与接收方中相关基因的表达,并不能证明相应蛋白质已被翻译、加工、分泌并扩散到受体处,也不能证明受体结合与信号传导已发生。这些环节都是表达代理与真实通讯之间需要验证的证据缺口 Armingol et al., 2021Dimitrov et al., 2022(图 22.2)。此外,体内通讯跨越不同空间尺度 Palla et al., 2022,而推断范围受采样细胞类型、先验数据库和测量模态限制。若信号来自未采样的远端细胞,就可能遗漏相应发送方;离解后的转录组也缺少直接的空间距离信息。内分泌信号并不一概属于非蛋白质信号,但这类远程作用,以及钙离子、氧浓度等微环境因素,往往难以仅靠当前配体–受体表达框架完整解析 Dimitrov et al., 2022。
按谱系或细胞类型分组便于组织数据,但真实相互作用发生在具体细胞及其局部环境中,群体平均值可能掩盖类型内部差异 Wilk et al., 2022。将通讯表示为细胞类型对或蛋白质对之间的一对一连接,也简化了真实网络。共表达只提供候选线索;要描述局部细胞群落的通讯,还需要确定信号的强度、方向及其生物学作用 Armingol et al., 2021。
总结与展望
本章用 CellPhoneDB 和 LIANA 在单一条件下筛选配体–受体相互作用,再用 NicheNet 将差异表达与候选配体及靶基因联系起来。随着研究越来越关注同一种细胞类型在不同条件下的变化,跨条件比较 CCC 的方法也日益重要。除 NicheNet 外,还可考察 NATMI 的差异细胞连接分析 Hou et al., 2020、Crosstalker 的网络拓扑度量 Nagai et al., 2021、CellChat 以通路为核心的流形学习 Jin et al., 2021,以及 Tensor-cell2cell 的探索性张量分解,用于提取跨条件的 CCC 模式 Armingol et al., 2022。
单细胞与 CCC 领域持续发展,新的方法不断扩展分析范围,例如直接在单细胞分辨率下预测相互作用 Raredon et al., 2023Wang et al., 2019Wilk et al., 2022。另一些方法则尝试弥补蛋白质配体–受体框架的局限,纳入代谢物或其他小分子介导的通讯 Zheng et al., 2022Garcia-Alonso et al., 2022Zhang et al., 2021。
本章概括了离解单细胞数据中 CCC 推断的主要思路与局限,无法覆盖全部方法和最新进展。读者可将其作为起点,结合其他章节的分析方法、领域知识和进一步阅读,形成适合自身问题的研究方案。
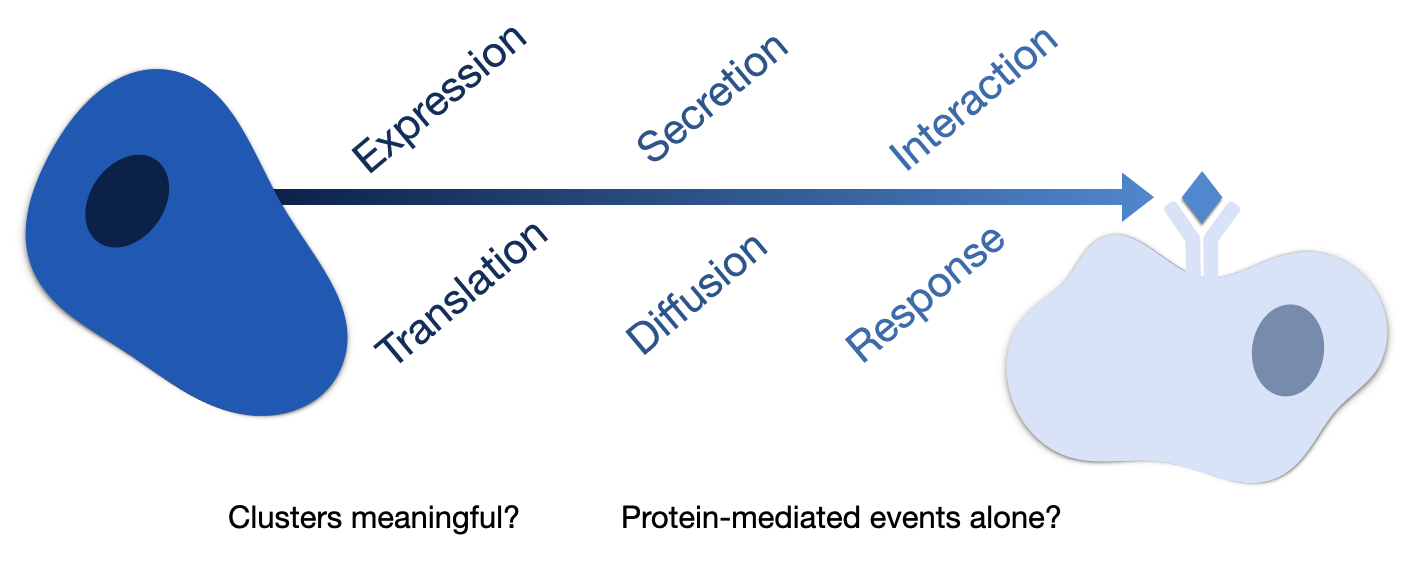
图 22.2:利用单细胞转录组推断细胞间通讯的假设与局限。
测验
会话信息
%%R
sessionInfo()
输出
R version 4.2.2 (2022-10-31)
Platform: x86_64-conda-linux-gnu (64-bit)
Running under: Ubuntu 20.04.5 LTS

Matrix products: default
BLAS/LAPACK: /home/dbdimitrov/anaconda3/envs/cellcell/lib/libopenblasp-r0.3.21.so

locale:
 [1] LC_CTYPE=en_US.UTF-8       LC_NUMERIC=C
 [3] LC_TIME=de_DE.UTF-8        LC_COLLATE=en_US.UTF-8
 [5] LC_MONETARY=de_DE.UTF-8    LC_MESSAGES=en_US.UTF-8
 [7] LC_PAPER=de_DE.UTF-8       LC_NAME=C
 [9] LC_ADDRESS=C               LC_TELEPHONE=C
[11] LC_MEASUREMENT=de_DE.UTF-8 LC_IDENTIFICATION=C

attached base packages:
[1] tools     stats     graphics  grDevices utils     datasets  methods
[8] base

other attached packages:
[1] nichenetr_1.1.1 tibble_3.1.8    purrr_1.0.1     dplyr_1.0.9
[5] tidyr_1.2.0     ggplot2_3.4.0   reticulate_1.25

loaded via a namespace (and not attached):
  [1] backports_1.4.1        circlize_0.4.15        Hmisc_4.7-2
  [4] plyr_1.8.8             igraph_1.3.5           lazyeval_0.2.2
  [7] sp_1.6-0               splines_4.2.2          listenv_0.9.0
 [10] scattermore_0.8        digest_0.6.31          foreach_1.5.2
 [13] htmltools_0.5.4        fansi_1.0.3            checkmate_2.1.0
 [16] magrittr_2.0.3         tensor_1.5             cluster_2.1.4
 [19] doParallel_1.0.17      ROCR_1.0-11            limma_3.54.0
 [22] tzdb_0.3.0             recipes_1.0.4          ComplexHeatmap_2.14.0
 [25] globals_0.16.2         readr_2.1.2            gower_1.0.1
 [28] matrixStats_0.63.0     hardhat_1.2.0          timechange_0.2.0
 [31] spatstat.sparse_3.0-0  jpeg_0.1-10            colorspace_2.0-3
 [34] ggrepel_0.9.2          xfun_0.36              crayon_1.5.2
 [37] jsonlite_1.8.4         progressr_0.13.0       spatstat.data_3.0-0
 [40] survival_3.5-0         zoo_1.8-11             iterators_1.0.14
 [43] glue_1.6.2             polyclip_1.10-4        gtable_0.3.1
 [46] ipred_0.9-13           leiden_0.4.3           GetoptLong_1.0.5
 [49] future.apply_1.10.0    shape_1.4.6            BiocGenerics_0.44.0
 [52] abind_1.4-5            scales_1.2.1           spatstat.random_3.0-1
 [55] miniUI_0.1.1.1         Rcpp_1.0.9             htmlTable_2.4.1
 [58] viridisLite_0.4.1      xtable_1.8-4           clue_0.3-63
 [61] foreign_0.8-84         proxy_0.4-27           Formula_1.2-4
 [64] stats4_4.2.2           lava_1.7.1             prodlim_2019.11.13
 [67] htmlwidgets_1.6.1      httr_1.4.4             DiagrammeR_1.0.9
 [70] RColorBrewer_1.1-3     ellipsis_0.3.2         Seurat_4.3.0
 [73] ica_1.0-3              pkgconfig_2.0.3        nnet_7.3-18
 [76] uwot_0.1.14            deldir_1.0-6           utf8_1.2.2
 [79] caret_6.0-93           tidyselect_1.2.0       rlang_1.0.6
 [82] reshape2_1.4.4         later_1.3.0            visNetwork_2.1.0
 [85] munsell_0.5.0          cli_3.6.0              generics_0.1.3
 [88] ggridges_0.5.4         fdrtool_1.2.17         stringr_1.5.0
 [91] fastmap_1.1.0          goftest_1.2-3          knitr_1.41
 [94] ModelMetrics_1.2.2.2   fitdistrplus_1.1-8     caTools_1.18.2
 [97] randomForest_4.7-1.1   RANN_2.6.1             pbapply_1.7-0
[100] future_1.30.0          nlme_3.1-161           mime_0.12
[103] rstudioapi_0.13        compiler_4.2.2         plotly_4.10.1
[106] png_0.1-8              e1071_1.7-12           spatstat.utils_3.0-1
[109] stringi_1.7.12         lattice_0.20-45        Matrix_1.5-3
[112] vctrs_0.5.1            pillar_1.8.1           lifecycle_1.0.3
[115] spatstat.geom_3.0-3    lmtest_0.9-40          GlobalOptions_0.1.2
[118] RcppAnnoy_0.0.20       bitops_1.0-7           data.table_1.14.6
[121] cowplot_1.1.1          irlba_2.3.5.1          httpuv_1.6.8
[124] patchwork_1.1.2        latticeExtra_0.6-30    R6_2.5.1
[127] promises_1.2.0.1       KernSmooth_2.23-20     gridExtra_2.3
[130] IRanges_2.32.0         parallelly_1.34.0      codetools_0.2-18
[133] MASS_7.3-58.1          rjson_0.2.21           withr_2.5.0
[136] SeuratObject_4.1.3     sctransform_0.3.5      S4Vectors_0.36.0
[139] parallel_4.2.2         hms_1.1.1              grid_4.2.2
[142] rpart_4.1.19           timeDate_4022.108      class_7.3-20
[145] Rtsne_0.16             spatstat.explore_3.0-5 pROC_1.18.0
[148] base64enc_0.1-3        shiny_1.7.4            lubridate_1.9.0
[151] interp_1.1-3
session_info.show()- Armingol, E., Officer, A., Harismendy, O., & Lewis, N. E. (2021). Deciphering cell-cell interactions and communication from gene expression. Nature Reviews. Genetics, 22(2), 71–88. 10.1038/s41576-020-00292-x
- Almet, A. A., Cang, Z., Jin, S., & Nie, Q. (2021). The landscape of cell-cell communication through single-cell transcriptomics. Current Opinion in Systems Biology, 26, 12–23. 10.1016/j.coisb.2021.03.007
- Efremova, M., Vento-Tormo, M., Teichmann, S. A., & Vento-Tormo, R. (2020). CellPhoneDB: inferring cell-cell communication from combined expression of multi-subunit ligand-receptor complexes. Nature Protocols, 15(4), 1484–1506. 10.1038/s41596-020-0292-x
- Jin, S., Guerrero-Juarez, C. F., Zhang, L., Chang, I., Ramos, R., Kuan, C.-H., Myung, P., Plikus, M. V., & Nie, Q. (2021). Inference and analysis of cell-cell communication using CellChat. Nature Communications, 12(1), 1088. 10.1038/s41467-021-21246-9
- Raredon, M. S. B., Yang, J., Garritano, J., Wang, M., Kushnir, D., Schupp, J. C., Adams, T. S., Greaney, A. M., Leiby, K. L., Kaminski, N., Kluger, Y., Levchenko, A., & Niklason, L. E. (2022). Computation and visualization of cell-cell signaling topologies in single-cell systems data using Connectome. Scientific Reports, 12(1), 4187. 10.1038/s41598-022-07959-x
- Hou, R., Denisenko, E., Ong, H. T., Ramilowski, J. A., & Forrest, A. R. (2020). Predicting cell-to-cell communication networks using NATMI. Nature Communications, 11(1), 1–11.
- Wang, S., Karikomi, M., MacLean, A. L., & Nie, Q. (2019). Cell lineage and communication network inference via optimization for single-cell transcriptomics. Nucleic Acids Research, 47(11), e66. 10.1093/nar/gkz204
- Browaeys, R., Saelens, W., & Saeys, Y. (2020). NicheNet: modeling intercellular communication by linking ligands to target genes. Nature Methods, 17(2), 159–162. 10.1038/s41592-019-0667-5
- Hu, Y., Peng, T., Gao, L., & Tan, K. (2021). CytoTalk: De novo construction of signal transduction networks using single-cell transcriptomic data. Science Advances, 7(16). 10.1126/sciadv.abf1356
- Liu, Z., Sun, D., & Wang, C. (2022). Evaluation of cell-cell interaction methods by integrating single-cell RNA sequencing data with spatial information. Genome Biology, 23(1), 218. 10.1186/s13059-022-02783-y
- Dimitrov, D., Türei, D., Garrido-Rodriguez, M., Burmedi, P. L., Nagai, J. S., Boys, C., Ramirez Flores, R. O., Kim, H., Szalai, B., Costa, I. G., Valdeolivas, A., Dugourd, A., & Saez-Rodriguez, J. (2022). Comparison of methods and resources for cell-cell communication inference from single-cell RNA-Seq data. Nature Communications, 13(1), 3224. 10.1038/s41467-022-30755-0
- Wang, S., Zheng, H., Choi, J. S., Lee, J. K., Li, X., & Hu, H. (2022). A systematic evaluation of the computational tools for ligand-receptor-based cell-cell interaction inference. Briefings in Functional Genomics, 21(5), 339–356. 10.1093/bfgp/elac019
- Kang, H. M., Subramaniam, M., Targ, S., Nguyen, M., Maliskova, L., McCarthy, E., Wan, E., Wong, S., Byrnes, L., Lanata, C. M., & others. (2018). Multiplexed droplet single-cell RNA-sequencing using natural genetic variation. Nature Biotechnology, 36(1), 89–94.
- Browaeys, R. (2022). NicheNet-v2: final networks and ligand-target matrices [Data set]. Zenodo. 10.5281/ZENODO.7074291
- Zhang, Y., Liu, T., Hu, X., Wang, M., Wang, J., Zou, B., Tan, P., Cui, T., Dou, Y., Ning, L., & others. (2021). CellCall: integrating paired ligand–receptor and transcription factor activities for cell–cell communication. Nucleic Acids Research, 49(15), 8520–8534.