⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: surface-protein
channels:
  - conda-forge
dependencies:
  - python=3.13
  - scanpy=1.12
  - muon=0.1.9
  - python-igraph=1.0.0
  - ipykernel=7.2.0
  - pip==26.0.1
  - pip:
      - lamindb==2.3.1
      - harmonypy==0.0.9
      - ipywidgets==8.1.8
🗄️ 获取数据和笔记本
本书使用 lamindb 存储、共享和加载数据集与笔记本,托管实例为 theislab
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
按照 说明注册并登录
验证你的设置
下面用 Python API 检查连接;命令行方式可使用
lamin connect:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
运行后应显示最多 100 条已保存的数据集记录。
访问数据集(Artifact)
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
加载后的对象可直接在内存中分析。如需指定数据版本,可调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")中的 ID。访问笔记本(Transform)
加载笔记本:
lamin load <notebook url>该命令将笔记本下载到当前工作目录。与
Artifacts类似,可通过指定 ID 获取旧版本。
研究动机
通过测序对转录组和表位进行细胞索引(Cellular Indexing of Transcriptomes and Epitopes by Sequencing, CITE-seq)得到的抗体衍生标签(Antibody-Derived Tags, ADTs)也包含技术变异。主要来源包括细胞间测序深度差异、抗体非特异性结合,以及游离标签抗体等产生的背景信号。归一化(normalization)旨在减轻这些因素对分析的影响。
相较于常见的 RNA 计数(Count)数据,ADT 通常较不稀疏,许多标记呈现阴性背景峰与阳性信号峰。这里的“阴性”指缺乏特异性蛋白信号,并不是 Count 为负 Zheng et al., 2022。细胞生物物理性质会影响抗体捕获,而预先选定、规模较小的特征(feature)面板也容易受到组成性偏差(compositional bias)的影响。
ADT Count 为什么具有组成性
在有限的测序资源下,每个细胞的读段(Read)分配到预设抗体面板中的各个标签。某个标记占据较大比例时,其他标记的相对份额就可能降低,即使其实际蛋白量没有变化。因此,ADT Count 不能直接等同于细胞携带的蛋白分子数。
小型抗体面板若由少数强信号标记主导,这种效应尤其明显;RNA 测量覆盖的基因较多,但也并非没有组成性偏差。下文将介绍基于比值的尺度变换,以及利用背景和技术协变量进行校正的两类方法,两者原理不同。
ADT 有多种归一化方法,本章介绍两种常用选择。
传统方法是中心化对数比(Centered Log-Ratio, CLR)变换 Stoeckius et al., 2017,本章后半部分将演示其应用。另一种针对 ADT 背景设计的方法是背景去噪与缩放(Denoised and Scaled by Background, dsb)Mulè et al., 2022,其主要步骤如下:
首先,利用空液滴(empty droplet)估计各抗体的背景信号。ADT 背景主要与游离标签抗体及其他非特异性信号有关,不能简单理解为细胞外蛋白的总量。默认步骤在加伪计数并取对数后,减去相应空液滴背景均值,再除以背景标准差。
其次,估计并回归细胞层面的技术成分。同型对照(isotype controls)可与细胞内阴性蛋白的背景估计共同提供技术协变量。同型对照应与实验抗体的宿主和同型匹配,并且不针对样本中的特异靶抗原;它们用于衡量非特异性背景,而不是专门识别许多蛋白。
环境设置
import warnings

import matplotlib.pyplot as plt
import muon as mu
import pandas as pd
import scanpy as sc
import seaborn as sns

warnings.filterwarnings("ignore")
sc.settings.verbosity = 0
sc.set_figure_params(dpi=80, facecolor="white", frameon=False)

import lamindb as ln

ln.track()
→ connected lamindb: theislab/sc-best-practices
→ found notebook normalization.ipynb, making new version -- anticipating changes
→ created Transform('Z95qTilYUzGh0005', key='normalization.ipynb'), started new Run('kGh9gDK6yaGvesDT') at 2026-07-29 10:39:11 UTC
→ notebook imports: lamindb-core==2.3.1 matplotlib==3.11.1 muon==0.1.9 pandas==2.3.3 scanpy==1.12.3 seaborn==0.13.2
• recommendation: to identify the notebook across renames, pass the uid: ln.track("Z95qTilYUzGh")
加载数据
加载前一章保存的 MuData 对象,参见 质量控制:
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="surface-protein/cite_quality_control.h5mu",
    is_latest=True,
)
mdata = af.load()
mdatadsb 还需要包含背景液滴的未过滤数据。mdata_raw 是包含全部液滴的 MuData 对象;mdata 则仅保留通过 Cell Ranger 和本教程质控的条形码(Barcode)。本例未过滤对象包含超过 2,400 万个液滴,质控后对象包含 106,515 个细胞。
af_raw = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="surface-protein/cite_raw.h5mu",
    is_latest=True,
)
mdata_raw = af_raw.load()
mdata_rawmdata["prot"].layers["counts"] = mdata[
"prot"
].X.copy() # saving the raw data in a layer.dsb 归一化
dsb 归一化 Mulè et al., 2022 利用背景数据减少 ADT 技术噪声。本例同时提供未过滤数据中的空液滴和同型对照。缺少同型对照时,muon 仍可根据细胞内阴性蛋白背景估计技术成分,不必机械地只保留第一步;但本章不演示这种配置。若缺少可用的背景液滴,本例的背景缩放步骤无法直接照用,可考虑后文的 CLR。
同型对照不应呈现由目标抗原驱动的特异信号,其细胞间变化可帮助估计技术差异。不过,对照信号也可能随细胞性质变化,因此应检查其适用性,不能假定所有细胞中的信号必然一致。
先查看未过滤数据的 RNA 总 Count 分布,以辅助区分候选空液滴与含细胞液滴。
sc.pp.calculate_qc_metrics(mdata_raw["rna"], inplace=True, percent_top=None)
sns.displot(
    mdata_raw["rna"]
    .obs.sample(frac=0.01)
    .query("total_counts<100000 and total_counts>10"),
    x="total_counts",
    log_scale=True,
    hue="donor",
    multiple="stack",
)
<seaborn.axisgrid.FacetGrid at 0x7f5154351400>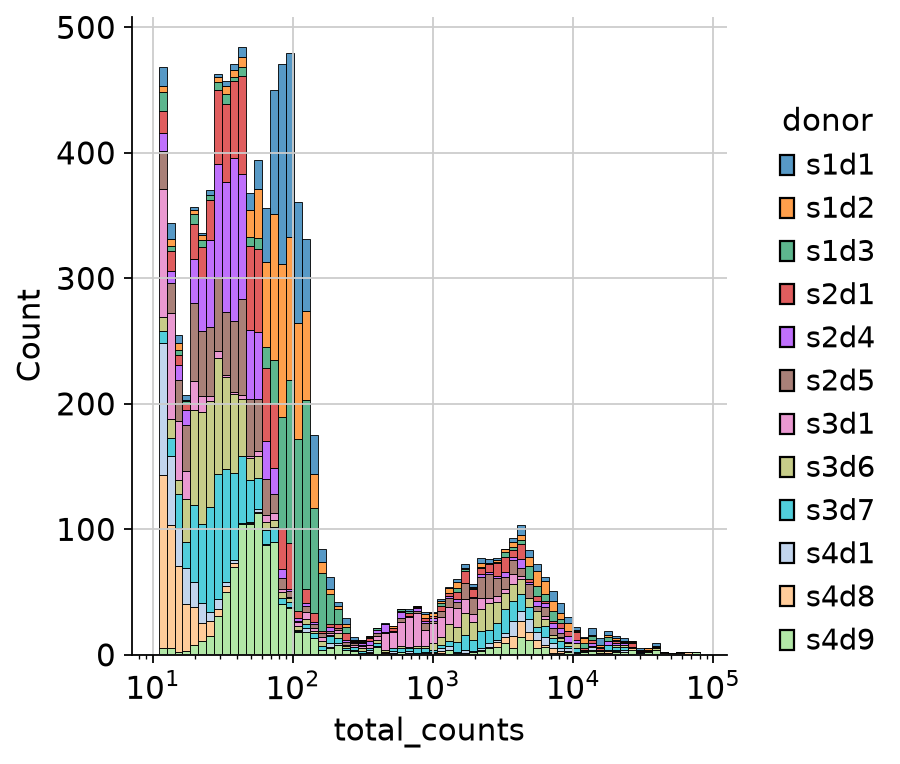
本例在 10^1 到 10^2.1 附近的低 Count 峰主要对应候选空液滴。mdata 保存过滤后的细胞,mdata_raw 则包含含细胞及不含细胞的液滴。下方调用没有显式传入 empty_counts_range:在 muon v0.1.9 中,此时将未出现在 mdata 中的液滴作为背景。因此,代码并未直接按图中的区间筛选空液滴,背景集合也可能包括被质控去除的细胞,使用时需核对其组成。
列出用于技术成分估计的同型对照。
isotype_controls = ["Mouse-IgG1", "Mouse-IgG2a", "Mouse-IgG2b", "Rat-IgG2b"]调用 muon.prot.pp.dsb,传入过滤后的 MuData、未过滤的 MuData,以及同型对照名称。
mu.prot.pp.dsb(mdata, mdata_raw, isotype_controls=isotype_controls, random_state=0)先查看保存在 counts 层中的原始 Count。
pd.Series(mdata["prot"].layers["counts"][:100, :100].toarray().flatten()).value_counts()1.0 1048
0.0 1026
2.0 898
3.0 688
4.0 581
...
347.0 1
390.0 1
344.0 1
565.0 1
621.0 1
Name: count, Length: 543, dtype: int64再查看 dsb 处理后的数值。这些值表示背景校正后的相对表达,可以为负,已不再是原始 Count。
pd.Series(mdata["prot"].X[:100, :100].flatten()).value_counts()8.529189 2
1.581845 1
8.613171 1
14.779234 1
7.079424 1
..
8.519451 1
2.257648 1
7.581913 1
40.300850 1
6.755094 1
Name: count, Length: 9999, dtype: int64下面分别绘制每个细胞的原始 ADT 总 Count,以及 dsb 处理后各标记数值之和。两者量纲不同,不能直接当作相同尺度的蛋白总量比较:
sns.histplot(mdata["prot"].layers["counts"].sum(axis=1), bins=50)
plt.title("Total counts per cell (raw)")
plt.xlim(0, 20000)
(0.0, 20000.0)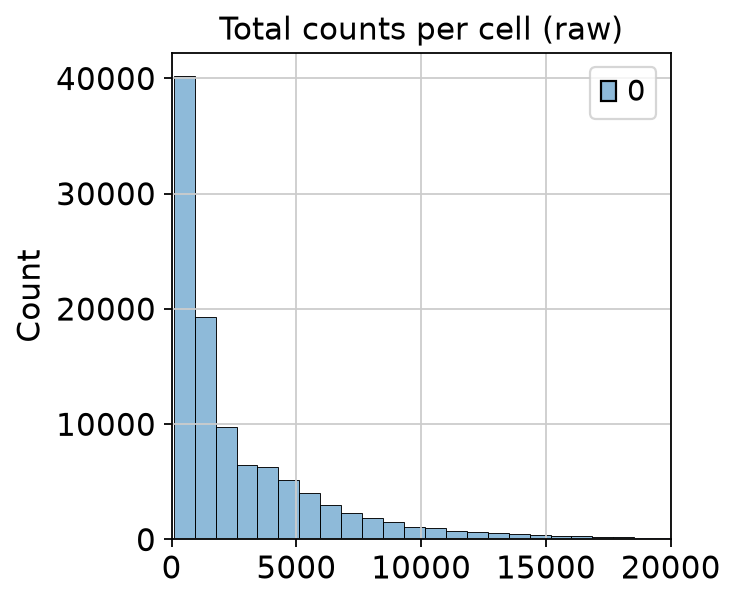
原始 ADT 总 Count 在细胞间差异较大。测序深度、游离抗体背景及非特异性结合都可能贡献这些差异,真实蛋白水平和细胞大小也会产生影响。
sns.histplot(mdata["prot"].X.sum(axis=1), bins=50)
plt.title("Total counts per cell (dsb normalized)")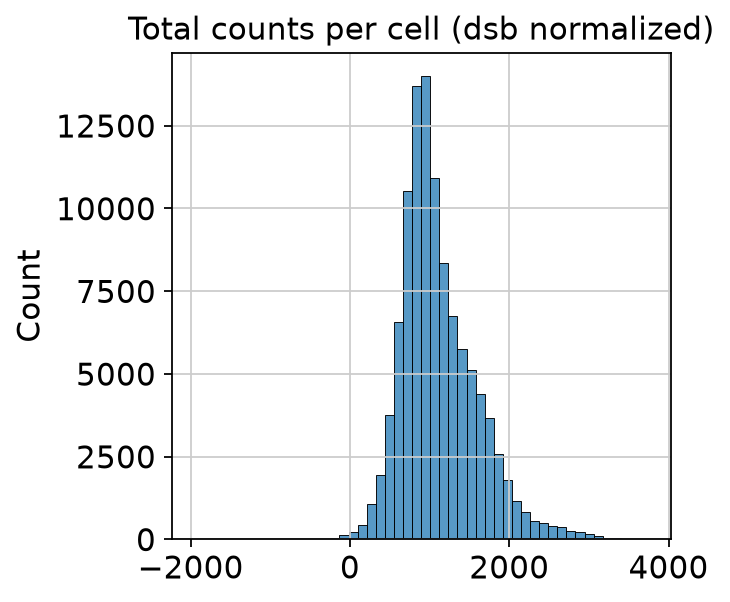
dsb 处理后的分布范围发生变化,说明数值尺度及背景成分已被调整;仅凭分布收窄,不能判定剩余差异全部来自生物学,也不能量化噪声消除程度。
CLR 归一化
缺少背景数据或希望比较其他方法时,可使用 muon.prot.pp.clr 进行 Centered Log-Ratio 归一化。这一方法最初用于原始 CITE-seq 研究 Stoeckius et al., 2017。
CLR 类变换可减轻细胞间 ADT 总量差异对降维(dimensionality reduction)和聚类(clustering)的影响,但不直接估计游离抗体背景。本例使用 muon 默认的 seurat 变体:先计算每个细胞中各蛋白的 log(1 + Count) 均值并取指数,作为几何参考尺度,再计算 log(1 + Count / 参考尺度)。这与无伪计数的标准 CLR 不同,也不保证每个细胞变换后的数值总和相等。
mdata_clr_normalize = mdata.copy()
mdata_clr_normalize["prot"].X = mdata_clr_normalize["prot"].layers["counts"].copy()
先将原始 Count 复制到独立对象,再调用 muon.prot.pp.clr:
mu.prot.pp.clr(mdata_clr_normalize["prot"], axis=1)本章推荐 axis=1,即对每个细胞沿蛋白维度计算参考尺度,以减轻细胞间总量差异。axis=0 则对每个蛋白沿细胞维度计算参考尺度,两者回答的问题不同。小面板或具有相近总体分布的标记可考虑后者,但选择应依据实验和下游目标,而非只看归一化后分布是否接近。这里的轴定义特指 muon,不应直接套用其他软件的同名参数。
从 muon 0.1.8 起,clr 提供 flavor 参数。本例使用默认 flavor="seurat";flavor="stoeckius" 则先加 1 再按标准对数比形式变换,结果可为负,并会转为稠密矩阵。不同变体的数值含义和内存需求不同,复现时应记录具体设置。
比较原始 Count 与 CLR 处理后的数值:
pd.Series(mdata["prot"].layers["counts"][:100, :100].toarray().flatten()).value_counts()1.0 1048
0.0 1026
2.0 898
3.0 688
4.0 581
...
347.0 1
390.0 1
344.0 1
565.0 1
621.0 1
Name: count, Length: 543, dtype: int64pd.Series(mdata_clr_normalize["prot"].X[:100, :100].toarray().flatten()).value_counts()0.000000 1026
0.172764 20
0.163880 19
0.160785 18
0.166124 17
...
2.751836 1
1.074037 1
1.052570 1
1.923326 1
4.267047 1
Name: count, Length: 4092, dtype: int64绘制每个细胞的 CLR 数值之和:
sns.histplot(mdata_clr_normalize["prot"].X.sum(axis=1), bins=50)
plt.title("Total counts per cell (CLR normalized)")
plt.xlim(0, 400)
(0.0, 400.0)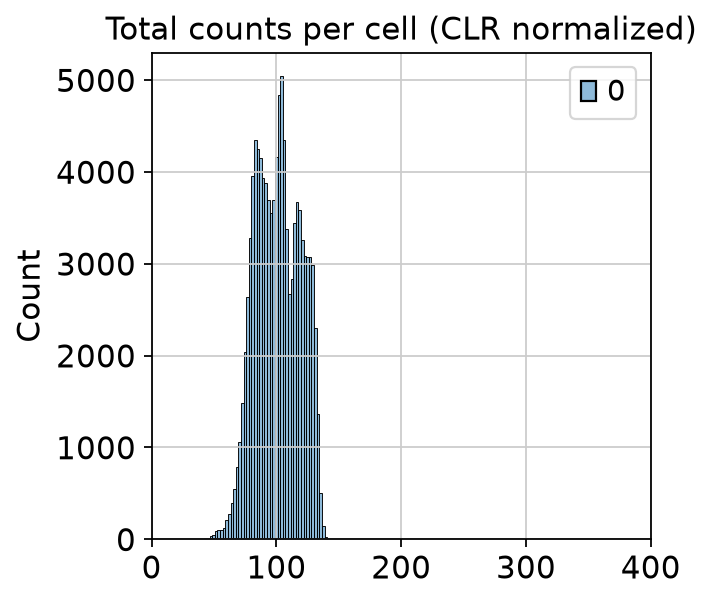
本例多数细胞的 CLR 数值之和约为 50–150,较原始图中 0–20,000 的 Count 范围更集中。由于变换改变了数值尺度,两个范围不能直接比较为相同单位的总量,也不能仅凭范围缩小证明技术噪声已被去除。
本例具备背景液滴和同型对照,因此后续继续使用 dsb 处理的对象,并将其保存。
af_normalization = ln.Artifact.from_mudata(
    mdata,
    key="surface-protein/cite_normalization.h5mu",
    description="CITE-seq data after normalization",
)
af_normalization.save()
输出
→ returning artifact with same hash: Artifact(uid='1gDVbNOjKn0egsqm0003', key='surface-protein/cite_normalization.h5mu', description='CITE-seq data after normalization', suffix='.h5mu', kind='dataset', otype='MuData', size=1467018249, hash='PntBph8LObdvBIRlb7XKEm', n_files=None, n_observations=106515, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=98, schema_id=None, created_by_id=7, created_at=2026-07-29 10:21:13 UTC, is_locked=False, version_tag=None, is_latest=True); to track this artifact as an input, use: ln.Artifact.get()
Artifact(uid='1gDVbNOjKn0egsqm0003', key='surface-protein/cite_normalization.h5mu', description='CITE-seq data after normalization', suffix='.h5mu', kind='dataset', otype='MuData', size=1467018249, hash='PntBph8LObdvBIRlb7XKEm', n_files=None, n_observations=106515, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=98, schema_id=None, created_by_id=7, created_at=2026-07-29 10:21:13 UTC, is_locked=False, version_tag=None, is_latest=True)ln.finish()输出
• please hit CTRL + s to save the notebook in your editor ... ✓
→ finished Run('kGh9gDK6yaGvesDT') after 15m at 2026-07-29 10:54:55 UTC
→ go to: https://lamin.ai/theislab/sc-best-practices/transform/Z95qTilYUzGh0005
→ to update your notebook from the CLI, run: lamin save /groups/nils/members/javier/single-cell-best-practices/jupyter-book/surface_protein/normalization.ipynb
贡献者
我们衷心感谢以下人员的贡献:
作者
Javier Marchena-Hurtado
Daniel Strobl
Ciro Ramírez-Suástegui
审阅者
Lukas Heumos
Anna Schaar
- Zheng, Y., Jun, S.-H., Tian, Y., Florian, M., & Gottardo, R. (2022). Robust Normalization and Integration of Single-cell Protein Expression across CITE-seq Datasets. bioRxiv. 10.1101/2022.04.29.489989
- Stoeckius, M., Hafemeister, C., Stephenson, W., Houck-Loomis, B., Chattopadhyay, P. K., Swerdlow, H., Satija, R., & Smibert, P. (2017). Simultaneous epitope and transcriptome measurement in single cells. Nature Methods, 14(9), 865–868. 10.1038/nmeth.4380
- Mulè, M. P., Martins, A. J., & Tsang, J. S. (2022). Normalizing and denoising protein expression data from droplet-based single cell profiling. Nature Communications, 13(11), 2099. 10.1038/s41467-022-29356-8