🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
免疫受体在细胞中的作用
免疫受体(Immune Receptors, IRs)参与识别抗原、病原相关成分及其他免疫信号,通常位于特定细胞的细胞膜上,并启动相应的免疫反应。其识别对象并不都来自外界,也包括自身成分和细胞状态变化。不同类型的 IR 识别不同的结构或信号:
模式识别受体(Pattern Recognition Receptors, PRRs):识别病原体相关分子模式(Pathogen-Associated Molecular Patterns, PAMPs)等信号。
杀伤细胞活化/抑制受体(Killer Activator/Inhibitor Receptors, KARs/KIRs):感知宿主细胞表面配体的变化,参与识别异常细胞。
补体受体(complement receptor):识别补体蛋白及其片段。
Fc 受体:结合抗体的 Fc 区,参与识别抗体包被的靶标或免疫复合物。
细胞因子受体(cytokine receptor):结合细胞因子。
B 细胞受体(B-Cell Receptors, BCRs):直接识别抗原表位。
T 细胞受体(T-Cell Receptors, TCRs):常规 αβ TCR 主要识别由主要组织相容性复合体(Major Histocompatibility Complex, MHC)呈递的肽表位。
适应性免疫系统的受体
适应性免疫系统中,携带抗原受体的两大淋巴细胞谱系是 T 细胞和 B 细胞。两者的前体均起源于骨髓;T 细胞主要在胸腺成熟,B 细胞主要在骨髓成熟 Cooper & Alder, 2006。两类细胞的适应性免疫受体(Adaptive Immune Receptors, AIRs)可识别病原体、肿瘤及自身来源的抗原,但识别方式不同:BCR 直接结合可溶性或膜结合抗原的表位;常规 αβ TCR 则识别肽–MHC 复合体(peptide–major histocompatibility complex, pMHC),借助细胞表面的抗原呈递感知细胞内外的蛋白来源。这一描述不能直接概括所有 γδ TCR 或其他非常规 TCR。抗原刺激及相应的共刺激信号可促使 B、T 细胞活化和增殖,随后执行清除病原体、调节免疫应答或形成免疫记忆等功能。
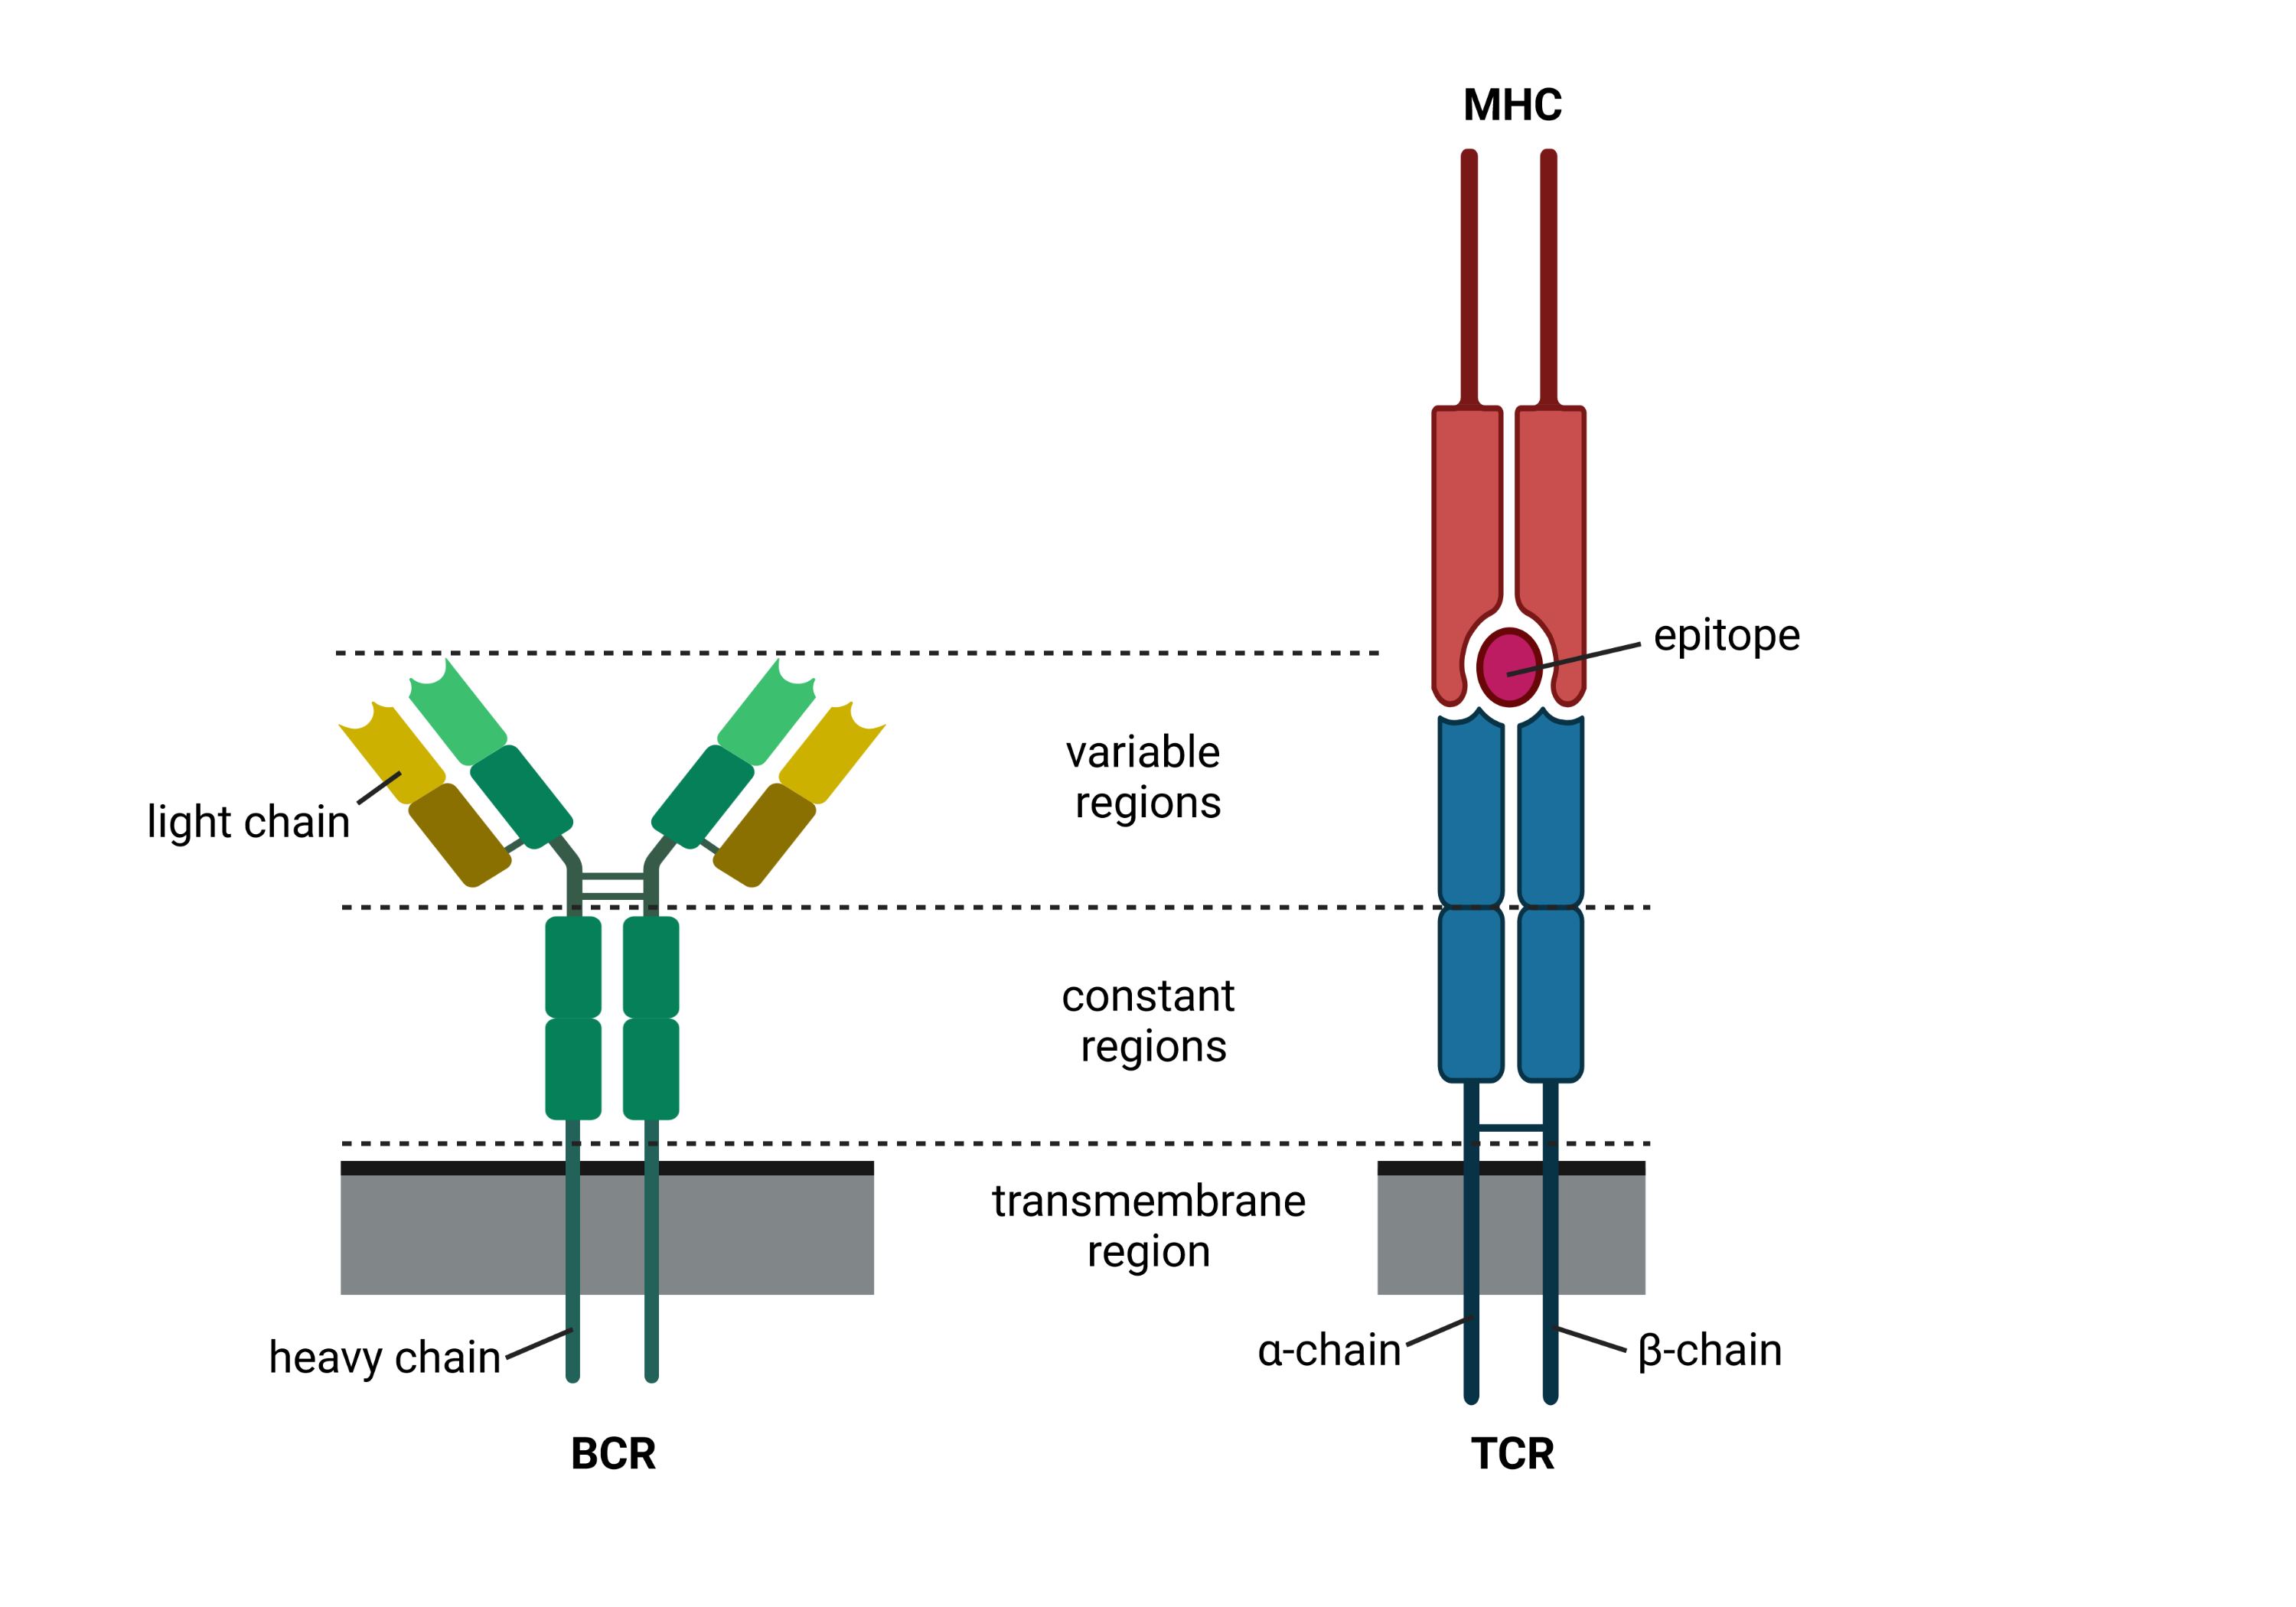
图 1:两类 AIR 的结构示意图。使用以下工具绘制:BioRender.com。
通过 V(D)J 重组形成适应性免疫受体
TCR 的抗原识别部分由两条链组成,分别为 α/β 链或 γ/δ 链。BCR 的膜结合免疫球蛋白则由两条相同的重链和两条相同的轻链组成,轻链分为 κ 和 λ 两型。两类受体均与相应的信号转导蛋白形成复合体。受体可变区由可变(variable, V)、多样性(diversity, D)和连接(joining, J)基因片段重组而成:α、γ、κ、λ 链使用 V 和 J 片段,β、δ 及免疫球蛋白重链还使用 D 片段。为简化表述,本书将这两类序列分别称为 VJ 链和 VDJ 链。
为识别广泛的抗原,AIR 具有极高的序列多样性。文献估计 TCR 潜在的序列空间可达 1020 量级,而单个人体内不同 TCR 序列的数量可达 107 量级 Zarnitsyna et al., 2013。BCR 的潜在多样性也有高达 1018 的估计 Briney et al., 2019。这些估计的口径不同,不能将理论序列空间等同于一个人体内实际存在的受体数。一个个体所拥有的全部 AIR 构成其适应性免疫受体库(adaptive immune receptor repertoire, AIRR)。
V(D)J 重组通过以下机制产生序列多样性:
组合多样性(combinatorial diversity):不同 V、D、J 基因片段的组合,以及不同 VJ 链与 VDJ 链的配对,共同增加受体种类。
连接多样性(junctional diversity):基因片段连接处的核苷酸插入和切除产生额外的序列变化。
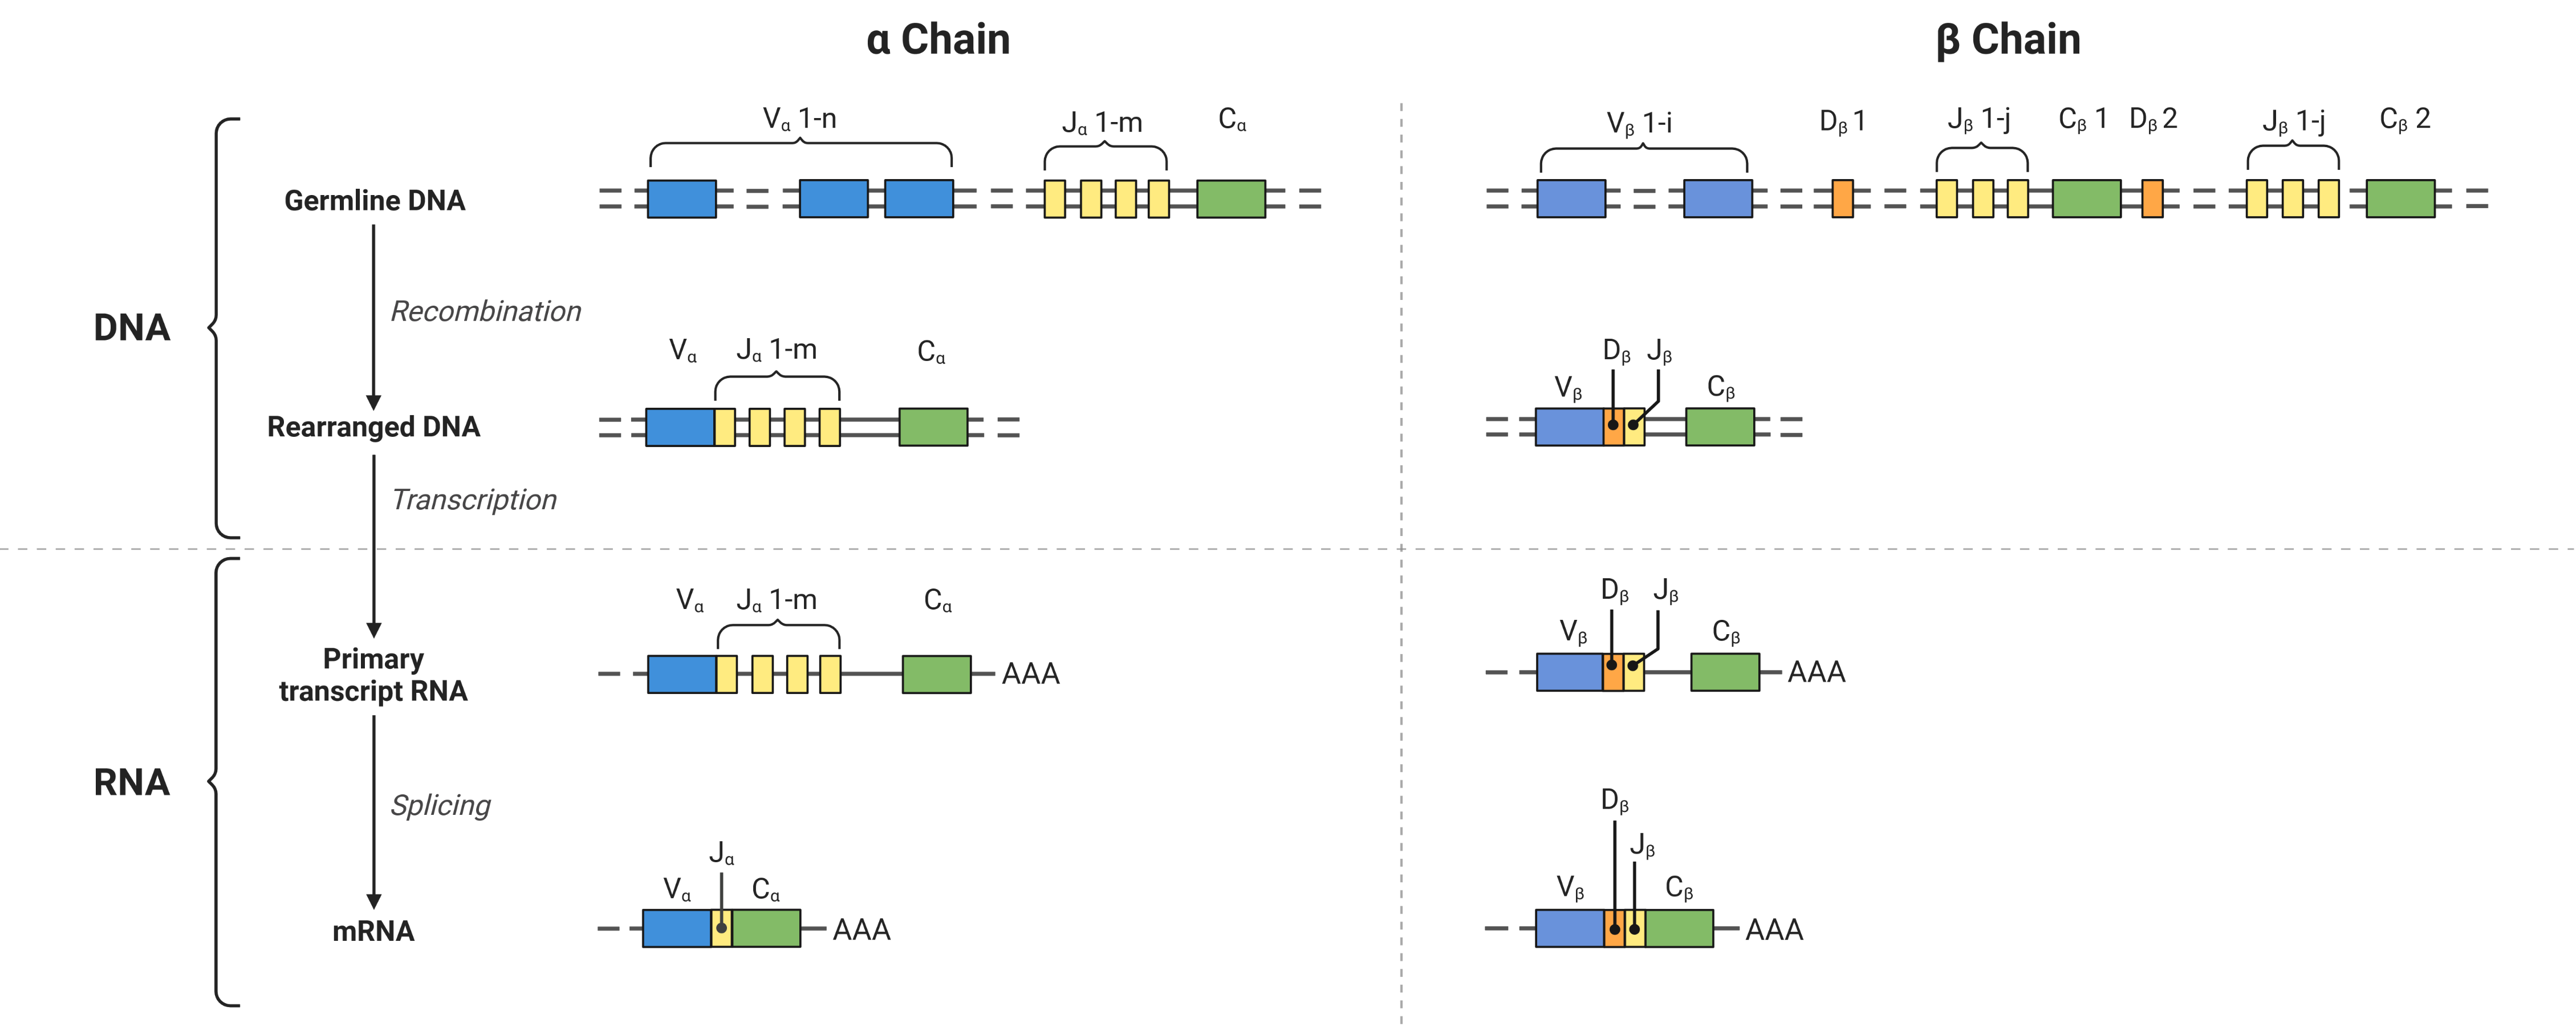
图 2:以 αβ TCR 为例展示 V(D)J 重组。使用以下工具绘制:BioRender.com。
此外,活化 B 细胞增殖时,免疫球蛋白可变区还会发生体细胞高频突变(Somatic Hypermutation, SHM)。突变与后续选择共同促进亲和力成熟(affinity maturation);并非每次突变都会提高抗原结合亲和力。
每条 AIR 链的可变区包含三个高度可变的互补决定区(Complementarity-Determining Regions, CDRs),即 CDR1–3,参与抗原识别。CDR1 和 CDR2 由 V 基因编码,CDR3 则跨越 V、D、J 或 V、J 的连接区域,因此通常最多样。VDJ 链的 CDR3 常被用作受体特异性的重要表征,但受体的结合特异性还取决于配对链及其他区域,不能仅凭一条 CDR3 序列确证。
VDJ 测序
细胞分离
进行单细胞测量前,需要根据研究目的富集并分离目标细胞。常用方法包括:
荧光激活细胞分选(Fluorescence-Activated Cell Sorting, FACS):基于流式细胞术,先用荧光探针标记细胞悬液中的目标细胞。细胞随高速液流经过检测区,仪器逐个测量荧光信号;液流在振动作用下分成液滴,再通过对液滴充电和偏转完成分选。
磁激活细胞分选(Magnetic-Activated Cell Sorting, MACS):用连接抗体、酶、凝集素或链霉亲和素等分子的磁珠标记细胞,再施加磁场保留带磁珠的细胞,洗去其他细胞,最后收集目标群体。也可以采用负向分选:用一组标记物标记非目标细胞,将其磁性截留,并收集未被标记的目标细胞。这种方式无需直接标记目标细胞。
激光捕获显微切割(Laser Capture Microdissection, LCM):根据显微镜下的形态定位组织切片中的细胞群或单个细胞,再选择性取出。系统通常包括显微镜、激光控制单元、载物台控制装置、CCD 相机和显示器。在热塑膜捕获方案中,激光脉冲局部熔化薄膜,使其黏附目标细胞以便取出。这种方法能尽量减少对周围组织的扰动,但不能保证完全没有损伤。
微流控(microfluidics):在微小通道中处理细胞悬液,操作体积可低至纳升级。分离机制包括细胞亲和捕获、利用大小等物理性质、免疫磁珠以及介电性质差异。以亲和捕获为例,可在芯片表面固定抗体,使流过的目标细胞被捕获;洗去未结合成分后,再释放细胞供后续分析。微流控并不限于这一种分离机制 Hu et al., 2016。
免疫受体测序
一种获取单细胞 V(D)J 链序列的方法,是从全长单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)数据中进行计算重建。常用的 Smart-seq2 是全长转录本方案,不能简单等同于只测量 5′ 端的表达定量方案。TRAPeS、TraCer 和 VDJPuzzle 可从 scRNA-seq 数据重建 TCR 序列;BALDR Upadhyay et al., 2018、BASIC Canzar et al., 2016 和 BraCer Lindeman et al., 2018 则用于恢复 BCR 序列。不过,短读长重建可能无法完整捕捉 V(D)J 区域的重组产物和可变剪接形式。为改善这一点,RAGE-seq 等方法将免疫受体转录本的靶向富集与 Oxford Nanopore 长读长测序(long-read sequencing)结合,以获取更完整的序列;同一实验的转录组部分则可使用 Illumina 等短读长平台测量 Singh et al., 2019。
AIR 库分析
单细胞 VDJ 测序可提供受体链的核苷酸序列及对应的氨基酸序列,并借助细胞标识关联 VJ 链与 VDJ 链。由此可注释 V、D、J、恒定区(constant, C)基因及 CDR3 序列。AIR 序列与 B、T 细胞的抗原识别能力密切相关,为研究细胞功能提供线索,但通常不能单凭序列直接确定靶抗原。AIR 信息主要可用于以下三类分析:
表型分析:根据相同或相似 AIR 将细胞分组,研究相关群体在不同条件下的变化,例如刺激后的转录组响应、克隆扩增(clonal expansion)或免疫应答前后的受体库多样性。序列相似可提示功能关联,但并不保证识别同一抗原。
序列分析:针对已识别的 AIR 群体,例如其他模态提示发生响应的细胞簇,分析 V、D、J 基因使用情况及富集的序列基序(motif),寻找与疾病或治疗相关的特征。
特异性推断:通过数据库匹配、序列距离或预测模型,为 AIR 提出候选靶抗原,定位可能对感染、肿瘤或自身抗原产生反应的细胞。结果仍需结合数据库证据、模型适用范围和实验验证解释。
数据集
本教程使用 Haniffa Lab 发布的数据集演示 IR 的预处理和分析方法 Stephenson et al., 2021。该研究围绕严重急性呼吸综合征冠状病毒 2(Severe Acute Respiratory Syndrome Coronavirus 2, SARS-CoV-2),收集了 130 名参与者的超过 750,000 个外周血单个核细胞(Peripheral Blood Mononuclear Cells, PBMCs)的转录组数据,参与者包括感染者及对照。
数据来自 Newcastle、Cambridge 和 London 三个中心,涵盖无症状、轻度、中度、重度和危重症感染者,以及健康人、其他严重呼吸道疾病患者和静脉注射脂多糖(lipopolysaccharide, LPS)以模拟全身炎症反应的健康参与者等对照。数据还提供年龄、性别和吸烟状态等参与者层面的信息。
我们选择这一社区较熟悉的大规模单细胞数据集,是因为它同时包含 VDJ 测序信息。本教程分析其中具有 IR 注释的超过 150,000 个 B 细胞和 200,000 个 T 细胞。
运行以下命令下载数据:
path_data = "data/"
path_bcr_input = f"{path_data}/BCR_00_read_aligned.csv"
path_tcr_input = f"{path_data}/TCR_00_read_aligned.tsv"
! wget -O $path_bcr_input -nc https://figshare.com/ndownloader/files/35574338
! wget -O $path_tcr_input -nc https://figshare.com/ndownloader/files/35574539输出
--2022-06-07 18:30:52--  https://figshare.com/ndownloader/files/35574338
Resolving figshare.com (figshare.com)... 54.72.163.193, 52.50.42.102, 2a05:d018:1f4:d000:7421:2135:71b2:6a10, ...
Connecting to figshare.com (figshare.com)|54.72.163.193|:443... connected.
HTTP request sent, awaiting response... 302 Found
Location: https://s3-eu-west-1.amazonaws.com/pfigshare-u-files/35574338/bcr_cellranger.csv?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=AKIAIYCQYOYV5JSSROOA/20220607/eu-west-1/s3/aws4_request&X-Amz-Date=20220607T163052Z&X-Amz-Expires=10&X-Amz-SignedHeaders=host&X-Amz-Signature=b18cb63ca03820e07cb8b3d9375466ca6405e655822269f5ae36d7449a28b810 [following]
--2022-06-07 18:30:52--  https://s3-eu-west-1.amazonaws.com/pfigshare-u-files/35574338/bcr_cellranger.csv?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=AKIAIYCQYOYV5JSSROOA/20220607/eu-west-1/s3/aws4_request&X-Amz-Date=20220607T163052Z&X-Amz-Expires=10&X-Amz-SignedHeaders=host&X-Amz-Signature=b18cb63ca03820e07cb8b3d9375466ca6405e655822269f5ae36d7449a28b810
Resolving s3-eu-west-1.amazonaws.com (s3-eu-west-1.amazonaws.com)... 52.218.62.171
Connecting to s3-eu-west-1.amazonaws.com (s3-eu-west-1.amazonaws.com)|52.218.62.171|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 84451806 (81M) [text/csv]
Saving to: ‘data//BCR_00_read_aligned.csv’

100%[======================================>] 84,451,806  39.1MB/s   in 2.1s

2022-06-07 18:30:54 (39.1 MB/s) - ‘data//BCR_00_read_aligned.csv’ saved [84451806/84451806]

--2022-06-07 18:30:55--  https://figshare.com/ndownloader/files/35574539
Resolving figshare.com (figshare.com)... 54.72.163.193, 52.50.42.102, 2a05:d018:1f4:d000:7421:2135:71b2:6a10, ...
Connecting to figshare.com (figshare.com)|54.72.163.193|:443... connected.
HTTP request sent, awaiting response... 302 Found
Location: https://s3-eu-west-1.amazonaws.com/pfigshare-u-files/35574539/TCR_mergedUpdated.tsv?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=AKIAIYCQYOYV5JSSROOA/20220607/eu-west-1/s3/aws4_request&X-Amz-Date=20220607T163055Z&X-Amz-Expires=10&X-Amz-SignedHeaders=host&X-Amz-Signature=141ab989ae794394fb6c441d50c0ea6771f96a8d048a8a4c400c10dba267b97c [following]
--2022-06-07 18:30:55--  https://s3-eu-west-1.amazonaws.com/pfigshare-u-files/35574539/TCR_mergedUpdated.tsv?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=AKIAIYCQYOYV5JSSROOA/20220607/eu-west-1/s3/aws4_request&X-Amz-Date=20220607T163055Z&X-Amz-Expires=10&X-Amz-SignedHeaders=host&X-Amz-Signature=141ab989ae794394fb6c441d50c0ea6771f96a8d048a8a4c400c10dba267b97c
Resolving s3-eu-west-1.amazonaws.com (s3-eu-west-1.amazonaws.com)... 52.218.62.171
Connecting to s3-eu-west-1.amazonaws.com (s3-eu-west-1.amazonaws.com)|52.218.62.171|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 247085830 (236M) [text/tab-separated-values]
Saving to: ‘data//TCR_00_read_aligned.tsv’

100%[======================================>] 247,085,830 42.4MB/s   in 5.8s

2022-06-07 18:31:01 (40.9 MB/s) - ‘data//TCR_00_read_aligned.tsv’ saved [247085830/247085830]
加载数据
本教程主要使用以下两个 Python 包读取数据、按细胞整理信息并进行可视化:
Scanpy:通用单细胞分析包(https://
github .com /theislab /scanpy,Wolf et al., 2018) Scirpy:用于免疫受体分析的 Scanpy 扩展(https://
github .com /scverse /scirpy,Sturm et al., 2020)
这里使用 Scirpy 演示 IR 分析。其他具有相关功能的工具包括 immunarch(R,ImmunoMind Team, 2019)、scRepertoire(R,Borcherding et al., 2020)、dandelion(Python,并整合部分 R 工具,Stephenson et al., 2021)和 Platypus(R,Yermanos et al., 2021)。工具比较可参阅 Valkiers et al., 2022。
import warnings

warnings.filterwarnings(
    "ignore",
    ".*IProgress not found*",
)
warnings.simplefilter(action="ignore", category=FutureWarning)

import pandas as pd
import scanpy as sc
import scirpy as ir

warnings.simplefilter(action="ignore", category=pd.errors.DtypeWarning)
先设置数据的输入与输出路径。
path_bcr_out = f"{path_data}/BCR_01_preprocessed.h5ad"

path_tcr_csv = f"{path_data}/TCR_00_read_aligned.csv"
path_tcr_out = f"{path_data}/TCR_01_preprocessed.h5ad"原始数据
先查看 Cell Ranger 流程(pipeline)的输出,了解数据结构。下面读取 filtered_contig_annotations.csv" 文件,每行对应一条组装序列(contig)的注释。原文文件名末尾多出的引号属于示例文本笔误;实际读取路径由代码变量指定。下方对 productive 列的类型转换仅修改当前 DataFrame,不会改写输入文件。
df_bcr_raw = pd.read_csv(path_bcr_input, index_col=0)

# The column 'productive' contains mixed data types which are not compatible with downstream tools.
# We correct them by casting them to strings.
df_bcr_raw["productive"] = df_bcr_raw["productive"].astype(str)
print(f"Total measurements: {len(df_bcr_raw)}")
df_bcr_raw.head(5)
Total measurements: 373670
下面列出与预处理和分析相关的字段。Cell Ranger 的详细字段说明见官方文档(https://
barcode:该 contig 所属细胞的条形码(Barcode)。
is_cell:该 Barcode 是否被判定为细胞。
high_confidence:该 contig 是否通过高置信度判定的布尔标记,并非校准后的概率。
chain:受体链的类型,例如 TRA 为 TCR α 链,IGH 为免疫球蛋白重链。
{v,d,j,c}_gene:受体 V、D、J、C 片段的基因注释。
full_length:是否满足全长序列的判定条件,见下文。
productive:是否满足 productive 的序列判定条件,见下文。
cdr3{_nt}:cdr3 为 CDR3 的氨基酸序列,cdr3_nt 为其核苷酸序列。
patient_id:参与者 ID。
Productive AIR 的判定
检测到 AIR 序列,并不意味着该序列一定能够编码完整受体。productive 表示序列满足相应的阅读框、起始密码子等判定条件;不满足的序列标为 non-productive。这是编码潜力的注释,不能证明受体具有功能性抗原结合能力。Scirpy 的默认分析通常不使用 non-productive 链;较新版本可将这些链保留在原始 AIRR 数据中,在链索引阶段排除,而不一定在读取时删除。10x Genomics 的 官方定义 包括以下条件:
序列跨越 V 基因到 J 基因。
前导区含有起始 密码子。
CDR3 与起始密码子处于同一阅读框。
V–J 区间内不存在同框终止密码子。
示例 1:序列未覆盖完整的 V–J 区间,对应 full_length 列为假。此类 contig 常缺少基因注释,尤其是 V 或 J 基因注释。
columns = [
    "barcode",
    "v_gene",
    "d_gene",
    "c_gene",
    "j_gene",
    "productive",
    "full_length",
]
df_bcr_raw[~df_bcr_raw["full_length"]][columns].head()示例 2:contig 被标为 full_length,但缺少可识别的 CDR3,因此未被判为 productive。
columns += ["cdr3", "cdr3_nt"]
df_bcr_raw[(df_bcr_raw["productive"] == "False") & (df_bcr_raw["full_length"])][
    columns
].head(5)下面读取 TCR 数据,将制表符分隔格式转换为逗号分隔格式,供后续使用。由于不同样本的 Barcode 可能重复,代码将跨样本唯一的 CellID 列移出原位置,作为 barcode 列。除 contig 注释外,数据还包含年龄、结局等参与者信息和细胞类型注释。
df_tcr_raw = pd.read_csv(path_tcr_input, sep="\t")
df_tcr_raw["barcode"] = df_tcr_raw.pop("CellID")
df_tcr_raw.to_csv(path_tcr_csv)
print(f"Total measurements: {len(df_tcr_raw)}")
df_tcr_raw.head()
Total measurements: 547630
这份 TCR 数据已预先处理:示例中的 contig 均被标注为 full_length 和 productive。
df_tcr_raw["full_length"].value_counts()True 547630
Name: full_length, dtype: int64df_tcr_raw["productive"].value_counts()True 547630
Name: productive, dtype: int64按细胞整理数据
为进行细胞层面的分析,需要根据细胞条形码(cell barcode, CB),将逐条 contig 记录归并到对应细胞。一个细胞通常关联多条 contig,因为其受体包含 VJ 类链和 VDJ 类链;有些细胞还可能表达额外的受体链 Schuldt & Binstadt, 2019。
Scirpy 在读取受支持格式的受体数据时,会自动按细胞整理这些记录:
adata_tcr = ir.io.read_10x_vdj(path_tcr_csv)
print(f"Amount cells: {len(adata_tcr)}")
WARNING: Non-standard locus name ignored: Multi
Amount cells: 280045
本章旧版示例将 IR 信息存放在 adata_tcr.obs 这一 pandas DataFrame 中,每行对应一个细胞。下面列出旧格式的字段;Scirpy v0.13 起主要将链记录保存在 .obsm["airr"],并通过链索引选取用于分析的 VJ/VDJ 链,不能假定以下列在新版中仍直接存在。
has_ir:是否检测到 IR。
multi_chain:是否检测到超过两条 VJ 链或超过两条 VDJ 链,而非受体链总数是否超过二。
extra_chains:旧格式中用于保存额外链的信息。
旧格式还将 contig 注释展开为列:分别记录 VJ 与 VDJ 两类链,每个细胞每类最多保留两条主要 contig,形成下列字段。这里的“两条”是每一链类别的上限,不是一个细胞全部链的总数上限。
IR_V{D}J_{1,2}_locus
IR_V{D}J_{1,2}_productive
IR_V{D}J_{1,2}_{v,d,j,c}_call
IR_V{D}J_{1,2}_junction{_aa}
adata_tcr.obs.head(5)读取受体数据时不会自动加入这些参与者注释。下面从原始表中提取相关字段,去重后以 Barcode 为索引,整理为细胞层面的注释表。
patient_information = [
    "barcode",
    "Centre",
    "Sample",
    "patient_id",
    "Collection_Day",
    "Sex",
    "Swab_result",
    "Status",
    "Smoker",
    "Status_on_day_collection",
    "Status_on_day_collection_summary",
    "Days_from_onset",
    "time_after_LPS",
    "Worst_Clinical_Status",
    "Outcome",
    "initial_clustering",
    "study_id",
    "AgeRange",
    "Age",
]
df_patient = df_tcr_raw[patient_information].copy()
df_patient["Days_from_onset"] = df_patient["Days_from_onset"].astype(
    str
)  # mixed type (str, int)
df_patient = df_patient.drop_duplicates().reset_index(drop=True)

# Assigning barcode as index
df_patient.index = df_patient.pop("barcode")
df_patient.index.name = None
df_patient.head()将注释表加入 AnnData 的 .obs;pandas 会按细胞索引对齐,然后检查结果。
adata_tcr.obs[df_patient.columns] = df_patient
adata_tcr.obs.head()同样读取 BCR 数据并检查 IR 注释。此处 read_10x_vdj 会重新读取输入文件,前面对 df_bcr_raw 的类型转换不会自动传递到这次读取。
adata_bcr = ir.io.read_10x_vdj(path_bcr_input)
adata_bcr.obs.head(5)
WARNING: Non-standard locus name ignored: Multi
WARNING: Non-standard locus name ignored: None
再从 BCR 的 contig 表中提取参与者信息,去重并设置细胞索引。
patient_information = ["barcode", "patient_id"]
df_patient = df_bcr_raw[patient_information].copy()
df_patient = df_patient.drop_duplicates().reset_index(drop=True)

# Assigning barcode as index
df_patient.index = df_patient.pop("barcode")
df_patient.index.name = None
df_patient.head()将这些信息加入细胞注释:
adata_bcr.obs[df_patient.columns] = df_patient
adata_bcr.obs.head()质量控制
可靠分析需要质量合适的输入数据。应先识别受体信息不完整或链组合异常的细胞:
受体信息不完整:只检测到 VJ 或 VDJ 链,另一类链可能在测序或重建中遗漏。这些记录仍可能来自真实细胞,但不适用于需要完整配对受体序列的分析。
额外受体链:一个细胞可能检测到多条 VJ 或 VDJ 链。T、B 细胞天然表达双受体的情况已有报道 Schuldt & Binstadt, 2019。若检测到超过两条 VJ 链或超过两条 VDJ 链,则应警惕双细胞(Doublet)或其他技术问题;额外一条链本身并不足以确证 Doublet。
汇总每个细胞的受体链后,可以标记其链配对状态,再按下游任务选择合适的细胞。不同分析对链信息完整性的要求并不相同。
标记 AIR 状态
ir.tl.chain_qc(adata_tcr)ir.tl.chain_qc(adata_bcr)chain_qc 生成受体类型、亚型和链配对状态三类注释。主要取值如下:
chain_pairing(链配对状态)
orphan {VJ}/{VDJ}(孤链):只检测到一条 VJ 链或一条 VDJ 链。
single pair(单对):检测到一条 VJ 链和一条相匹配的 VDJ 链。
extra {VJ}/{VDJ}(额外链):在一对 VJ/VDJ 链之外,还检测到一条额外的 VJ 或 VDJ 链。
two full chains(两对链):检测到两条 VJ 链和两条 VDJ 链,且类别相匹配;这类注释不能单独证明每条链在细胞内的实际物理配对。
multichain(多链):超过两条 VJ 链或超过两条 VDJ 链,提示可能存在 Doublet。
receptor_type(受体类型):包括 BCR、TCR、no IR(无受体)和 ambiguous(类型不明确,如同时包含 TCR 与 BCR 链);较新版本还会单列 multichain。
receptor_subtype(受体亚型):区分 αβ、γδ TCR 及含 κ 或 λ 轻链的 BCR 等组合;实际字符串标签以所用 Scirpy 版本为准。
可视化
不同样本、采集中心或数据来源的链配对质量可能不同,应按这些分组查看各类状态的分布。下面比较三个采集中心的数据。
_ = ir.pl.group_abundance(adata_tcr, groupby="Centre", target_col="chain_pairing")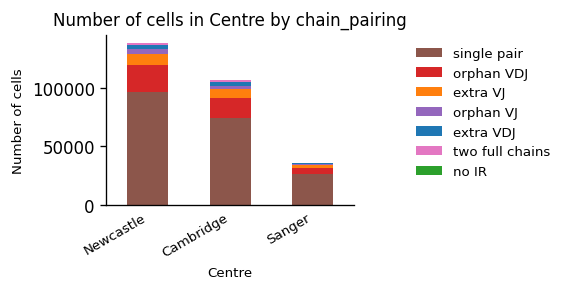
三个中心都以 single pair 细胞为主,说明多数细胞获得了一对受体链。比较不同中心时,可进一步查看各状态的细胞比例,以减少总细胞数差异对图形的影响:
_ = ir.pl.group_abundance(
    adata_tcr, groupby="Centre", target_col="chain_pairing", normalize=True
)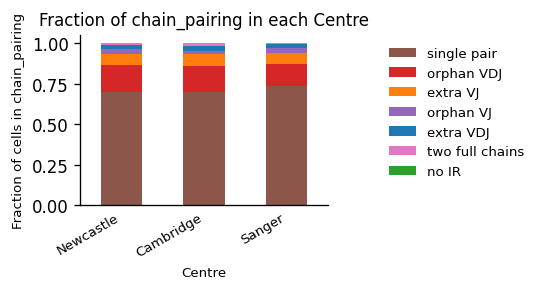
本例三个中心的链配对组成总体相近:single pair 最多,其次是 orphan VDJ 和 orphan VJ。原教程将单对受体超过 60%、孤链约 10–20%、额外链约 10% 作为示例性参考,这些比例不是适用于所有实验的固定质控阈值。多模态测序中,无 AIR 信息的细胞比例还取决于样本中不表达这类受体的细胞占比,以及受体捕获效率。
_ = ir.pl.group_abundance(
    adata_tcr, groupby="Centre", target_col="receptor_type", normalize=True
)
_ = ir.pl.group_abundance(
    adata_tcr, groupby="Centre", target_col="receptor_subtype", normalize=True
)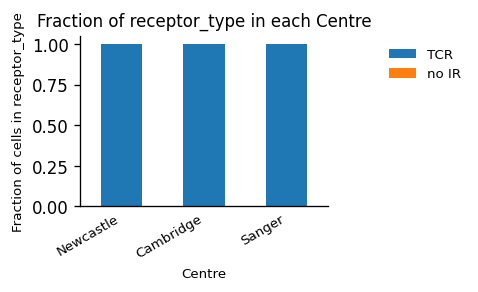
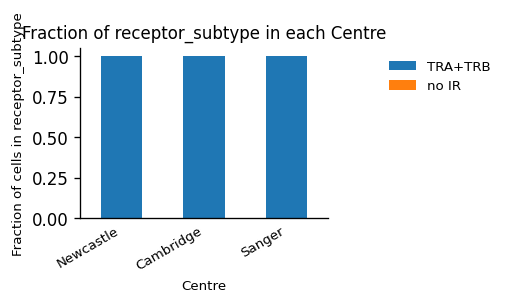
第一张图主要显示 TCR,符合这里已将 T、B 细胞数据分开处理的设置;本例检出的 TCR 为 αβ 型。无 AIR 信息的细胞比例太小,难以从图中辨认,因此再查看绝对数量。原教程输出中,这类细胞为 22 个;在包含其他细胞类型的多模态数据中,该比例可能更高。
adata_tcr.obs["chain_pairing"].value_counts()single pair 196957
orphan VDJ 45266
extra VJ 19034
orphan VJ 7937
extra VDJ 7473
two full chains 3356
no IR 22
Name: chain_pairing, dtype: int64对 BCR 按参与者比较。为便于展示,下面选择 COVID-003 和 AP11 两名参与者的细胞;这一步是指定参与者取子集,并非随机下采样。
adata_bcr_tmp = adata_bcr[
    adata_bcr.obs["patient_id"].isin(["COVID-003", "AP11"])
].copy()
_ = ir.pl.group_abundance(
    adata_bcr_tmp, groupby="patient_id", target_col="chain_pairing"
)
_ = ir.pl.group_abundance(
    adata_bcr_tmp, groupby="patient_id", target_col="chain_pairing", normalize=True
)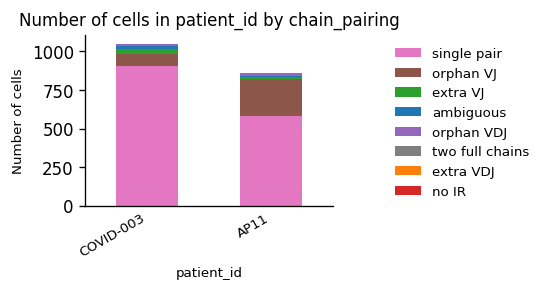
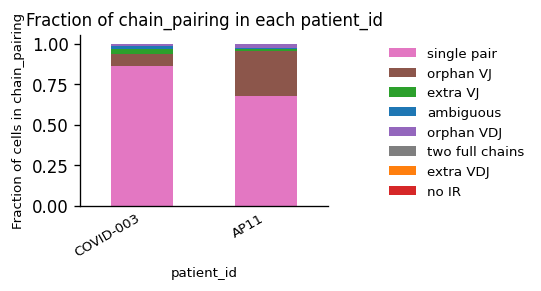
两名参与者的 B 细胞数量差异较大,但链配对状态的比例相近。
_ = ir.pl.group_abundance(
    adata_bcr_tmp, groupby="patient_id", target_col="receptor_type", normalize=True
)
_ = ir.pl.group_abundance(
    adata_bcr_tmp, groupby="patient_id", target_col="receptor_subtype", normalize=True
)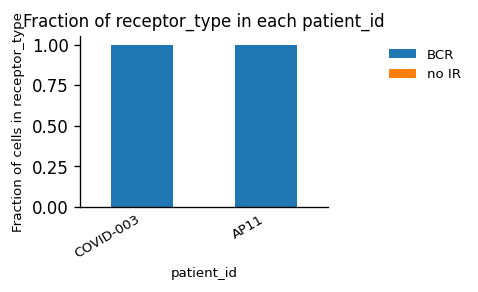
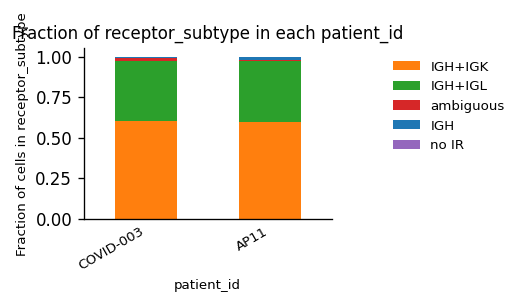
该子集同样只包含一种受体类型,即 BCR;不同细胞分别使用 κ 或 λ 轻链。
过滤
是否按 AIR 状态过滤,取决于研究所需的信息以及可接受的数据量损失。常见做法是保留全部细胞及状态标签,在各项下游分析前再选择可用记录。例如,仅用 VDJ 链的 CDR3 查询数据库时可以纳入 orphan VDJ;若查询需要完整配对受体,则必须同时具备 VJ 和 VDJ 信息。原文此处的“第 X 章”是尚未补全的交叉引用。下面演示不同过滤条件,可按具体任务选择应用时机。
可以采用不同严格程度的条件,或组合多个条件:
has IR(具有受体):保留检测到 IR 的细胞,因为无受体序列的细胞无法参与相应的序列分析。
no multi chains(排除多链):排除超过两条 VJ 链或超过两条 VDJ 链的疑似 Doublet。
only one AIR(仅保留一组受体):排除两组链或额外链记录,以减少特异性归属到具体受体时的歧义。
no single chains(排除孤链):排除只具有 VJ 或 VDJ 信息的细胞,适用于要求完整链配对的分析。
本书后续仍使用完整数据,因此这里将逐步过滤的结果存入临时 AnnData 对象,并打印每一步保留的细胞数。注意:下面原始示例用 "multi_chain" 比较 chain_pairing,而 Scirpy 的分类值为 "multichain";两者不一致时,这一步不会排除预期记录。运行时应先核对实际类别。后续筛选 single pair 才会明确只保留单对链记录。
adata_bcr_tmp.obs["chain_pairing"].value_counts()single pair 1489
orphan VJ 312
extra VJ 46
ambiguous 31
orphan VDJ 25
two full chains 6
extra VDJ 4
no IR 1
Name: chain_pairing, dtype: int64print(f"Amount of all B cells:\t\t\t\t{len(adata_bcr)}")
adata_bcr_tmp = adata_bcr[adata_bcr.obs["chain_pairing"] != "no IR"]
print(f"Amount of B cells with AIR:\t\t\t{len(adata_bcr_tmp)}")
adata_bcr_tmp = adata_bcr_tmp[adata_bcr_tmp.obs["chain_pairing"] != "multi_chain"]
print(f"Amount of B cells without doublets:\t\t{len(adata_bcr_tmp)}")
adata_bcr_tmp = adata_bcr_tmp[
~adata_bcr_tmp.obs["chain_pairing"].isin(
["two full chains", "extra VJ", "extra VDJ"]
)
]
print(f"Amount of B cells with unique AIR per cell:\t{len(adata_bcr_tmp)}")
adata_bcr_tmp = adata_bcr_tmp[adata_bcr_tmp.obs["chain_pairing"] == "single pair"]
print(f"Amount of B cells with sinlge complete AIR:\t{len(adata_bcr_tmp)}")Amount of all B cells: 159446
Amount of B cells with AIR: 159185
Amount of B cells without doublets: 159185
Amount of B cells with unique AIR per cell: 153936
Amount of B cells with single complete AIR: 108395
最后的临时对象只保留 single pair 的 BCR 记录。严格过滤可能显著减少可用细胞,进而限制下游分析。
adata_bcr_tmp.obs["chain_pairing"].value_counts()single pair 108395
Name: chain_pairing, dtype: int64TCR 数据可按相同顺序过滤;同样需要注意上面说明的 multichain 字符串差异。
adata_tcr.obs["chain_pairing"].value_counts()single pair 196957
orphan VDJ 45266
extra VJ 19034
orphan VJ 7937
extra VDJ 7473
two full chains 3356
no IR 22
Name: chain_pairing, dtype: int64print(f"Amount of all T cells:\t\t\t\t{len(adata_tcr)}")
adata_tcr_tmp = adata_tcr[adata_tcr.obs["chain_pairing"] != "no IR"]
print(f"Amount of T cells with AIR:\t\t\t{len(adata_tcr_tmp)}")
adata_tcr_tmp = adata_tcr_tmp[adata_tcr_tmp.obs["chain_pairing"] != "multi_chain"]
print(f"Amount of T cells without doublets:\t\t{len(adata_tcr_tmp)}")
adata_tcr_tmp = adata_tcr_tmp[
~adata_tcr_tmp.obs["chain_pairing"].isin(
["two full chains", "extra VJ", "extra VDJ"]
)
]
print(f"Amount of T cells with unique AIR per cell:\t{len(adata_tcr_tmp)}")
adata_tcr_tmp = adata_tcr_tmp[adata_tcr_tmp.obs["chain_pairing"] == "single pair"]
print(f"Amount of T cells with sinlge complete AIR:\t{len(adata_tcr_tmp)}")Amount of all T cells: 280045
Amount of T cells with AIR: 280023
Amount of T cells without doublets: 280023
Amount of T cells with unique AIR per cell: 250160
Amount of T cells with sinlge complete AIR: 196957
adata_tcr_tmp.obs["chain_pairing"].value_counts()single pair 196957
Name: chain_pairing, dtype: int64最后保存带有受体状态注释的完整 adata_tcr 和 adata_bcr,供后续分析使用;此处保存的不是上面的临时过滤对象。
sc.write(adata=adata_tcr, filename=path_tcr_out)
sc.write(adata=adata_bcr, filename=path_bcr_out)测验
- Cooper, M. D., & Alder, M. N. (2006). The evolution of adaptive immune systems. Cell, 124(4), 815–822.
- Zarnitsyna, V., Evavold, B., Schoettle, L., Blattman, J., & Antia, R. (2013). Estimating the diversity, completeness, and cross-reactivity of the T cell repertoire. Frontiers in Immunology, 4, 485.
- Briney, B., Inderbitzin, A., Joyce, C., & Burton, D. R. (2019). Commonality despite exceptional diversity in the baseline human antibody repertoire. Nature, 566(7744), 393–397.
- Hu, P., Zhang, W., Xin, H., & Deng, G. (2016). Single cell isolation and analysis. Frontiers in Cell and Developmental Biology, 4, 116.
- Upadhyay, A. A., Kauffman, R. C., Wolabaugh, A. N., Cho, A., Patel, N. B., Reiss, S. M., Havenar-Daughton, C., Dawoud, R. A., Tharp, G. K., Sanz, I., Pulendran, B., Crotty, S., Lee, F. E.-H., Wrammert, J., & Bosinger, S. E. (2018). BALDR: a computational pipeline for paired heavy and light chain immunoglobulin reconstruction in single-cell RNA-seq data. Genome Medicine, 10(1), 20. 10.1186/s13073-018-0528-3
- Canzar, S., Neu, K. E., Tang, Q., Wilson, P. C., & Khan, A. A. (2016). BASIC: BCR assembly from single cells. Bioinformatics, 33(3), 425–427. 10.1093/bioinformatics/btw631
- Lindeman, I., Emerton, G., Mamanova, L., Snir, O., Polanski, K., Qiao, S.-W., Sollid, L. M., Teichmann, S. A., & Stubbington, M. J. T. (2018). BraCeR: B-cell-receptor reconstruction and clonality inference from single-cell RNA-seq. Nature Methods, 15(8), 563–565. 10.1038/s41592-018-0082-3
- Singh, M., Al-Eryani, G., Carswell, S., Ferguson, J. M., Blackburn, J., Barton, K., Roden, D., Luciani, F., Giang Phan, T., Junankar, S., & others. (2019). High-throughput targeted long-read single cell sequencing reveals the clonal and transcriptional landscape of lymphocytes. Nature Communications, 10(1), 1–13.
- Stephenson, E., Reynolds, G., Botting, R. A., Calero-Nieto, F. J., Morgan, M. D., Tuong, Z. K., Bach, K., Sungnak, W., Worlock, K. B., Yoshida, M., & others. (2021). Single-cell multi-omics analysis of the immune response in COVID-19. Nature Medicine, 27(5), 904–916.
- Wolf, F. A., Angerer, P., & Theis, F. J. (2018). SCANPY: large-scale single-cell gene expression data analysis. Genome Biology, 19(1), 1–5.
- Sturm, G., Szabo, T., Fotakis, G., Haider, M., Rieder, D., Trajanoski, Z., & Finotello, F. (2020). Scirpy: a Scanpy extension for analyzing single-cell T-cell receptor-sequencing data. Bioinformatics, 36(18), 4817–4818.
- ImmunoMind Team. (2019). immunarch: An R Package for Painless Bioinformatics Analysis of T-Cell and B-Cell Immune Repertoires. 10.5281/zenodo.3367200
- Borcherding, N., Bormann, N. L., & Kraus, G. (2020). scRepertoire: An R-based toolkit for single-cell immune receptor analysis. F1000Research, 9.
- Yermanos, A., Agrafiotis, A., Kuhn, R., Robbiani, D., Yates, J., Papadopoulou, C., Han, J., Sandu, I., Weber, C., Bieberich, F., & others. (2021). Platypus: an open-access software for integrating lymphocyte single-cell immune repertoires with transcriptomes. NAR Genomics and Bioinformatics, 3(2), lqab023.
- Valkiers, S., de Vrij, N., Gielis, S., Verbandt, S., Ogunjimi, B., Laukens, K., & Meysman, P. (2022). Recent advances in T-cell receptor repertoire analysis: bridging the gap with multimodal single-cell RNA sequencing. ImmunoInformatics, 100009.