⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: preprocessing
channels:
  - bioconda
  - conda-forge
dependencies:
  - conda-forge::ipywidgets=8.1.5
  - conda-forge::leidenalg=0.10.2
  - conda-forge::numba=0.61.0
  - conda-forge::python=3.12.9
  - conda-forge::r-base=4.3.3
  - conda-forge::r-soupx=1.6.2
  - conda-forge::r-sctransform=0.4.1
  - conda-forge::r-glmpca=0.2.0
  - conda-forge::rpy2=3.5.11
  - conda-forge::scanpy=1.11.1
  - conda-forge::session-info=1.0.0
  - bioconda::anndata2ri=1.3.2
  - bioconda::bioconductor-scdblfinder=1.16.0
  - bioconda::bioconductor-scry=1.14.0
  - bioconda::bioconductor-scran=1.30.0
  - bioconda::bioconductor-glmgampoi=1.14.0
  - pip
  - pip:
      - lamindb[bionty,jupyter]
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
我们现在得到了一份归一化(normalization)后的数据表示,它在保留生物学异质性的同时,降低了基因表达中的技术性采样效应。单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq) 数据集通常包含多达 30,000 个基因(取决于物种),而到目前为止,我们只去除了在少于 20 个细胞中检测到的基因。然而,剩余基因中有许多并不具信息量,且大多为零计数。因此,标准的预处理流程会包含特征选择(feature selection)这一步,旨在剔除那些不具信息量、可能无法代表样本间有意义生物学变异的基因。
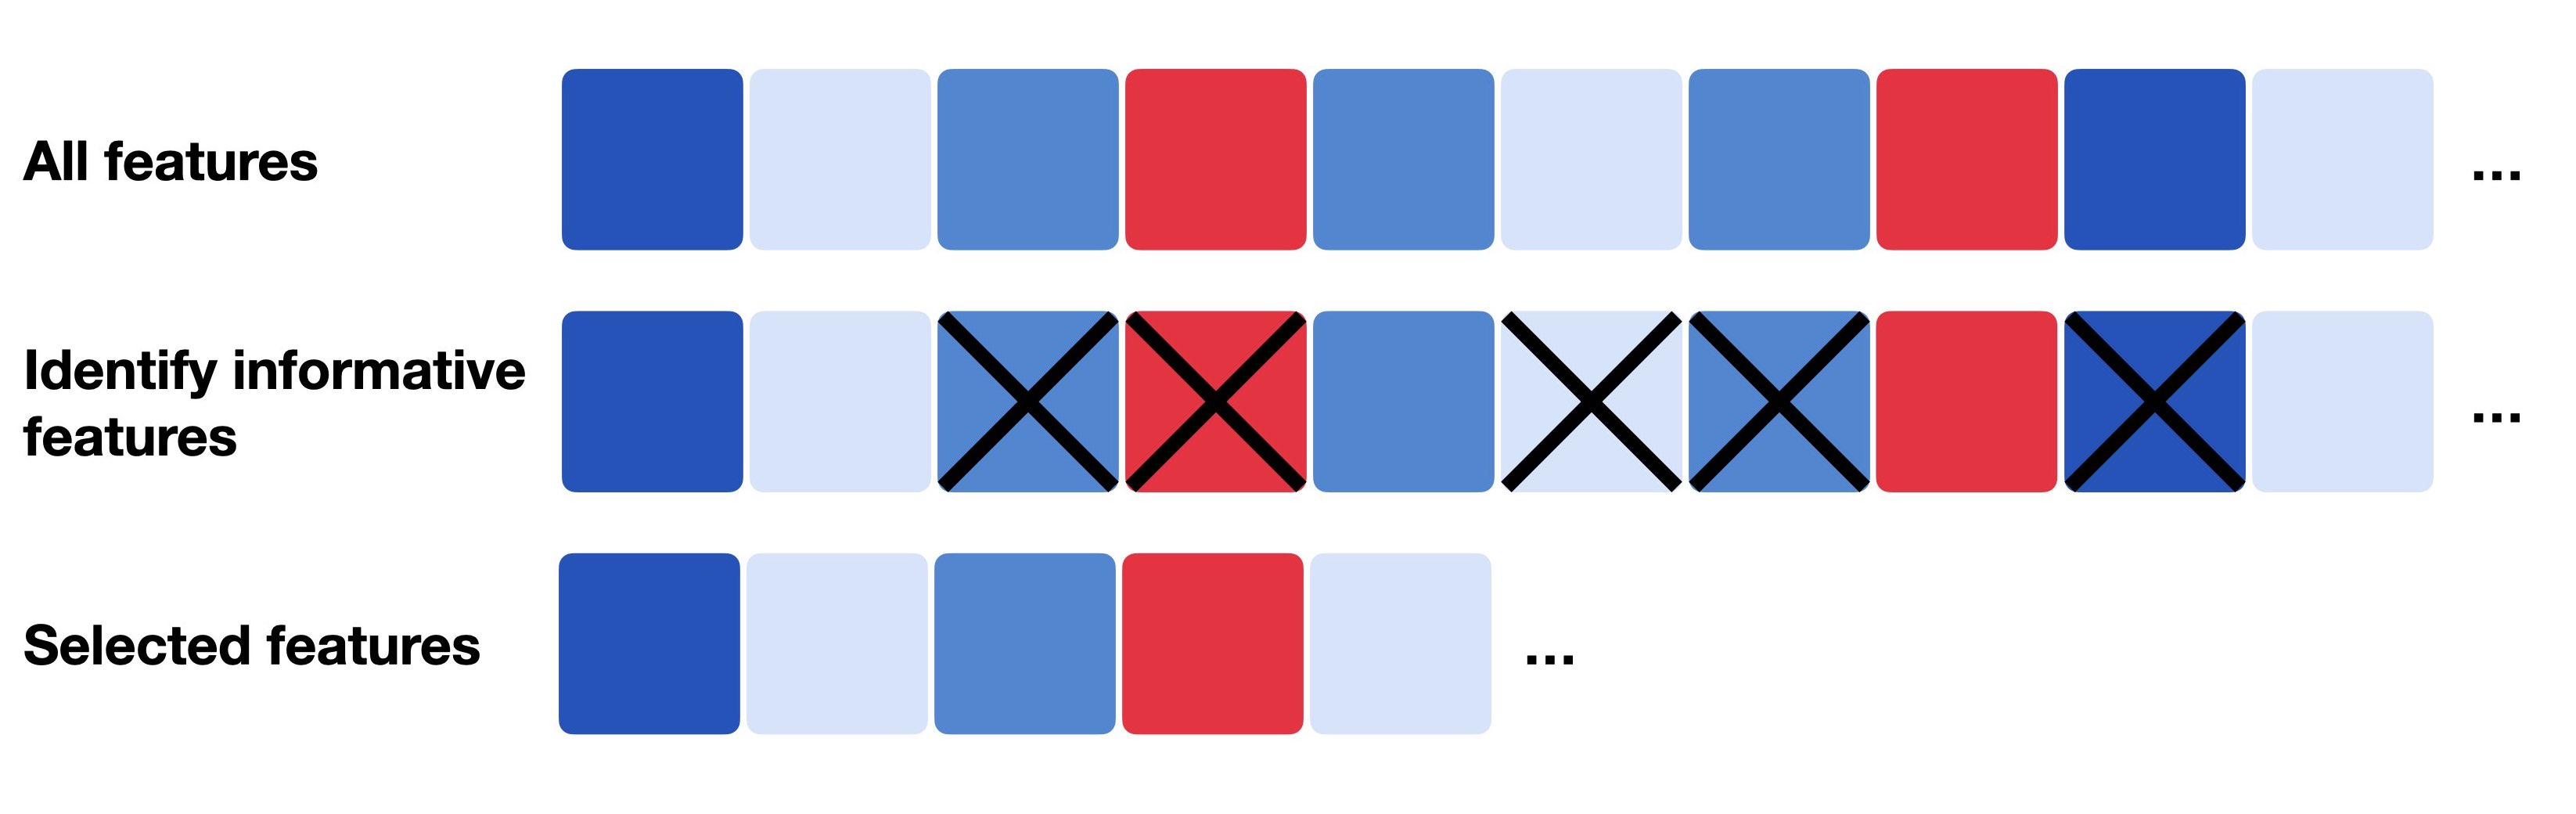
图 1:特征选择通常指只选取一部分相关特征(基因)的过程,这些特征可以是最具信息量的、变异最大的,或偏差最高的。
通常,scRNA-seq 实验聚焦于某一特定组织,因此只有一小部分基因是有信息量、且在生物学上具有变异性的。传统方法和流程要么计算所有基因的变异系数(coefficient of variation, CV)(高变基因(highly variable gene, HVG)),要么计算所有基因的平均表达水平(高表达基因),从中选出 500–2000 个基因,并将这些特征用于下游分析步骤。然而,这些方法对此前所用的归一化技术非常敏感。如前所述,以往的预处理流程包括用 每百万计数(counts per million, CPM) 归一化、随后做对数变换。但由于对数变换无法作用于精确的零值,分析人员往往会加上一个小的 伪计数(pseudocount)(例如 1,即 log1p)到所有归一化计数上,然后再对数据取对数。然而,伪计数的选择是任意的,可能给变换后的数据引入偏倚。这种任意性进而也会影响特征选择,因为观测到的变异性取决于所选的伪计数。一个接近零的小伪计数值,会增大零计数基因的方差 Townes et al., 2019。
Germain 等人转而提出使用 偏差(deviance)来进行特征选择,它作用于原始计数 Germain et al., 2020。偏差可以用闭式(closed form)计算,用于量化某个基因是否在各细胞间呈现恒定的表达谱——这类基因不具信息量。表达恒定的基因可由一个多项分布零模型(multinomial null model)描述,并用二项偏差(binomial deviance)来近似。在各细胞间信息量很高的基因会有较高的偏差值,表明零模型对其拟合很差(即它们在各细胞间并非恒定表达)。该方法据此按偏差值对所有基因排序,只选取高偏差的基因。
偏差衡量什么?
偏差是基因计数在两个模型下对数似然(log-likelihood)之差的两倍:一个模型假定每个细胞都以相同速率产生该基因的计数,另一个模型则能完全重现观测计数。以恒定速率表达的基因能被共享速率模型很好地拟合,因此得分较低;只在某一细胞群中开启、而在其他细胞群中关闭的基因则得分较高。
与方差不同,偏差直接定义在原始计数上,因此无需预先归一化,也不会仅仅因为某个基因表达量高就将其排在前列。
如前所述,偏差可以用闭式计算,并由 R 包 scry 提供。
首先配置运行环境。
import logging

import lamindb as ln
import matplotlib.pyplot as plt
import numpy as np
import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro
import rpy2.robjects.packages as rpackages
import scanpy as sc
import seaborn as sns
from rpy2.robjects import default_converter, numpy2ri, pandas2ri, r
from rpy2.robjects.conversion import localconverter

# Suppress verbose logging from Scanpy
sc.settings.verbosity = 0

# Set figure parameters for clean, minimal plots
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

assert ln.setup.settings.instance.slug == "theislab/sc-best-practices"

ln.track()

rcb.logger.setLevel(logging.ERROR)


%load_ext rpy2.ipython
输出
→ loaded Transform('xKADqrV9wgwX0000'), re-started Run('yI5lBnmJ...') at 2025-05-30 16:25:12 UTC
→ notebook imports: lamindb==1.3.2 matplotlib==3.10.1 numpy==2.1.3 rpy2==3.5.11 scanpy==1.11.1 seaborn==0.13.2
The rpy2.ipython extension is already loaded. To reload it, use:
  %reload_ext rpy2.ipython
%%R
library(scry)
library(SingleCellExperiment)
接下来,加载 上一章 中已经归一化好的数据集。偏差作用于原始计数,因此无需把 adata.X 替换为某个归一化层,我们可以直接使用归一化笔记本中所存储的对象。
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="preprocessing_visualization/s4d8_normalization.h5ad", is_latest=True
)
adata = af.load()
adata
AnnData object with n_obs × n_vars = 14814 × 20223
obs: 'n_genes_by_counts', 'log1p_n_genes_by_counts', 'total_counts', 'log1p_total_counts', 'pct_counts_in_top_20_genes', 'total_counts_mt', 'log1p_total_counts_mt', 'pct_counts_mt', 'total_counts_ribo', 'log1p_total_counts_ribo', 'pct_counts_ribo', 'total_counts_hb', 'log1p_total_counts_hb', 'pct_counts_hb', 'outlier', 'mt_outlier', 'soupx_groups', 'scDblFinder_score', 'scDblFinder_class', 'size_factors'
var: 'gene_ids', 'feature_types', 'genome', 'interval', 'mt', 'ribo', 'hb', 'n_cells_by_counts', 'mean_counts', 'log1p_mean_counts', 'pct_dropout_by_counts', 'total_counts', 'log1p_total_counts', 'n_cells'
layers: 'analytic_pearson_residuals', 'counts', 'log1p_norm', 'scran_normalization', 'soupX_counts'与之前类似,我们将 AnnData 对象保存到 R 环境中。
X_sparse = adata.X.T.tocoo()

Matrix = rpackages.importr("Matrix")

with localconverter(ro.default_converter + pandas2ri.converter + numpy2ri.converter):
    ro.globalenv["obs"] = adata.obs
    ro.globalenv["var"] = adata.var

i, j = X_sparse.row, X_sparse.col
x = X_sparse.data

ro.globalenv["i"] = ro.IntVector((i + 1).tolist())  # R is 1-indexed
ro.globalenv["j"] = ro.IntVector((j + 1).tolist())
ro.globalenv["x"] = ro.FloatVector(x.tolist())

r("X <- sparseMatrix(i = i, j = j, x = x, dims = c({}, {}))".format(*X_sparse.shape))
<rpy2.robjects.methods.RS4 object at 0x164985550> [25]
R classes: ('dgCMatrix',)现在我们可以直接在未归一化的计数矩阵(count matrix)上调用基于偏差的特征选择,并将二项偏差值导出为一个向量。
%%R
sce <- SingleCellExperiment(
  assays = list(X = X),
  colData = obs,
  rowData = var
)

sce <- devianceFeatureSelection(sce, assay = "X")
with localconverter(default_converter + pandas2ri.converter + numpy2ri.converter):
binomial_deviance = ro.r("rowData(sce)$binomial_deviance")下一步,我们对该向量排序,选出偏差最高的前 4,000 个基因,并在 .var 中新增“highly_deviant”列来标记这些基因。我们还保存了计算得到的二项偏差,以便日后改选其他数量的高变基因。
idx = binomial_deviance.argsort()[-4000:]
mask = np.zeros(adata.var_names.shape, dtype=bool)
mask[idx] = True

adata.var["highly_deviant"] = mask
adata.var["binomial_deviance"] = binomial_deviance
最后,我们将特征选择的结果可视化。我们用一个 scanpy 函数计算每个基因在所有细胞中的均值和离散度。
sc.pp.highly_variable_genes(adata, layer="scran_normalization")我们通过绘制各基因的离散度对均值的散点图,并按“highly_deviant”着色,来查看结果。
ax = sns.scatterplot(
    data=adata.var, x="means", y="dispersions", hue="highly_deviant", s=5
)
ax.set_xlim(None, 1.5)
ax.set_ylim(None, 3)
plt.show()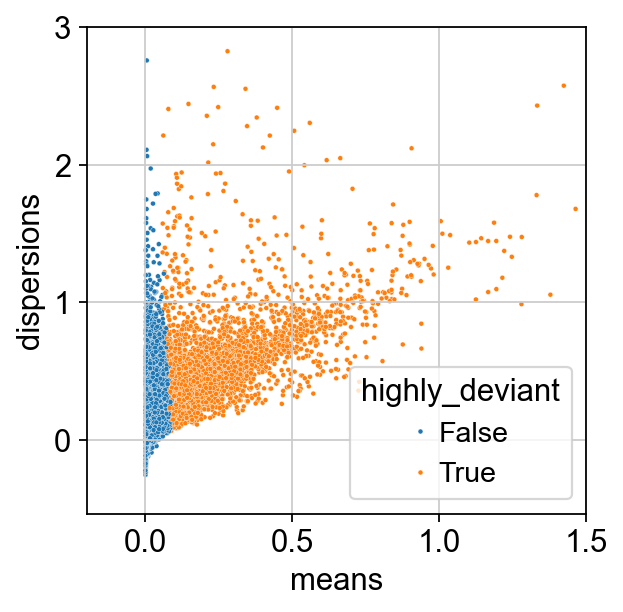
我们观察到,平均表达较高的基因被选为高偏差基因。这与以下研究的经验观察一致:Townes et al., 2019。
af = ln.Artifact.from_anndata(
    adata,
    key="preprocessing_visualization/s4d8_feature_selection.h5ad",
    description="anndata after feature selection",
).save()
af
输出
→ returning existing artifact with same hash: Artifact(uid='L5HAg9RzjUS8xFgu0001', is_latest=True, key='preprocessing_visualization/s4d8_feature_selection.h5ad', description='anndata after feature selection', suffix='.h5ad', otype='AnnData', size=4514546187, hash='3DjpkQ3uPn7ZpewbPan1yD', space_id=1, storage_id=1, run_id=9, created_by_id=5, created_at=2025-04-25 15:37:59 UTC); to track this artifact as an input, use: ln.Artifact.get()
Artifact(uid='L5HAg9RzjUS8xFgu0001', is_latest=True, key='preprocessing_visualization/s4d8_feature_selection.h5ad', description='anndata after feature selection', suffix='.h5ad', otype='AnnData', size=4514546187, hash='3DjpkQ3uPn7ZpewbPan1yD', n_observations=14814, space_id=1, storage_id=1, run_id=9, created_by_id=5, created_at=2025-04-25 15:37:59 UTC)- Townes, F. W., Hicks, S. C., Aryee, M. J., & Irizarry, R. A. (2019). Feature selection and dimension reduction for single-cell term`RNA`-Seq based on a multinomial model. Genome Biology, 20(1), 295. 10.1186/s13059-019-1861-6
- Germain, P.-L., Sonrel, A., & Robinson, M. D. (2020). pipeComp, a general framework for the evaluation of computational pipelines, reveals performant single cell RNA-seq preprocessing tools. Genome Biology, 21(1), 227. 10.1186/s13059-020-02136-7