🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
介绍
B、T 细胞通过适应性免疫受体(Adaptive Immune Receptors, AIRs)识别靶标,氨基酸序列是决定结合特异性的重要基础。其中,VDJ 链的互补决定区 3(Complementarity-Determining Region 3, CDR3)在许多分析中提供了较强的信息,VJ 链及其他受体区域也有贡献。但其相对重要性随受体、抗原和研究设置而变,不能将单条 CDR3 的相似性等同于相同特异性 Springer et al., 2021。
确定细胞的抗原特异性(antigen specificity),有助于选择与研究问题相关的细胞并观察其状态。实验上,可用带有条形码(Barcode)的肽–主要组织相容性复合体多聚体(peptide–Major Histocompatibility Complex multimers, pMHC multimers)检测 T 细胞受体(T-Cell Receptors, TCRs),或用带标签的抗原检测 B 细胞受体(B-Cell Receptors, BCRs)。这会增加实验设计的复杂度和成本。计算方法可提供候选特异性注释,作为实验信息的补充。
本章介绍三类计算方法:
数据库查询:公共数据库汇集了既往研究中的受体序列及其靶标,可与单细胞数据进行匹配。
聚类(clustering)与距离:Glanville et al., 2017 等研究表明,部分序列相近的受体可具有共同特异性。基于这一线索,可用序列距离和无监督聚类寻找候选功能群体,但序列相近并不保证结合同一抗原。
表位(epitope)预测:机器学习模型根据 AIR 与靶标信息预测结合,可为单细胞中的受体提供候选表位;预测能力受训练数据和验证方式限制。
三类方法都受到参考数据的限制。公共数据库偏向研究较多的疾病和表位;原教程写作时,主要 TCR 数据库的已知结合记录集中于数百种表位,这不是当前数据库规模的实时统计。此外,许多记录只有单条 VJ 或 VDJ 链的 CDR3,缺少配对链、V/D/J 注释及其他 CDR 信息,因而难以唯一确定完整受体的特异性。
TCR 特异性分析
先以 TCR 为例。既往研究 Davis & Bjorkman, 1988Rudolph et al., 2006Glanville et al., 2017 表明,CDR3 尤其是 CDR3β 参与与 pMHC 的接触,这也符合其高度多样的序列特征。Springer et al., 2021 在特定序列分类任务中比较了不同输入信息的贡献,报告了以下排序;它描述的是该研究的模型和数据:
CDR3β > V/J 基因 > CDR3α > MHC > 细胞类型
这一排序可为查询、聚类和距离计算时选择输入信息提供参考,但不能直接当作所有任务的普遍规律;尤其不能因此忽略真实抗原识别中的 MHC 限制。
import warnings

warnings.filterwarnings(
    "ignore",
    ".*IProgress not found*",
)

import matplotlib.pyplot as plt
import pandas as pd
import scanpy as sc
import scirpy as ir
import seaborn as sb
读取前面预处理保存的数据,并选择 CV0902 和 AP6 两名参与者的细胞进行演示。
path_data = "data"
path_tcr = f"{path_data}/TCR_01_preprocessed.h5ad"
adata_tcr = sc.read(path_tcr)
# TODO final decision sampling: prosponed until remaining chapters are fixed
adata_tcr = adata_tcr[adata_tcr.obs["patient_id"].isin(["CV0902", "AP6"])].copy()数据库查询
先查找既往研究中带有抗原关联或特异性注释的 TCR。常见资源包括:
IEDB Fleri et al., 2017
VDJdb Shugay et al., 2018
McPAS-TCR Tickotsky et al., 2017
PIRD Zhang et al., 2020
immuneCode TM:SARS-CoV-2 相关 TCR 资源 Nolan et al., 2020
前四个资源涵盖多种疾病或免疫研究场景,immuneCode 聚焦严重急性呼吸综合征冠状病毒 2(Severe Acute Respiratory Syndrome Coronavirus 2, SARS-CoV-2)相关 TCR。不同资源的收录对象与证据类型并不相同:疾病关联不一定意味着已确定某个 TCR–肽结合对。应检查目标表位的覆盖、配对链信息及实验依据,必要时选择专题数据库或原始研究数据。
查询越严格,通常命中越少,但可减少部分偶然匹配;精确率(precision)与召回率(recall)的实际变化仍需验证。可要求哪些链和基因信息匹配,取决于克隆型(clonotype)定义和数据完整性。下面以 VDJdb 演示不同约束;原教程选择它是因为当时包含较丰富的 SARS-CoV-2 表位记录,并不构成对当前数据库覆盖范围的排名。
Scirpy 可直接加载 VDJdb。本章旧版格式将受体、表位和实验信息展开保存在 vdjdb.obs 中;新版的受体链字段存储方式可能不同。
vdjdb = ir.datasets.vdjdb()
vdjdb.obs.head(5)VDJdb 还提供鉴定方法、抗原来源物种等注释。下面先筛选 SARS-CoV-2 记录,再查看所含表位和来源标签。
vdjdb[vdjdb.obs["antigen.species"] == "SARS-CoV-2"].obs[
    "antigen.epitope"
].value_counts()
YLQPRTFLL 1326
SPRWYFYYL 309
TTDPSFLGRY 254
RLQSLQTYV 150
LTDEMIAQY 135
...
LQAENVTGL 1
LPSYAAFAT 1
LPPVYTNSF 1
LPPANTNSF 1
YYTSNPTTF 1
Name: antigen.epitope, Length: 667, dtype: int64vdjdb[vdjdb.obs["antigen.species"] == "SARS-CoV-2"].obs[
"antigen.species"
].value_counts()SARS-CoV-2 4566
Name: antigen.species, dtype: int64原教程中,SARS-CoV-2 相关记录有较大一部分对应肽 YLQPRTFLL。注意,第二段代码已先筛选 antigen.species="SARS-CoV-2",因此它不能展示整个数据库的疾病或抗原物种分布。
手动查询
Scirpy、scRepertoire 等工具已提供受体数据集之间的匹配功能,通常可将数据库整理为相应格式后直接调用。若工具没有所需接口,或需要加入 MHC 类型等额外约束,也可以自行查询。下面先实现一个简单示例。
先保留 VDJdb 中 CDR3β 与查询数据完全相同的记录,缩小后续检索范围。
print(f"Amount of samples in VDJDB: {len(vdjdb)}")
vdjdb_overlap = vdjdb[
    vdjdb.obs["IR_VDJ_1_junction_aa"].isin(adata_tcr.obs["IR_VDJ_1_junction_aa"])
].obs
vdjdb_overlap = vdjdb_overlap[["IR_VDJ_1_junction_aa", "antigen.species"]]
print(f"Amount of overlapping samples in VDJDB: {len(vdjdb_overlap)}")
Amount of samples in VDJDB: 60055
Amount of overlapping samples in VDJDB: 7761
再为查询数据中的每个细胞添加 has_vdjdb_overlap 布尔标签,标记其 CDR3β 是否在数据库中出现;后续只处理有匹配的细胞。
adata_tcr.obs["has_vdjdb_overlap"] = adata_tcr.obs["IR_VDJ_1_junction_aa"].isin(
    vdjdb_overlap["IR_VDJ_1_junction_aa"]
)
adata_tcr.obs["has_vdjdb_overlap"].value_counts()
False 11522
True 1293
Name: has_vdjdb_overlap, dtype: int64下面的函数查找具有相同 CDR3β 的数据库记录,并汇总 antigen.species。若对应多个来源标签,返回 ambiguous;没有记录时返回 no entry;否则返回唯一标签。这里实际注释的是抗原来源物种,并非患者的疾病诊断;如需进一步限制 MHC 等条件,应显式加入查询。
def assign_disease(cdr3beta):
    matching_rows = vdjdb_overlap[vdjdb_overlap["IR_VDJ_1_junction_aa"] == cdr3beta]
    diseases = matching_rows["antigen.species"].values.tolist()
    diseases = list(set(diseases))
    if len(diseases) > 1:
        return "ambiguous"
    if len(diseases) == 0:
        return "no entry"
    return diseases[0]
将函数应用于存在序列重叠的细胞,得到来自数据库的候选抗原来源注释。未进入查询子集的细胞仍为缺失值。
adata_tcr.obs["antigen.species_manual"] = (
    adata_tcr[adata_tcr.obs["has_vdjdb_overlap"]]
    .obs["IR_VDJ_1_junction_aa"]
    .apply(assign_disease)
)
adata_tcr.obs["antigen.species_manual"].value_counts()
CMV 601
EBV 83
HIV-1 70
ambiguous 55
SARS-CoV-2 12
HomoSapiens 8
InfluenzaA 7
HCV 4
TriticumAestivum 1
YFV 1
DENV2 1
MCMV 1
SIV 1
Name: antigen.species_manual, dtype: int64本例可得到巨细胞病毒(Cytomegalovirus, CMV)、EB 病毒(Epstein–Barr Virus, EBV)及 HIV-1 等来源的匹配。结果受数据库收录偏差、注释错误、单链信息不完整、交叉反应及 MHC 限制影响,不能据此诊断参与者存在 CMV/EBV 潜伏感染或 HIV 感染。它们只是后续验证的候选线索;原文还注明,选择不同供体后需要重新解读这些结果。
使用不同严格程度查询
也可以使用 Scirpy 完成匹配。ir_dist 先分别计算查询集与 VDJdb 之间 VJ、VDJ 序列的关系,按唯一链序列保存稀疏矩阵(sparse matrix),而不是直接生成完整的细胞×细胞矩阵。采用 identity 时,精确匹配编码为 1,其他位置为 0;这是距离加一的存储约定,不是结合概率。
距离计算使用以下参数:
metric=‘identity’:只考虑完全相同的序列,稍后再介绍相似序列查询。
sequence=‘aa’:比较氨基酸序列;蛋白序列与结合功能相关,VDJdb 也提供这类信息。
metric = "identity"
sequence = "aa"
ir.pp.ir_dist(adata_tcr, vdjdb, metric=metric, sequence=sequence)
随后根据链匹配条件,将序列关系映射到查询细胞与参考记录:
metric=‘identity’,sequence=‘aa’:必须与前一步距离计算的设置相同。
receptor_arms=‘VDJ’:在这里的 αβ TCR 中比较 CDR3β;VJ 对应 α 链,all 要求两类链均匹配,any 允许其中一类匹配。
dual_ir=‘primary_only’:只使用选出的主链。具有额外受体链的细胞还可选择 any 或 all,分别按任一链组合或全部所需链组合进行匹配。
ir.tl.ir_query(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    receptor_arms="VDJ",
    dual_ir="primary_only",
)
100%|█████████████████████████████████████| 6191/6191 [00:04<00:00, 1292.12it/s]
最后将匹配参考记录中的指定字段转移到查询细胞的注释中。
metric=‘identity’,sequence=‘aa’:沿用前面的序列类型与距离设置。
include_ref_cols:指定需要转移的参考字段,这里为抗原来源物种和表位序列。
suffix:为新注释列指定后缀,以区分多次查询;第一次调用使用默认后缀,后面的查询再显式设置。
ir.tl.ir_query_annotate(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["antigen.species", "antigen.epitope"],
)
adata_tcr.obs["antigen.species"].value_counts()
100%|█████████████████████████████████████| 1690/1690 [00:00<00:00, 5387.03it/s]
CMV                 601
EBV                  83
HIV-1                70
ambiguous            55
SARS-CoV-2           12
HomoSapiens           8
InfluenzaA            7
HCV                   4
TriticumAestivum      1
YFV                   1
DENV2                 1
MCMV                  1
SIV                   1
Name: antigen.species, dtype: int64
本例结果与前面的手动查询对应,但所需自定义代码更少。Scirpy 还提供距离度量,可进一步查询相似序列。
接着只比较 α 链,并用 _VJ 后缀保存注释。前面计算的链序列距离可以复用,但仍需以 receptor_arms="VJ" 重新调用 ir_query,再调用 ir_query_annotate。
ir.tl.ir_query(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    receptor_arms="VJ",
    dual_ir="primary_only",
)
ir.tl.ir_query_annotate(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["antigen.species", "antigen.epitope"],
    suffix="_VJ",
)
adata_tcr.obs["antigen.species_VJ"].value_counts()
输出
100%|█████████████████████████████████████| 5209/5209 [00:03<00:00, 1536.95it/s]
100%|█████████████████████████████████████| 4064/4064 [00:00<00:00, 5683.50it/s]
ambiguous       927
CMV             466
InfluenzaA      349
MCMV            143
SARS-CoV-2       55
EBV              43
HomoSapiens      27
HCV              11
HIV-1             6
YFV               3
HSV-2             1
Homo sapiens      1
Name: antigen.species_VJ, dtype: int64
本例只查询 α 链时命中较多,也出现更多 ambiguous 注释。单链序列的多样性及数据库组成会影响这一现象。CMV 相关记录仍较多、HIV 相关记录较少,均不能单独证实或排除感染,也不能当作感染概率的定量更新。
最后要求 α、β 两类主链的 CDR3 均完全匹配:
ir.tl.ir_query(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    receptor_arms="all",
    dual_ir="primary_only",
)
ir.tl.ir_query_annotate(
    adata_tcr,
    vdjdb,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["antigen.species", "antigen.epitope"],
    suffix="_fullIR",
)
adata_tcr.obs["antigen.species_fullIR"].value_counts()
输出
100%|██████████████████████████████████████| 6722/6722 [00:07<00:00, 850.87it/s]
100%|███████████████████████████████████████| 328/328 [00:00<00:00, 5088.80it/s]
CMV            87
InfluenzaA     26
EBV            21
ambiguous      16
HomoSapiens     5
HIV-1           4
YFV             3
SIV             1
SARS-CoV-2      1
Name: antigen.species_fullIR, dtype: int64
增加链配对约束后,匹配数量减少。更完整的序列证据通常可减少歧义,但仍不能保证每条注释都正确,也不等于比较了整个受体序列。
序列距离
计算 TCR 的成对序列距离,可寻找具有潜在共同特异性的细胞群,也可放宽数据库查询以获得更多候选命中。常见方法分为三类:
编辑距离(edit distance):计算通过指定编辑操作将一个序列变为另一个序列所需的代价。
k-mer 匹配:比较两个序列中长度为 k 的短片段。
嵌入(Embedding):将序列表示为数值向量,例如通过深度学习(deep learning, DL)获得,再比较这些表示。
原教程写作时,这些方法的独立统一基准仍有限,因此这里只选择 TCRdist 和 TCRmatch 演示,不作通用性能排名。
TCRdist:综合多个受体环区的序列,通过氨基酸替换代价和缺口罚分计算距离 Dash et al., 2017。替换代价与 BLOSUM(BLOcks SUbstitution Matrix)矩阵有关;BLOSUM 给出的是替换的对数优势评分,而非直接的替换概率 Henikoff & Henikoff, 1992。纳入更多受体信息可能改善区分,但效果依赖任务,也会增加输入信息要求。
TCRmatch:基于 CDR3β 中不同长度片段的相似性计算受体间的相似度 Chronister et al., 2021。它只要求 CDR3β,适合仅有 β 链信息的记录,也被整合到 IEDB 中。
这些度量以受体序列为输入,相同输入的重复细胞会产生重复计算。因此可先提取受体信息并适当去重,再计算距离。
TCRdist
from tcrdist.repertoire import TCRrep本例联合分析 α、β 链,需要两条链的 CDR3 和 V 基因信息;TCRdist 也支持按所选链配置进行分析。下面按配对状态和 V 基因缺失情况取子集,再把提取的列转为字符串并去重。注意,示例中的 "No IR" 与 Scirpy 常用标签 "no IR" 大小写不同;且去重还包含参与者、细胞类型等元数据,因此不保证每种受体序列只剩一行。
adata_tcrdist = adata_tcr[
    ~adata_tcr.obs["chain_pairing"].isin(["No IR", "orphan VDJ", "orphan VJ"])
]

for col in ["IR_VJ_1_v_call", "IR_VDJ_1_v_call"]:
    adata_tcrdist = adata_tcrdist[~adata_tcrdist.obs[col].isna()]
adata_tcrdist = adata_tcrdist.copy()


df_tcrdist = adata_tcrdist.obs[
    [
        "IR_VJ_1_junction_aa",
        "IR_VJ_1_v_call",
        "IR_VJ_1_j_call",
        "IR_VDJ_1_junction_aa",
        "IR_VDJ_1_v_call",
        "IR_VDJ_1_j_call",
        "chain_pairing",
        "patient_id",
        "antigen.species",
        "initial_clustering",
    ]
].copy()

for col in df_tcrdist.columns:
    df_tcrdist[col] = df_tcrdist[col].astype(str)
df_tcrdist = df_tcrdist.drop_duplicates()
df_tcrdist = df_tcrdist.reset_index(drop=True)
将字段重命名为 TCRdist 所需格式。工具使用 V 基因等位基因(allele)注释,而本例只有基因名,因此代码统一附加 *01。这是缺少等位基因信息时的假设,不是对真实基因型的测定,可能影响从参考推定的环区序列。另将原行索引保存为一列,以便在 TCRrep 内部重排记录后恢复对应关系。
dict_rename_tcrdist = {
    "IR_VJ_1_junction_aa": "cdr3_a_aa",
    "IR_VJ_1_v_call": "v_a_gene",
    "IR_VDJ_1_junction_aa": "cdr3_b_aa",
    "IR_VDJ_1_v_call": "v_b_gene",
}

df_tcrdist = df_tcrdist.rename(columns=dict_rename_tcrdist)

df_tcrdist["v_a_gene"] = df_tcrdist["v_a_gene"].astype(str) + "*01"
df_tcrdist["v_b_gene"] = df_tcrdist["v_b_gene"].astype(str) + "*01"

df_tcrdist["count"] = 1  # todo

df_tcrdist["index"] = df_tcrdist.index

df_tcrdist.head(5)创建 TCRrep 对象,指定物种为 human,分析链为 alpha 和 beta;对象随后保存相应的成对距离。
tr = TCRrep(cell_df=df_tcrdist, organism="human", chains=["alpha", "beta"])输出
/home/icb/felix.drost/miniconda/envs/bestPractice/lib/python3.8/site-packages/tcrdist/repertoire.py:159: UserWarning: cell_df needs a counts column to track clonal number of frequency

  self._validate_cell_df()
/home/icb/felix.drost/miniconda/envs/bestPractice/lib/python3.8/site-packages/tcrdist/repertoire.py:791: UserWarning: No 'count' column provided; count column set to 1
  warnings.warn("No 'count' column provided; count column set to 1")
分别取得 α、β 链距离,将两者相加得到总距离,并用保存的原始索引标记矩阵的行列。
dist_total = tr.pw_alpha + tr.pw_beta
columns = tr.clone_df["index"].astype(float).astype(int)
df_dist = pd.DataFrame(dist_total, columns=columns, index=columns)
将总距离绘制为热图,并用平均连接法(average linkage)做层次聚类(hierarchical clustering),使距离较小的受体排列在一起。
import scipy.cluster.hierarchy as hc
import scipy.spatial as sp
from matplotlib import rcParams

rcParams["figure.figsize"] = (20, 20)

linkage = hc.linkage(sp.distance.squareform(df_dist), method="average")
plot = sb.clustermap(
    df_dist,
    row_linkage=linkage,
    col_linkage=linkage,
    figsize=(40, 40),
    yticklabels=False,
    xticklabels=False,
)
plot.ax_row_dendrogram.set_visible(False)
plot.ax_col_dendrogram.set_visible(False)

plot.fig.suptitle("TCRdist")
plt.tight_layout()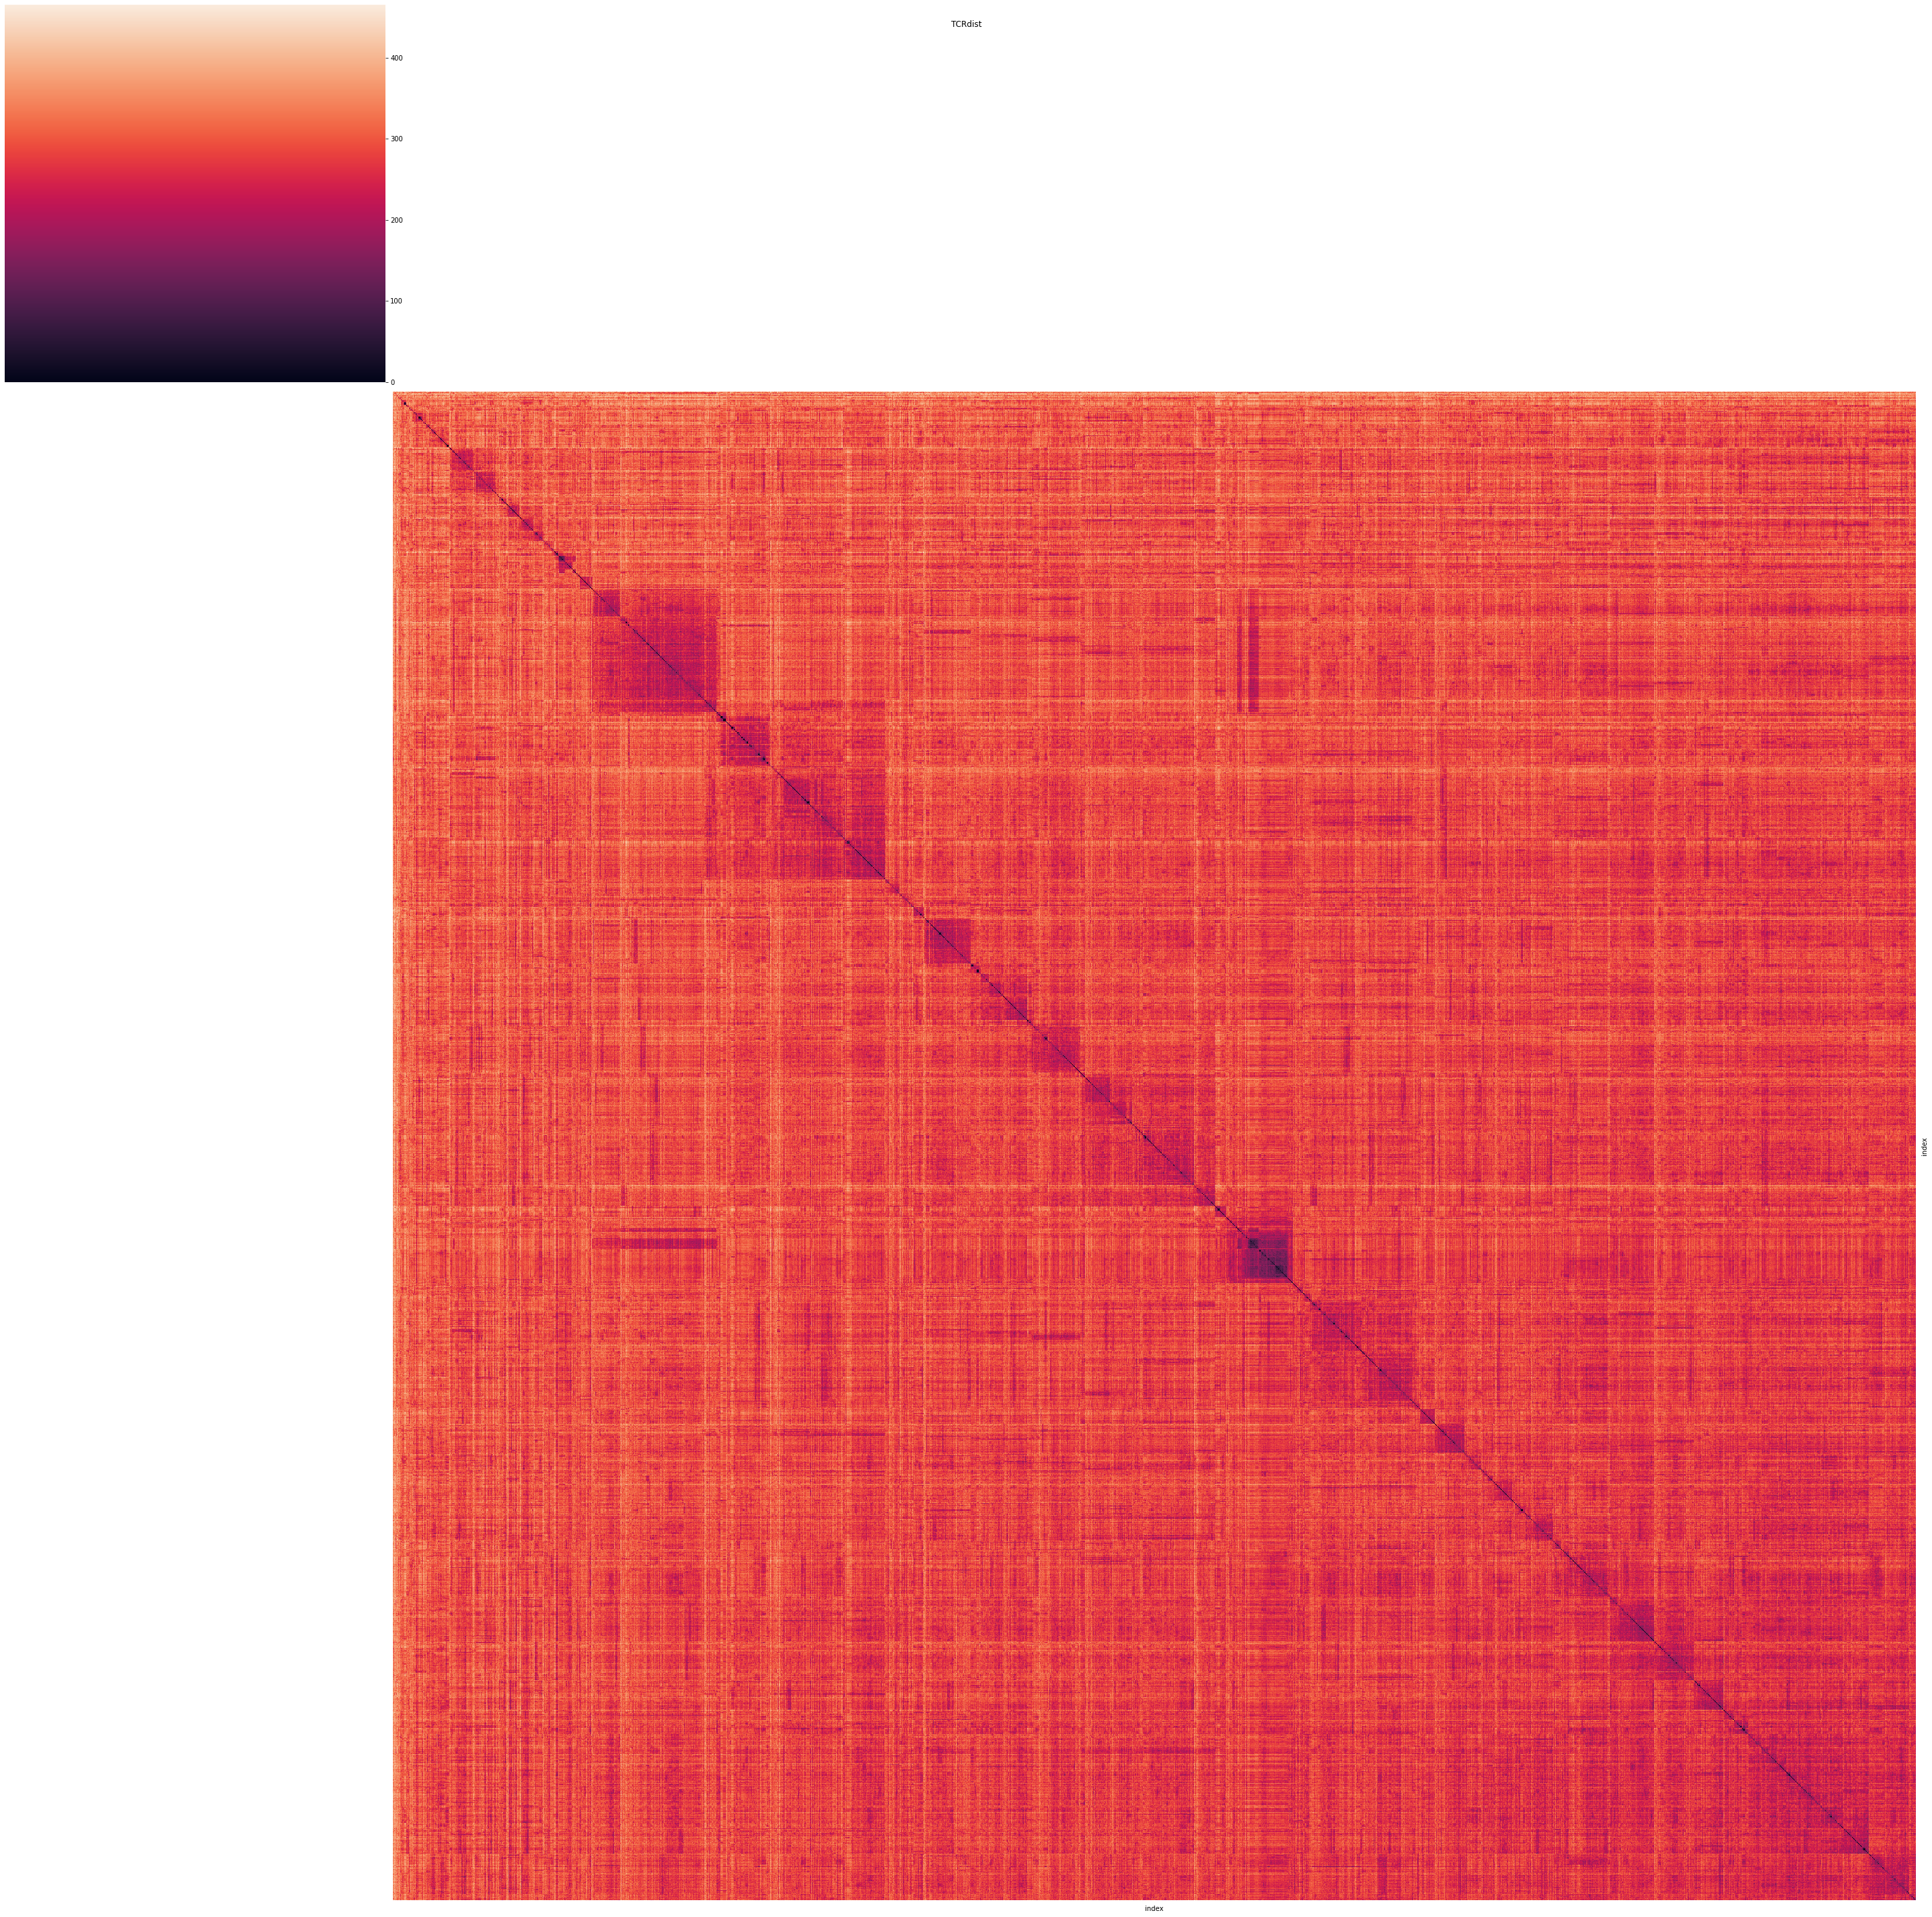
热图中的相近序列群可作为候选功能群体,但不能仅凭聚类认定其表位特异性相同。下面回到 Scirpy,使用 α、β 链的距离构建并显示克隆型簇。
df_tcrdist_alpha = pd.DataFrame(
    tr.pw_alpha, columns=tr.clone_df["cdr3_a_aa"], index=tr.clone_df["cdr3_a_aa"]
)
df_tcrdist_beta = pd.DataFrame(
    tr.pw_beta, columns=tr.clone_df["cdr3_b_aa"], index=tr.clone_df["cdr3_b_aa"]
)
下面将距离名称、序列和距离矩阵写入 adata.uns,以衔接 Scirpy 的旧版接口。函数将原距离大于 cutoff 的条目置为稀疏矩阵中的 0,其余值加 1,因此完全相同的序列编码为 1,原距离恰等于阈值也保留。本例对每条链使用 60;这不同于只要求 α、β 总距离不超过 120。后续还应核对以 CDR3 作索引时是否存在重复键。
from scipy.sparse import csr_matrix


def add_dists(adata, df_dist_alpha, df_dist_beta, name, cutoff):
    adata.uns[f"ir_dist_aa_{name}"] = {
        "params": {"metric": f"{name}", "sequence": "aa", "cutoff": cutoff}
    }

    for chain, dists in [("VJ", df_dist_alpha), ("VDJ", df_dist_beta)]:
        if dists is None:
            continue
        dist_values = dists.values + 1
        dist_values[dist_values > (cutoff + 1)] = 0
        dist_values = csr_matrix(dist_values)
        adata.uns[f"ir_dist_aa_{name}"][chain] = {
            "seqs": dists.index.tolist(),
            "distances": dist_values,
        }


add_dists(adata_tcrdist, df_tcrdist_alpha, df_tcrdist_beta, "tcrdist", 60)
根据这些链距离定义克隆型簇,使用氨基酸序列、两类链均匹配及仅主链的设置。
ir.tl.define_clonotype_clusters(
    adata_tcrdist,
    sequence="aa",
    metric="tcrdist",
    receptor_arms="all",
    dual_ir="primary_only",
)
100%|██████████████████████████████████████| 5325/5325 [00:12<00:00, 432.66it/s]
随后构建并绘制网络。本例只显示至少 3 个细胞且至少 3 个节点的连通分组,对应 min_cells=3 和 min_nodes=3。
adata_tcrdist.obs["antigen.species"] = adata_tcrdist.obs["antigen.species"].astype(str)

ir.tl.clonotype_network(
    adata_tcrdist, min_cells=3, min_nodes=3, sequence="aa", metric="tcrdist"
)
ir.pl.clonotype_network(
    adata_tcrdist,
    color="antigen.species",
    label_fontsize=9,
    panel_size=(14, 7),
    base_size=10,
    size_power=0.75,
)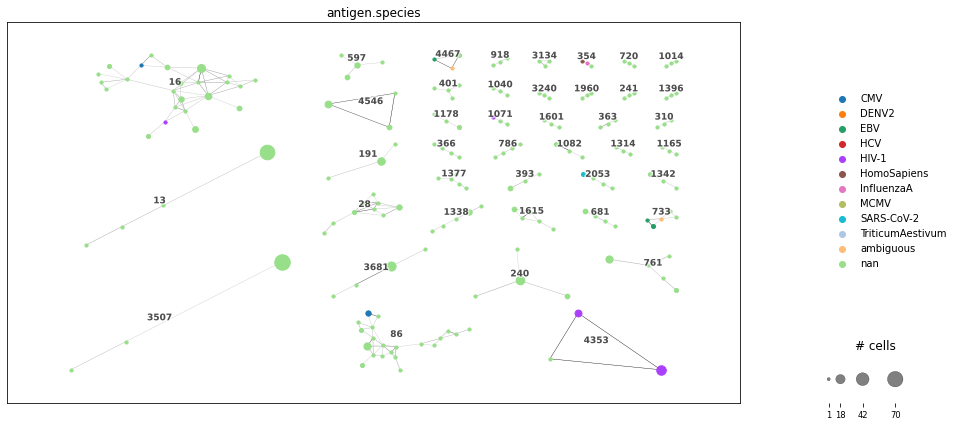
网络节点代表共享受体配置的细胞,点大小随细胞数变化,颜色来自前面数据库查询的候选抗原来源注释。同一连通分组中的受体由距离阈值连接;传递连接不保证任意两点都足够接近,更不能确证相同特异性。可进一步结合转录组开展差异表达分析,或检查富集基序和保守残基。
TCRmatch
TCRmatch 仅需要 CDR3β,因而可利用许多没有配对 α 链信息的数据。下面排除缺少 CDR3β 的记录并尝试排除疑似双细胞(Doublet)。原代码中的 "No IR"、"multi_chain" 与常用分类值 "no IR"、"multichain" 不同,应先核对实际标签。提取后按序列和 antigen.species 一起去重,并非严格的仅序列去重。
adata_tcrmatch = adata_tcr[
    ~adata_tcr.obs["chain_pairing"].isin(["No IR", "orphan VJ", "multi_chain"])
]
adata_tcrmatch = adata_tcrmatch[
    ~adata_tcrmatch.obs["IR_VDJ_1_junction_aa"].isna()
].copy()

df_tcrmatch = adata_tcrmatch.obs[["IR_VDJ_1_junction_aa", "antigen.species"]].copy()
df_tcrmatch = df_tcrmatch.drop_duplicates()
df_tcrmatch = df_tcrmatch.reset_index(drop=True)
len(df_tcrmatch)6190本例 TCRmatch 输入要求 CDR3β 去掉 Cell Ranger 连接区序列开头的 C 和末尾的 F 或 W。下面用切片去掉首尾字符;运行前应确认输入确实采用这一边界定义,否则会误删有效残基。
df_tcrmatch["CDR3b_trimmed"] = df_tcrmatch["IR_VDJ_1_junction_aa"].str[1:-1]
df_tcrmatch[["CDR3b_trimmed"]].to_csv(
    "tmp/tcrmatch_input.csv", header=False, index=False
)
df_tcrmatch[["CDR3b_trimmed"]].to_csv(
    "tmp/tcrmatch_input.csv", header=False, index=False
)
df_tcrmatch.head(5)通过命令行调用 TCRmatch,主要参数如下:
-i:查询序列文件。
-t:计算线程数。
-d:参考序列文件;可以是数据库,也可以使用查询文件本身来计算成对相似度。-s:相似度筛选阈值,分数越接近 1 表示越相似。本例先使用 0.9,也可选择更严格的 0.97。这些阈值不是 90% 或 97% 的结合概率,所谓置信度依赖原方法的评估条件。较宽松阈值通常会保留更多候选结果。
cmd_tcrmatch = "cd TCRMatch/ &&"
cmd_tcrmatch += "./tcrmatch -i ../tmp/tcrmatch_input.csv -t 1 -d ../tmp/tcrmatch_input.csv -s 0.9 > ../tmp/tcrmatch_output.csv"
通过 notebook 的 shell 调用运行该命令:
!$cmd_tcrmatchTCRmatch 输出达到相似度阈值的序列对及分数,每行是一对 input_sequence、match_sequence。下面先转为行列均为序列的宽表,再平均两个方向的分数并计算 1−相似度,转换为越小越相近的距离;缺失项填为 1,表示没有保留的相似匹配。这里处理的是 TCRmatch 相似度,不是 TCRdist。转置求平均前应保证行列的序列及顺序一致。
dist_tcrmatch = pd.read_csv("tmp/tcrmatch_output.csv", sep="\t")
dist_tcrmatch = dist_tcrmatch[["input_sequence", "match_sequence", "score"]]
dist_tcrmatch = dist_tcrmatch.pivot("input_sequence", "match_sequence", "score")
values = 1 - (dist_tcrmatch.values + dist_tcrmatch.values.transpose()) / 2

trimmed_2_full = dict(df_tcrmatch[["CDR3b_trimmed", "IR_VDJ_1_junction_aa"]].values)
columns = dist_tcrmatch.index.map(trimmed_2_full)
dist_tcrmatch = pd.DataFrame(index=columns, columns=columns, data=values)
dist_tcrmatch = dist_tcrmatch.fillna(1)
dist_tcrmatch.index.name = None
dist_tcrmatch.head(5)用热图展示转换后的距离。大量序列对未达到最初的相似度筛选阈值,在这个矩阵中会显示为填入的距离 1,而不是较小的距离。
linkage = hc.linkage(sp.distance.squareform(dist_tcrmatch), method="average")
plot = sb.clustermap(
    dist_tcrmatch,
    row_linkage=linkage,
    col_linkage=linkage,
    figsize=(40, 40),
    yticklabels=False,
    xticklabels=False,
)
plot.ax_row_dendrogram.set_visible(False)
plot.ax_col_dendrogram.set_visible(False)
plot.fig.suptitle("TCRmatch")
plt.tight_layout()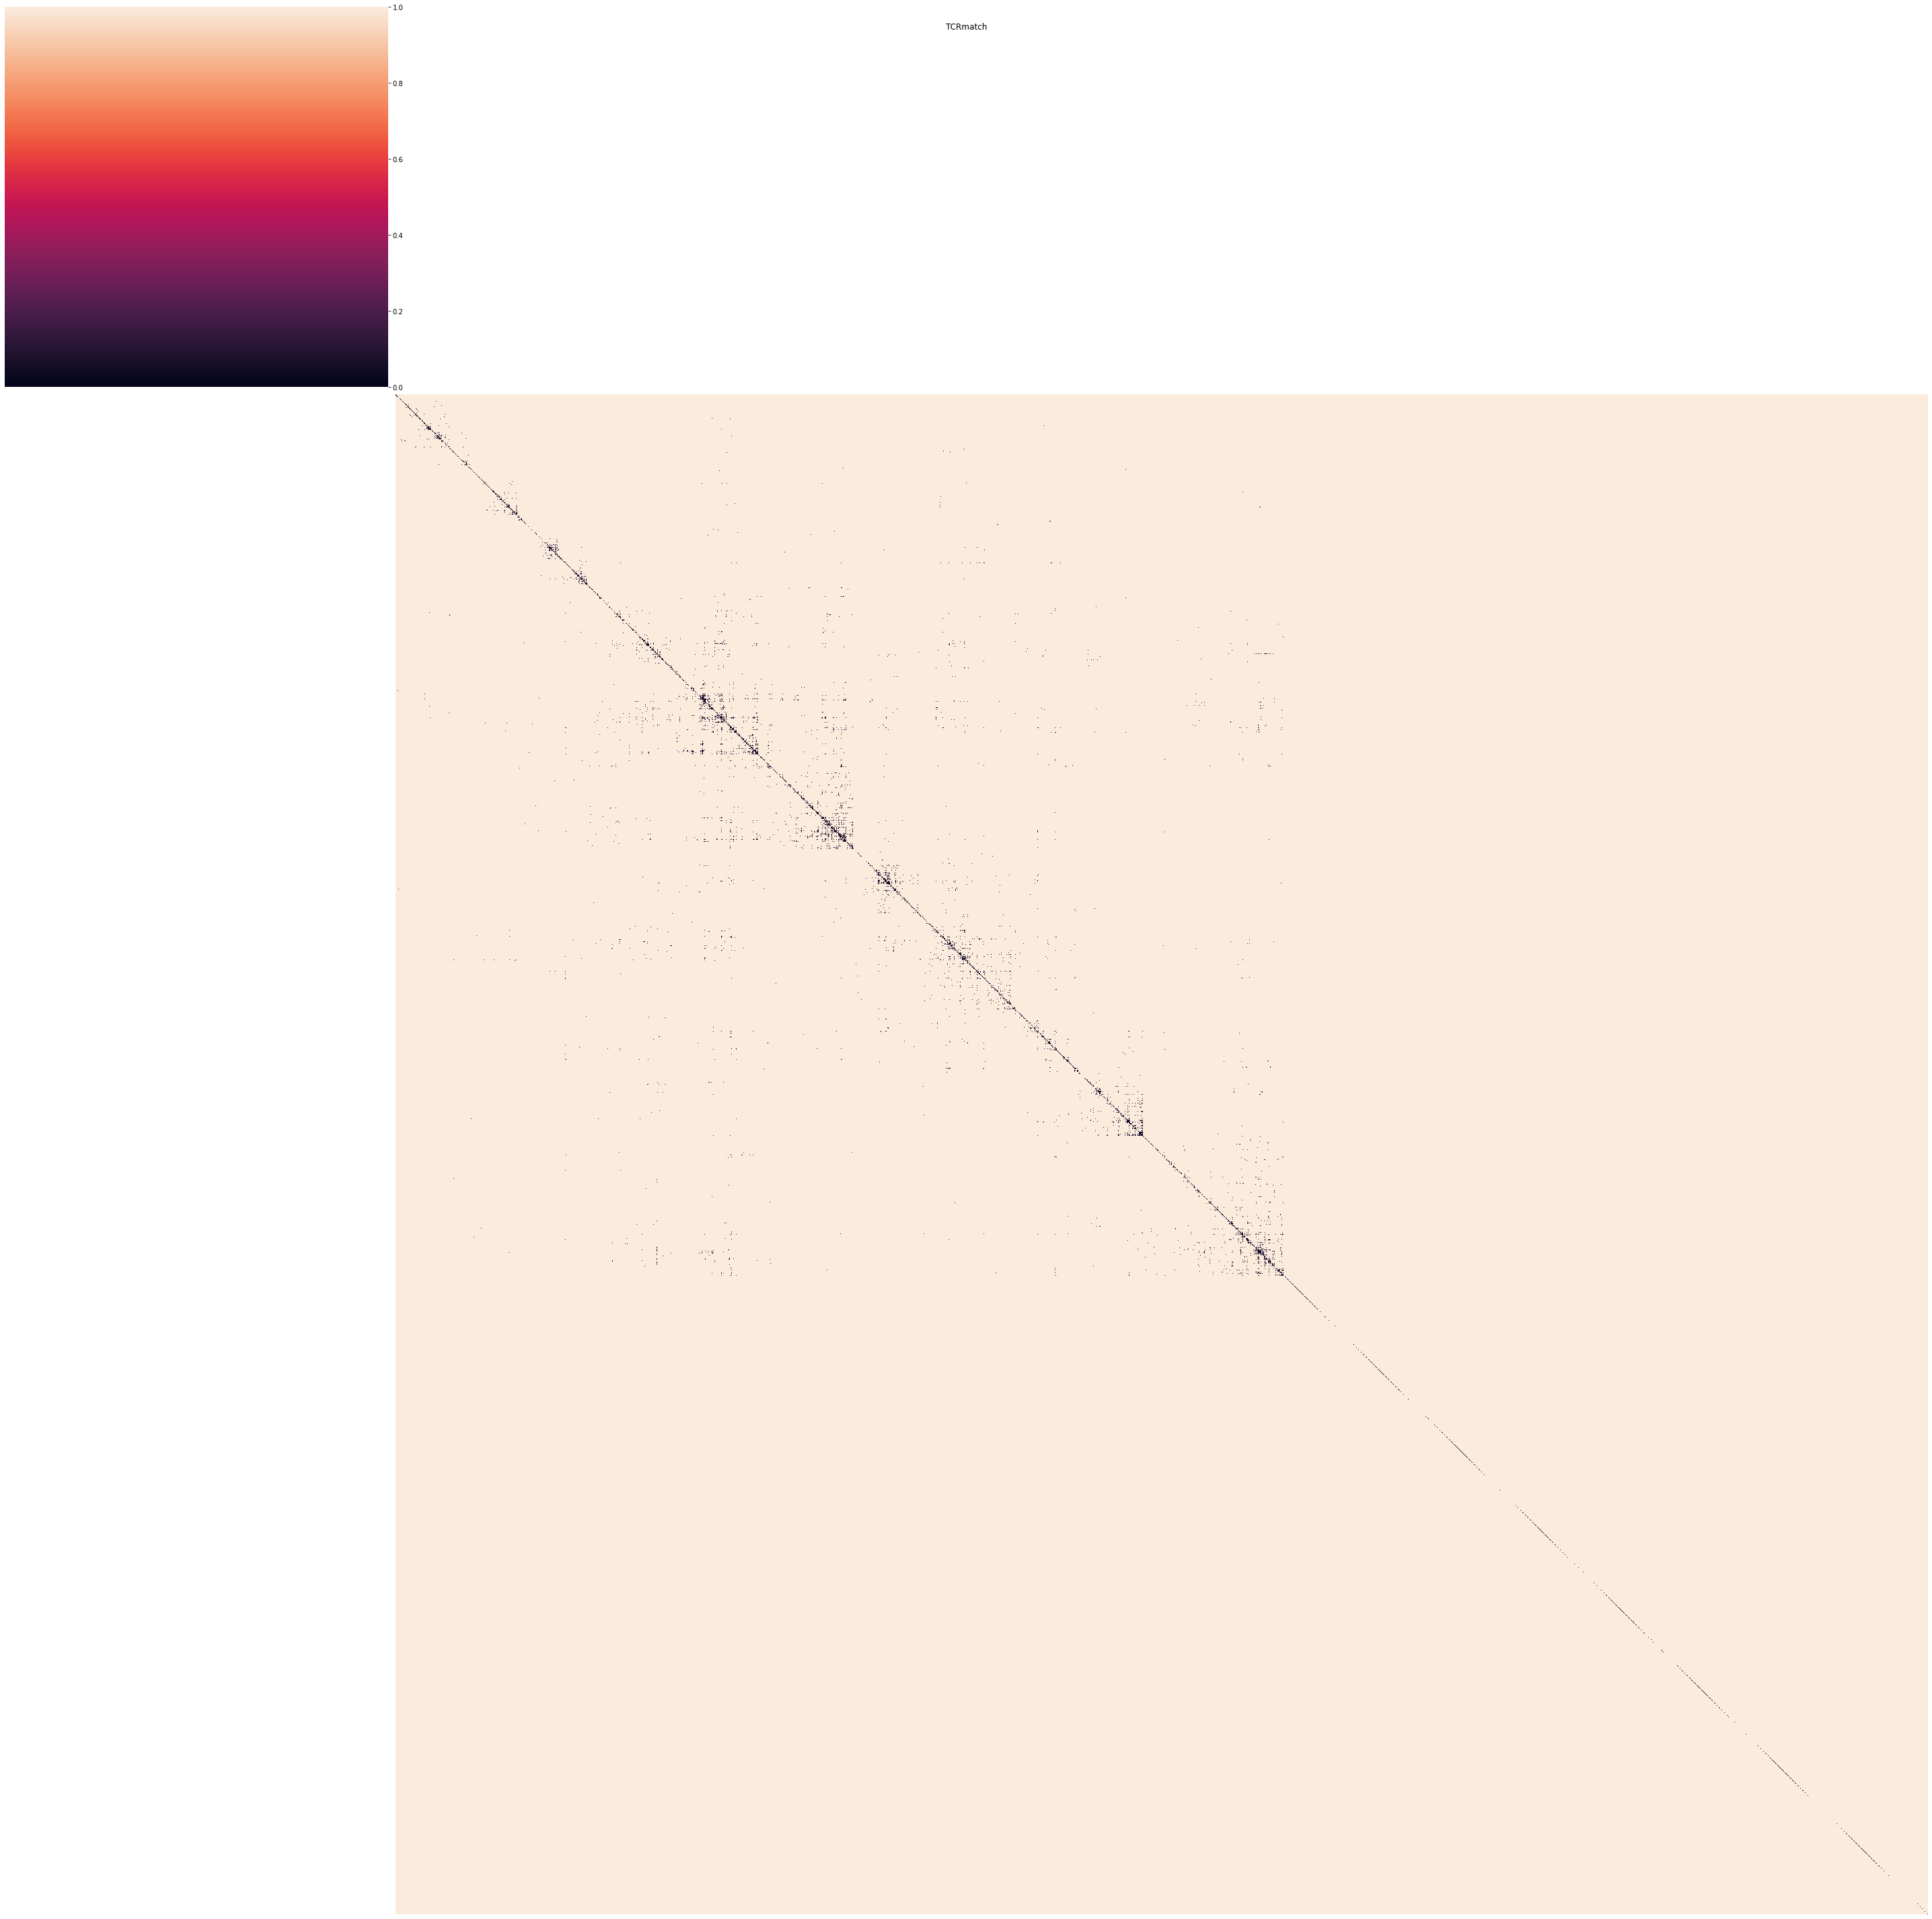
再用前面定义的 add_dists 将距离加入 AnnData,构建网络。此处 cutoff=0.05 相当于进一步要求相似度至少为 0.95,比最初输出文件使用的 0.9 更严格。
add_dists(adata_tcrmatch, None, dist_tcrmatch, "tcrmatch", 0.05)ir.tl.define_clonotype_clusters(
adata_tcrmatch,
sequence="aa",
metric="tcrmatch",
receptor_arms="VDJ",
dual_ir="primary_only",
)
ir.tl.clonotype_network(
adata_tcrmatch, min_cells=1, min_nodes=3, sequence="aa", metric="tcrmatch"
)
adata_tcrmatch.obs["antigen.species"] = adata_tcrmatch.obs["antigen.species"].astype(
str
)
ir.pl.clonotype_network(
adata_tcrmatch,
color="antigen.species",
label_fontsize=9,
panel_size=(14, 7),
base_size=20,
size_power=0.5,
)100%|█████████████████████████████████████| 6190/6190 [00:02<00:00, 2370.78it/s]
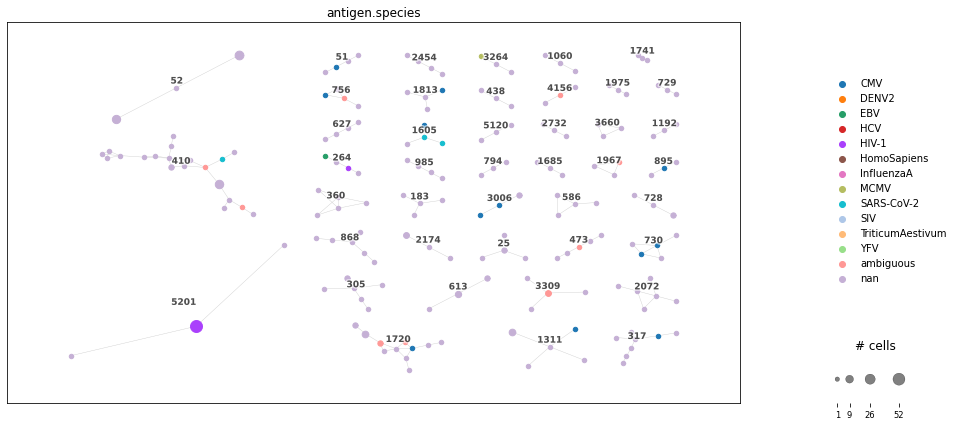
得到的网络以 CDR3β 信息为基础:相同序列可汇为节点,相似序列按阈值连接成克隆型簇。这里的簇并非全部由完全相同的 CDR3β 构成,也不能直接等同于同一抗原特异性群体。只需 β 链使它能覆盖更多细胞和数据库记录。
通过距离度量查询数据库
用序列距离匹配相似受体,可以增加候选注释,也可能增加假阳性。下面使用 Scirpy 的 alignment 距离,它根据 CDR3 序列比对计算差异,与包含更多环区信息的完整 TCRdist 配置并不等价。
为控制计算量,下面只选择 AP6 这一名参与者的细胞;这是按参与者取子集。
adata_tcr_align = adata_tcr[adata_tcr.obs["patient_id"] == "AP6"].copy()使用 alignment 度量,设置距离阈值为 10,再按前面的流程进行两类链匹配与注释。
metric = "alignment"
sequence = "aa"
ir.pp.ir_dist(adata_tcr_align, vdjdb, metric=metric, sequence=sequence, cutoff=10)
100%|███████████████████████████████████████| 9468/9468 [02:46<00:00, 57.00it/s]
100%|█████████████████████████████████████| 13702/13702 [04:08<00:00, 55.13it/s]
ir.tl.ir_query(
    adata_tcr_align,
    vdjdb,
    metric=metric,
    sequence=sequence,
    receptor_arms="all",
    dual_ir="primary_only",
)
100%|██████████████████████████████████████| 1012/1012 [00:01<00:00, 714.86it/s]
ir.tl.ir_query_annotate(
    adata_tcr_align,
    vdjdb,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["antigen.species", "antigen.epitope"],
    suffix="_alignment",
)
adata_tcr_align.obs["antigen.species_alignment"].value_counts()
100%|█████████████████████████████████████| 2202/2202 [00:00<00:00, 5430.96it/s]
CMV            840
ambiguous      182
HIV-1           30
EBV             20
InfluenzaA      18
SARS-CoV-2       6
HomoSapiens      4
HCV              1
Name: antigen.species_alignment, dtype: int64
本例放宽到相似序列后命中增多,同时 ambiguous 注释也增加。比较时应使用相同的细胞子集,避免把供体选择差异当作方法效果。
表位预测
另一类方法直接用机器学习模型预测 TCR 与候选表位的结合,而非只查找相似参考受体。模型通常以已知 TCR–表位数据训练,因此也继承了热门表位过度代表等偏差;缺乏某表位的参考数据时,不能假定预测就能可靠弥补这一缺口。常见模型有两类:
类别模型:将表位作为固定类别,根据 TCR 序列预测其与训练所覆盖表位的关联。
表位序列模型:同时输入 TCR 和表位序列。形式上可以提交未见过的表位,但对训练外表位的泛化性能可能显著下降。
使用前应检查训练集是否覆盖目标表位,以及测试集是否与训练集独立,避免序列重叠造成性能高估。预测结果需要针对具体应用验证。原作者期待后续方法改进能够提高特异性预测质量,这一展望不等于现有模型已在所有任务上可靠。
本例选择 ERGO-II Springer et al., 2021,主要因为它能灵活使用不同受体信息,并容许部分字段缺失;这不是基于统一性能比较得出的最优方法推荐。
ERGO-II 至少需要 CDR3β;其他字段能否缺失取决于模型设置。下面先排除 orphan VJ、no IR 等记录,并尝试排除多链细胞。原代码使用 "multi_chains",而 Scirpy 常用分类值为 "multichain",因此该条件可能没有实际排除目标记录。运行前还应明确核对 CDR3β 是否缺失。
adata_ergo = adata_tcr[
    ~adata_tcr.obs["chain_pairing"].isin(["orphan VJ", "no IR", "multi_chains"])
]
df_ergo = adata_ergo.obs[
    [
        "IR_VJ_1_junction_aa",
        "IR_VJ_1_v_call",
        "IR_VJ_1_j_call",
        "IR_VDJ_1_junction_aa",
        "IR_VDJ_1_v_call",
        "IR_VDJ_1_j_call",
    ]
].copy()
将 Scirpy 字段重命名为 ERGO-II 要求的列名。
dict_rename = {
    "IR_VJ_1_junction_aa": "TRA",
    "IR_VJ_1_v_call": "TRAV",
    "IR_VJ_1_j_call": "TRAJ",
    "IR_VDJ_1_junction_aa": "TRB",
    "IR_VDJ_1_v_call": "TRBV",
    "IR_VDJ_1_j_call": "TRBJ",
}
df_ergo = df_ergo.rename(columns=dict_rename)
这里选择 CMV 来源的肽 KLGGALQAK 作为待测表位,承接前面的候选匹配,而不是因为已证实参与者感染。示例将 T-Cell-Type 和缺失的 MHC 信息设为 None;这表示模型输入缺失,不表示真实识别不受 MHC 或细胞背景影响。随后将输入保存为 CSV。
df_ergo["Peptide"] = "KLGGALQAK"  #'YLQPRTFLL'
df_ergo["T-Cell-Type"] = None
df_ergo["MHC"] = None

df_ergo.to_csv("tmp/ergo_input.csv")
通过命令行激活示例环境,指定以 vdjdb 训练的模型和输入文件。原作者为保存结果取消了 Predict.py 当时第 105 行的注释;代码位置可能随版本变化,应查看实际文件。原教程还提到安装与运行问题,可参阅该项目的 GitHub issues 和使用说明,或使用其文档介绍的网页界面。
cmd_ergo = "source ~/.bashrc &&"
cmd_ergo += "conda activate ergo &&"
cmd_ergo += "cd ERGO-II &&"
cmd_ergo += "python Predict.py vdjdb ../tmp/ergo_input.csv"
# cmd_ergo += 'cd ..'!$cmd_ergo/home/icb/felix.drost/miniconda/envs/ergo/lib/python3.8/site-packages/pytorch_lightning/core/decorators.py:13: UserWarning: data_loader decorator deprecated in 0.7.0. Will remove 0.9.0
warnings.warn(w)
cell_id TRA ... MHC Score
0 BGCV01_AAACCTGAGACCGGAT-1 NaN ... NaN 0.000002
1 BGCV01_AAACCTGAGGAACTGC-1 CAVKRGNNARLMF ... NaN 0.629516
2 BGCV01_AAACCTGAGGGATCTG-1 CAVGAPGDDKIIF ... NaN 0.635792
3 BGCV01_AAACCTGCAACGCACC-1 NaN ... NaN 0.000017
4 BGCV01_AAACCTGCACGTGAGA-1 CAVNSPGGYQKVTF ... NaN 0.625245
... ... ... ... .. ...
12362 S12_TTTGTCAGTAGAAAGG-1 CARNTGNQFYF ... NaN 0.614335
12363 S12_TTTGTCAGTCCAACTA-1 NaN ... NaN 0.000023
12364 S12_TTTGTCAGTGAGTGAC-1 CARNTGNQFYF ... NaN 0.614335
12365 S12_TTTGTCATCCACTCCA-1 CAVSELGSEKLVF ... NaN 0.685439
12366 S12_TTTGTCATCGCATGAT-1 CVVRAPWGSARQLTF ... NaN 0.673902
[12367 rows x 11 columns]
命令成功完成并写出结果后,读取输出文件。
df_tcr_ergo = pd.read_csv("ERGO-II/results.csv", index_col=0)
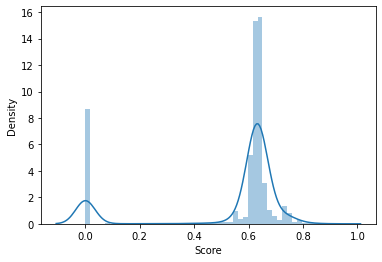
df_tcr_ergo.head()查看预测结合分数的分布,并统计 Score 至少为 0.9 的记录数。分数及阈值需要结合模型校准解释,不能直接视为实验验证的结合概率。
sb.distplot(df_tcr_ergo["Score"])/home/icb/felix.drost/miniconda/envs/bestPractice/lib/python3.8/site-packages/seaborn/distributions.py:2619: FutureWarning: `distplot` is a deprecated function and will be removed in a future version. Please adapt your code to use either `displot` (a figure-level function with similar flexibility) or `histplot` (an axes-level function for histograms).
warnings.warn(msg, FutureWarning)
import numpy as np

np.sum(df_tcr_ergo["Score"] >= 0.9)1原文待办:确定最终使用的供体后,补充结果解读。
BCR 特异性分析
BCR 的特异性推断也可使用数据库、序列比较和预测模型。下面沿用相同结构,重点说明与 TCR 分析不同的部分。
path_data = "data"
path_bcr = f"{path_data}/BCR_01_preprocessed.h5ad"
adata_bcr = sc.read(path_bcr)
adata_bcr = adata_bcr[
adata_bcr.obs["patient_id"].isin(
["COVID-030", "IVLPS-6", "COVID-064", "COVID-014", "COVID-027", "COVID-024"]
)
].copy()数据库查询
可查找带有抗原结合或特异性注释的抗体/BCR 记录,常用资源包括:
IEDB Fleri et al., 2017
PIRD Zhang et al., 2020
CoV-AbDab:冠状病毒相关抗体资源 Raybould et al., 2021
应根据研究问题选择数据库。IEDB 和 PIRD 覆盖较广,CoV-AbDab 则聚焦冠状病毒相关抗体,包括 SARS-CoV-2 等,不能将其全部记录视为同一病毒或同一表位的阳性结合证据。
准备数据库
下面以 CoV-AbDab 演示如何整理参考数据并创建 AnnData。代码下载的是文件名标记为 200422 的历史快照:
!wget -O tmp/CoV-AbDab.csv http://opig.stats.ox.ac.uk/webapps/covabdab/static/downloads/CoV-AbDab_200422.csv输出
--2022-06-07 22:46:19--  http://opig.stats.ox.ac.uk/webapps/covabdab/static/downloads/CoV-AbDab_200422.csv
Resolving opig.stats.ox.ac.uk (opig.stats.ox.ac.uk)... 163.1.32.58
Connecting to opig.stats.ox.ac.uk (opig.stats.ox.ac.uk)|163.1.32.58|:80... connected.
HTTP request sent, awaiting response... 200 OK
Length: 3397624 (3.2M) [text/csv]
Saving to: ‘tmp/CoV-AbDab.csv’

100%[======================================>] 3,397,624   10.1MB/s   in 0.3s

2022-06-07 22:46:19 (10.1 MB/s) - ‘tmp/CoV-AbDab.csv’ saved [3397624/3397624]
读取数据库,保留 Ab or Nb 列为 Ab 的抗体记录,排除 Nb 类记录。
cov_abdab = pd.read_csv("tmp/CoV-AbDab.csv")
cov_abdab = cov_abdab[cov_abdab["Ab or Nb"] == "Ab"]
cov_abdab.head(5)将数据库列名映射为本章采用的旧版 Scirpy 字段。注意,原示例将 Light J Gene 写为 IR_VJ_1_h_call;与 J 基因对应的字段应为 IR_VJ_1_j_call。这里保留原代码,实际使用时需要核对这一拼写。
dict_rename_cov_abdab = {
    "Heavy V Gene": "IR_VDJ_1_v_call",
    "Heavy J Gene": "IR_VDJ_1_j_call",
    "Light V Gene": "IR_VJ_1_v_call",
    "Light J Gene": "IR_VJ_1_h_call",
    "CDRH3": "IR_VDJ_1_junction_aa",
    "CDRL3": "IR_VJ_1_junction_aa",
    "Binds to": "Binding",
}
cov_abdab = cov_abdab.rename(columns=dict_rename_cov_abdab)
按旧版 Scirpy 结构补充受体存在标记及第二组链的缺失值。这些常量用于数据表示,不是新的实验测量。
cov_abdab["has_ir"] = "True"
cov_abdab["IR_VJ_2_junction_aa"] = None
cov_abdab["IR_VDJ_2_junction_aa"] = None
为便于演示,下面将 Binding 文本中包含 SARS-CoV2 的记录标为 SARS-CoV-2,其余标为字符串 None。后者只表示未匹配这段标签文本,不等于已测试且证实不结合;数据库也不保证每条抗体都针对全部 SARS-CoV-2 表位做过实验。保留哪些结合标签应由研究问题决定。
cov_abdab["Binding"] = cov_abdab["Binding"].apply(
    lambda x: "SARS-CoV-2" if "SARS-CoV2" in x else "None"
)
不同数据源对 CDR3/连接区边界的定义可能不同。Cell Ranger 连接区常包含开头的 C 及末尾的 F 或 W,而数据库可能省略这些残基。本例给轻链补 C/F、重链补 C/W,以对齐所用快照的格式;不能不检查原序列就对任意数据库统一补字符,否则可能重复添加或造成错误匹配。
cov_abdab["IR_VJ_1_junction_aa"] = "C" + cov_abdab["IR_VJ_1_junction_aa"] + "F"
cov_abdab["IR_VDJ_1_junction_aa"] = "C" + cov_abdab["IR_VDJ_1_junction_aa"] + "W"
将整理后的受体和结合字段存入 AnnData.obs,并在 .uns["DB"]["name"] 中记录数据库名称,以便本章旧版查询接口使用。
cov_abdab = sc.AnnData(obs=cov_abdab)
cov_abdab.uns["DB"] = {}
cov_abdab.uns["DB"]["name"] = "CoV-AbDab"
/home/icb/felix.drost/miniconda/envs/bestPractice/lib/python3.8/site-packages/anndata/_core/anndata.py:121: ImplicitModificationWarning: Transforming to str index.
warnings.warn("Transforming to str index.", ImplicitModificationWarning)
精确匹配
先比较重链主链的 CDR3 氨基酸序列是否完全相同,而不是比较整条重链。
metric = "identity"
sequence = "aa"

ir.pp.ir_dist(adata_bcr, cov_abdab, metric=metric, sequence=sequence)
ir.tl.ir_query(
    adata_bcr,
    cov_abdab,
    metric=metric,
    sequence=sequence,
    receptor_arms="VDJ",
    dual_ir="primary_only",
)
ir.tl.ir_query_annotate(
    adata_bcr, cov_abdab, metric=metric, sequence=sequence, include_ref_cols=["Binding"]
)
adata_bcr.obs["Binding"].value_counts()
100%|███████████████████████████████████| 15443/15443 [00:04<00:00, 3441.29it/s]
100%|█████████████████████████████████████████| 26/26 [00:00<00:00, 3350.08it/s]
SARS-CoV-2    26
Name: Binding, dtype: int64
原教程报告,26 个细胞的重链 CDR3 与数据库记录精确匹配。匹配数量依赖所用样本及数据库版本。
随后要求重链和轻链主链的 CDR3 都精确匹配:
ir.tl.ir_query(
    adata_bcr,
    cov_abdab,
    metric=metric,
    sequence=sequence,
    receptor_arms="all",
    dual_ir="primary_only",
)
ir.tl.ir_query_annotate(
    adata_bcr,
    cov_abdab,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["Binding"],
    suffix="_fullIR",
)
adata_bcr.obs["Binding_fullIR"].value_counts()
100%|███████████████████████████████████| 19402/19402 [00:09<00:00, 2025.33it/s]
100%|█████████████████████████████████████████| 21/21 [00:00<00:00, 2945.83it/s]
SARS-CoV-2    21
Name: Binding_fullIR, dtype: int64
配对链约束通常会减少命中,并可降低部分匹配歧义,但不能保证全部命中均具有相同结合功能。
通过汉明距离查询
体细胞高频突变(Somatic Hypermutation, SHM)可使同一 B 细胞谱系的受体在多个位置发生替换;插入和缺失相对较少,但并非不存在。汉明距离(Hamming distance)统计等长序列中不同位置的数量,可用于允许少量氨基酸替换的 CDR3 查询。阈值应显式选择并验证;下方 ir_dist 未指定 cutoff,不能据此认定只允许一个替换。代码还把 sequence 拼为 seqeunce,这会导致变量未定义时运行失败。
metric = "hamming"
sequence = "aa"

ir.pp.ir_dist(adata_bcr, cov_abdab, metric=metric, sequence=sequence)
ir.tl.ir_query(
    adata_bcr,
    cov_abdab,
    metric=metric,
    sequence=seqeunce,
    receptor_arms="all",
    dual_ir="primary_only",
)
ir.tl.ir_query_annotate(
    adata_bcr,
    cov_abdab,
    metric=metric,
    sequence=sequence,
    include_ref_cols=["Binding"],
    suffix="_Hamming",
)
adata_bcr.obs["Binding_Hamming"].value_counts()
输出
100%|███████████████████████████████████| 10561/10561 [00:02<00:00, 5105.46it/s]
100%|███████████████████████████████████| 24885/24885 [00:04<00:00, 5575.50it/s]
100%|████████████████████████████████████| 19402/19402 [00:23<00:00, 835.62it/s]
100%|█████████████████████████████████████████| 44/44 [00:00<00:00, 4068.01it/s]
SARS-CoV-2    44
Name: Binding_Hamming, dtype: int64
放宽到相似序列可能增加候选注释,但必须先修正变量拼写并明确距离阈值。原文将结果描述为“两条链距离均为 1”,而示例没有显式设置 cutoff;Scirpy 的 Hamming 默认阈值为 2,不能把默认调用的结果当作阈值 1 的验证结果。
这些候选分组可与转录组等模态结合,研究可能具有 SARS-CoV-2 相关反应的 B 细胞状态。特异性仍需其他证据支持,避免将数据库推断直接当作实验标签。
距离度量
SHM 会使同一 BCR 克隆谱系包含不同序列。亲和力成熟(affinity maturation)过程中,这些受体可能继续识别相同或相关表位,但亲和力及识别范围也可能改变。考虑这类变化的距离聚类已在前面的克隆型章节介绍;原文此处的章节引用尚未补全 。
不同克隆谱系也可能识别同一抗原或表位,即使它们没有共同的近期克隆来源。部分抗体比较方法利用序列和实测或预测的结构来寻找这种功能相似性,也可用于 BCR 研究。结构计算可能带来较高成本,是否适合大规模单细胞分析取决于方法和数据规模;本教程不展开这些流程。
预测
常规 αβ TCR 主要识别 MHC 呈递的肽,而 BCR 可直接识别蛋白质、多糖等抗原上的线性或构象表位。后者不要求 MHC 呈递,但仍受受体与抗原三维结构约束。抗体(antibody, Ab)/BCR 预测工具可识别抗体上的结合位点(paratope)和抗原上的表位;深度学习也用于结构预测、抗体设计、优化和对接。这些方法多面向抗体发现与治疗开发,部分流程计算成本较高,超出本教程的大规模单细胞示例范围。
测验
- Springer, I., Tickotsky, N., & Louzoun, Y. (2021). Contribution of t cell receptor alpha and beta cdr3, mhc typing, v and j genes to peptide binding prediction. Frontiers in Immunology, 12.
- Glanville, J., Huang, H., Nau, A., Hatton, O., Wagar, L. E., Rubelt, F., Ji, X., Han, A., Krams, S. M., Pettus, C., & others. (2017). Identifying specificity groups in the T cell receptor repertoire. Nature, 547(7661), 94–98.
- Davis, M. M., & Bjorkman, P. J. (1988). T-cell antigen receptor genes and T-cell recognition. Nature, 334(6181), 395–402.
- Rudolph, M. G., Stanfield, R. L., & Wilson, I. A. (2006). How TCRs bind MHCs, peptides, and coreceptors. Annual Review of Immunology, 24(1), 419–466.
- Fleri, W., Paul, S., Dhanda, S. K., Mahajan, S., Xu, X., Peters, B., & Sette, A. (2017). The immune epitope database and analysis resource in epitope discovery and synthetic vaccine design. Frontiers in Immunology, 8, 278.
- Shugay, M., Bagaev, D. V., Zvyagin, I. V., Vroomans, R. M., Crawford, J. C., Dolton, G., Komech, E. A., Sycheva, A. L., Koneva, A. E., Egorov, E. S., & others. (2018). VDJdb: a curated database of T-cell receptor sequences with known antigen specificity. Nucleic Acids Research, 46(D1), D419–D427.
- Tickotsky, N., Sagiv, T., Prilusky, J., Shifrut, E., & Friedman, N. (2017). McPAS-TCR: a manually curated catalogue of pathology-associated T cell receptor sequences. Bioinformatics, 33(18), 2924–2929.
- Zhang, W., Wang, L., Liu, K., Wei, X., Yang, K., Du, W., Wang, S., Guo, N., Ma, C., Luo, L., & others. (2020). PIRD: Pan immune repertoire database. Bioinformatics, 36(3), 897–903.
- Nolan, S., Vignali, M., Klinger, M., Dines, J. N., Kaplan, I. M., Svejnoha, E., Craft, T., Boland, K., Pesesky, M., Gittelman, R. M., & others. (2020). A large-scale database of T-cell receptor beta (TCRβ) sequences and binding associations from natural and synthetic exposure to SARS-CoV-2. Research Square.
- Dash, P., Fiore-Gartland, A. J., Hertz, T., Wang, G. C., Sharma, S., Souquette, A., Crawford, J. C., Clemens, E. B., Nguyen, T. H., Kedzierska, K., & others. (2017). Quantifiable predictive features define epitope-specific T cell receptor repertoires. Nature, 547(7661), 89–93.
- Henikoff, S., & Henikoff, J. G. (1992). Amino acid substitution matrices from protein blocks. Proceedings of the National Academy of Sciences, 89(22), 10915–10919.
- Chronister, W. D., Crinklaw, A., Mahajan, S., Vita, R., Koşaloğlu-Yalçın, Z., Yan, Z., Greenbaum, J. A., Jessen, L. E., Nielsen, M., Christley, S., & others. (2021). TCRMatch: Predicting T-cell receptor specificity based on sequence similarity to previously characterized receptors. Frontiers in Immunology, 12, 673.
- Raybould, M. I. J., Kovaltsuk, A., Marks, C., & Deane, C. M. (2021). CoV-AbDab: the Coronavirus Antibody Database. Bioinformatics, 37(5), 734–735. 10.1093/bioinformatics/btaa739