🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: spatial
channels:
  - defaults
  - conda-forge
dependencies:
  - conda-forge::python=3.12.12
  - conda-forge::scanpy=1.12
  - conda-forge::leidenalg
  - conda-forge::pytorch-cpu
  - conda-forge::pip
  - pip:
      - squidpy==1.8.1
      - SpaGCN==1.2.7
      - SpatialDE==1.1.3
      - tangram-sc==1.0.4
      - cell2location==0.1.5
研究动机
单细胞分析常先识别高变基因(Highly Variable Genes, HVGs),进行特征(feature)选择以减少数据维度。HVG 方法关注跨细胞的表达变异,通常结合均值–方差关系评估,而不直接利用空间位置。因此,表达变异较大的基因未必呈现明确的空间模式,也未必是空间可变基因(Spatially Variable Genes, SVGs)。
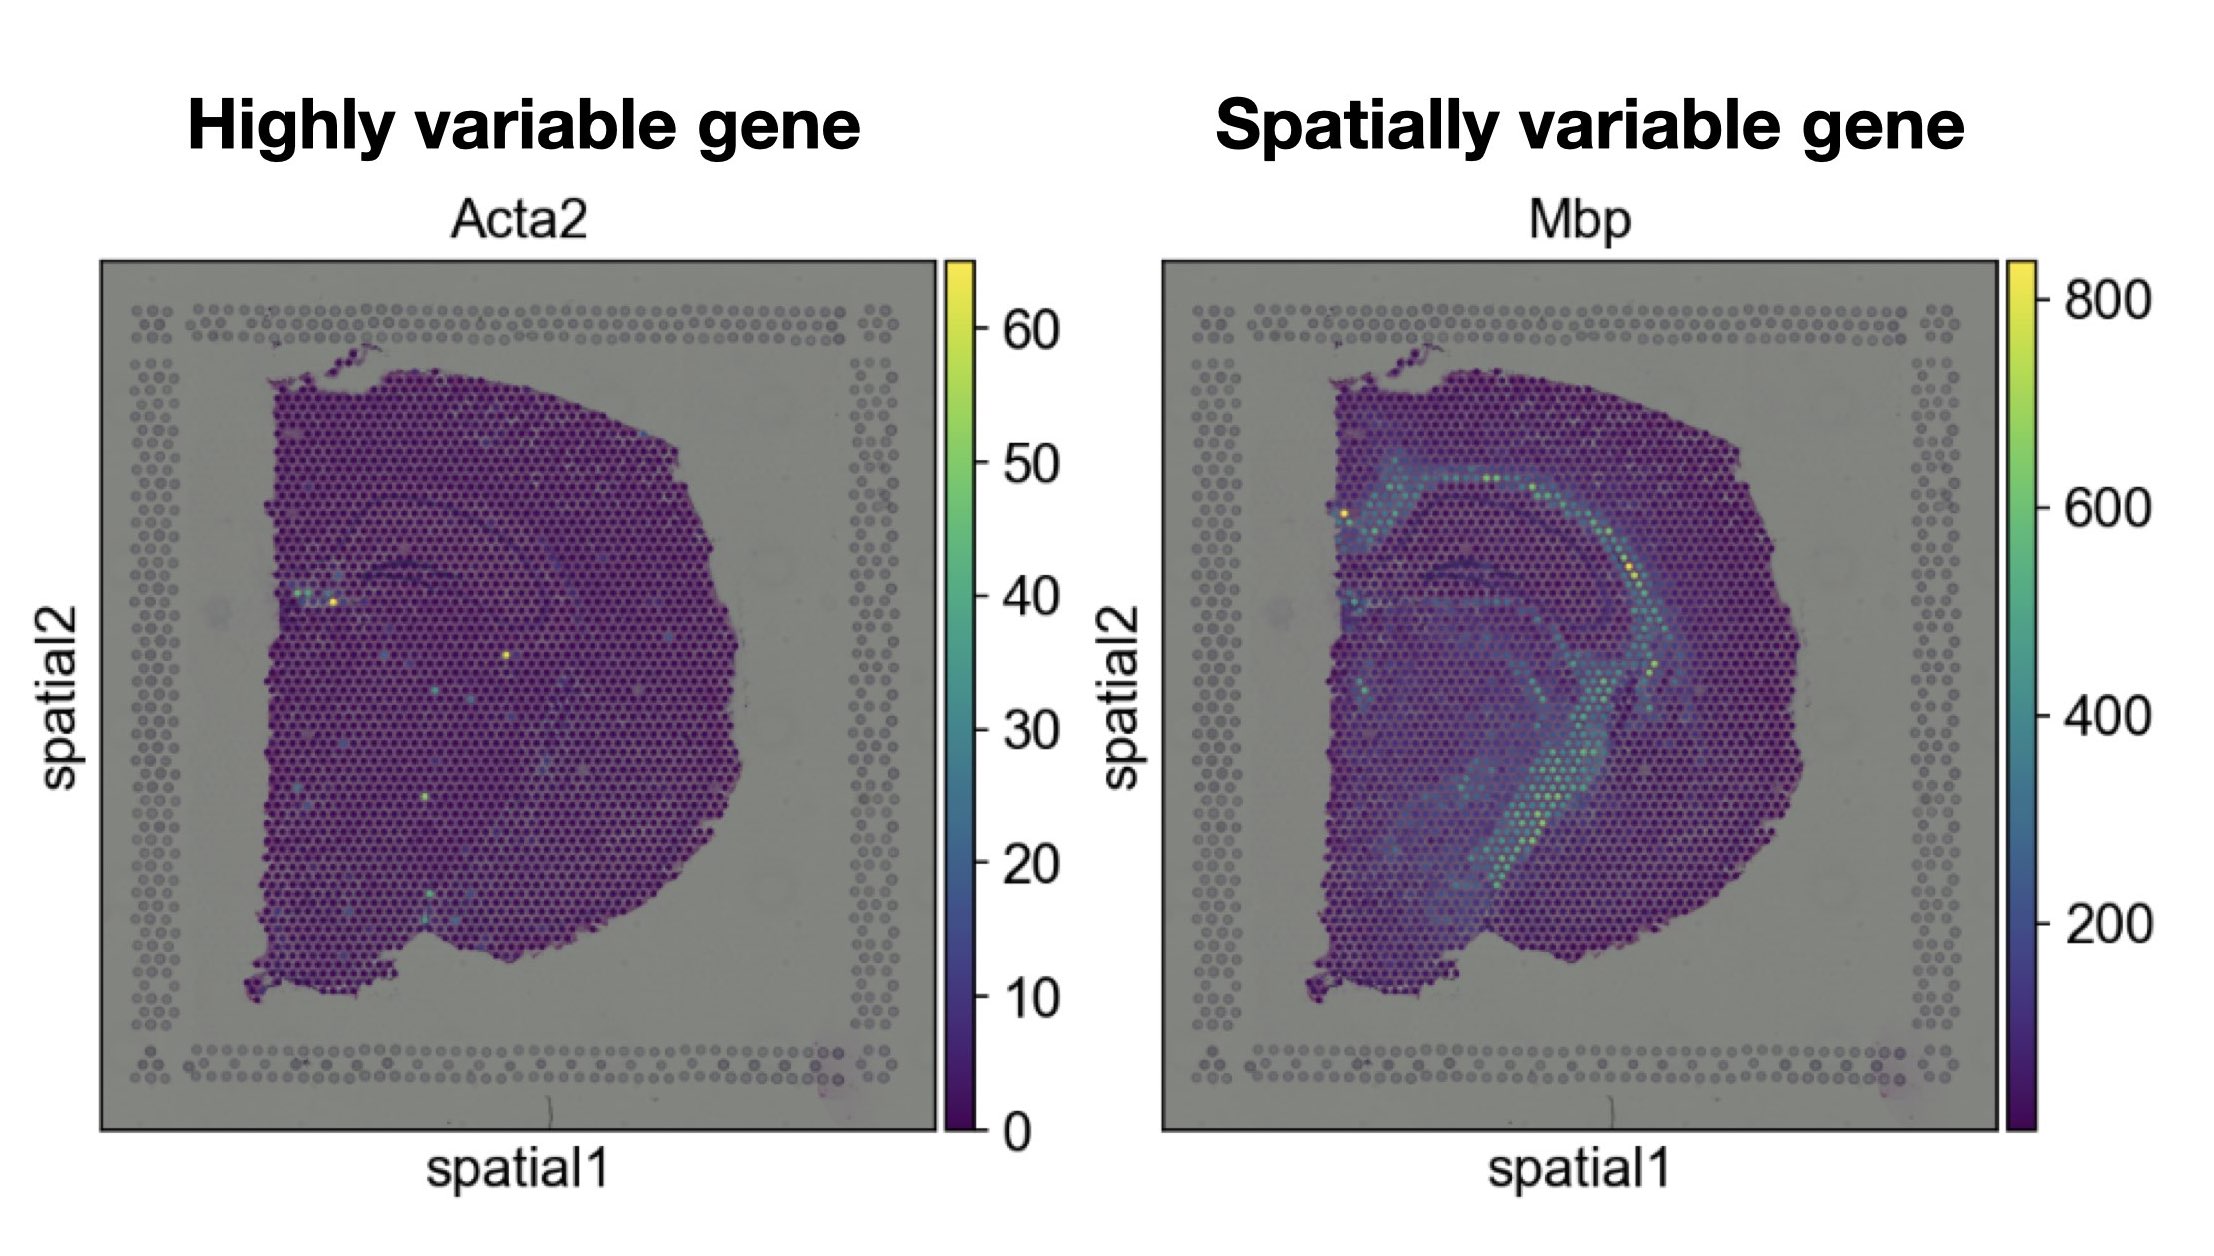
图 1:SVG 强调表达随空间位置呈现规律;HVG 强调跨细胞的较高表达变异,两者不等同。
空间表达模式可能源于细胞类型组成、组织功能分区或细胞间通讯(Cell–Cell Communication, CCC)等因素。识别 SVG 有助于研究组织生物学;相关方法通常检验表达与空间位置是否存在关联,部分方法将变异分为空间与非空间成分 Walker et al., 2022。
现有方法的复杂度、假设和空间变异定义不同,尚无适用于所有情形的最佳方法。SpatialDE Svensson et al., 2018、SpatialDE2 Kats et al., 2021 和 SPARKZhu et al., 2021 Sun et al., 2020 采用空间相关性检验;SepalAndersson & Lundeberg, 2021 通过表达信号的扩散过程刻画空间模式;scGCOZhang et al., 2022 使用图割(graph cut)方法;SpaGCN Hu et al., 2021 则先用图卷积网络(Graph Convolutional Network, GCN)识别空间域(spatial domain),再寻找与域相关的 SVG。
本章先用 Squidpy Palla et al., 2022 中的莫兰指数(Moran’s I)演示空间自相关(spatial autocorrelation)分析,再介绍 SpatialDE 的工作流(workflow)。
环境配置与数据
先导入所需软件包并加载数据。
import NaiveDE
import scanpy as sc
import SpatialDE
import squidpy as sq

sc.settings.verbosity = 3
sc.settings.set_figure_params(dpi=80, facecolor="white")
本例使用来自一只小鼠的一张组织切片,由 10x Genomics 提供并经 Space Ranger 1.1.0 处理,详见 数据页面。Squidpy 提供预处理数据及相应加载函数。
adata = sq.datasets.visium_hne_adata()Squidpy 中的 Moran’s I
Moran’s I 衡量空间自相关,即空间邻近观测之间的信号关联。用于表达数据时,可以检查相近位置是否倾向于具有相似的表达水平。
定义为: 其中:
表示该 feature 的观测值相对于均值的偏差,即
表示观测 i 与 j 之间的空间权重
表示空间观测单元的数量
表示全部空间权重之和,即对所有 i、j 求和的
先构建空间邻接图,再调用 Squidpy 计算 Moran’s I。下方代码传入全部基因名;如需缩短演示时间,可指定较小的基因集合。
sq.gr.spatial_neighbors(adata)
sq.gr.spatial_autocorr(adata, mode="moran", genes=adata.var_names)
Creating graph using `grid` coordinates and `None` transform and `1` libraries.
Adding `adata.obsp['spatial_connectivities']`
`adata.obsp['spatial_distances']`
`adata.uns['spatial_neighbors']`
Finish (0:00:00)
Calculating moran's statistic for `None` permutations using `1` core(s)
Adding `adata.uns['moranI']`
Finish (0:00:00)
结果以数据框形式写入 adata.uns,对应的键为 moranI。下面查看前几行:
adata.uns["moranI"].head()Squidpy 为每个基因计算的主要结果包括:
I:Moran’s I 统计量pval_norm:在正态近似假设下计算的解析 p 值(p-value)var_norm:该假设下 Moran’s I 的方差{p_val}_{corr_method}:使用指定多重检验(multiple testing)方法校正后的 p 值
以两个显著基因 Nrgn 和 Ttr 为例查看空间表达。表中的校正 p 值显示为 0.0,这是浮点计算或显示精度造成的结果,不能解读为真实概率恰好为零。数值下溢及尾部概率计算中的舍入都可能产生零;仅凭表中结果,不能确定它们的真实数量级。
这里的 p 值来自正态近似的解析计算。将参数 n_perms 传给 spatial_autocorr 还可获得基于置换的结果;有限置换次数会限制经验 p 值的分辨率。
sq.pl.spatial_scatter(adata, color=["Nrgn", "Ttr"])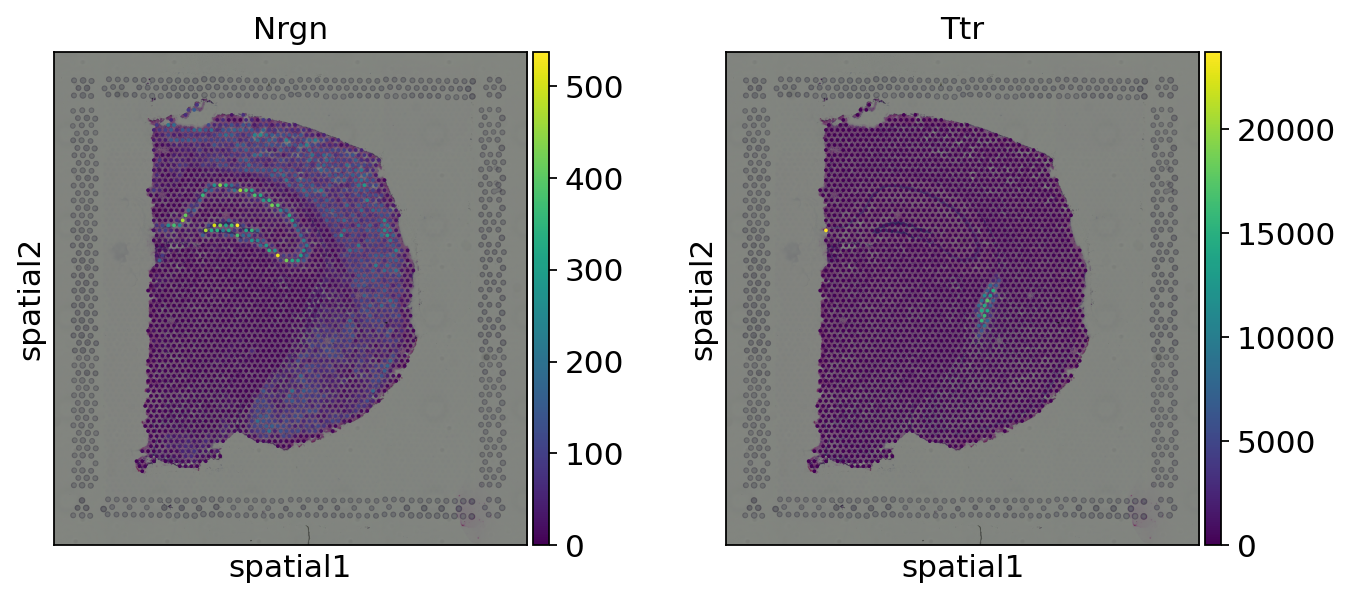
两个基因都在组织中呈现局部表达模式,但它们未必都是某一细胞簇的标记基因(marker gene)。SVG 识别可视为利用空间信息进行 feature 选择:它关注表达与位置的关系,而不只是跨观测的总体变异。
SpatialDE
SpatialDE 使用高斯过程回归(Gaussian Process Regression, GPR),将每个基因的表达变异分解为空间与非空间成分,并估计空间成分对总变异的贡献。它比较包含空间成分的模型与不含该成分的零模型,以检验空间变异是否显著。
继续使用前面的数据集。SpatialDE 接收列名唯一的表达数据框,因此先用 Scanpy 将基因名称变为唯一值。
adata.var_names_make_unique()提取原始计数(Count)表,以细胞或 捕获点(spot) 的条形码(Barcode)作为行索引、基因名作为列名。这里设置 use_raw=True,从对象保存的 raw 层取值。所调用的 Scanpy 函数是 get.obs_df,传入的数据对象为 adata。
counts = sc.get.obs_df(adata, keys=list(adata.var_names), use_raw=True)后续还需要每个 spot 的总 Count 和空间坐标。先将总 Count 提取为数据框,空间坐标将在调用模型时直接传入。
total_counts = sc.get.obs_df(adata, keys=["total_counts"])SpatialDE 的噪声模型采用高斯分布(Gaussian distribution)。原始 Count 常具有随均值变化的方差,可用负二项等计数模型描述,因此需要先做方差稳定化变换(variance-stabilizing transformation, VST)。NaiveDE.stabilize 使用基于 Anscombe 思路的变换,使数据更符合建模假设;这并不保证变换后严格服从正态分布。
norm_expr = NaiveDE.stabilize(counts.T).T/home/icb/anna.schaar/miniconda3/envs/spatial-chapters/lib/python3.9/site-packages/scipy/optimize/_minpack_py.py:906: OptimizeWarning: Covariance of the parameters could not be estimated
warnings.warn('Covariance of the parameters could not be estimated',
方差稳定化后,不同 spot 的文库大小(library size)仍可能影响表达。SpatialDE 推荐先回归掉总 Count 对数的影响,再进行空间检验:
resid_expr = NaiveDE.regress_out(total_counts, norm_expr.T, "np.log(total_counts)").T将空间坐标和回归后的表达残差传入 SpatialDE。作者在本数据集上对全部基因运行约需 15 分钟,具体耗时取决于数据规模和硬件。
results = SpatialDE.run(adata.obsm["spatial"], resid_expr)查看分析结果:
results.head()结果数据框中的主要列包括:
g:基因名l:表达空间变化的特征长度尺度,其单位与输入坐标一致pval:空间 变异检验的 p 值qval:多重检验校正后的 q 值
按校正后的 q 值(qval)排序,取前十个基因,并仅展示 g,l 和 qval 三列。将结果保存为 top10,供后续绘图。
top10 = results.sort_values("qval").head(10)[["g", "l", "qval"]]
top10绘制排名前三的基因,检查其空间表达模式,并与已有聚类(clustering)标签比较,判断模式是否与特定群体相关。
sq.pl.spatial_scatter(adata, color=list(top10["g"][:3]) + ["cluster"])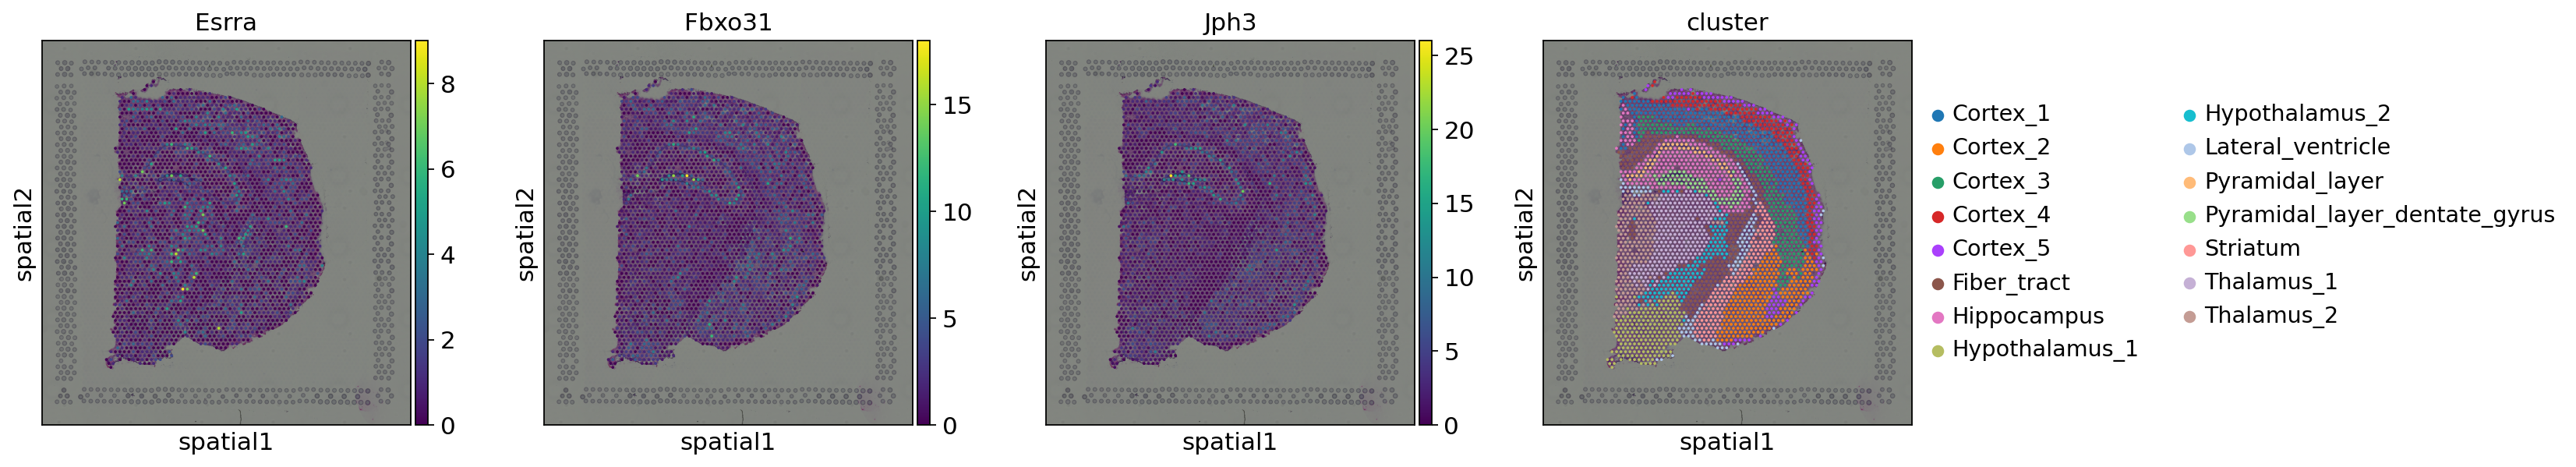
这三个基因均呈现空间模式。Esrra 的表达不限于某个单独簇,主要分布在皮层、丘脑与下丘脑;Fbxo31 和 Jph3 则主要在锥体细胞层表达。
- Walker, B. L., Cang, Z., Ren, H., Bourgain-Chang, E., & Nie, Q. (2022). Deciphering tissue structure and function using spatial transcriptomics. Communications Biology, 5(1), 220. 10.1038/s42003-022-03175-5
- Svensson, V., Teichmann, S. A., & Stegle, O. (2018). SpatialDE: identification of spatially variable genes. Nature Methods, 15(5), 343–346. 10.1038/nmeth.4636
- Kats, I., Vento-Tormo, R., & Stegle, O. (2021). SpatialDE2: Fast and localized variance component analysis of spatial transcriptomics. bioRxiv, 2021.10.27.466045. 10.1101/2021.10.27.466045
- Zhu, J., Sun, S., & Zhou, X. (2021). SPARK-X: non-parametric modeling enables scalable and robust detection of spatial expression patterns for large spatial transcriptomic studies. Genome Biology, 22(1), 184. 10.1186/s13059-021-02404-0
- Sun, S., Zhu, J., & Zhou, X. (2020). Statistical analysis of spatial expression patterns for spatially resolved transcriptomic studies. Nature Methods, 17(2), 193–200. 10.1038/s41592-019-0701-7
- Andersson, A., & Lundeberg, J. (2021). sepal: identifying transcript profiles with spatial patterns by diffusion-based modeling. Bioinformatics, 37(17), 2644–2650. 10.1093/bioinformatics/btab164
- Zhang, K., Feng, W., & Wang, P. (2022). Identification of spatially variable genes with graph cuts. Nature Communications, 13(1), 5488. 10.1038/s41467-022-33182-3
- Hu, J., Li, X., Coleman, K., Schroeder, A., Ma, N., Irwin, D. J., Lee, E. B., Shinohara, R. T., & Li, M. (2021). SpaGCN: Integrating gene expression, spatial location and histology to identify spatial domains and spatially variable genes by graph convolutional network. Nat. Methods, 18(11), 1342–1351.
- Palla, G., Spitzer, H., Klein, M., Fischer, D., Schaar, A. C., Kuemmerle, L. B., Rybakov, S., Ibarra, I. L., Holmberg, O., Virshup, I., Lotfollahi, M., Richter, S., & Theis, F. J. (2022). Squidpy: a scalable framework for spatial omics analysis. Nature Methods, 19(2), 171–178. 10.1038/s41592-021-01358-2