🧠 关键要点
在单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)数据中,识别差异表达基因(Differentially Expressed Genes, DEGs)主要有样本层面和细胞层面两种思路。已有比较研究表明,样本层面的方法表现更好。
样本层面的方法将每位患者同一条件、同一细胞类型的计数(Count)聚合,例如对细胞求和,生成伪 bulk(pseudobulk)样本。随后可使用最初为 bulk RNA-seq 开发的 edgeR 或 DESeq2 等工具进行分析。
建模前先探索数据。对 pseudobulk 样本进行主成分分析(Principal Component Analysis, PCA),有助于识别主要变异来源,并将其纳入设计矩阵(design matrix)。
不同细胞群表达的基因集(gene set)不同,因此应按细胞类型分别过滤低表达基因。
若数据包含不同亚组,设计矩阵应纳入相关协变量(covariate)。随后定义对比(contrast),检验具体感兴趣的组间差异。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到新文件,并命名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: differential-gene-expression
channels:
  - conda-forge
  - bioconda
dependencies:
  - conda-forge::python=3.14.6
  - conda-forge::pertpy=1.1.1
  - conda-forge::scanpy=1.12.3
  - bioconda::pydeseq2=0.5.4
  - pip
  - pip:
      - decoupler==2.2.0
      - lamindb==2.8.1
🗄️ 获取数据和笔记本
本书使用 lamindb 存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。感谢以下机构提供免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
本章承接 注释 一节, 并在此基础上进一步展开;该节已介绍如何使用 差异基因表达(Differential Gene Expression, DGE)分析,为 聚类(clustering) 标注 细胞类型。这里进一步讨论复杂实验设计中的 DGE 检验,例如涉及疾病、基因敲除或药物等一种或多种条件的实验。我们通常关注目标条件与参考条件之间基因表达差异的大小及其统计显著性。参考条件可按研究目的选定,常用健康样本。此类检验适用于任意分组;在单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)中,通常按细胞类型分别开展。
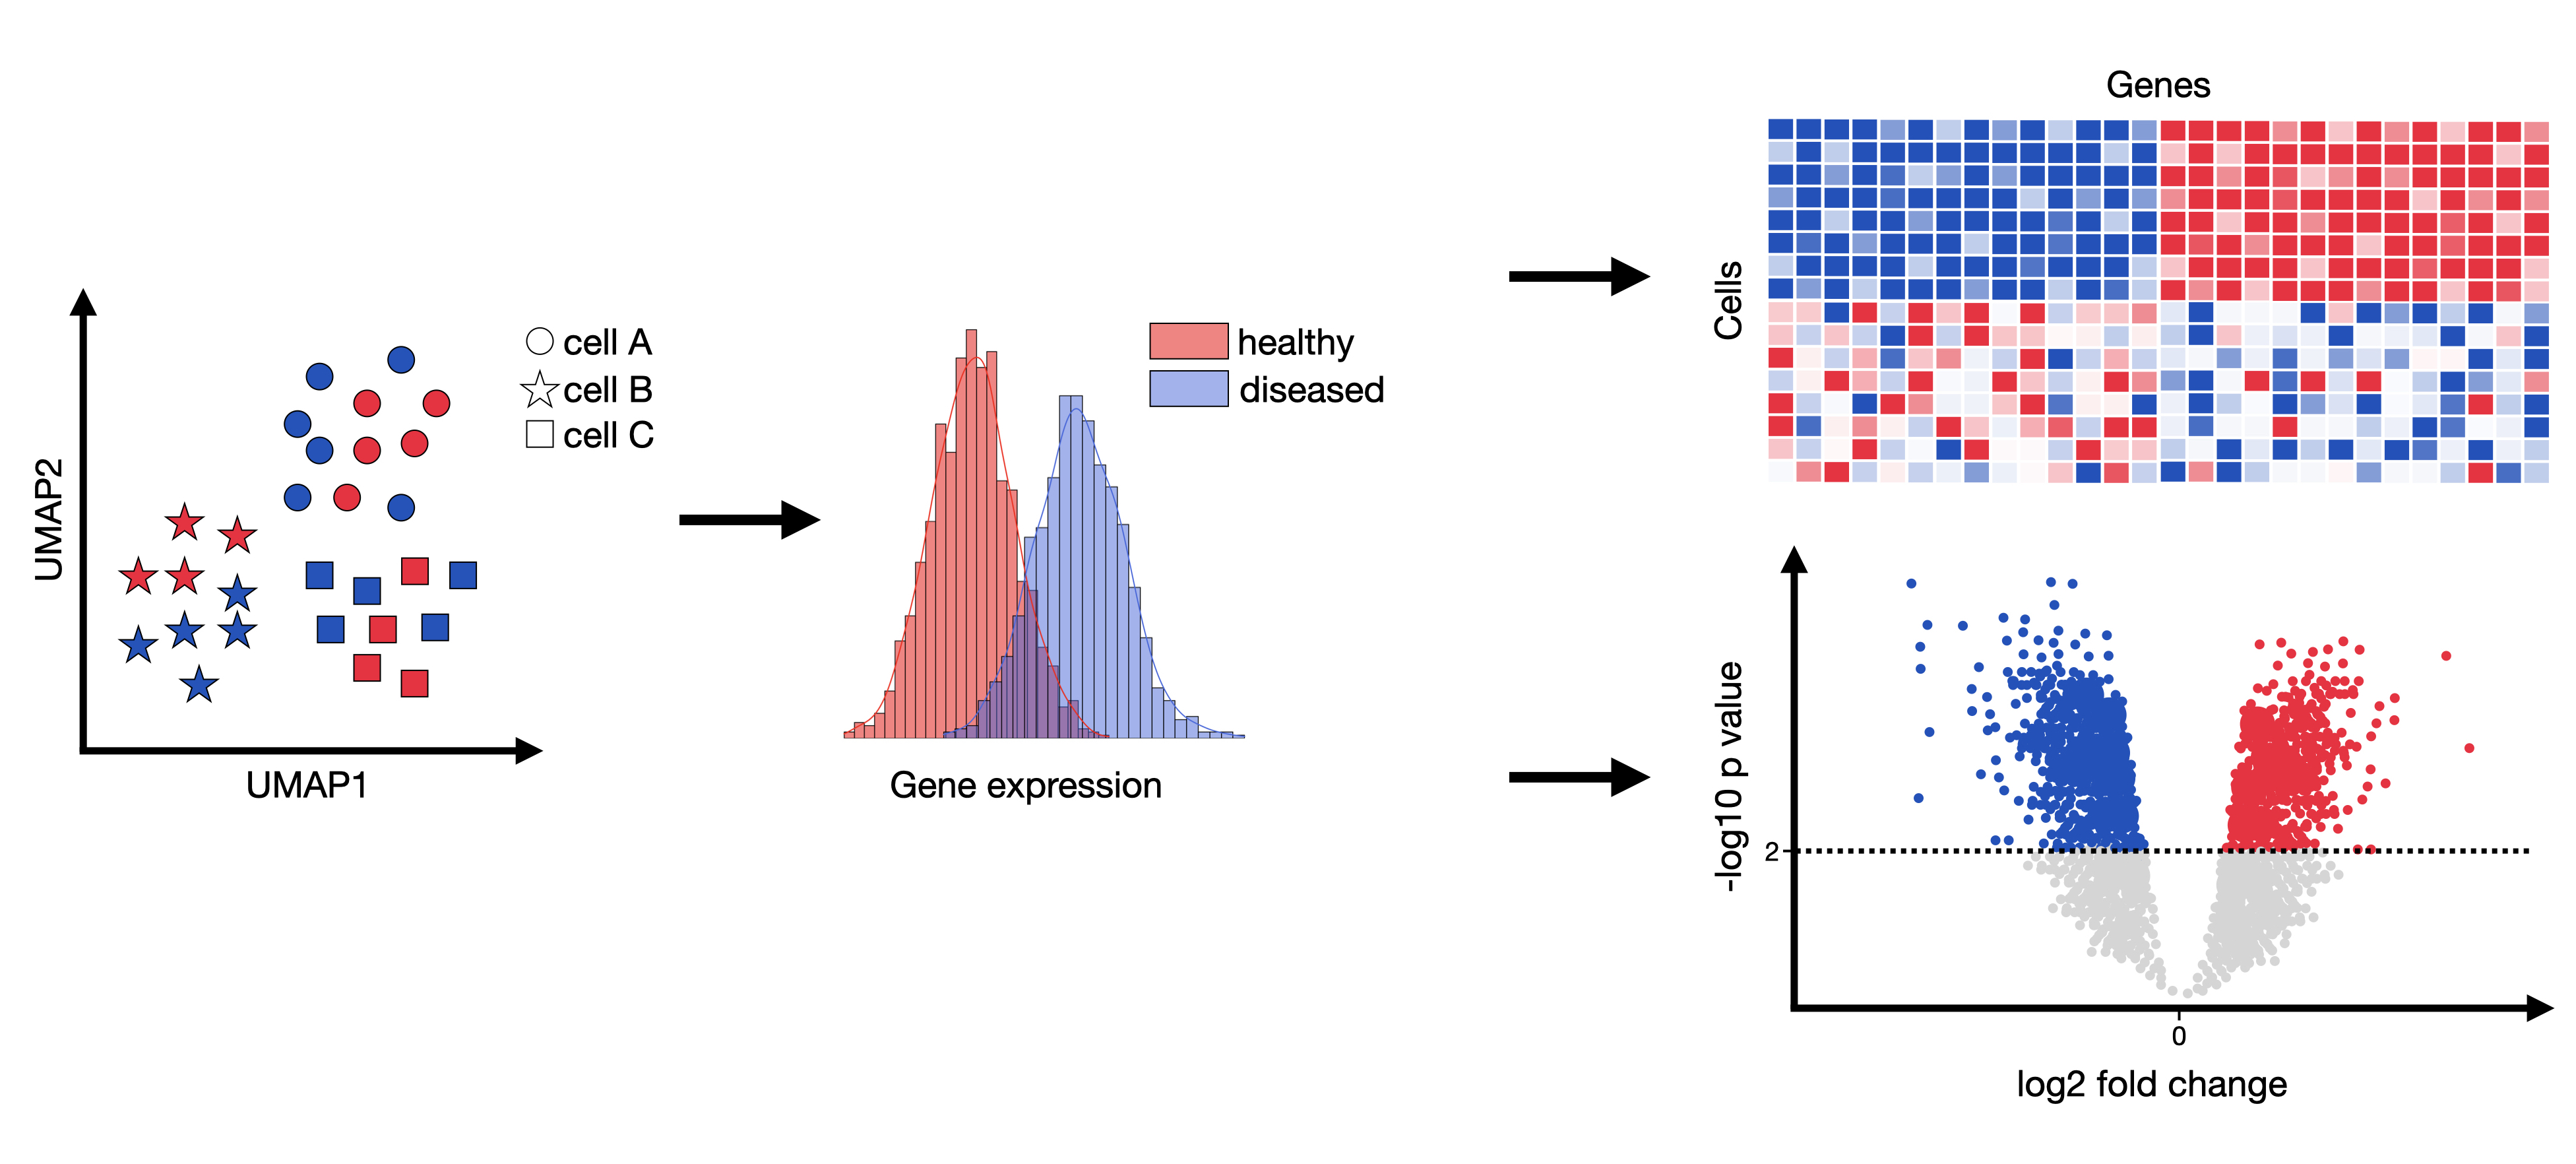
图 1:DGE 分析旨在识别比较组间表达显著升高或降低的基因,常见应用是在同一细胞类型内比较健康与研究条件。
分析可得到可能影响并解释观测表型的基因集(gene set)。随后可进一步研究这些基因涉及的通路,或它们可能引起的细胞间通讯变化。
DGE 检验通常针对每个基因、每组条件比较,返回 log2 倍数变化(log2 fold change, log2FC)及校正后的 p 值(p-value)。可按 p 值排序,再深入分析。
常用的 Student t 检验(Student's t-test)可以检验表达差异,但难以充分处理 scRNA-seq 数据的一些特点,例如 漏检(dropout) 造成的大量零值,以及复杂实验设计的需求。样本量通常不足以在不借助其他基因信息的情况下准确估计方差。此外,原始计数(Count)并非某个样本中某个基因表达量的绝对测量值。每个基因的实际读段(Read)数受到 文库(library) 制备效率、非编码转录本污染量及 测序 深度的影响。因此,t 检验用于 scRNA-seq 时,灵敏度和特异度均有不足,处理复杂实验设计的灵活性也有限。
DGE 检验是生物信息学中的经典问题,已有众多工具。现有方法主要分为两类:样本层面的方法先聚合表达数据,生成“伪 bulk(pseudobulk)样本”,再使用最初针对 bulk 表达 样本设计的方法,例如 edgeR Robinson et al., 2010 或 DEseq2 Love et al., 2014;细胞层面的方法则针对 细胞 分别建模,使用 MAST 等广义混合效应模型(Generalized Mixed-Effects Model)Finak et al., 2015 或 glmmTMB Brooks et al., 2017。不同 DGE 工具在各数据集上的结果一致性和稳健性较低 Wang et al., 2019Das et al., 2021。如前所述,单细胞数据包含 dropout、零膨胀(zero inflation)及较大的细胞间变异等噪声 Hicks et al., 2017Vallejos et al., 2017Luecken & Theis, 2019,但针对 bulk RNA-seq 开发的方法,与专门针对 scRNA-seq 的方法相比仍表现良好 Das et al., 2021Soneson & Robinson, 2018Jaakkola et al., 2016Squair et al., 2021。研究还发现,单细胞专用方法尤其容易把高表达基因错误地标记为差异表达。
研究强调了伪重复(pseudoreplication)问题:将并非统计独立的观测当作独立生物学重复(biological replicate)进行推断。忽略同一个体内细胞的固有相关性,会抬高假发现率(False Discovery Rate, FDR)Squair et al., 2021Zimmerman et al., 2021Junttila et al., 2022。因此,DGE 分析需要通过 批次校正(batch correction),或在同一个体内按细胞类型求和、取均值生成 pseudobulk 样本,或在模型中纳入个体随机效应(random effect),处理样本内细胞之间的相关性 Zimmerman et al., 2021。比较研究发现,按细胞求和的 pseudobulk 方法,如 edgeR、DESeq2 或 Limma Ritchie et al., 2015,以及设置随机效应的 MAST 等混合效应模型(mixed-effects model),均优于未考虑样本内相关性的简单方法,例如 Wilcoxon 秩和检验(Wilcoxon rank-sum test)或 Seurat 的 Hao et al., 2021 潜变量模型 Junttila et al., 2022。
在针对 Zimmerman 论文的后续讨论中,Murphy 等人审视并改进了其 基准测试(benchmarking) 策略 Murphy & Skene, 2022。他们得出的结论是:pseudobulk 方法表现最好,但究竟是求和还是求平均聚合更优,还需要进一步研究。
因此,本笔记本采用 pseudobulk 方法演示 DGE 分析。我们选择 DESeq2,是因为它有 Python 实现 PyDESeq2。若希望使用 edgeR,可参考 pertpy 的差异基因表达教程 进行改写。本章结合了 decoupler 和 pertpy 教程中的部分内容;更多细节请参阅相应文档。
环境设置
import decoupler as dc
import lamindb as ln
import numpy as np
import pandas as pd
import pertpy as pt
import scanpy as sc

ln.connect("theislab/sc-best-practices")
ln.track()
输出
→ loaded Transform('zt7x1ebMcoIA0000', key='differential_gene_expression.ipynb'), re-started Run('Oh5MpUtPYV0UPunU') at 2026-08-14 13:57:25 UTC
→ notebook imports: decoupler==2.2.0 lamindb-core==2.8.1 numpy==2.4.6 pandas==2.3.3 pertpy==1.1.1 scanpy==1.12.3
• tip: to identify the notebook across renames, pass the uid: ln.track("zt7x1ebMcoIA")
准备数据集
本章使用 Kang 数据集:通过 10x 液滴平台测量 8 位狼疮患者的外周血单个核细胞(Peripheral Blood Mononuclear Cells, PBMCs),比较未刺激与干扰素 β(Interferon Beta, IFN-β)刺激 6 小时两种条件,共 16 个样本 Kang et al., 2018。干扰素 β(interferon beta)以天然成纤维细胞制剂或重组制剂(干扰素 β-1a 和干扰素 β-1b)的形式使用,具有与干扰素 α 类似的抗病毒和抗增殖特性。干扰素 β 已被批准用于治疗复发-缓解型多发性硬化症和继发进展型多发性硬化症。
首先,我们加载完整的数据集。
adata = ln.Artifact.get(
    key="conditions/differential_gene_expression.h5ad",
).load()
adata
AnnData object with n_obs × n_vars = 24673 × 15706
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'label', 'cluster', 'cell_type', 'replicate', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters'
var: 'name'
obsm: 'X_pca', 'X_umap'分析需要 label(包含条件标签)、replicate(患者 ID)和 cell_type 列,均位于 .obs。
adata.obs[:5]分析需要原始 Count。先确认 .X 确实保存原始 Count,再将其复制到 counts 层;该层位于 AnnData 对象。
X = adata.X.data
np.array_equal(X, np.round(X))Trueadata.layers["counts"] = adata.X.copy()同一批 8 位患者分别提供了 8 个未刺激对照样本和 8 个刺激样本。
print(len(adata[adata.obs["label"] == "ctrl"].obs["replicate"].cat.categories))
print(len(adata[adata.obs["label"] == "stim"].obs["replicate"].cat.categories))
8
8
我们过滤掉表达基因少于 200 个的细胞,以及在少于 3 个细胞中出现的基因,以进行基本的质量控制(quality control, QC)。
sc.pp.filter_cells(adata, min_genes=200)
sc.pp.filter_genes(adata, min_cells=3)
adata.shape
(24562, 15701)生成 pseudobulk 样本
PyDESeq2 用于 bulk 数据的 DGE 分析,因此需要先将单细胞数据聚合为 pseudobulk 样本。对每位患者的每个实验条件,按细胞类型分别汇总细胞的基因表达 Count,得到对应的 pseudobulk 样本。无论随后只分析少数细胞群、为各群分别拟合模型,还是将多个细胞群纳入同一模型,都需要先完成这一步。
为每个“患者–条件”组合生成 pseudobulk 样本前,先创建组合标识列,其值由以下两列拼接而成:replicate 和 label。
adata.obs["sample"] = pd.Categorical(
    f"{rep}_{l}" for rep, l in zip(
        adata.obs["replicate"],
        adata.obs["label"],
        strict=False
    )
)
接下来使用 decoupler 生成 pseudobulk 样本。数据包含 8 位患者、8 种细胞类型和 2 个条件(ctrl 和 stim),因此共生成 128 个 pseudobulk 样本(8 × 8 × 2)。
adata_pb = dc.pp.pseudobulk(
    adata, sample_col="sample",
    groups_col="cell_type",
    layer="counts",
    mode="sum"
)
adata_pb
AnnData object with n_obs × n_vars = 128 × 15701
obs: 'sample', 'cell_type', 'label', 'replicate', 'psbulk_cells', 'psbulk_counts'
var: 'name', 'n_cells'
layers: 'psbulk_props'可依据两个指标过滤低质量样本:细胞数(psbulk_cells)和 Count 总和(psbulk_counts)。下图展示这两个指标,帮助选择过滤阈值。
dc.pl.filter_samples(
    adata=adata_pb,
    groupby=["label", "cell_type", "replicate"],
    min_cells=10,
    min_counts=1000,
    figsize=(5, 8),
)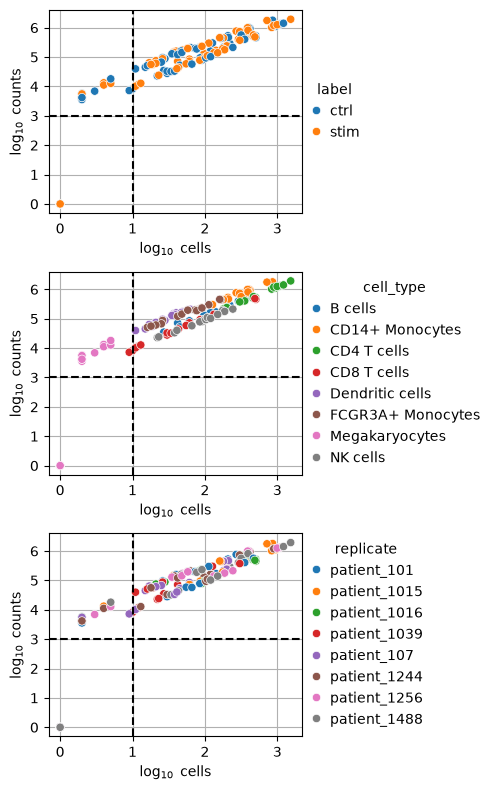
阈值需要根据数据集判断,没有统一标准。常用经验是保留至少包含 10 个细胞、Count 总和至少为 1,000 的样本。应用图中虚线所示的阈值后,仅保留右上象限的 pseudobulk 样本。过滤可使用 decoupler.pp.filter_samples()。
dc.pp.filter_samples(adata_pb, min_cells=10,min_counts=1000)过滤低质量样本后,再查看剩余样本。所有巨核细胞 pseudobulk 样本均未通过质量控制,另有两个 CD8 T 细胞样本被移除。
dc.pl.obsbar(adata=adata_pb, y="cell_type", hue="label", figsize=(6, 3))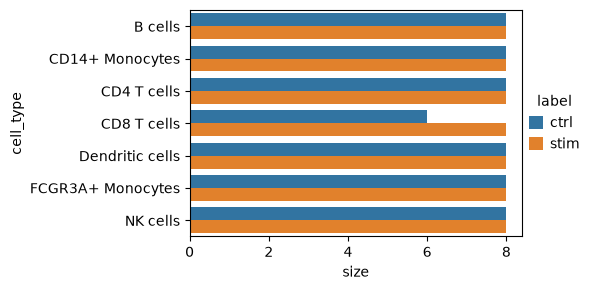
探索变异来源
DGE 结果的可靠性很大程度上取决于统计模型能否捕捉主要变异来源。对 pseudobulk 样本进行 主成分分析(Principal Component Analysis, PCA) 或多维尺度分析(Multidimensional Scaling, MDS),有助于识别变异来源,并据此构建设计矩阵(design matrix)和对比矩阵(contrast matrix)Law et al., 2020。
对于包含生物学重复的实验,如果不考虑多种生物学变异来源,就会抬高 FDR Thurman et al., 2021Lähnemann et al., 2020。增加每位个体的细胞数能够提高估计精度,但对检测个体间差异的统计功效(statistical power)帮助有限。提高统计功效更有效的办法,是增加独立实验样本数 Zimmerman et al., 2021。
现有数据无法再增加独立样本数,因此接下来通过探索分析识别主要变异来源,以合理构建设计矩阵。
我们先对生成的 pseudobulk 样本做基础探索性数据分析(exploratory data analysis, EDA),寻找可能异常的患者或样本,必要时将其剔除,以免影响差异表达结果。先将原始 Count 保存在 'counts' 层,再进行归一化和缩放以计算 PCA。之后恢复原始 Count,用于 下游分析。
adata_pb.layers['counts'] = adata_pb.X.copy()

sc.pp.normalize_total(adata_pb, target_sum=1e6)
sc.pp.log1p(adata_pb)
sc.pp.scale(adata_pb, max_value=10)
sc.tl.pca(adata_pb)

dc.pp.swap_layer(adata=adata_pb, key="counts", inplace=True)
还纳入 psbulk_counts_log 和 psbulk_cells_log,因为对数变换可以减小样本文库大小(library size)及细胞数相关指标(psbulk_counts 和 psbulk_cells)分布的偏斜,更可靠地检测它们与主成分(principal component, PC)的相关性。
adata_pb.obs["psbulk_counts_log"] = np.log(adata_pb.obs["psbulk_counts"])
adata_pb.obs["psbulk_cells_log"] = np.log(adata_pb.obs["psbulk_cells"])
dc.tl.rankby_obsm(adata_pb, key="X_pca")
sc.pl.pca_variance_ratio(adata_pb)
dc.pl.obsm(
adata=adata_pb,
return_fig=True,
nvar=5,
titles=["PC scores", "Adjusted p-values"],
figsize=(10, 5)
)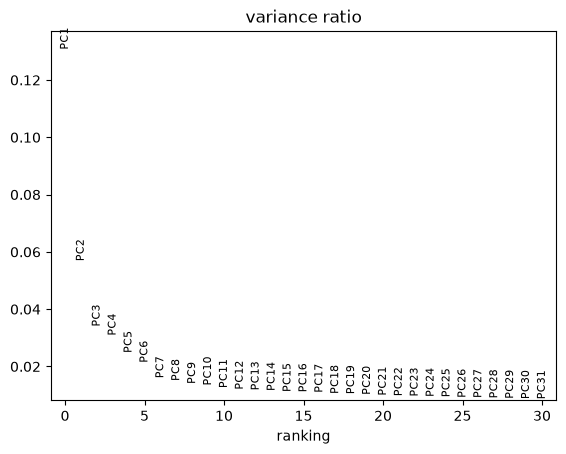
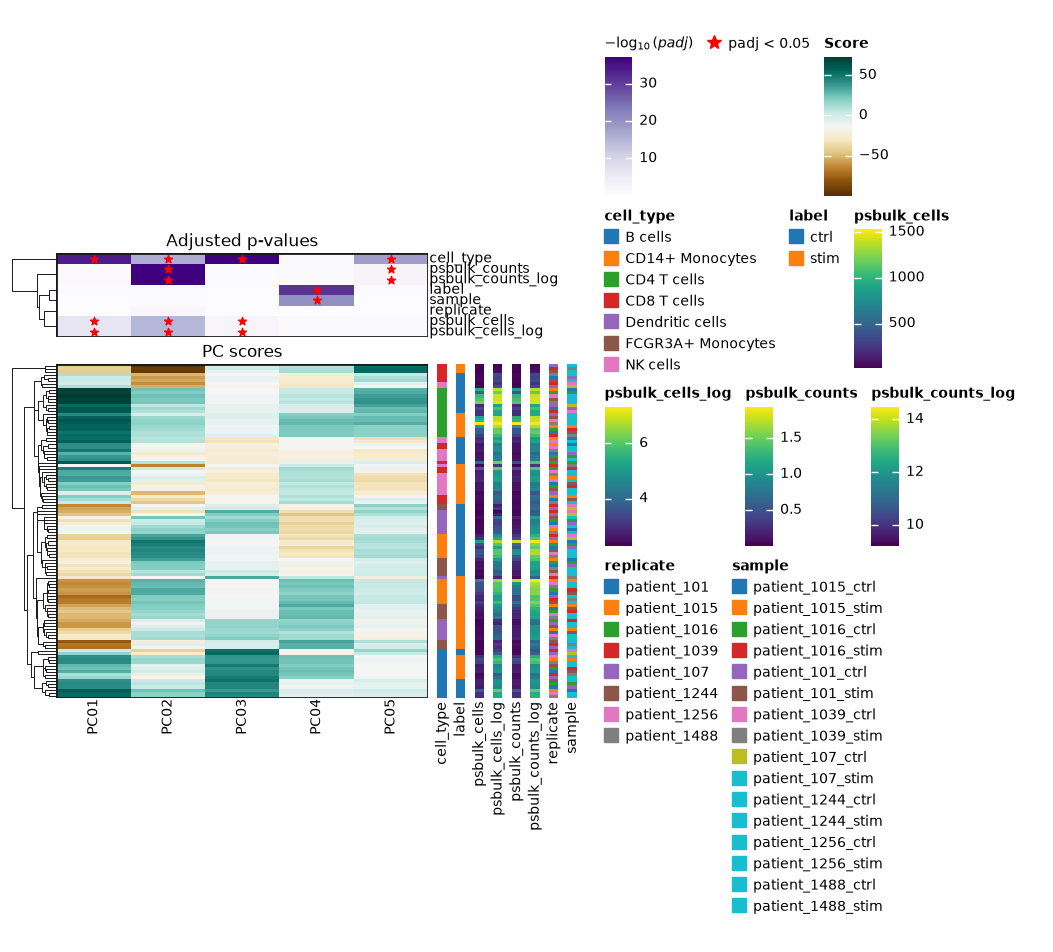
本数据集中,第一主成分(PC1)的方差解释比例最高,约为 0.13,并与细胞类型及 pseudobulk 样本的细胞数相关。若某些元数据(metadata)变量与解释较多方差的主成分相关,应尽可能在下游 DGE 分析中作为协变量(covariate)考虑,例如纳入设计矩阵。也可以直接绘制主成分,并按这些元数据变量着色。
adata_pb.obs = adata_pb.obs.sort_index(axis=1)
sc.pl.pca(adata_pb, color=adata_pb.obs, ncols=2, size=300)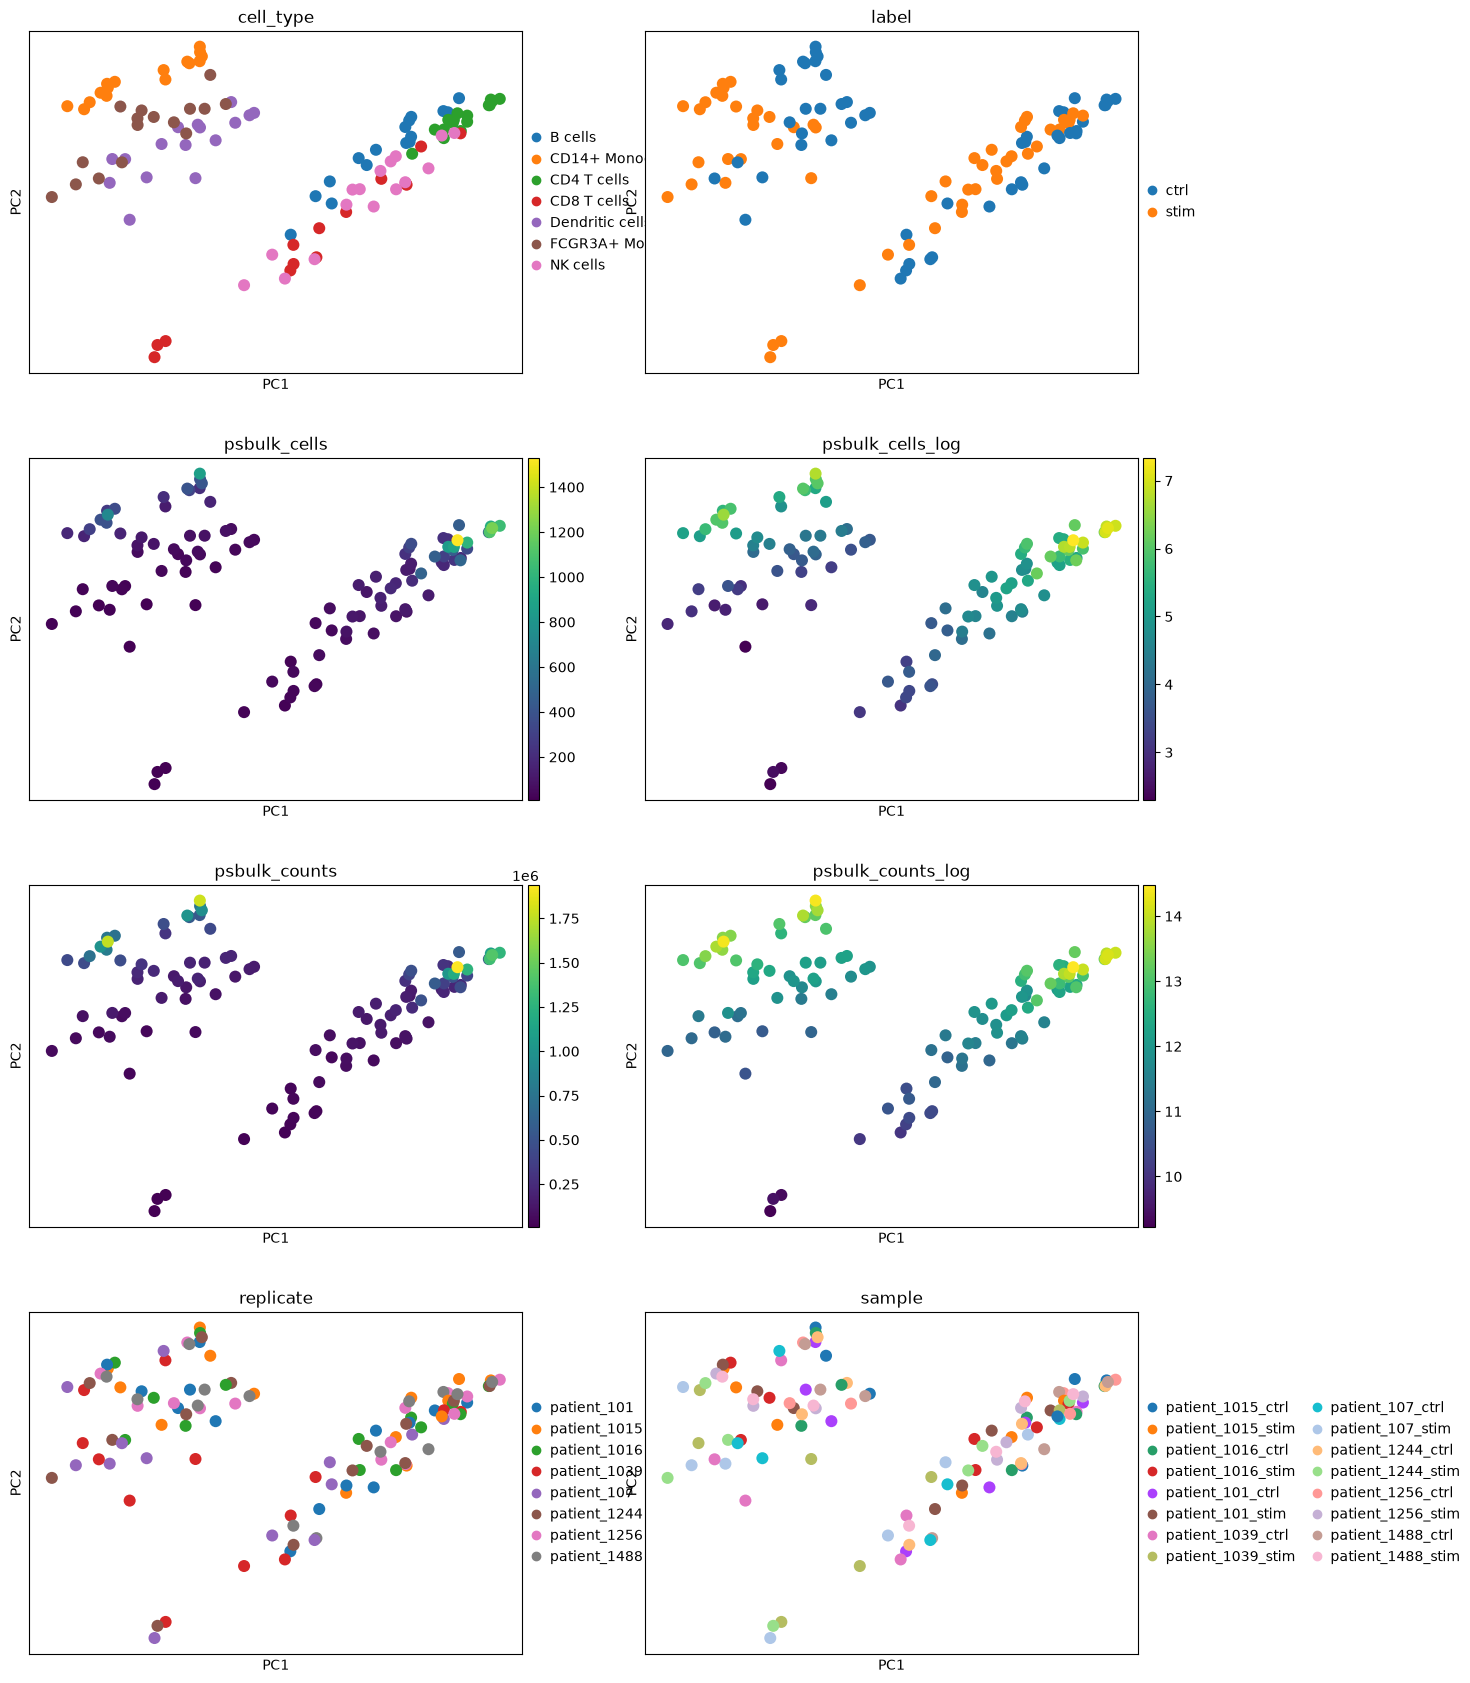
PCA 图中,不同细胞类型相互分离,刺激与未刺激细胞也呈现分离。按 pseudobulk 细胞数和 Count 着色时,较高值集中在左上方和右上方,且分别与 CD14+ 单核细胞及 CD4 T 细胞群部分重合。这提示 pseudobulk 样本的细胞数和 Count 可能与细胞类型有关。患者及样本标识(replicate、sample)与这些主成分未呈现明显相关,因此本示例未将它们纳入设计矩阵。
分析单一细胞类型或分组
若已明确关注的细胞类型,可在此提取相应子集,减少混杂因素;否则可先 分析完整数据集,识别受影响最大的细胞类型,再返回此步骤。
若探索分析发现细胞类型与主成分相关,可在各细胞类型子集中重新分析,检查相关协变量的影响是否仍然存在。本例中,提取 CD14+ 单核细胞后,pseudobulk 细胞数与主成分的关联消失,因此第一个设计矩阵未纳入该变量。
特征选择
除了过滤低质量样本,还可在 DGE 分析前去除低表达或噪声较大的基因。不同细胞类型表达的基因集合不同,因此应按细胞类型分别过滤。这里将分析 流程(pipeline) 应用于 CD14+ 单核细胞子集,因为原研究在该群体中识别到的差异表达基因(differentially expressed gene, DEG)最多。
adata_mono = adata_pb[adata_pb.obs["cell_type"] == "CD14+ Monocytes"].copy()
adata_mono.shape
(16, 15701)过滤基因有两种策略:
decoupler.pp.filter_by_expr:要求基因在所有样本中的 Read 总数达到阈值(min_total_count),且在足够数量的样本中达到最低 Count 要求(min_count)。该方法最早见于 edgeR Robinson et al., 2010。decoupler.pp.filter_by_prop:要求基因在至少一定数量的样本中,表达该基因的细胞比例达到阈值(min_prop);最低样本数由min_smpls指定。可绘制保留基因的数量,并交互式调整过滤参数。
dc.pl.filter_by_expr(
    adata=adata_mono,
    group="label",
    min_count=10,
    min_total_count=15,
    large_n=10,
    min_prop=0.7,
)
dc.pl.filter_by_prop(
    adata=adata_mono,
    min_prop=0.1,
    min_smpls=2,
)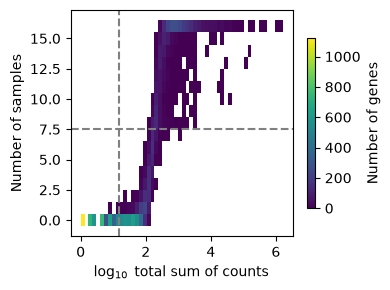
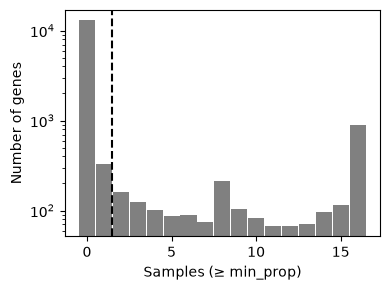
上图展示基于 filter_by_expr 指标的基因频数分布,下图对应 filter_by_prop。虚线表示当前阈值:上图仅保留右上象限的基因,下图仅保留竖线右侧的基因。
过滤阈值没有统一标准。常用经验是观察是否存在双峰分布,再设置能将低质量基因与其余基因区分开的阈值。本例中,默认参数能够保留较多基因,同时去除潜在噪声。
确定阈值后即可实际过滤基因:将前面绘图调用中的 pl 改为 pp。
dc.pp.filter_by_expr(
    adata=adata_mono,
    group="label",
    min_count=10,
    min_total_count=15,
    large_n=10,
    min_prop=0.7,
)
dc.pp.filter_by_prop(
    adata=adata_mono,
    min_prop=0.1,
    min_smpls=2,
)
adata_mono.shape
(16, 2345)使用 PyDESeq2 检验差异表达
接下来使用 pertpy,以便调用其内置绘图函数。也可以直接使用 PyDESeq2 完成 DGE 分析;pertpy 中的 PyDESeq2 接口与原接口十分相似。
下一步需要为模型定义合适的设计矩阵。建议阅读 这份指南,了解设计矩阵的构建方法。
pds2 = pt.tl.PyDESeq2(adata=adata_mono,design='~ label')pds2.fit()输出
Using None as control genes, passed at DeseqDataSet initialization
Fitting size factors...
... done in 0.00 seconds.

Fitting dispersions...
... done in 0.23 seconds.

Fitting dispersion trend curve...
... done in 0.02 seconds.

Fitting MAP dispersions...
... done in 0.24 seconds.

Fitting LFCs...
... done in 0.13 seconds.

Calculating cook's distance...
... done in 0.00 seconds.

Replacing 2 outlier genes.

Fitting dispersions...
... done in 0.01 seconds.

Fitting MAP dispersions...
... done in 0.01 seconds.

Fitting LFCs...
... done in 0.01 seconds.
res_df = pds2.test_contrasts(pds2.contrast(
    column="label",
    baseline="ctrl",
    group_to_compare="stim")
)
输出
Log2 fold change & Wald test p-value, contrast vector: [0. 1.]
              baseMean  log2FoldChange     lfcSE       stat        pvalue  \
index
HES4        179.827743        6.600825  0.379008  17.416074  6.230913e-68
ISG15     19252.031373        7.076825  0.420073  16.846656  1.110180e-63
SDF4         28.927758       -0.757192  0.178380  -4.244825  2.187642e-05
UBE2J2       25.529327       -0.889011  0.187880  -4.731802  2.225355e-06
AURKAIP1    115.547324       -0.572923  0.097563  -5.872361  4.296310e-09
...                ...             ...       ...        ...           ...
CSTB       1201.426144        0.864196  0.189358   4.563812  5.023307e-06
SUMO3        72.227191       -0.429374  0.109306  -3.928191  8.558717e-05
PTTG1IP      54.543949        0.213316  0.135542   1.573794  1.155351e-01
ITGB2        41.979324        1.341235  0.240249   5.582690  2.368272e-08
PRMT2        70.413437        0.566704  0.149073   3.801520  1.438112e-04

                  padj
index
HES4      2.981937e-66
ISG15     4.412494e-62
SDF4      4.560019e-05
UBE2J2    5.234160e-06
AURKAIP1  1.303344e-08
...                ...
CSTB      1.133749e-05
SUMO3     1.671123e-04
PTTG1IP   1.438820e-01
ITGB2     6.699154e-08
PRMT2     2.748470e-04

[2345 rows x 6 columns]
Running Wald tests...
... done in 0.08 seconds.
res_df.head(10)下面查看 结果表:
variable:基因名baseMean:所有样本的归一化 Count 均值log_fc:log2 倍数变化lfcSE:log2 倍数变化的标准误(standard error, SE)stat:Wald 统计量(Wald statistic)p_value:Wald 检验(Wald test)的 p 值adj_p_value:经 Benjamini–Hochberg 校正(Benjamini–Hochberg correction, BH)的 p 值
各行按 adj_p_value 排序。log_fc 的正负始终取决于所定义的基准组。正的 log_fc 表示目标组的表达高于基准组,负值则表示更低。本例中,与对照 CD14+ 单核细胞相比,刺激组中 IFITM2 的 log2 倍数变化约为 4.7;相反,VCAN 的 log2 倍数变化约为 −4.4,见下图。
接下来将结果可视化。
pds2.plot_volcano(res_df, log2fc_threshold=0)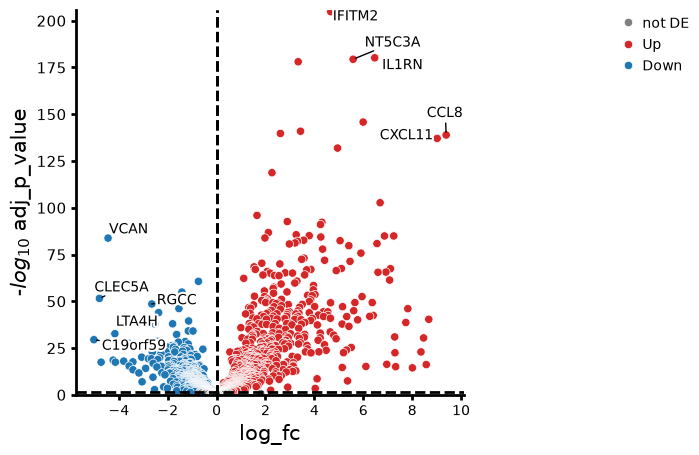
点在纵轴上越高,adj_p_value 越小;点在横轴上离 0 越远,表达变化幅度越大。因此,左上方和右上方的基因既有较大的表达变化,也有较强的统计证据支持这种差异。
还可以按不同亚组展示结果,这里按患者分别绘图。
pds2.plot_paired(
    adata_mono,
    results_df=res_df,
    n_top_vars=4,
    groupby="label",
    pairedby="replicate"
)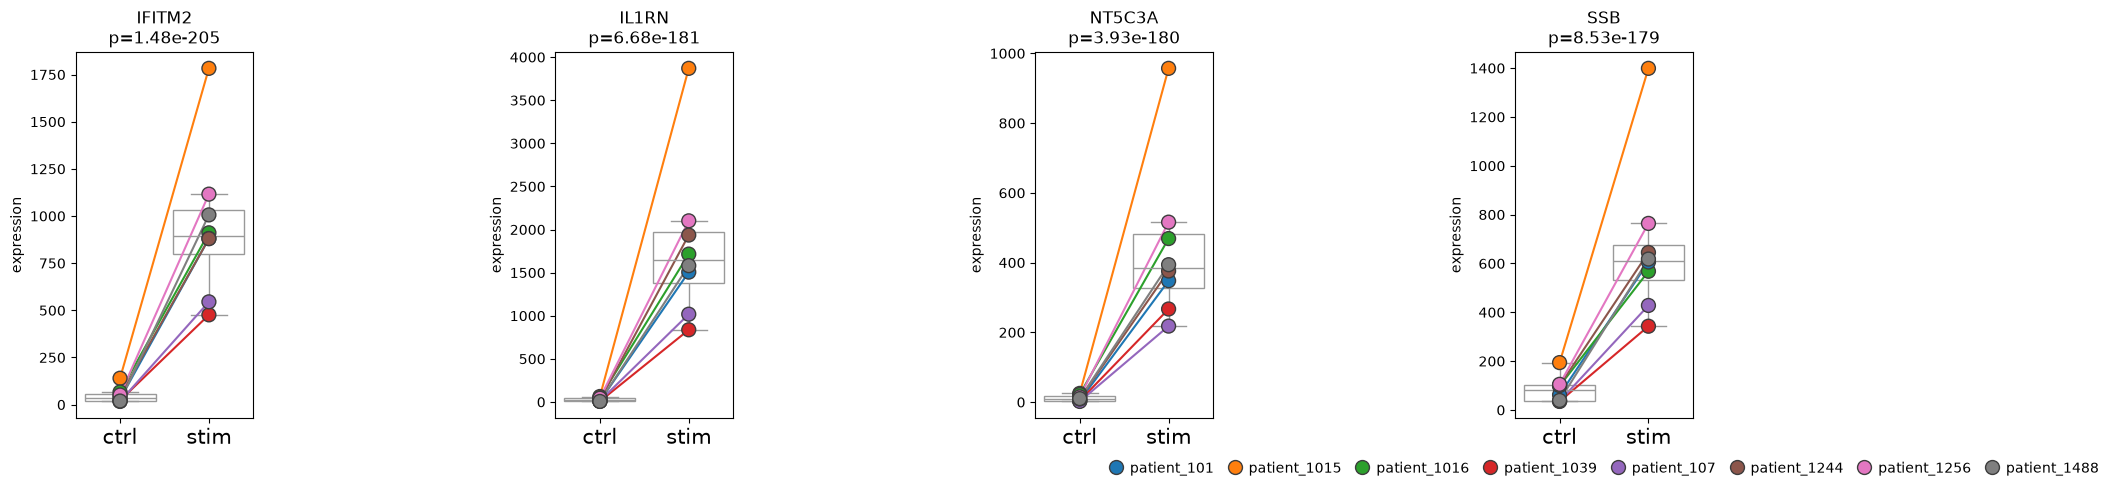
可以看到,患者 1015 的 CD14+ 单核细胞对刺激表现出较强反应。
af = ln.Artifact.from_dataframe(res_df, key="conditions/differential_gene_expression/res_df_CD14_Monocytes.parquet").save()→ returning artifact with same hash: Artifact(uid='Mem61XmLNGot02R90000', key='conditions/differential_gene_expression/res_df_CD14_Monocytes.parquet', description=None, suffix='.parquet', kind='dataset', otype='DataFrame', size=156841, hash='x4gTKODdWoEElLoMWppaBg', n_files=None, n_observations=2345, extra_data=None, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=51, schema_id=None, created_by_id=6, created_at=2026-07-28 10:01:26 UTC, is_locked=False, version_tag=None, is_latest=True); to track this artifact as an input, use: ln.Artifact.get()
分析多个细胞类型或分组
如果尚不清楚哪种细胞类型受处理影响最大,可以先对完整数据集拟合模型,再返回 本章前半部分,聚焦感兴趣的细胞类型。
以下步骤也演示如何处理包含多个分组的数据。即使已明确目标细胞类型,数据仍可能按性别、是否应答或年龄等因素分组。本节提供初步示例,展示如何在单一细胞类型内研究不同分组之间的差异。
由于 CD14+ 单核细胞子集(adata_mono)中没有特别值得探讨的亚组,我们改为同时分析多个细胞类型。这一步暂不进行特征选择(feature selection),因为不同细胞类型表达的基因集合不同,更适合分别筛选。
首先构建一个简单的 设计矩阵。
pds2 = pt.tl.PyDESeq2(adata=adata_pb, design="~ label")pds2.fit()输出
Using None as control genes, passed at DeseqDataSet initialization
Fitting size factors...
... done in 0.03 seconds.

Fitting dispersions...
... done in 1.41 seconds.

Fitting dispersion trend curve...
... done in 0.15 seconds.

Fitting MAP dispersions...
... done in 2.02 seconds.

Fitting LFCs...
... done in 1.68 seconds.

Calculating cook's distance...
... done in 0.11 seconds.

Replacing 36 outlier genes.

Fitting dispersions...
... done in 0.02 seconds.

Fitting MAP dispersions...
... done in 0.04 seconds.

Fitting LFCs...
... done in 0.02 seconds.
res_df = pds2.compare_groups(
    adata_pb,
    column="label",
    baseline="ctrl",
    groups_to_compare=["stim"]
)
输出
Fitting size factors...
... done in 0.04 seconds.
Using None as control genes, passed at DeseqDataSet initialization
Fitting dispersions...
... done in 1.71 seconds.

Fitting dispersion trend curve...
... done in 0.20 seconds.

Fitting MAP dispersions...
... done in 2.27 seconds.

Fitting LFCs...
... done in 1.82 seconds.

Calculating cook's distance...
... done in 0.08 seconds.

Replacing 36 outlier genes.

Fitting dispersions...
... done in 0.01 seconds.

Fitting MAP dispersions...
... done in 0.01 seconds.

Fitting LFCs...
... done in 0.01 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [0. 1.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        0.043299  2.310776  0.018738  0.985050
RP11-206L10.2   0.030188       -0.014207  2.115790 -0.006715  0.994642
RP11-206L10.9   0.047391        0.120755  1.838275  0.065689  0.947625
FAM87B          0.053617       -0.028965  2.603665 -0.011125  0.991124
LINC00115       0.389827       -0.221986  0.420872 -0.527442  0.597886
...                  ...             ...       ...       ...       ...
C21orf58        0.121437       -0.262831  0.920014 -0.285682  0.775122
PCNT            0.676612       -0.112711  0.333573 -0.337892  0.735445
DIP2A           1.532521       -0.289122  0.273588 -1.056781  0.290612
S100B           0.638731       -0.509243  0.795387 -0.640245  0.522013
PRMT2          24.013222        0.241891  0.132709  1.822721  0.068346

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115           NaN
...                 ...
C21orf58            NaN
PCNT           0.841589
DIP2A          0.487455
S100B          0.694474
PRMT2          0.182654

[15701 rows x 6 columns]
... done in 0.44 seconds.
pds2.plot_paired(
    adata_pb,
    results_df=res_df,
    n_top_vars=4,
    groupby="label",
    pairedby="cell_type"
)
• Performing pseudobulk for paired samples
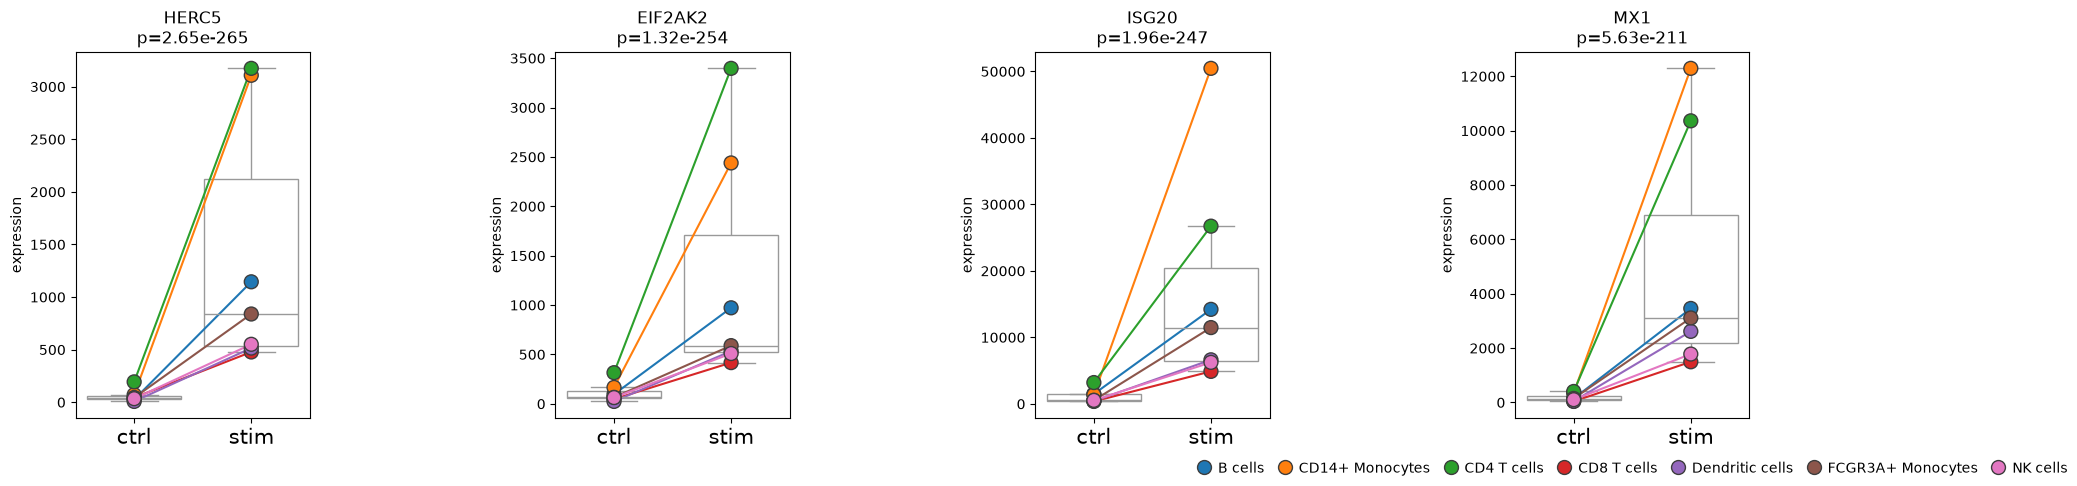
排名前四的差异表达基因在 CD14+ 单核细胞和 CD4 T 细胞中都表现出较强的表达变化。
接着检验:ctrl 和 stim 之间的表达差异,在 CD14+ 单核细胞与 CD4 T 细胞中是否不同?也就是说,刺激引起的表达变化是否依赖细胞类型?
为此,构建更复杂的 设计矩阵,再通过对比(contrast)指定要检验的条件组合。
pds2 = pt.tl.PyDESeq2(adata=adata_pb, design="~ cell_type * label")pds2.fit()输出
Fitting size factors...
... done in 0.03 seconds.
Using None as control genes, passed at DeseqDataSet initialization
Fitting dispersions...
... done in 3.58 seconds.

Fitting dispersion trend curve...
... done in 0.21 seconds.

Fitting MAP dispersions...
... done in 3.44 seconds.

Fitting LFCs...
... done in 2.55 seconds.

Calculating cook's distance...
... done in 0.05 seconds.

Replacing 3 outlier genes.

Fitting dispersions...
... done in 0.01 seconds.

Fitting MAP dispersions...
... done in 0.01 seconds.

Fitting LFCs...
... done in 0.01 seconds.
interaction_contrast = (
    pds2.cond(cell_type="CD14+ Monocytes", label="stim") -
    pds2.cond(cell_type="CD14+ Monocytes", label="ctrl")
) - (
    pds2.cond(cell_type="CD4 T cells", label="stim") -
    pds2.cond(cell_type="CD4 T cells", label="ctrl")
)

res_df = pds2.test_contrasts(interaction_contrast)
输出
Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0.  0.  0.  0.  0.  0.  0.  0.  1. -1.  0.  0.  0.  0.]
                baseMean  log2FoldChange      lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        1.740385  10.956334  0.158847  0.873789
RP11-206L10.2   0.030188       -0.208432  10.939235 -0.019054  0.984798
RP11-206L10.9   0.047391        0.917190  10.951037  0.083754  0.933252
FAM87B          0.053617        0.882214  10.986500  0.080300  0.935999
LINC00115       0.389827        0.455551   1.374820  0.331353  0.740378
...                  ...             ...        ...       ...       ...
C21orf58        0.121437        0.744942   4.379467  0.170099  0.864932
PCNT            0.676612       -0.612964   1.089164 -0.562784  0.573582
DIP2A           1.532521       -0.203075   0.684943 -0.296484  0.766861
S100B           0.638731        0.746339   2.759453  0.270466  0.786802
PRMT2          24.013222        0.705998   0.293153  2.408295  0.016027

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115           NaN
...                 ...
C21orf58            NaN
PCNT                NaN
DIP2A          0.898603
S100B               NaN
PRMT2          0.079216

[15701 rows x 6 columns]
... done in 0.49 seconds.
pds2.plot_volcano(res_df, log2fc_thresh=0)/var/folders/dy/0ztxj7hd3h3cz5ghg9zsd3bh0000gn/T/ipykernel_9010/2542205832.py:1: FutureWarning: The argument log2fc_thresh is deprecated and will be removed in the future. Use `log2fc_threshold`.
pds2.plot_volcano(res_df, log2fc_thresh=0)
NaNs encountered, dropping rows with NaNs
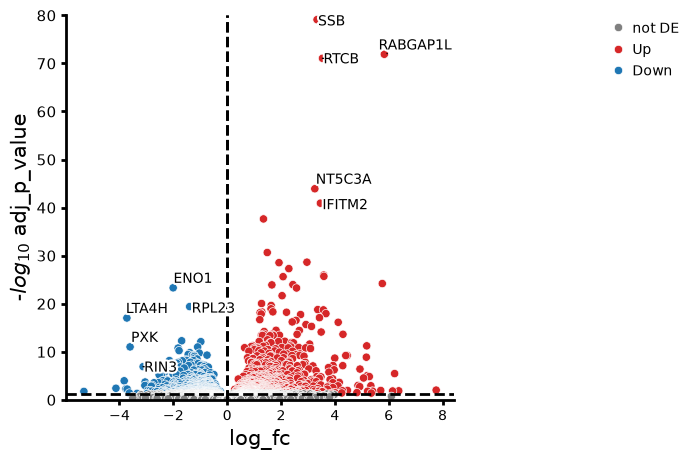
部分基因的表达变化在两类细胞之间存在明显差异。例如,RABGAP1L 在 CD14+ 单核细胞中的表达变化高于 CD4 T 细胞,而 ENO1 的变化则更低。
也可以绘制排名靠前的差异表达基因的倍数变化,但仅纳入通过指定显著性阈值 α 的结果,例如 α = 0.01。
pds2.plot_fold_change(res_df[res_df["adj_p_value"] < 0.01].copy(), n_top_vars=15)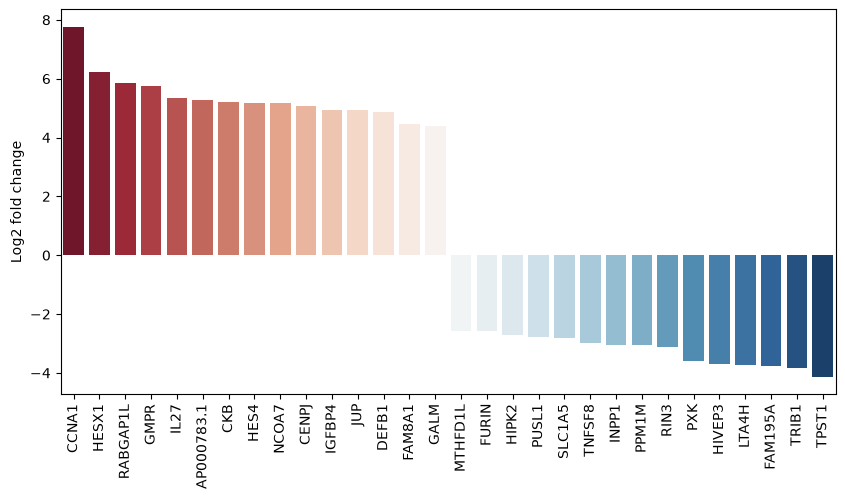
最后,还可以同时绘制多个比较。这里将 CD14+ 单核细胞分别与其他细胞类型比较,结果应大致反映细胞注释时使用的标记基因(marker gene)。这主要用于演示分析功能;实际研究中,应替换为感兴趣的分组,例如性别、是否应答或年龄组。
res_df = pds2.compare_groups(adata_pb,
    column="cell_type",
    baseline="CD14+ Monocytes",
    groups_to_compare=list(set(adata_pb.obs["cell_type"].unique()) - {"CD14+ Monocytes"})
)
输出
Fitting size factors...
... done in 0.03 seconds.
Using None as control genes, passed at DeseqDataSet initialization
Fitting dispersions...
... done in 1.92 seconds.

Fitting dispersion trend curve...
... done in 0.20 seconds.

Fitting MAP dispersions...
... done in 2.45 seconds.

Fitting LFCs...
... done in 1.86 seconds.

Calculating cook's distance...
... done in 0.05 seconds.

Replacing 6 outlier genes.

Fitting dispersions...
... done in 0.01 seconds.

Fitting MAP dispersions...
... done in 0.01 seconds.

Fitting LFCs...
... done in 0.01 seconds.

Running Wald tests...
... done in 0.44 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  0.  0.  0.  1.  0.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        2.151508  5.502361  0.391015  0.695786
RP11-206L10.2   0.030188        1.959356  5.400545  0.362807  0.716749
RP11-206L10.9   0.047391        1.959338  4.454816  0.439825  0.660064
FAM87B          0.053617        2.295035  5.477388  0.419002  0.675215
LINC00115       0.389827        1.067380  0.763056  1.398823  0.161866
...                  ...             ...       ...       ...       ...
C21orf58        0.121437        1.637420  1.891524  0.865662  0.386675
PCNT            0.676612        2.224298  0.612325  3.632546  0.000281
DIP2A           1.532521       -0.492096  0.514316 -0.956796  0.338670
S100B           0.638731        1.730428  1.455929  1.188539  0.234621
PRMT2          24.013222        0.148906  0.172725  0.862102  0.388632

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115      0.343732
...                 ...
C21orf58            NaN
PCNT           0.002758
DIP2A          0.541026
S100B          0.432238
PRMT2          0.590751

[15701 rows x 6 columns]
... done in 0.47 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  1.  0.  0.  0.  0.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        0.161952  5.470482  0.029605  0.976382
RP11-206L10.2   0.030188       -0.246900  5.375897 -0.045927  0.963368
RP11-206L10.9   0.047391       -0.389012  4.432479 -0.087764  0.930064
FAM87B          0.053617       -0.768141  5.492885 -0.139843  0.888784
LINC00115       0.389827        0.908217  0.612293  1.483305  0.137993
...                  ...             ...       ...       ...       ...
C21orf58        0.121437        1.199311  1.736388  0.690693  0.489759
PCNT            0.676612        1.931798  0.502570  3.843835  0.000121
DIP2A           1.532521        0.735263  0.325135  2.261409  0.023734
S100B           0.638731        4.501091  1.235405  3.643412  0.000269
PRMT2          24.013222        0.239543  0.153839  1.557103  0.119446

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115      0.181667
...                 ...
C21orf58            NaN
PCNT           0.000267
DIP2A          0.036822
S100B          0.000566
PRMT2          0.159545

[15701 rows x 6 columns]
... done in 0.53 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  0.  0.  0.  0.  1.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        2.474859  5.503200  0.449713  0.652918
RP11-206L10.2   0.030188        2.282718  5.401389  0.422617  0.672575
RP11-206L10.9   0.047391        2.677699  4.433057  0.604030  0.545824
FAM87B          0.053617        2.282707  5.494428  0.415459  0.677806
LINC00115       0.389827        1.199922  0.788086  1.522576  0.127865
...                  ...             ...       ...       ...       ...
C21orf58        0.121437        2.515586  1.834763  1.371069  0.170353
PCNT            0.676612        2.175944  0.651016  3.342384  0.000831
DIP2A           1.532521        1.044960  0.414023  2.523918  0.011606
S100B           0.638731        3.882751  1.306370  2.972168  0.002957
PRMT2          24.013222        0.373729  0.174184  2.145598  0.031905

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115      0.190911
...                 ...
C21orf58            NaN
PCNT           0.002286
DIP2A          0.024516
S100B          0.007275
PRMT2          0.058900

[15701 rows x 6 columns]
... done in 0.45 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  0.  1.  0.  0.  0.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        3.396434  5.696649  0.596216  0.551031
RP11-206L10.2   0.030188        3.074759  5.599790  0.549085  0.582947
RP11-206L10.9   0.047391        3.140181  4.616491  0.680210  0.496372
FAM87B          0.053617        3.074880  5.696030  0.539829  0.589315
LINC00115       0.389827        1.314403  0.839342  1.565992  0.117351
...                  ...             ...       ...       ...       ...
C21orf58        0.121437        2.718599  1.954670  1.390823  0.164279
PCNT            0.676612        2.018859  0.690688  2.922968  0.003467
DIP2A           1.532521        1.157852  0.443806  2.608917  0.009083
S100B           0.638731        3.976854  1.383560  2.874364  0.004048
PRMT2          24.013222       -0.180823  0.202844 -0.891434  0.372696

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115      0.179558
...                 ...
C21orf58       0.234673
PCNT           0.009134
DIP2A          0.021086
S100B          0.010424
PRMT2          0.456279

[15701 rows x 6 columns]
... done in 0.50 seconds.

Running Wald tests...
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  0.  0.  1.  0.  0.]
                baseMean  log2FoldChange     lfcSE      stat    pvalue  \
index
AL627309.1      0.010607        2.368673  5.495653  0.431009  0.666462
RP11-206L10.2   0.030188        2.356868  5.385137  0.437662  0.661632
RP11-206L10.9   0.047391        2.176679  4.447242  0.489445  0.624527
FAM87B          0.053617        2.176522  5.486869  0.396678  0.691605
LINC00115       0.389827        0.574520  0.876521  0.655454  0.512175
...                  ...             ...       ...       ...       ...
C21orf58        0.121437        2.037958  1.867656  1.091185  0.275192
PCNT            0.676612        1.752980  0.702328  2.495958  0.012562
DIP2A           1.532521       -0.969059  0.628585 -1.541651  0.123158
S100B           0.638731        1.797302  1.482714  1.212170  0.225447
PRMT2          24.013222       -0.333650  0.184535 -1.808052  0.070598

                   padj
index
AL627309.1          NaN
RP11-206L10.2       NaN
RP11-206L10.9       NaN
FAM87B              NaN
LINC00115      0.660674
...                 ...
C21orf58            NaN
PCNT           0.046558
DIP2A          0.255190
S100B          0.385549
PRMT2          0.172537

[15701 rows x 6 columns]
Log2 fold change & Wald test p-value, contrast vector: [ 0. -1.  0.  0.  0.  0.  0.]
                baseMean  log2FoldChange     lfcSE      stat        pvalue  \
index
AL627309.1      0.010607        1.472575  5.504369  0.267528  7.890624e-01
RP11-206L10.2   0.030188        1.492242  5.391594  0.276772  7.819552e-01
RP11-206L10.9   0.047391        1.491757  4.444019  0.335677  7.371141e-01
FAM87B          0.053617        1.492273  5.484781  0.272075  7.855642e-01
LINC00115       0.389827       -0.002214  0.804918 -0.002751  9.978054e-01
...                  ...             ...       ...       ...           ...
C21orf58        0.121437        1.376525  1.846643  0.745420  4.560177e-01
PCNT            0.676612        0.990738  0.660558  1.499851  1.336531e-01
DIP2A           1.532521       -0.665660  0.460780 -1.444638  1.485596e-01
S100B           0.638731        1.090877  1.448696  0.753006  4.514461e-01
PRMT2          24.013222       -1.228460  0.183585 -6.691519  2.208651e-11

                       padj
index
AL627309.1              NaN
RP11-206L10.2           NaN
RP11-206L10.9           NaN
FAM87B                  NaN
LINC00115      9.984005e-01
...                     ...
C21orf58                NaN
PCNT           1.999094e-01
DIP2A          2.184766e-01
S100B          5.456290e-01
PRMT2          1.420383e-10

[15701 rows x 6 columns]
... done in 0.52 seconds.
pds2.plot_multicomparison_fc(res_df, n_top_vars=5, figsize=(12, 1.5))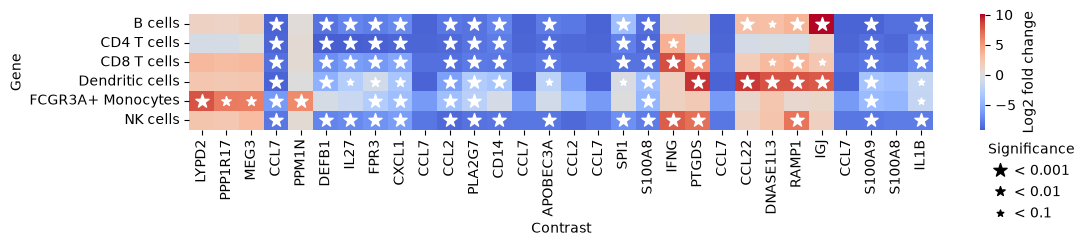
下图展示其他所有细胞类型相对于 CD14+ 单核细胞的差异表达基因。例如,CLL2 和 CCL7 在其他所有细胞类型中的表达均显著低于 CD14+ 单核细胞。
问题
翻转卡
选择题
- Robinson, M. D., McCarthy, D. J., & Smyth, G. K. (2010). edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics (Oxford, England), 26(1), 139–140. 10.1093/bioinformatics/btp616
- Love, M. I., Huber, W., & Anders, S. (2014). Moderated estimation of fold change and dispersion for term`RNA`-seq data with DESeq2. Genome Biology, 15(12), 550. 10.1186/s13059-014-0550-8
- Finak, G., McDavid, A., Yajima, M., Deng, J., Gersuk, V., Shalek, A. K., Slichter, C. K., Miller, H. W., McElrath, M. J., Prlic, M., Linsley, P. S., & Gottardo, R. (2015). MAST: a flexible statistical framework for assessing transcriptional changes and characterizing heterogeneity in single-cell term`RNA` sequencing data. Genome Biology, 16(1), 278. 10.1186/s13059-015-0844-5
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB Balances Speed and Flexibility Among Packages for Zero-inflated Generalized Linear Mixed Modeling. The R Journal, 9(2), 378–400. 10.32614/RJ-2017-066
- Wang, T., Li, B., Nelson, C. E., & Nabavi, S. (2019). Comparative analysis of differential gene expression analysis tools for single-cell term`RNA` sequencing data. BMC Bioinformatics, 20(1), 40. 10.1186/s12859-019-2599-6
- Das, S., Rai, A., Merchant, M. L., Cave, M. C., & Rai, S. N. (2021). A comprehensive survey of statistical approaches for differential Expression analysis in single-cell term`RNA` sequencing studies. Genes (Basel), 12(12), 1947.
- Hicks, S. C., Townes, F. W., Teng, M., & Irizarry, R. A. (2017). Missing data and technical variability in single-cell term`RNA`-sequencing experiments. Biostatistics, 19(4), 562–578. 10.1093/biostatistics/kxx053
- Vallejos, C. A., Risso, D., Scialdone, A., Dudoit, S., & Marioni, J. C. (2017). Normalizing single-cell term`RNA` sequencing data: challenges and opportunities. Nature Methods, 14(6), 565–571. 10.1038/nmeth.4292
- Luecken, M. D., & Theis, F. J. (2019). Current best practices in single-cell term`RNA`-seq analysis: a tutorial. Molecular Systems Biology, 15(6), e8746. https://doi.org/10.15252/msb.20188746
- Soneson, C., & Robinson, M. D. (2018). Bias, robustness and scalability in single-cell differential expression analysis. Nature Methods, 15(4), 255–261. 10.1038/nmeth.4612
- Jaakkola, M. K., Seyeterm`DNA`srollah, F., Mehmood, A., & Elo, L. L. (2016). Comparison of methods to detect differentially expressed genes between single-cell populations. Briefings in Bioinformatics, 18(5), 735–743. 10.1093/bib/bbw057
- Squair, J. W., Gautier, M., Kathe, C., Anderson, M. A., James, N. D., Hutson, T. H., Hudelle, R., Qaiser, T., Matson, K. J. E., Barraud, Q., Levine, A. J., La Manno, G., Skinnider, M. A., & Courtine, G. (2021). Confronting false discoveries in single-cell differential expression. Nature Communications, 12(1), 5692. 10.1038/s41467-021-25960-2
- Zimmerman, K. D., Espeland, M. A., & Langefeld, C. D. (2021). A practical solution to pseudoreplication bias in single-cell studies. Nature Communications, 12(1), 738. 10.1038/s41467-021-21038-1
- Junttila, S., Smolander, J., & Elo, L. L. (2022). Benchmarking methods for detecting differential states between conditions from multi-subject single-cell term`RNA`-seq data. bioRxiv. 10.1101/2022.02.16.480662
- Ritchie, M. E., Phipson, B., Wu, D., Hu, Y., Law, C. W., Shi, W., & Smyth, G. K. (2015). limma powers differential expression analyses for term`RNA`-sequencing and microarray studies. Nucleic Acids Research, 43(7), e47–e47. 10.1093/nar/gkv007