🧠 关键要点
应用 Augur 前,应能可靠标注细胞类型。结合差异丰度(Differential Abundance, DA)检验排查潜在混杂因素,并通过差异基因表达(Differential Gene Expression, DGE)分析探索扰动(perturbation)在基因层面的影响。
使用 scGen 等工具预测扰动响应时,高表达基因通常预测得较好,低表达基因则更具挑战。
Mixscape 流程中的线性判别分析(Linear Discriminant Analysis, LDA)主要用于辅助可视化。统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)图中的距离需要谨慎解读,不能仅凭图形位置判断不同敲除扰动的相似性与差异。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: perturbation_modeling
channels:
  - defaults
  - conda-forge
dependencies:
  - conda-forge::python=3.13.11
  - conda-forge::pertpy=1.0.4
研究动机
单细胞实验技术的进步,使研究者能够在大规模多重实验中测量数十万个细胞,并同时考察数千种条件。这些外部条件引起的暂时或持久变化通常称为扰动(perturbation)Srivatsan et al., 2020。近年来,这类技术已用于测量基于成簇规律间隔短回文重复序列(Clustered Regularly Interspaced Short Palindromic Repeats, CRISPR)与 Cas9 核酸酶的扰动,并获取多模态读出 Papalexi et al., 2021Frangieh et al., 2021,也用于全基因组范围的扰动 Replogle et al., 2021 和组合扰动 Wessels et al., 2022。尽管实验技术不断进步,基因组合敲除或药物组合所形成的庞大条件空间仍难以穷尽。这推动了利用计算方法对单细胞扰动响应进行建模 Ji et al., 2021。
扰动建模涉及以下方面 Ji et al., 2021:
扰动响应:根据对照和处理条件的信息,预测扰动后的组学特征(feature)。可用预测 feature 与实测值的相关性评估结果。还可以预测半数抑制浓度(Half-Maximal Inhibitory Concentration, IC50)、剂量–响应曲线下面积(area under the curve, AUC)、毒性和细胞存活率等表型指标。
靶点与机制:利用组学测量预测扰动靶点与作用机制,包括为尚未充分表征的化合物推断药物作用方式。
扰动间的相互作用:预测组合扰动的效应,以理解遗传因素与药物、或不同药物之间的相互作用。
化学性质:利用组学测量预测扰动物的分子指纹、R 基团、药效团等化学性质或结构表示,乃至完整化合物。
覆盖上述各类任务的稳健、易用工具仍在发展中。下面仅介绍三种方法,分别演示单细胞扰动数据可以解决的部分问题:
识别受扰动影响最大的细胞类型:将 Augur 应用于 Kang 2018 数据 Kang et al., 2018。
预测单细胞的转录响应:将 scGen 应用于 Kang 2018 数据 Kang et al., 2018。
评估细胞对 CRISPR 遗传扰动的响应:将 Mixscape 应用于 Papalexi 2021 数据 Papalexi et al., 2021。
识别受扰动影响最大的细胞类型
研究动机
扰动对不同细胞的影响通常并不相同;细胞类型或细胞周期状态不同,响应程度也可能不同。这里使用 Augur,这一方法由 Skinnider 等人提出 Skinnider et al., 2021Squair et al., 2021,可量化细胞类型层面的响应。
Augur 的局限
Augur 依赖明确的细胞类型或分组。若细胞分化等连续过程使类型边界难以划定,其排序可能无法反映足够细致的响应差异。可以构建描述不同聚类(clustering)关系的聚类树,并在多个分辨率下运行 Augur,评估哪种粒度更适合研究当前扰动 Squair et al., 2021。
同一种细胞类型内部,也可能同时包含有响应和无响应的细胞;响应强度还可能沿连续轨迹变化,因此把细胞硬分成两类并不总是准确。Augur 不解析每个细胞的独立响应,而是汇总同一细胞类型的预测性能,给出类型层面的平均分数 Squair et al., 2021。
有些扰动主要改变细胞类型的相对丰度。Augur 在交叉验证前从每种条件中抽取相同数量的细胞,因此不会保留相对丰度信息。丰度变化可能伴随细胞内在转录状态的变化;强扰动还可能使某种细胞类型消失,或使其仅在处理后出现。因此,建议结合各细胞类型的差异丰度(Differential Abundance, DA)检验,为 Augur 的结果提供背景 Squair et al., 2021。
按 IFN-β 刺激响应对细胞类型排序
为演示 Augur,我们使用 Kang 数据集:研究者采集了 8 位狼疮患者的外周血单个核细胞(Peripheral Blood Mononuclear Cell, PBMC),将每位供体的细胞分别置于未刺激条件和干扰素 β(interferon beta, IFN-β)刺激 6 小时的条件下,共获得 16 个样本,并采用 10x 液滴平台进行单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)Kang et al., 2018。
这里的目标是识别对 IFN-β 刺激响应最明显的细胞类型。
首先导入 pertpy 和 Scanpy。
import warnings

warnings.filterwarnings("ignore")
warnings.simplefilter("ignore")

# This is required to catch warnings when the multiprocessing module is used
import os

os.environ["PYTHONWARNINGS"] = "ignore"
import pertpy as pt
import scanpy as scpertpy 提供了便于加载 Kang 数据集的函数。
adata = pt.dt.kang_2018()为便于阅读,将 label 重命名为 condition,并调整条件标签的名称。
adata.obs.rename({"label": "condition"}, axis=1, inplace=True)
adata.obs["condition"].replace({"ctrl": "control", "stim": "stimulated"}, inplace=True)该数据集中的 PBMC 来自 Kang et al., 2018,共包含七种细胞类型。
adata.obs.cell_type.value_counts()cell_type
CD4 T cells 11238
CD14+ Monocytes 5697
B cells 2651
NK cells 1716
CD8 T cells 1621
FCGR3A+ Monocytes 1089
Dendritic cells 529
Megakaryocytes 132
Name: count, dtype: int64接下来在 pertpy 中创建 Augur 对象,选择估计器来预测每种细胞类型内部的扰动标签。类别型标签可使用 random_forest_classifier 或 logistic_regression_classifier;数值型标签可使用 random_forest_regressor。这些估计器都通过 Params 类设置其他参数。本例选择 random_forest_classifier,它适合当前的类别型标签,通常也能兼顾运行速度和预测性能。
ag_rfc = pt.tl.Augur("random_forest_classifier")接下来调用 Augur 对象的 load 方法,将 AnnData 数据整理为 Augur 所需的格式。
loaded_data = ag_rfc.load(adata, label_col="condition", cell_type_col="cell_type")
loaded_dataAnnData object with n_obs × n_vars = 24673 × 15706
obs: 'nCount_RNA', 'nFeature_RNA', 'tsne1', 'tsne2', 'label', 'cluster', 'cell_type', 'replicate', 'nCount_SCT', 'nFeature_SCT', 'integrated_snn_res.0.4', 'seurat_clusters', 'y_'
var: 'name'
obsm: 'X_pca', 'X_umap'随后即可通过 predict 方法运行 Augur。这里可选择两种 feature 筛选方式:
采用原始 Augur 的方差筛选策略(原文记为
select_variance_feature=True;下方实际 API 参数为 select_variance_features=True),也是默认方式。它会移除同一细胞类型内部变异较小的 feature。详细方法见 Augur 的 Nature Protocols 论文 Squair et al., 2021。采用这一策略时,结果与 R 版 Augur 较为接近。基于
scanpy.pp.highly_variable_genes筛选高变基因(Highly Variable Gene, HVG)。这种方式减少了参与训练的基因数,但预先选择高变基因可能使 Augur 分数偏高,因此不同筛选方式的分数不宜直接比较。它运行更快,适合探索规模很大、且预期特定细胞类型会产生强响应的数据。
本例采用原始 Augur 的方差筛选策略,并将 subsample_size 设为 20,即每次从每种细胞类型的每个实验条件中分别随机抽取 20 个细胞。这里固定该设置便于比较;在本章环境所用的 pertpy 1.0.4 中,20 也是默认值。
v_adata, v_results = ag_rfc.predict(
loaded_data, subsample_size=20, n_threads=4, select_variance_features=True, span=1
)
v_results["summary_metrics"]输出
结果表包含多个模型评估指标。解读 IFN-β 响应排序时,主要查看 mean_augur_score,在本例分类任务中它对应 mean_auc。值越高,表明模型越容易区分该细胞类型中的对照与受扰动状态,提示其转录响应更明显。下面将结果可视化。
lollipop = ag_rfc.plot_lollipop(v_results)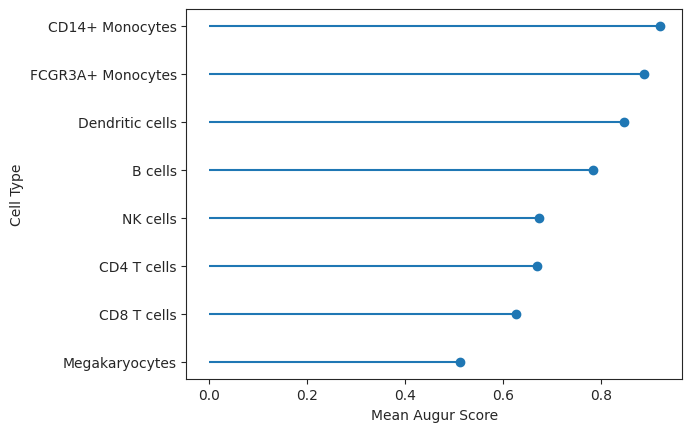
本例中,CD14+ 单核细胞的 IFN-β 响应最明显,巨核细胞最弱。这与原始研究中各细胞类型的 差异表达基因(Differentially Expressed Gene, DEG) 数量大致一致 Kang et al., 2018。
结果表中的 mean_augur_score 还会按细胞所属类型写入 v_adata.obs 的 augur_score 列,可在统一流形逼近与投影(Uniform Manifold Approximation and Projection, UMAP)图上着色展示。同一类型的细胞共享该分数,因此图中颜色不能用于区分该类型内部的响应强弱。
sc.pp.neighbors(v_adata)
sc.tl.umap(v_adata)sc.pl.umap(adata=v_adata, color=["augur_score", "cell_type", "label"])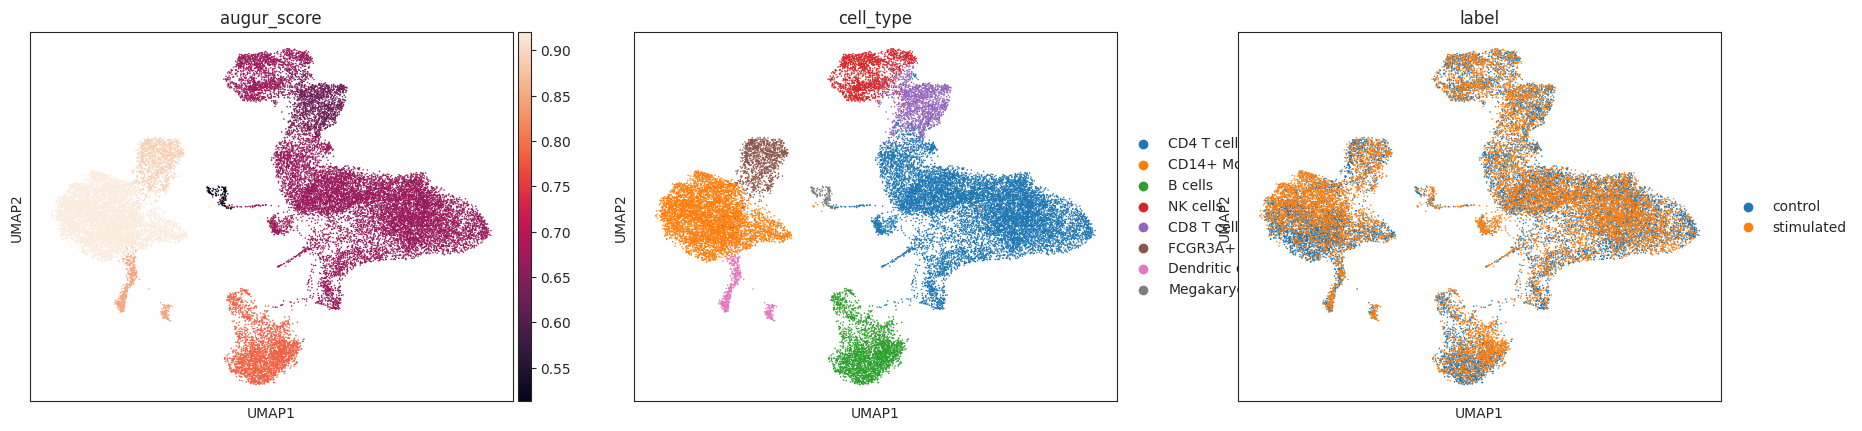
探索对排序贡献最大的基因
模型的 feature 重要性反映各基因对条件预测的贡献,可帮助探索细胞类型排序的依据。这些值保存在结果对象中,可直接绘图;它们本身不是基因层面的统计显著性。
important_features = ag_rfc.plot_important_features(v_results)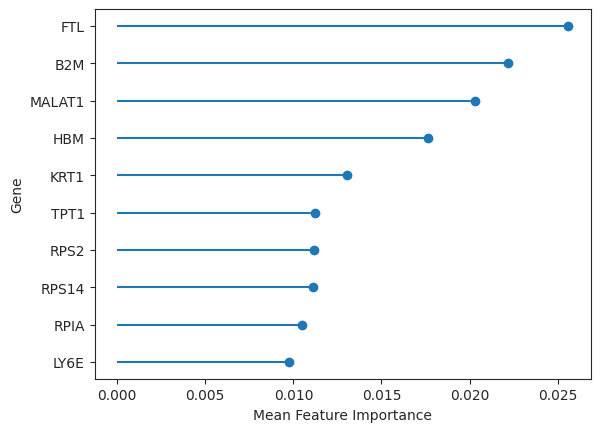
可以进一步考察这些基因涉及的通路或基因集。不过,Augur 的推断单位是细胞类型,并不直接检验单个基因是否响应扰动。Augur 作者也建议:若问题聚焦于单基因,应采用差异基因表达(Differential Gene Expression, DGE)检验,这在概念和实际操作上都更合适 Squair et al., 2021。
差异优先级分析
Augur 还支持差异优先级分析(differential prioritization):通过置换检验(permutation test),识别两次细胞类型排序中 AUC 差异具有统计显著性的细胞类型。例如,先分别比较药物 A 与未处理对照、药物 B 与同一对照,再比较这两次分析的 AUC。它比较的是相对共同参考条件的可分性差异。
Bhattacherjee 等人让小鼠摄入可卡因,并在停药后 48 小时和 15 天采集前额叶皮层样本进行 scRNA-seq 测量 Bhattacherjee et al., 2019。
下面评估 withdraw_15d_Cocaine 和 withdraw_48h_Cocaine 两种停药条件相对于共同参考条件 Maintenance_Cocaine 的效应。差异优先级分析通过 置换检验,将两次细胞类型排序间观测到的 AUC 差异,与随机置换条件标签后得到的差异分布比较 Squair et al., 2021。具体来说,先分别将停药 15 天(withdraw_15d_Cocaine)和停药 48 小时(withdraw_48h_Cocaine)与持续用药参考组比较,得到每种细胞类型的两个 AUC,再计算二者之差。随后置换条件标签并重复分析,构建各细胞类型 AUC 差异的经验零分布,由此计算置换检验 p 值。这能识别响应排序发生显著变化的细胞类型,并说明在哪种条件下,其转录状态与共同参考组更容易区分。
每组比较都分别使用 default 模式和 permute 模式运行,以便开展 置换检验。首先用 pertpy 加载 bhattacherjee 数据集,并创建一个使用随机森林(random forest)分类器的 Augur 对象。
bhattacherjee_adata = pt.dt.bhattacherjee()
ag_rfc = pt.tl.Augur("random_forest_classifier")接下来针对 Maintenance_Cocaine 和 withdraw_15d_Cocaine 这组比较,分别以 augur_mode=default 和 augur_mode=permute 两种模式运行 Augur。下方先对表达矩阵进行 log1p 变换;这一步本身并不执行每个细胞的总量归一化。
sc.pp.log1p(bhattacherjee_adata)# Default mode
bhattacherjee_15 = ag_rfc.load(
bhattacherjee_adata,
condition_label="Maintenance_Cocaine",
treatment_label="withdraw_15d_Cocaine",
)
bhattacherjee_adata_15, bhattacherjee_results_15 = ag_rfc.predict(
bhattacherjee_15, random_state=None, n_threads=4
)
bhattacherjee_results_15["summary_metrics"].loc["mean_augur_score"].sort_values(
ascending=False
)Oligo 0.801417
Astro 0.769116
Microglia 0.743707
OPC 0.743605
Inhibitory 0.656202
NF Oligo 0.625692
Excitatory 0.623923
Endo 0.588481
Name: mean_augur_score, dtype: float64# Permute mode
bhattacherjee_adata_15_permute, bhattacherjee_results_15_permute = ag_rfc.predict(
bhattacherjee_15,
augur_mode="permute",
n_subsamples=100,
random_state=None,
n_threads=4,
)同样比较 Maintenance_Cocaine 和 withdraw_48h_Cocaine。
# Default mode
bhattacherjee_48 = ag_rfc.load(
bhattacherjee_adata,
condition_label="Maintenance_Cocaine",
treatment_label="withdraw_48h_Cocaine",
)
bhattacherjee_adata_48, bhattacherjee_results_48 = ag_rfc.predict(
bhattacherjee_48, random_state=None, n_threads=4
)
bhattacherjee_results_48["summary_metrics"].loc["mean_augur_score"].sort_values(
ascending=False
)Astro 0.624898
OPC 0.598050
NF Oligo 0.592619
Microglia 0.587789
Inhibitory 0.560000
Oligo 0.557630
Endo 0.540272
Excitatory 0.527143
Name: mean_augur_score, dtype: float64# Permute mode
bhattacherjee_adata_48_permute, bhattacherjee_results_48_permute = ag_rfc.predict(
bhattacherjee_48,
augur_mode="permute",
n_subsamples=100,
random_state=None,
n_threads=4,
)在散点图中对照两次运行的 Augur 分数。对角线表示两次分数相等;点偏离该线的程度反映相对于共同参考条件的可分性差异。
scatter = ag_rfc.plot_scatterplot(bhattacherjee_results_15, bhattacherjee_results_48)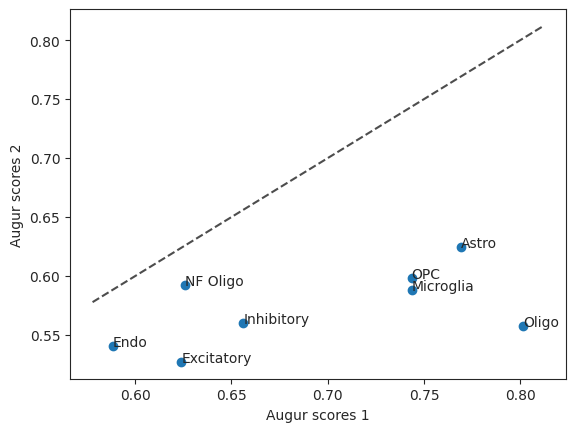
通过差异优先级分析,可以检验 withdraw_48h_Cocaine 和 withdraw_15d_Cocaine 相对于共同参考组的响应排序是否存在差异,并识别差异显著的细胞类型。
pvals = ag_rfc.predict_differential_prioritization(
augur_results1=bhattacherjee_results_15,
augur_results2=bhattacherjee_results_48,
permuted_results1=bhattacherjee_results_15_permute,
permuted_results2=bhattacherjee_results_48_permute,
)
pvalsp 值沿用 R 版 Augur 的计算方式,使用 b(置换后的差异超过观测差异的次数)和 m(置换总次数)。本例中,除小胶质细胞外,其余细胞类型的 b 相同,因此在相同置换次数下得到相同的 p 值。
diff = ag_rfc.plot_dp_scatter(pvals)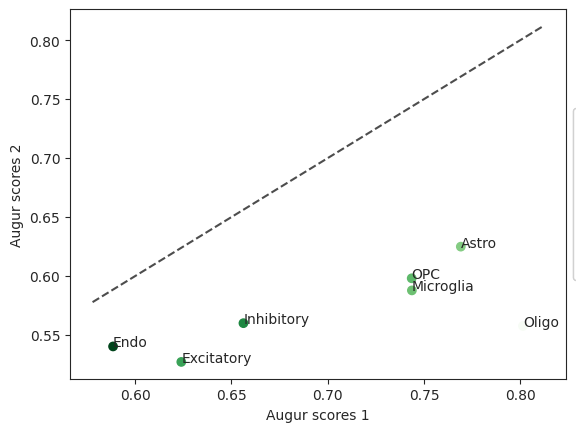
本例中,抑制性神经元(Inhibitory)在两个停药时间点的 AUC 差异较小。这可能提示其相对持续用药状态的转录差异在两个时间点相近,但不能据此断定存在永久性损伤;是否持续受损还需要独立的功能与时间序列证据。
预测 CD4 T 细胞的 IFN-β 响应
许多扰动响应模型旨在预测尚未测量的细胞群体对药物、基因敲除或疾病等刺激的转录响应,从而辅助实验设计和假设提出。缺失某些受扰动群体的原因可能是实验或样本失败(如细胞分选失败)、成本限制,或目标细胞类型过于稀少。对这些缺失群体进行计算预测,可以为是否开展后续实验提供参考。
多种扰动响应模型基于自编码器(Autoencoder, AE)Lotfollahi et al., 2019Lotfollahi et al., 2020Lotfollahi et al., 2021Russkikh et al., 2020Yuan et al., 2021Amodio et al., 2018Wei et al., 2022,这是一类用于学习数据低维表示的深度学习架构。
这里演示 scGen Lotfollahi et al., 2019,它将 VAE 与向量运算结合:先学习潜在表示,再估计对照与受扰动细胞之间的平均差异向量,将其加到目标群体中对照细胞的潜在表示上,最后解码得到预测表达。本例留出受 IFN-β 刺激的 CD4 T 细胞用于评估,训练时仍保留对照条件下的 CD4 T 细胞,以模拟未测得目标细胞类型刺激响应的情形。我们继续使用同一批 8 位狼疮患者的 PBMC 数据,每位供体均有未刺激和 IFN-β 刺激样本,数据来自 Kang et al., 2018,共包含七种细胞类型。
这里使用 scanpy 和 scgen 的相关功能来处理 AnnData 数据并建立扰动模型;下方代码实际通过 pertpy 的 SCGEN 实现调用 scGen。
import pertpy as pt
import scanpy as sc为 scGen 准备 Kang 数据
我们仍用 pertpy 加载 Kang 数据集。
adata = pt.dt.kang_2018()scGen 通常使用经过对数变换的表达数据。筛选 HVG 可缩小 feature 空间、加快计算;不过下方代码只计算高变标记,并未通过 subset=True 或矩阵取子集实际减少基因数。
sc.pp.log1p(adata)
sc.pp.highly_variable_genes(adata)为便于阅读,将 label 重命名为 condition,并调整条件标签的名称。
adata.obs.rename({"label": "condition"}, axis=1, inplace=True)
adata.obs["condition"].replace({"ctrl": "control", "stim": "stimulated"}, inplace=True)
该数据集中的 PBMC 来自 Kang et al., 2018,共包含七种细胞类型。
adata.obs.cell_type.value_counts()cell_type
CD4 T cells 11238
CD14+ Monocytes 5697
B cells 2651
NK cells 1716
CD8 T cells 1621
FCGR3A+ Monocytes 1089
Dendritic cells 529
Megakaryocytes 132
Name: count, dtype: int64从训练数据中移除所有受刺激的 CD4 T 细胞,生成 adata_t,同时保留对照 CD4 T 细胞。被留出的受刺激细胞用于后续评估,以模拟实验中未测得某一细胞类型在处理条件下响应的情形。
adata_t = adata[
~(
(adata.obs["cell_type"] == "CD4 T cells")
& (adata.obs["condition"] == "stimulated")
)
].copy()
cd4t_stim = adata[
(
(adata.obs["cell_type"] == "CD4 T cells")
& (adata.obs["condition"] == "stimulated")
)
].copy()scGen 使用 AnnData 保存数据,并通过 setup_anndata 注册所需字段。实验条件列由参数 batch_key 指定(本例为 "condition");还需提供细胞类型标签参数 labels_key("cell_type")。
pt.tl.SCGEN.setup_anndata(adata_t, batch_key="condition", labels_key="cell_type")构建与训练模型
用准备好的 AnnData 对象 adata_t 构建 scGen 模型。可配置的参数包括每个隐藏层的节点数(n_hidden)与隐藏层数(n_layers),以及潜在空间的维数。下方示例明确设置两层隐藏层、每层 800 个节点和 100 维潜在表示;模型在潜在空间中计算扰动差异向量。这些是本例配置,并非所有版本的通用默认值。增加网络宽度可能改善重建,但也增加计算量与过拟合(overfitting)风险,应结合验证结果调整。
model = pt.tl.SCGEN(adata_t, n_hidden=800, n_latent=100, n_layers=2)scGen 通过训练神经网络学习数据的低维表示。这里调用 train 方法估计模型参数。其中,max_epochs 表示最多遍历训练数据的轮数,本例设为 100;一个 训练轮次(epoch) 通常包含多次小批量参数更新。增加训练轮数会延长运行时间,也可能改善拟合。参数 batch_size 指定每次小批量更新使用的细胞数,其合适取值需结合数据与训练效果选择。启用 early_stopping 后,如果监控指标连续若干轮未改善,模型就会提前停止;等待轮数由 early_stopping_patience 指定。早停(early stopping)有助于减少过拟合,但不能保证模型一定能泛化到未见群体。
model.train(
max_epochs=100, batch_size=32, early_stopping=True, early_stopping_patience=25
)输出
INFO Jax module moved to TFRT_CPU_0.Note: Pytorch lightning will show GPU is not being used for the Trainer.
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
IPU available: False, using: 0 IPUs
HPU available: False, using: 0 HPUs
Epoch 26/100: 26%|██▌ | 26/100 [1:28:13<4:11:07, 203.61s/it, v_num=1, train_loss_step=1.06e+3, train_loss_epoch=4.52e+3]
Monitored metric elbo_validation did not improve in the last 25 records. Best score: 479.507. Signaling Trainer to stop.
为了可视化模型学到的表示,先提取潜在向量,再计算 UMAP。函数 get_latent_representation() 在本例配置下为每个细胞返回一个 100 维向量,并将其保存到 AnnData 的 .obsm 槽位中。
adata_t.obsm["scgen"] = model.get_latent_representation()接下来,基于潜在表示重新计算近邻图(nearest-neighbor graph)和 UMAP 嵌入(Embedding),再绘图查看细胞之间的关系。
sc.pp.neighbors(adata_t, use_rep="scgen")
sc.tl.umap(adata_t)sc.pl.umap(adata_t, color=["condition", "cell_type"], wspace=0.4, frameon=False)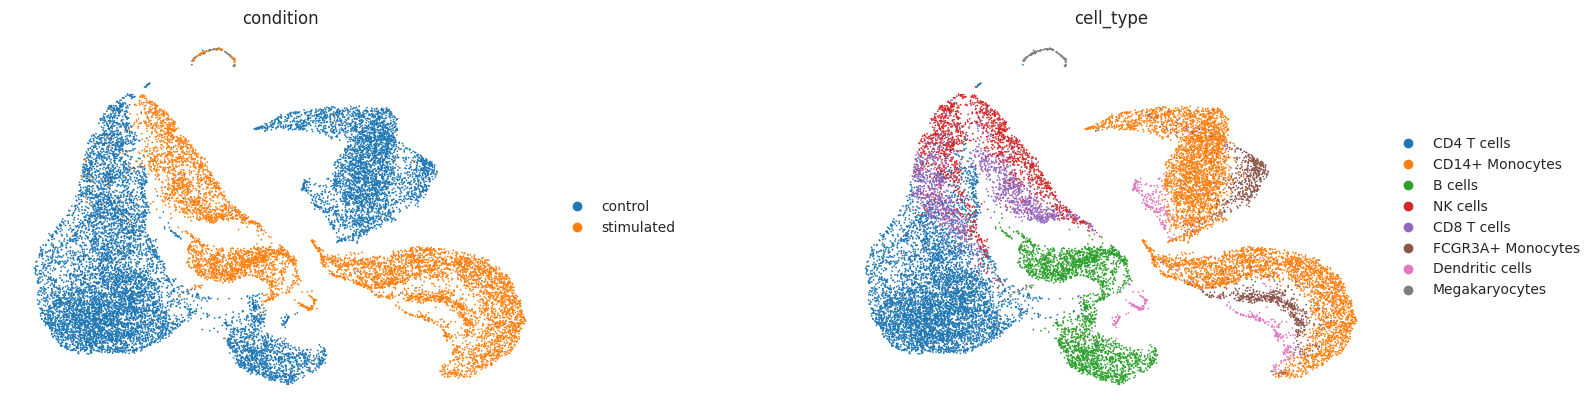
从图中可见,在训练集中同时包含两种条件的细胞类型中,IFN-β 刺激对应明显的转录状态变化。受刺激的 CD4 T 细胞已被留出,不在这一训练数据图中。
预测 CD4 T 细胞对 IFN-β 刺激的响应
模型训练完成后,可以模拟训练数据中各个对照 CD4 T 细胞的 IFN-β 响应。调用 predict 方法时,用 ctrl_key 和 stim_key 指定 condition 列中的两个条件标签;这些注释存储在 AnnData 对象中。模型据此估计受刺激与对照细胞在潜在空间中的平均差异向量,再将该向量加到 celltype_to_predict 指定细胞类型(本例为 CD4 T)中每个对照细胞的潜在表示上,最后解码得到预测表达。
pred, delta = model.predict(
ctrl_key="control", stim_key="stimulated", celltype_to_predict="CD4 T cells"
)
# we annotate the predicted cells to distinguish them later from ground truth cells.
pred.obs["condition"] = "predicted stimulated"输出
INFO Received view of anndata, making copy.
INFO Input AnnData not setup with scvi-tools. attempting to transfer AnnData setup
INFO Received view of anndata, making copy.
INFO Input AnnData not setup with scvi-tools. attempting to transfer AnnData setup
INFO Received view of anndata, making copy.
INFO Input AnnData not setup with scvi-tools. attempting to transfer AnnData setup
评估预测的 IFN-β 响应
前面为每个对照 CD4 T 细胞预测了 IFN-β 响应。单细胞测序具有破坏性,不能在扰动前后重复测量同一个细胞,因此无法逐细胞直接验证这些预测。不过,可以用留出的受刺激 CD4 T 细胞群体作为参考,评估预测群体是否与实测群体一致。定性上,比较对照、预测和实测受刺激细胞在主成分分析(Principal Component Analysis, PCA)空间中的 Embedding;定量上,比较预测与实测群体的逐基因平均表达,并检查差异表达分析中排名靠前的基因。
首先构建一个 AnnData 对象,合并对照、预测受刺激和实测受刺激的细胞。
ctrl_adata = adata[
((adata.obs["cell_type"] == "CD4 T cells") & (adata.obs["condition"] == "control"))
]
# concatenate pred, control and real CD4 T cells in to one object
eval_adata = ctrl_adata.concatenate(cd4t_stim, pred)eval_adata.obs.condition.value_counts()condition
stimulated 5678
control 5560
predicted stimulated 5560
Name: count, dtype: int64先查看对照、IFN-β 刺激和预测受刺激的 CD4 T 细胞在同一 PCA 空间中的分布。
sc.tl.pca(eval_adata)
sc.pl.pca(eval_adata, color="condition", frameon=False)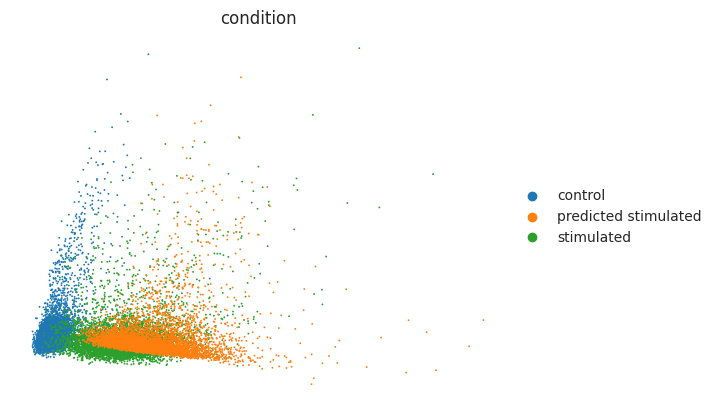
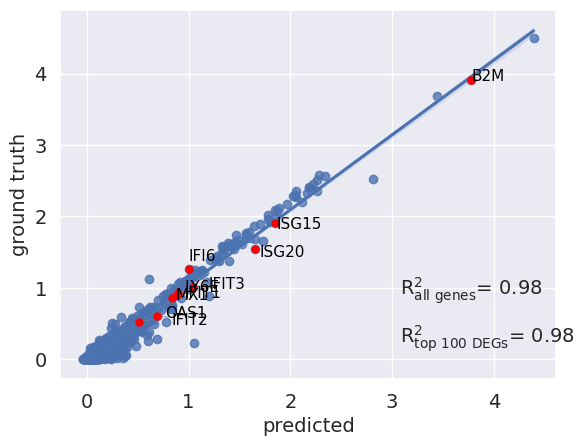
图中,预测细胞的位置向实测受刺激的 CD4 T 细胞靠近。还需要检查基因层面的响应,尤其是差异表达分析中排名靠前的基因是否也在预测中发生相应变化。下面先比较实测对照与受刺激细胞,再评估预测与实测的逐基因平均表达。
cd4t_adata = adata[adata.obs["cell_type"] == "CD4 T cells"]使用 Scanpy 的 Wilcoxon 秩和检验(Wilcoxon rank-sum test)对实测受刺激与对照细胞进行差异表达分析,并取得基因排名。下方没有按校正 p 值或效应量进一步筛选,因此 diff_genes 并非一份已确认显著的 DEG 列表。
sc.tl.rank_genes_groups(cd4t_adata, groupby="condition", method="wilcoxon")
diff_genes = cd4t_adata.uns["rank_genes_groups"]["names"]["stimulated"]
diff_genesarray(['ISG15', 'IFI6', 'ISG20', ..., 'EEF1A1', 'FTH1', 'RGCC'],
dtype=object)scGen 提供均值表达比较图功能(原文称 reg_mean_plot,下方实际调用 plot_reg_mean_plot),对预测与实测受刺激细胞的逐基因平均表达进行比较。图中的 R² 是两组均值之间 皮尔逊相关(Pearson correlation)系数的平方;接近 1 表示线性关联较强,并不单独保证预测方向或绝对表达量准确。红色标出的十个基因是 Wilcoxon 排名的前十项,不一定就是显著性达标或倍数变化最大的十个 DEG。本例把完整排名列表传给 top_100_genes,因此相应统计量并不只针对一百个显著 DEG。图中高平均表达基因的预测较好,而部分平均表达在 0–1 的基因偏差较大。评估时也应关注未受扰动影响的基因,检查模型是否引入了不应出现的变化。
r2_value = model.plot_reg_mean_plot(
eval_adata,
condition_key="condition",
axis_keys={"x": "predicted stimulated", "y": "stimulated"},
gene_list=diff_genes[:10],
top_100_genes=diff_genes,
labels={"x": "predicted", "y": "ground truth"},
show=True,
legend=False,
)
还可以检查 IFN-β 响应基因的表达分布。例如,下面绘制 ISG15 的表达分布,它是已知的干扰素诱导基因。本例中,模型预测了刺激后的上调趋势,并将表达值移向与实测受刺激细胞相近的范围。
sc.pl.violin(eval_adata, keys="ISG15", groupby="condition")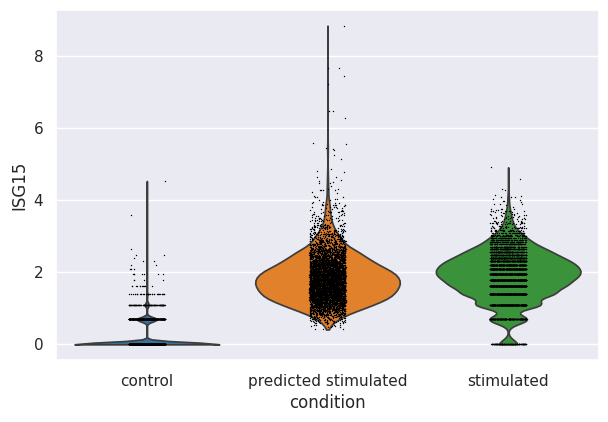
本例演示了如何用 scGen 预测某一细胞类型尚未测量的扰动条件下的基因表达。计算预测可辅助实验设计,但不能替代实际实验;预测中有多少信号来自细胞类型特异响应、有多少来自不同类型共享的响应,仍需进一步分析。在这里,高表达基因的总体响应预测较好,低表达基因的预测较弱,说明模型仍有改进空间。
分析单细胞混合池 CRISPR 筛选
扩展型 CRISPR 兼容 CITE-seq(Expanded CRISPR-compatible CITE-seq, ECCITE-seq)在转录组与表位细胞索引测序(Cellular Indexing of Transcriptomes and Epitopes by Sequencing, CITE-seq)的基础上,同时捕获单向导 RNA(single guide RNA, sgRNA)序列、转录组和细胞表面蛋白。转录组来自信使 RNA(messenger RNA, mRNA)读出,表面蛋白则通过抗体衍生标签(antibody-derived tag, ADT)测量。这样可以在同一实验中施加多种遗传扰动,用转录组探索效应,并借助蛋白表达提供补充验证。丰富的读出也使数据分析更复杂。
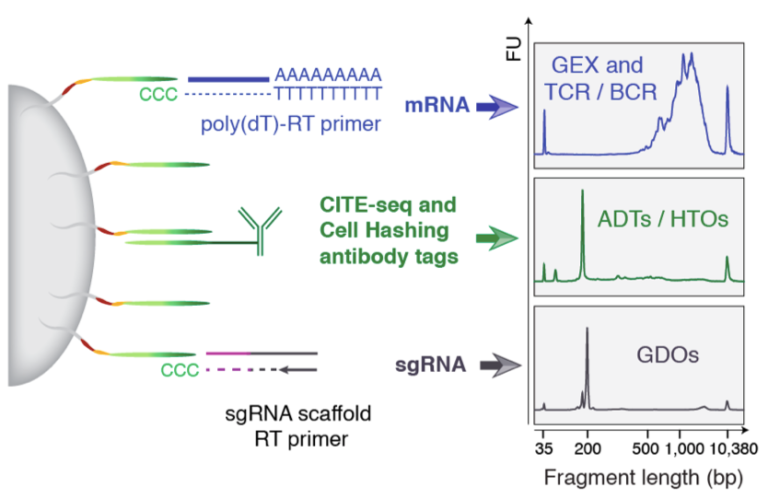
图 1:ECCITE-seq 概览。mRNA 与表面蛋白在同一细胞中联合测量,其中表面蛋白通过 ADT 读取。样本标签衍生寡核苷酸(hashtag-derived oligonucleotide, HTO)用于区分生物学重复,向导 RNA 衍生寡核苷酸(guide-derived oligonucleotide, GDO)用于确定各细胞携带的向导 RNA(guide RNA, gRNA)。图片来源(https://
本节使用 Papalexi 2021 数据集 Papalexi et al., 2021,其中包含约 20,000 个受刺激的 THP-1 细胞,使用了 111 种 gRNA。干扰素 γ(interferon gamma, IFN-γ)、地西他滨(decitabine, DAC)与转化生长因子 β1(transforming growth factor beta 1, TGF-β1)联合刺激,可诱导程序性死亡配体 1(programmed death-ligand 1, PD-L1)、PD-L2 和共刺激分子 CD86 的表达。该 ECCITE-seq 实验旨在研究调控 PD-L1 表达的分子网络,因为 PD-L1 常见于人类肿瘤,并可抑制 T 细胞介导的免疫响应 Papalexi et al., 2021。
本节分析的目标是:
减轻细胞周期、批次效应(batch effect)等混杂变异。
区分具有预期扰动转录响应的细胞与未检出此类响应的细胞。
可视化扰动响应。
这里继续使用 pertpy 中面向 scverse 生态实现的 Mixscape 流程(pipeline)。原文报告该实现约快 5–10 倍,具体速度取决于数据和运行环境。Mixscape 最初为 Seurat 生态开发,下面主要遵循配套的 Seurat 教程(https://
首先导入 pertpy、Scanpy 和 muon,其中 muon 用于蛋白数据预处理。
import muon as mu
import pertpy as pt
import scanpy as sc先通过 pertpy 加载数据集。加载函数返回 MuData 对象,其中包含转录组、ADT 测量以及 gRNA 计数(Count)。
mdata = pt.dt.papalexi_2021()
mdata原始 Seurat 对象中的四个测定(Assay)分别转换为 AnnData 对象,再组合成本例加载的 MuData 对象。各模态如下:
adt:四种抗体衍生标签(CD86、PDL1、PDL2、CD366)的计数矩阵(Count matrix);在此语境下,也常将这一模态简称为“蛋白”。gdo:实验使用的 111 种 gRNA。根据 GDO 的 Count,为每个细胞分配 gRNA 身份。若一个细胞中所有 gRNA 的 Count 均低于 5,则判为阴性;其余细胞分配给 Count 最高的 gRNA。若多种 gRNA 同时具有高 Count,则判为双细胞(Doublet)。hto:按照细胞哈希(cell hashing)流程,用 HTO 标记样本,以追踪各生物学重复的来源 Stoeckius et al., 2018。rna:所有细胞的转录组测量,即通常的“细胞 × 基因”Count 矩阵。
预处理
这里对 RNA 与 ADT 采用简化的预处理。先用 Scanpy 的 normalize_total 对 RNA 进行总量归一化,再做对数变换并保留 HVG。ADT 则采用中心化对数比变换(Centered Log-Ratio Transformation, CLR)Stoeckius et al., 2017。
sc.pp.normalize_total(mdata["rna"])
sc.pp.log1p(mdata["rna"])
sc.pp.highly_variable_genes(mdata["rna"], subset=True)mu.prot.pp.clr(mdata["adt"])数据探索
先在 UMAP Embedding 中分别查看生物学重复、细胞周期阶段与扰动标签,了解数据的主要变化来源。
sc.pp.pca(mdata["rna"])# We calculate neighbors with the cosine distance similarly to the original Seurat implementation
sc.pp.neighbors(mdata["rna"], metric="cosine")sc.tl.umap(mdata["rna"])sc.pl.umap(mdata["rna"], color=["replicate", "Phase", "perturbation"])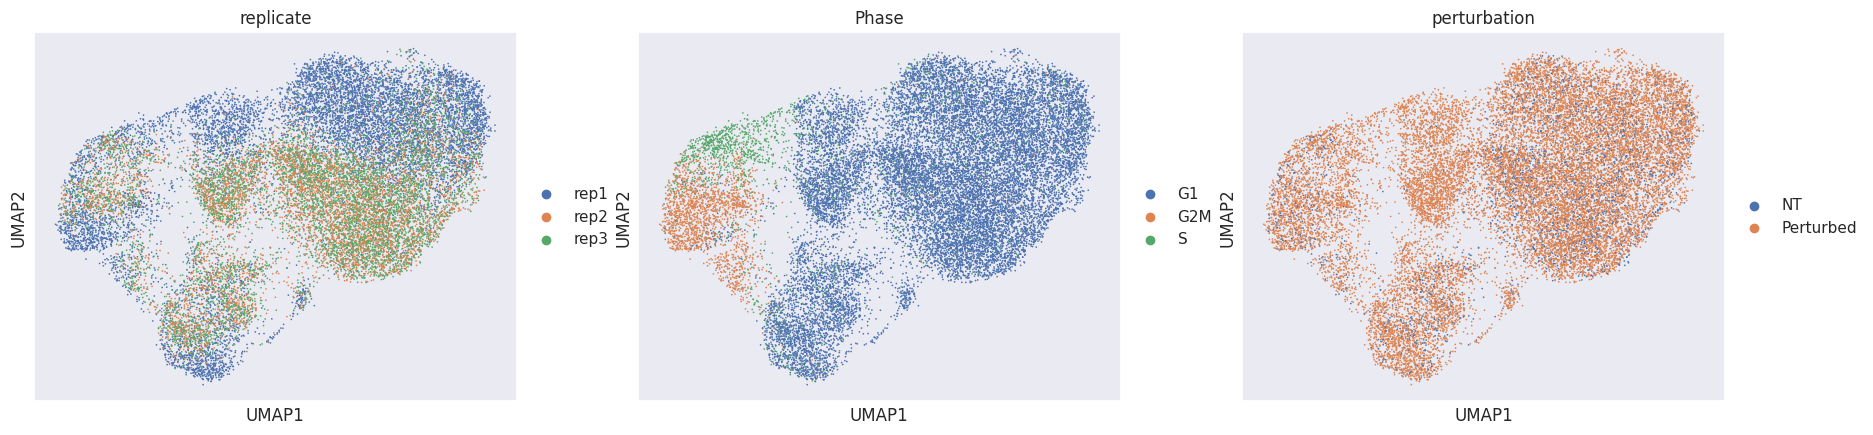
从 UMAP 图中可以看到两个需要进一步检查的问题:
许多细胞按生物学重复标签分开,提示可能存在批次效应。
细胞周期阶段也与 Embedding 中的分离有关,可能混杂扰动信号。
接下来计算局部扰动特征(local perturbation signature),构建更突出扰动效应的表达表示,以减轻这些混杂因素的影响。
计算局部扰动特征
基本思路是:从每个细胞的表达向量中,减去非靶向对照(non-targeting, NT)细胞池中与其最相近的 k 个细胞的平均表达,从而尽量突出遗传扰动相关信号。所选的 k 个近邻应与目标细胞处于相近生物学状态,并携带非靶向 gRNA;这并不意味着对照细胞没有 gRNA。所得差值称为局部扰动特征,但仍可能包含残余混杂。本例近邻数 k 为 20。根据 Papalexi 等人的建议,可在 20–30 之间选择 k。若 k 过小或过大,都可能削弱去除技术变异的效果 Papalexi et al., 2021。
现在用 pertpy 创建 Mixscape 对象,并计算局部扰动特征。
ms = pt.tl.Mixscape()

ms.perturbation_signature(
    mdata["rna"],
    pert_key="perturbation",
    control="NT",
    split_by="replicate",
    n_neighbors=20,
)
# We create a copy of the object to recalculate the PCA.
# Alternatively we could replace the X of the RNA part of our MuData object with the `X_pert` layer.
adata_pert = mdata["rna"].copy()
adata_pert.X = adata_pert.layers["X_pert"]
sc.pp.pca(adata_pert)
sc.pp.neighbors(adata_pert, metric="cosine")
sc.tl.umap(adata_pert)
sc.pl.umap(adata_pert, color=["replicate", "Phase", "perturbation"])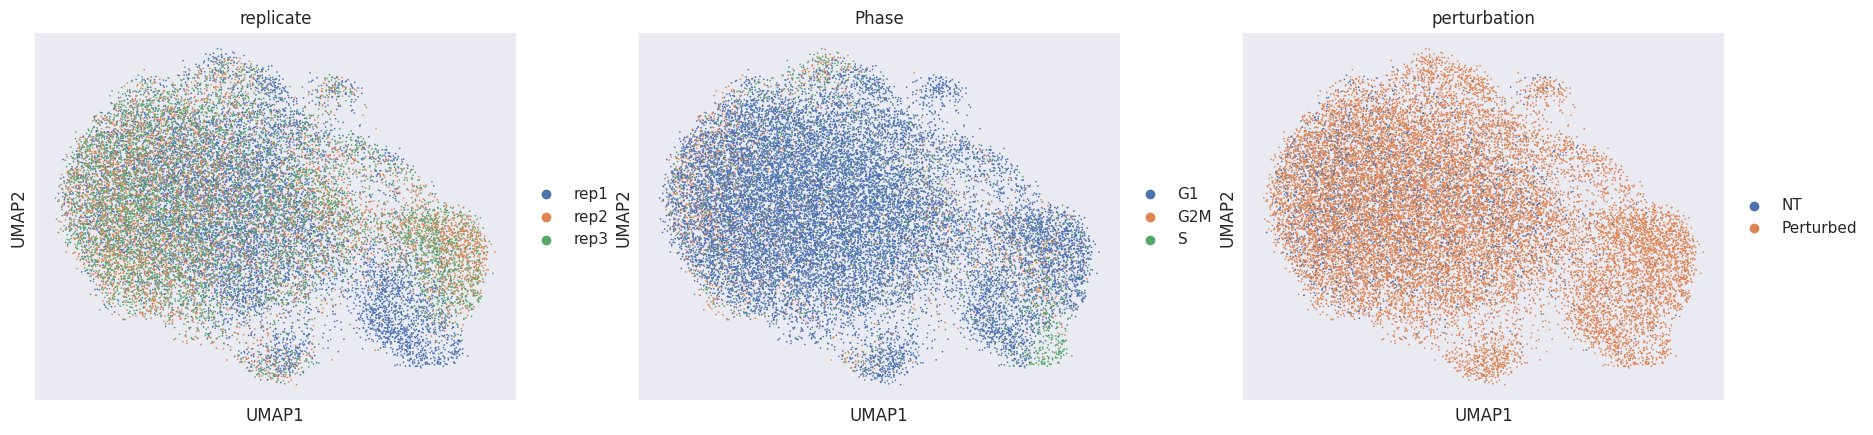
使用局部扰动特征重新计算近邻图与 Embedding 后,图中混杂结构有所减弱,并显现出一个与扰动相关的额外聚类。接下来,要把靶向细胞分为具有敲除样转录响应的细胞(knockout, KO)与未检出扰动响应的细胞(non-perturbed, NP)。这里的类别是依据转录组推断的,不能直接作为基因组编辑成功或失败的证据。
识别未检出扰动响应的细胞
Mixscape 假定,同一靶基因组内细胞的扰动分数可用两个高斯分布的混合来描述,分别对应 KO 与 NP 类。NP 分布假定与携带非靶向 gRNA 的 NT 对照一致。估计混合分布后,模型计算各细胞属于 KO 类的后验概率(posterior probability),并将大于 0.5 的细胞归为 KO。对全部 11 个靶基因组进行这一分析,可比较不同 gRNA 诱导可检测转录响应的比例。NP 表示未检出相应表达变化,不等于已经证明靶向编辑失败;分类结果也不能保证找出所有真实敲除细胞。
ms.mixscape(adata=mdata["rna"], control="NT", labels="gene_target", layer="X_pert")现在可以绘制全部 111 种 gRNA 的细胞分类比例。
ms.plot_barplot(mdata["rna"], guide_rna_column="guide_ID")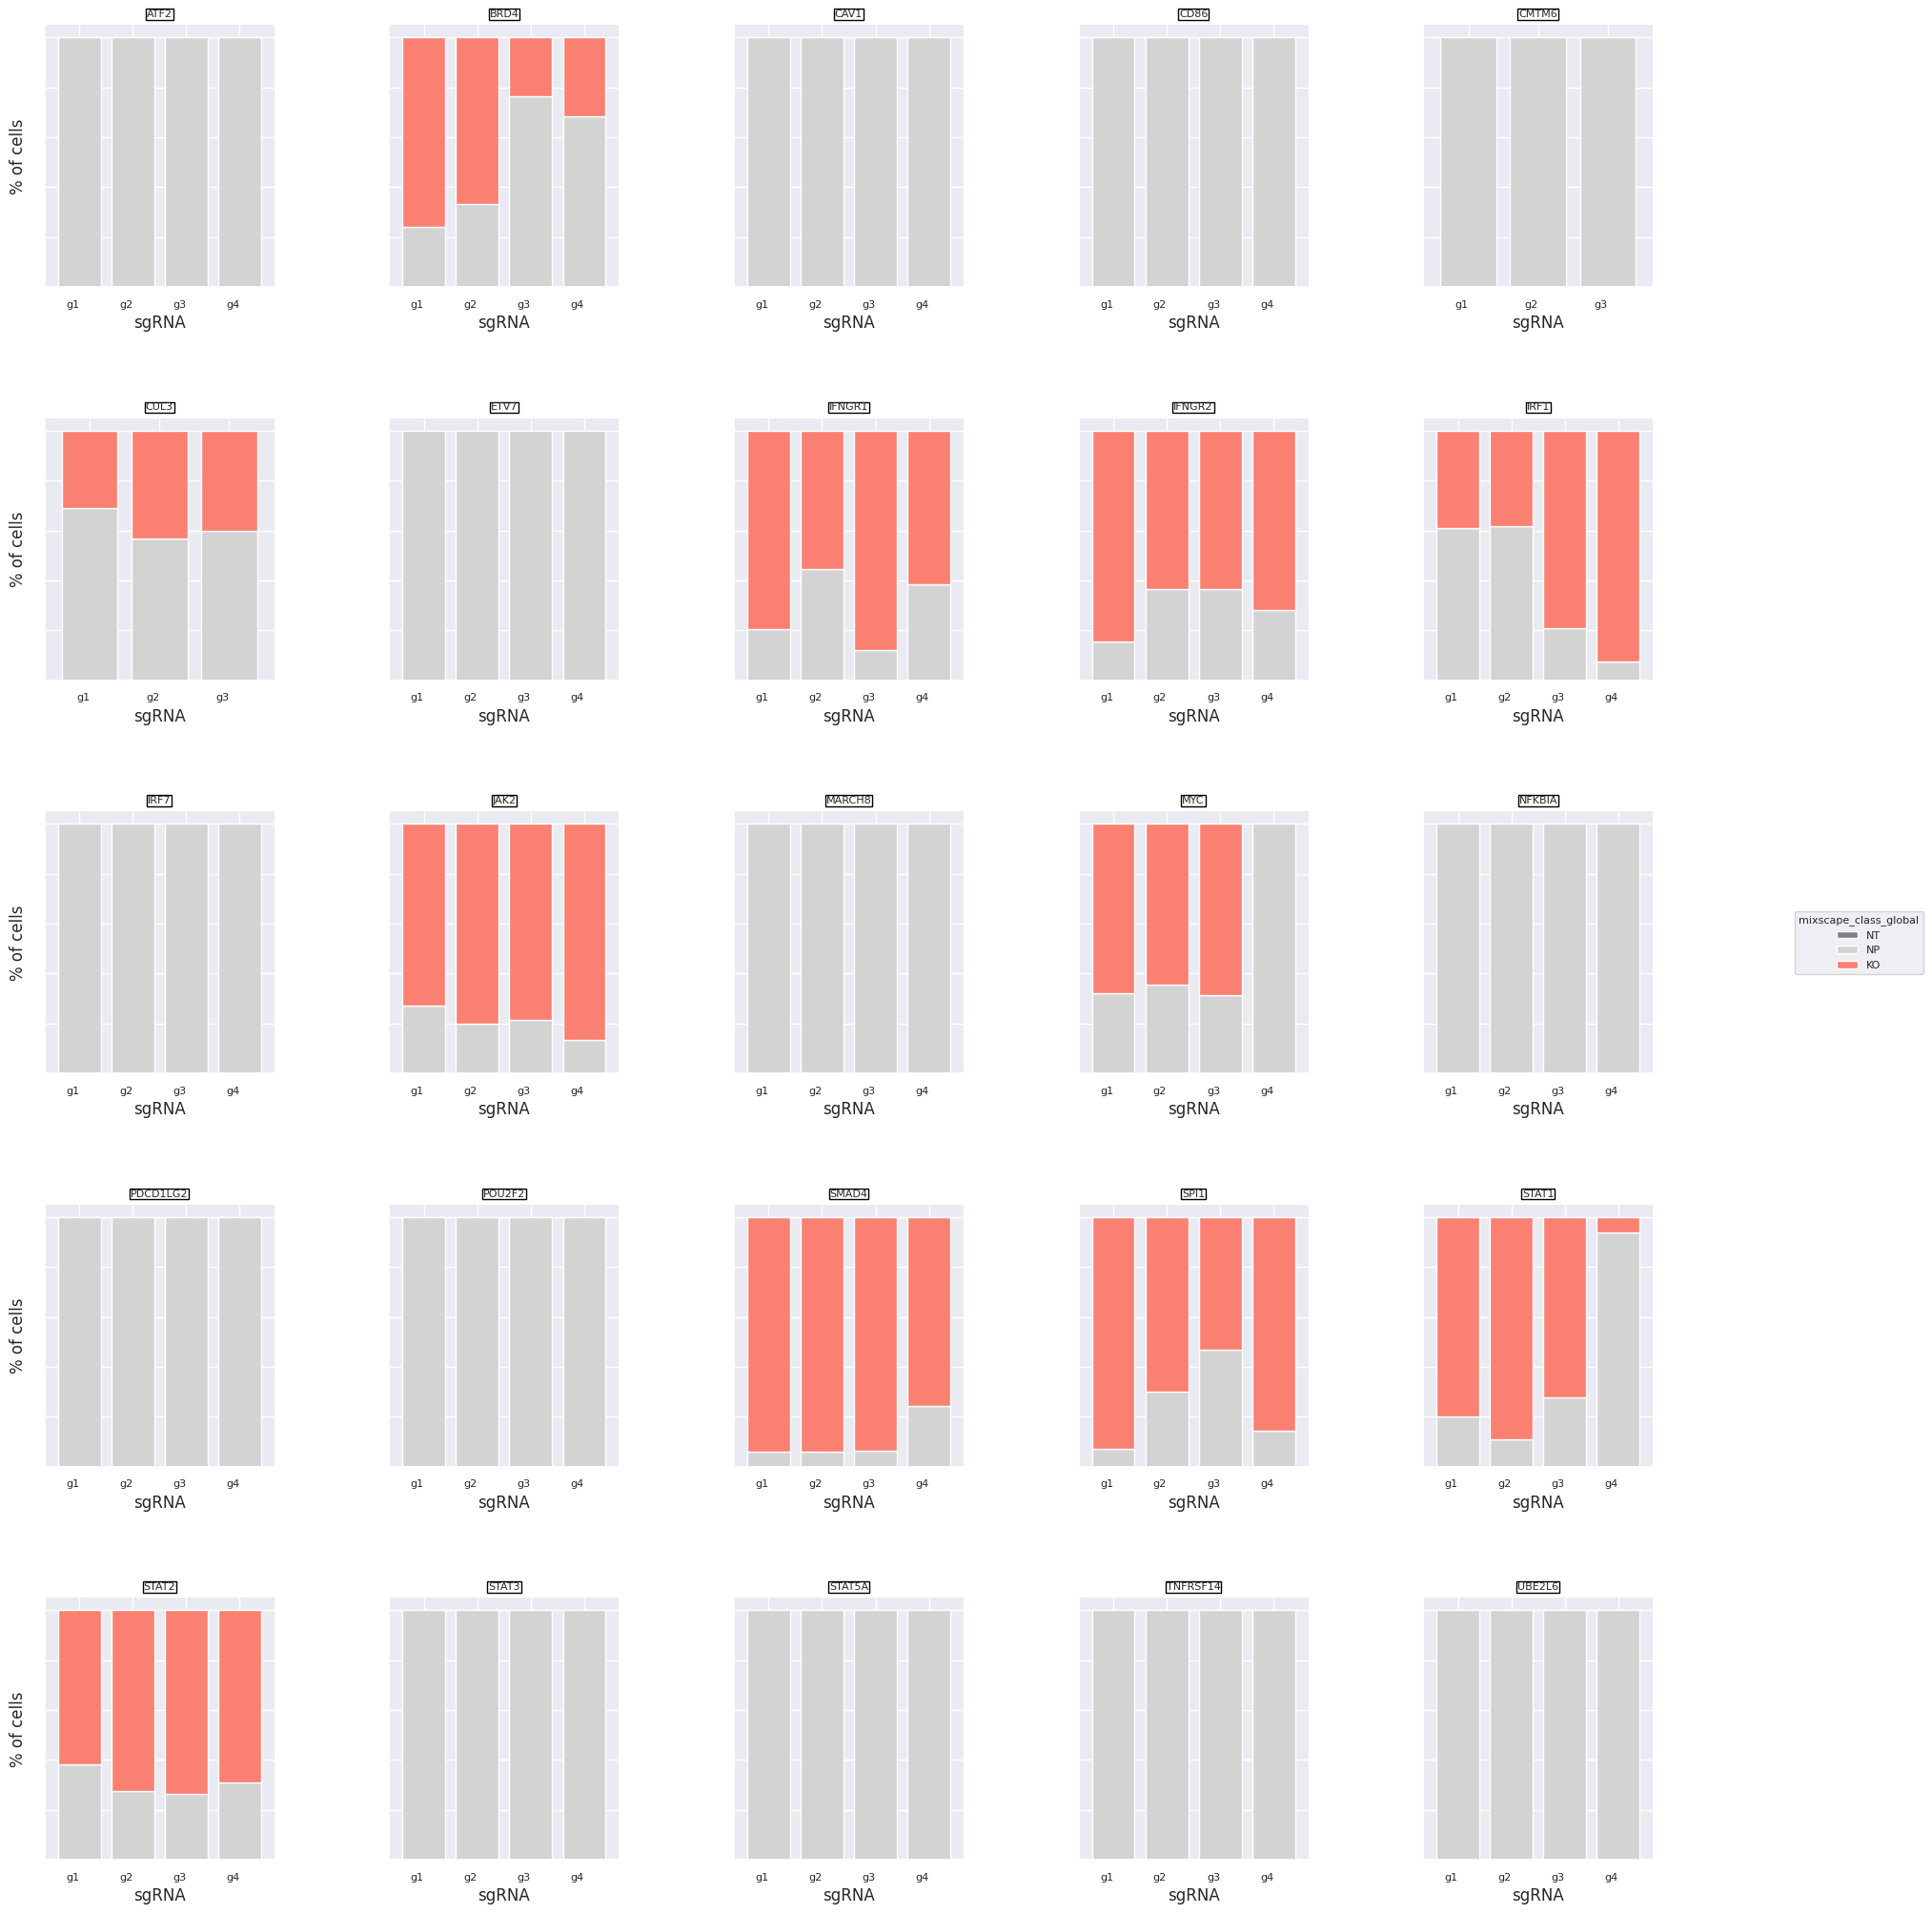
<Axes: title={'center': 'UBE2L6'}, xlabel='sgRNA', ylabel='% of cells'>针对同一靶基因,不同 gRNA 诱导可检测转录响应的比例也有差异。例如,靶向 STAT1 的 gRNA 4 对应的 KO 比例较低,而 gRNA 1–3 较高。
以 IFNGR2 为例,进一步查看扰动分数。
ms.plot_perturbscore(
    adata=mdata["rna"], labels="gene_target", target_gene="IFNGR2", color="orange"
)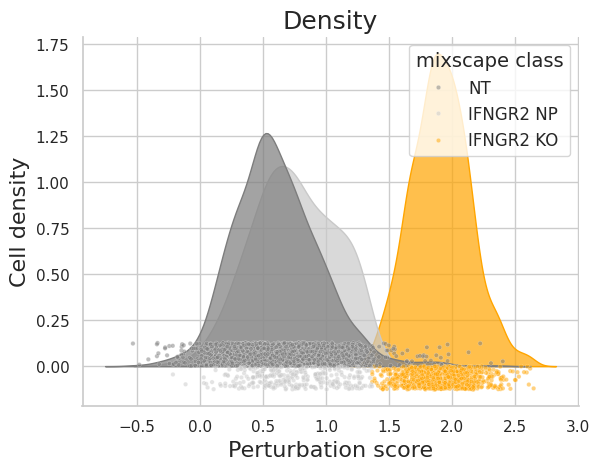
NT 与 IFNGR2 NP 类的分数分布较为接近,而 IFNGR2 KO 类明显偏移。这种分离也应体现在后验概率中。
sc.settings.set_figure_params(figsize=(10, 10))
ms.plot_violin(
    adata=mdata["rna"],
    target_gene_idents=["NT", "IFNGR2 NP", "IFNGR2 KO"],
    groupby="mixscape_class",
)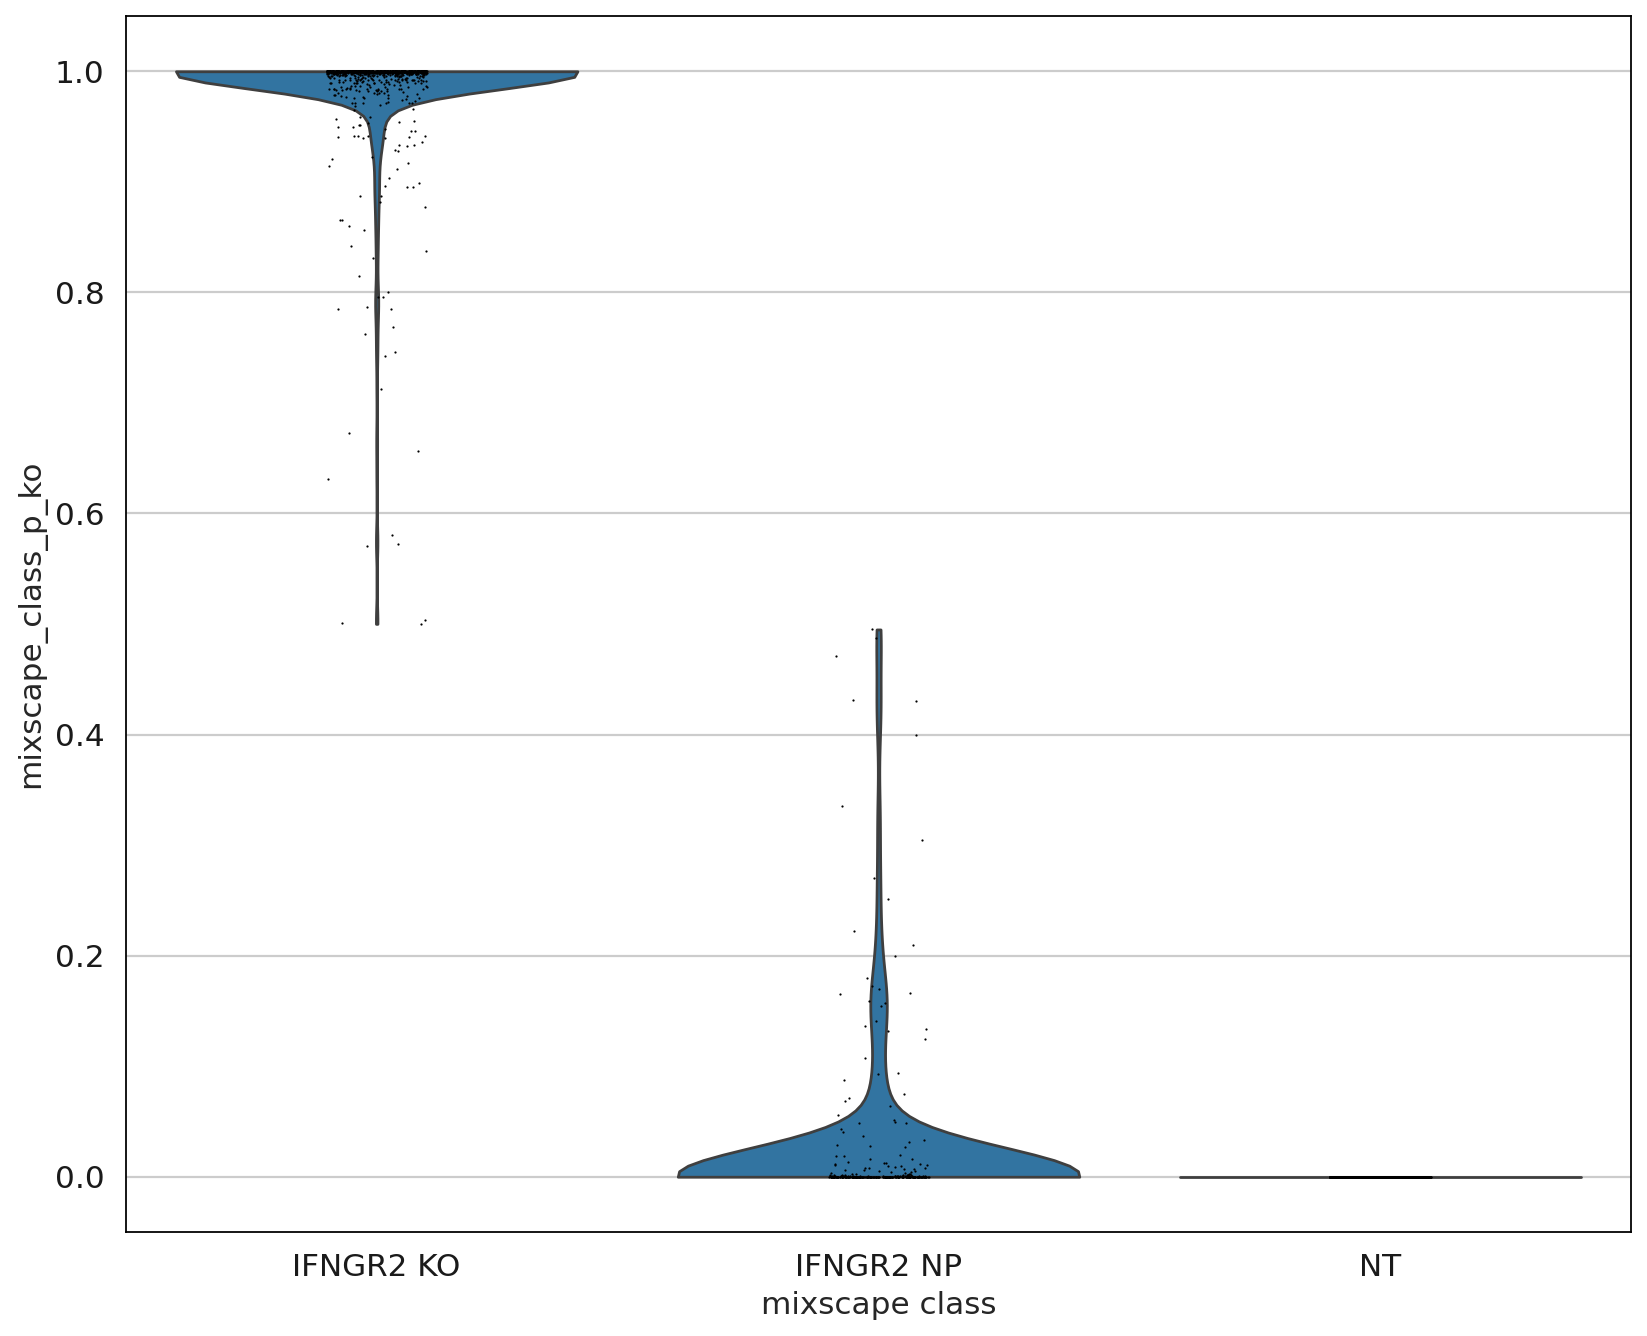
本例的后验概率将两类细胞较清楚地区分开,处于模糊边界的细胞较少。还可以在 Mixscape 类别间进行差异表达检验,并按后验概率排列细胞绘制热图,检查表达变化与分类的关系。
ms.plot_heatmap(
    adata=mdata["rna"],
    labels="gene_target",
    target_gene="IFNGR2",
    layer="X_pert",
    control="NT",
)
WARNING: dendrogram data not found (using key=dendrogram_mixscape_class). Running `sc.tl.dendrogram` with default parameters. For fine tuning it is recommended to run `sc.tl.dendrogram` independently.
WARNING: Groups are not reordered because the `groupby` categories and the `var_group_labels` are different.
categories: IFNGR2 KO, IFNGR2 NP, NT
var_group_labels: NT
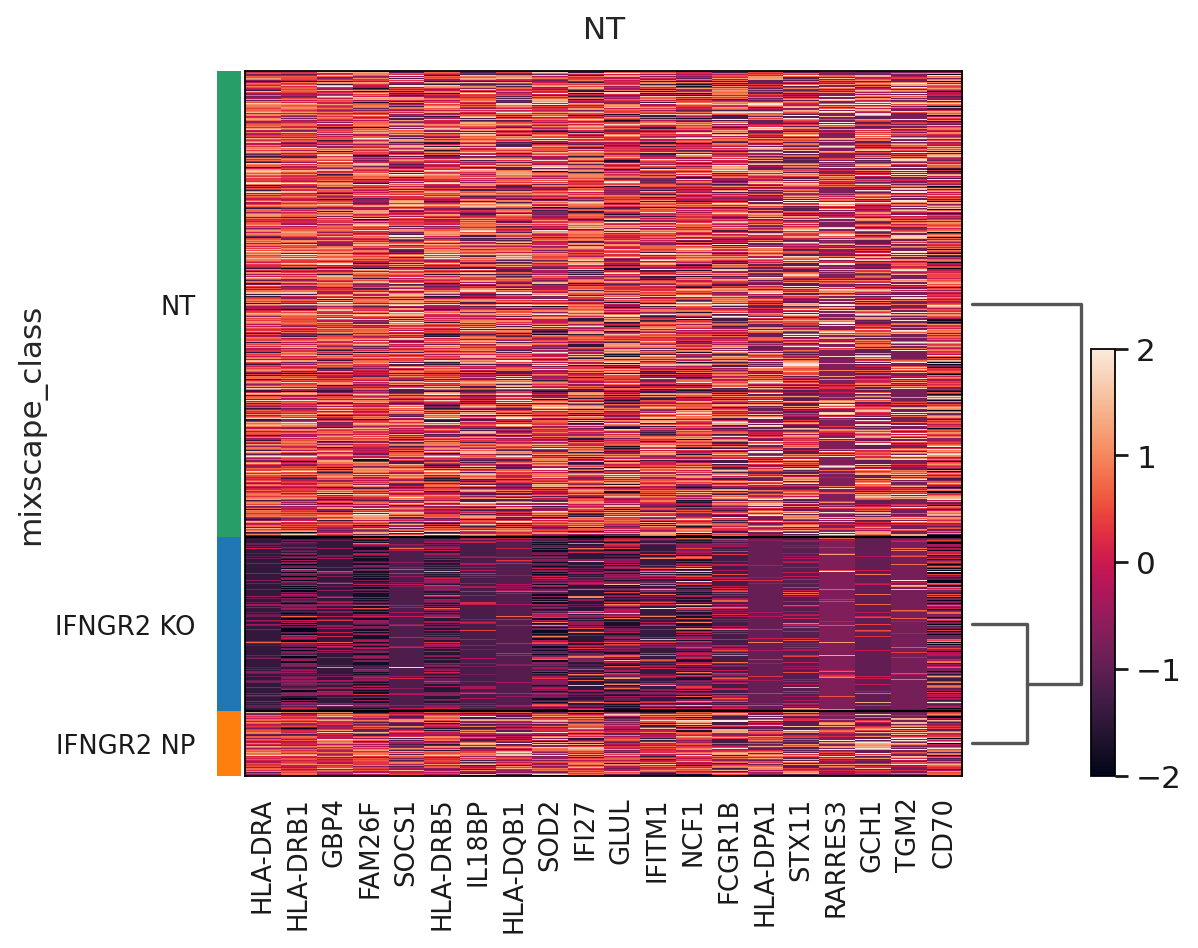
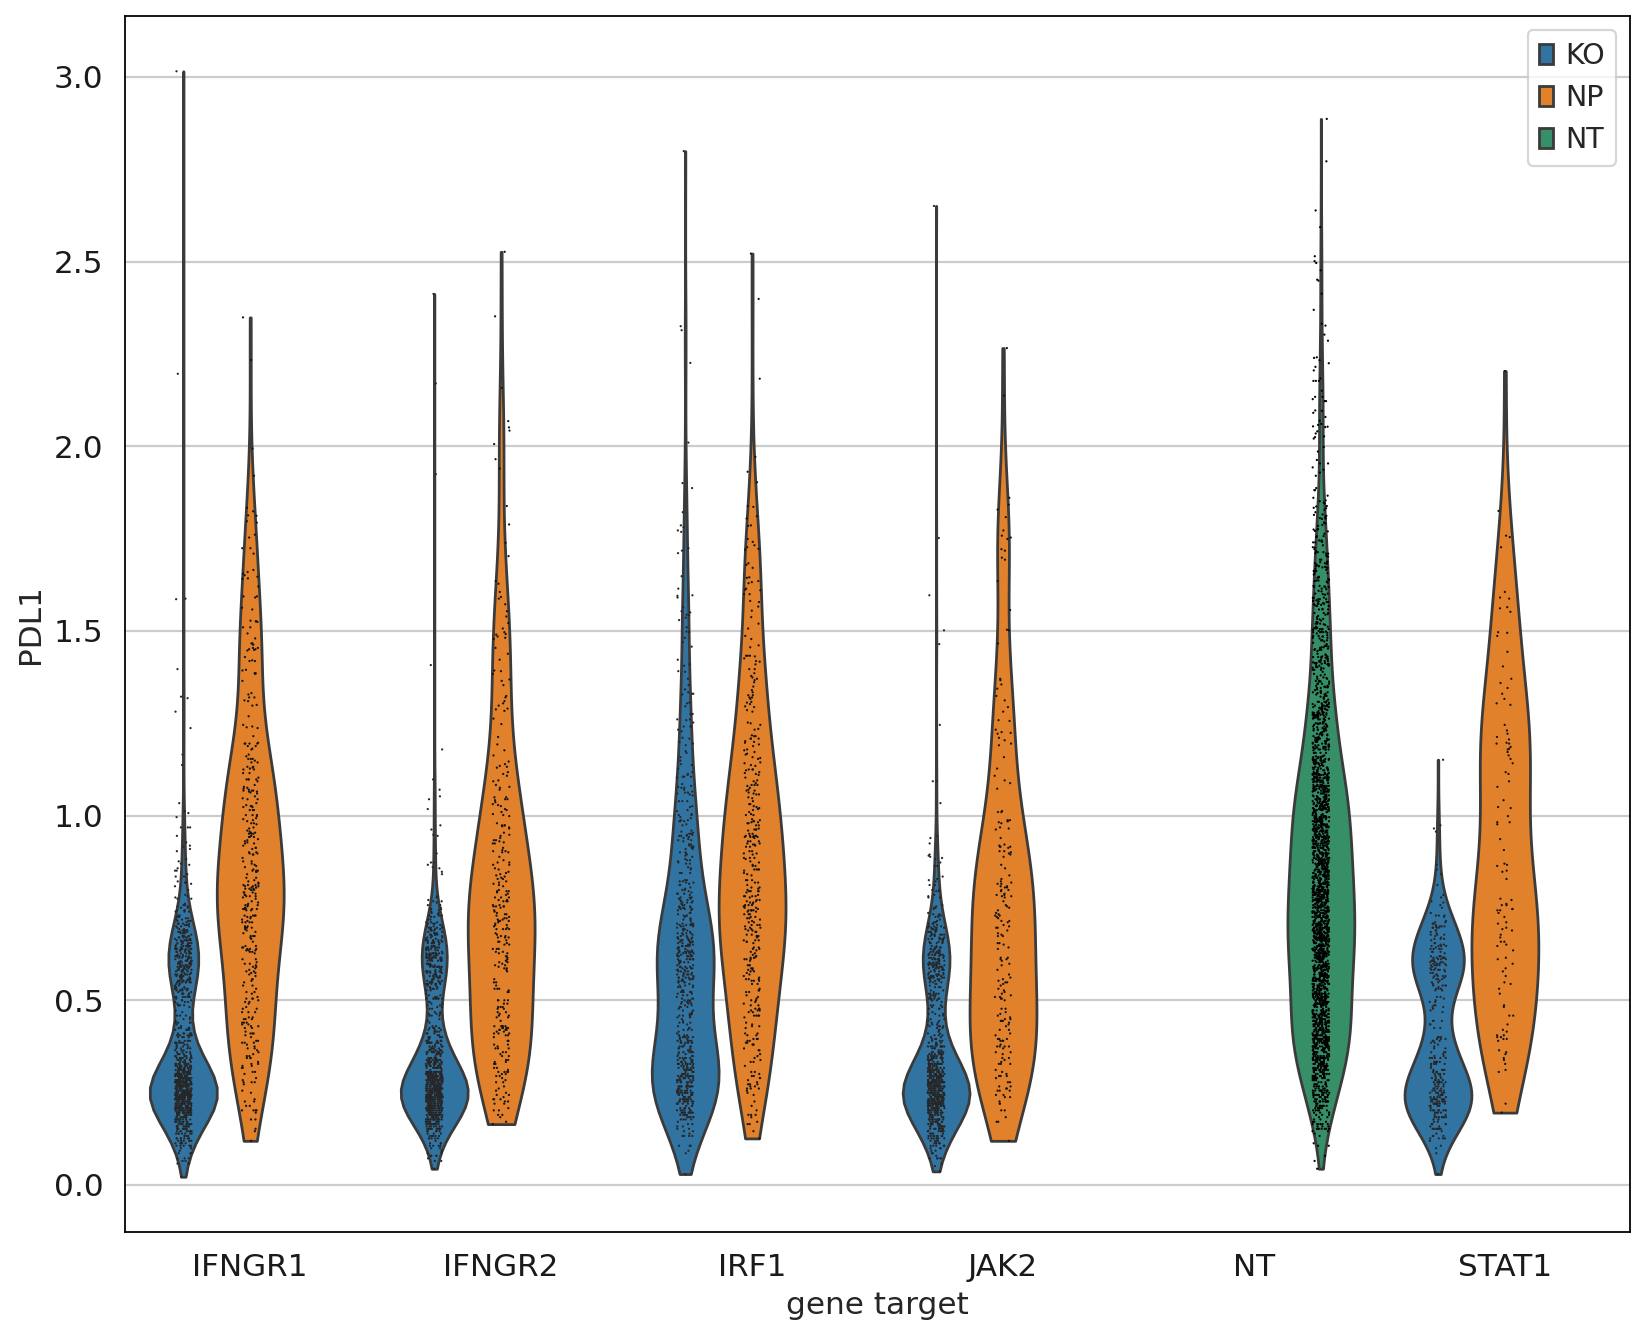
前面的分析只使用转录组数据。现在结合蛋白测量可以看到,图中 IFN-γ 通路相关靶基因的 KO 类细胞呈现 PD-L1 蛋白表达降低,而相应 NP 类没有同样明显的降低,为转录组推断的扰动效应提供补充支持。
mdata["adt"].obs["mixscape_class_global"] = mdata["rna"].obs["mixscape_class_global"]
ms.plot_violin(
    adata=mdata["adt"],
    target_gene_idents=["NT", "JAK2", "STAT1", "IFNGR1", "IFNGR2", "IRF1"],
    keys="PDL1",
    groupby="gene_target",
    hue="mixscape_class_global",
)
使用线性判别分析可视化扰动响应
Mixscape 的最后一步是计算并展示与扰动相关的细胞分组。这里先进行线性判别分析(Linear Discriminant Analysis, LDA),再基于其结果重新计算 UMAP。LDA 是监督方法,同时使用表达数据和已知类别标签,力求提高类别之间的可分性;本例标签来自 Mixscape 分类。
ms.lda(adata=mdata["rna"], control="NT", labels="gene_target", layer="X_pert")ms.plot_lda(adata=mdata["rna"], control="NT")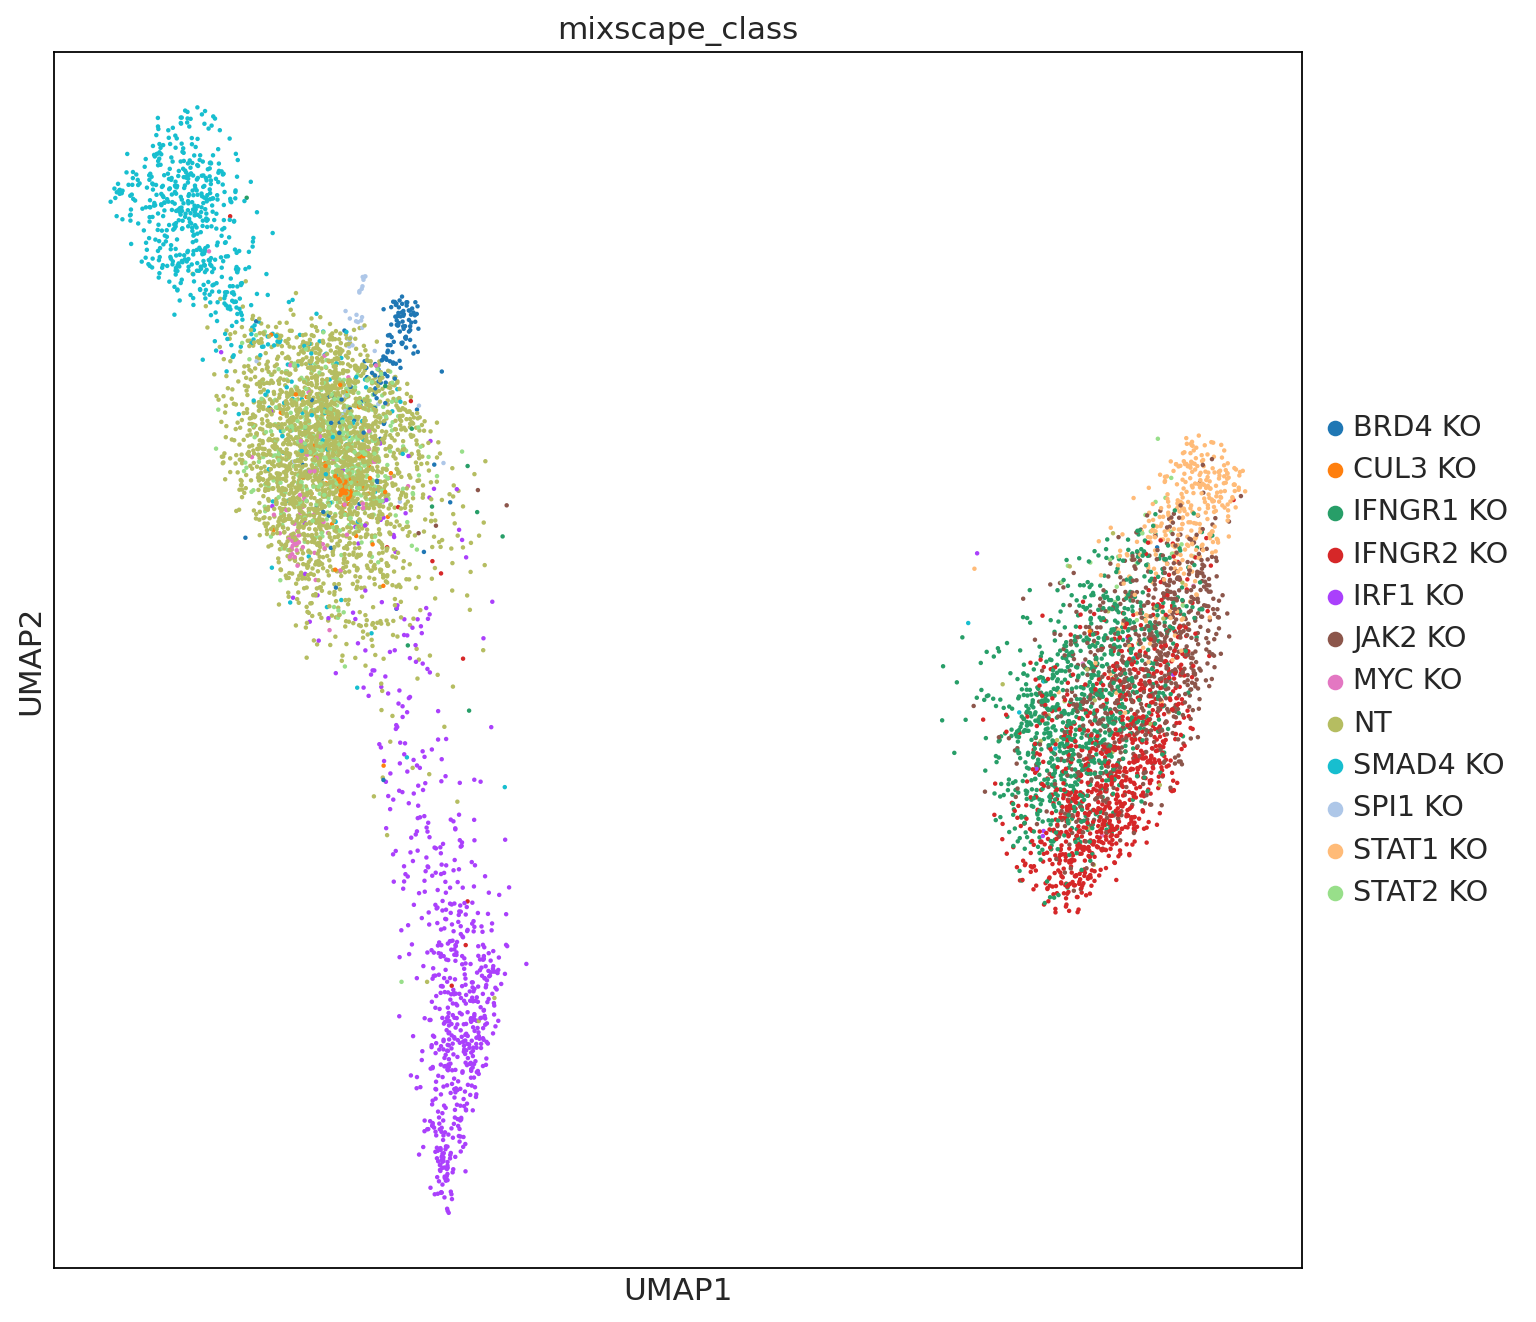
LDA 后的 UMAP 图呈现两个主要“岛”,提示存在不同的扰动响应模式。不过,图中的接近或分离不能单独证明不同敲除具有相似或不同的生物学效应;仍需通路分析及后续生物学验证等更严格的证据。
测验
- Srivatsan, S. R., McFaline-Figueroa, J. L., Ramani, V., Saunders, L., Cao, J., Packer, J., Pliner, H. A., Jackson, D. L., Daza, R. M., Christiansen, L., & others. (2020). Massively multiplex chemical transcriptomics at single-cell resolution. Science, 367(6473), 45–51.
- Papalexi, E., Mimitou, E. P., Butler, A. W., Foster, S., Bracken, B., Mauck, W. M., Wessels, H.-H., Hao, Y., Yeung, B. Z., Smibert, P., & Satija, R. (2021). Characterizing the molecular regulation of inhibitory immune checkpoints with multimodal single-cell screens. Nature Genetics, 53(3), 322–331. 10.1038/s41588-021-00778-2
- Frangieh, C. J., Melms, J. C., Thakore, P. I., Geiger-Schuller, K. R., Ho, P., Luoma, A. M., Cleary, B., Jerby-Arnon, L., Malu, S., Cuoco, M. S., & others. (2021). Multimodal pooled Perturb-CITE-seq screens in patient models define mechanisms of cancer immune evasion. Nature Genetics, 53(3), 332–341.
- Replogle, J. M., Saunders, R. A., Pogson, A. N., Hussmann, J. A., Lenail, A., Guna, A., Mascibroda, L., Wagner, E. J., Adelman, K., Bonnar, J. L., & others. (2021). Mapping information-rich genotype-phenotype landscapes with genome-scale Perturb-seq. bioRxiv.
- Wessels, H.-H., Méndez-Mancilla, A., Papalexi, E., Mauck, W. M., Lu, L., Morris, J. A., Mimitou, E., Smibert, P., Sanjana, N. E., & Satija, R. (2022). Efficient combinatorial targeting of term`RNA` transcripts in single cells with Cas13 RNA Perturb-seq. bioRxiv.
- Ji, Y., Lotfollahi, M., Wolf, F. A., & Theis, F. J. (2021). Machine learning for perturbational single-cell omics. Cell Systems, 12(6), 522–537.
- Kang, H. M., Subramaniam, M., Targ, S., Nguyen, M., Maliskova, L., McCarthy, E., Wan, E., Wong, S., Byrnes, L., Lanata, C. M., & others. (2018). Multiplexed droplet single-cell term`RNA`-sequencing using natural genetic variation. Nature Biotechnology, 36(1), 89–94.
- Skinnider, M. A., Squair, J. W., Kathe, C., Anderson, M. A., Gautier, M., Matson, K. J. E., Milano, M., Hutson, T. H., Barraud, Q., Phillips, A. A., Foster, L. J., La Manno, G., Levine, A. J., & Courtine, G. (2021). Cell type prioritization in single-cell data. Nature Biotechnology, 39(1), 30–34. 10.1038/s41587-020-0605-1
- Squair, J. W., Skinnider, M. A., Gautier, M., Foster, L. J., & Courtine, G. (2021). Prioritization of cell types responsive to biological perturbations in single-cell data with Augur. Nature Protocols, 16(8), 3836–3873. 10.1038/s41596-021-00561-x
- Squair, J. W., Gautier, M., Kathe, C., Anderson, M. A., James, N. D., Hutson, T. H., Hudelle, R., Qaiser, T., Matson, K. J. E., Barraud, Q., Levine, A. J., La Manno, G., Skinnider, M. A., & Courtine, G. (2021). Confronting false discoveries in single-cell differential expression. Nature Communications, 12(1), 5692. 10.1038/s41467-021-25960-2
- Bhattacherjee, A., Djekidel, M. N., Chen, R., Chen, W., Tuesta, L. M., & Zhang, Y. (2019). Cell type-specific transcriptional programs in mouse prefrontal cortex during adolescence and addiction. Nature Communications, 10(1), 4169. 10.1038/s41467-019-12054-3
- Lotfollahi, M., Wolf, F. A., & Theis, F. J. (2019). scGen predicts single-cell perturbation responses. Nature Methods, 16(8), 715–721.
- Lotfollahi, M., Naghipourfar, M., Theis, F. J., & Wolf, F. A. (2020). Conditional out-of-distribution generation for unpaired data using transfer VAE. Bioinformatics, 36(Supplement_2), i610–i617.
- Lotfollahi, M., Susmelj, A. K., De Donno, C., Ji, Y., Ibarra, I. L., Wolf, F. A., Yakubova, N., Theis, F. J., & Lopez-Paz, D. (2021). Learning interpretable cellular responses to complex perturbations in high-throughput screens. bioRxiv.
- Russkikh, N., Antonets, D., Shtokalo, D., Makarov, A., Vyatkin, Y., Zakharov, A., & Terentyev, E. (2020). Style transfer with variational autoencoders is a promising approach to term`RNA`-Seq data harmonization and analysis. Bioinformatics, 36(20), 5076–5085.