🧠 关键要点
谱系追踪(Lineage Tracing)的 实验分辨率 仍然有限。需要对谱系信息开展 统计分析 和 质量评估,以确定哪些样本适合进行谱系重建。下文介绍的专用工具可以方便地计算相关统计量。
通常很难预先判断 哪种算法 的重建效果最好;即使表现良好的算法,也可能各自更擅长恢复谱系的不同部分。建议 采用若干算法 进行重建并相互比较。
对于缺乏确定真值(ground truth)的分析, 必须谨慎得出结论。首先,应将谱系树与插入缺失(insertion and deletion, indel)热图放在一起查看,确认没有明显的重建错误;更多目视评估技巧见“重建谱系”一节。其次,对同一谱系分别使用不同算法重建,再比较各自的下游分析结果,有助于增强结论的可信度。与其他计算分析一样,我们通常建议在实验系统中验证结论。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到新文件,并命名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: lineage-tracing
channels:
  - defaults
  - conda-forge
dependencies:
  - conda-forge::python=3.12.9
  - pip:
      - git+https://github.com/YosefLab/Cassiopeia@master#egg=cassiopeia-lineage
      - scanpy==1.11.0
      - session_info
      - lamindb[bionty,jupyter]
内容概要:本章介绍能够同时测量细胞状态(cell state)与谱系历史的实验方法及相应的计算分析流程,并以小鼠肺癌模型中的肿瘤发育追踪为例,演示完整分析过程。
研究动机
细胞谱系(Cell Lineage)在生物学中无处不在。最著名的例子之一是胚胎发生:人等生物从一个受精卵发育成完整个体。细胞不断分裂产生子代,逐渐形成在胚胎发育中承担不同功能的谱系。数百年来,这一复杂过程始终吸引着科学家。过去一个半世纪的研究不断深化了人们对它的认识,高通量测序及用于观察和刻画这一过程的谱系追踪(Lineage Tracing)技术进一步推动了这一进展 Woodworth et al., 2017。其中,一些方法能够将细胞状态的测量结果与其历史模型联系起来,帮助我们理解分化轨迹的形成过程。
单细胞实验与谱系追踪技术相结合,使数据集的复杂度呈指数级增长,也对新的计算分析方法提出了迫切需求 Gong et al., 2021。过去五年间,研究者大量借鉴群体遗传学成果,将进化生物学的经典概念与前沿基因组工程技术结合起来。
本章简要介绍这些新技术,重点讲解如何通过计算流程分析实验数据并提取生物学信息。示例聚焦于基于 CRISPR/Cas9 基因编辑系统(clustered regularly interspaced short palindromic repeats/CRISPR-associated protein 9) 的演化型谱系追踪(Evolving Lineage Tracing)。有关其他实验方案,可参阅 McKenna 与 Gagnon 的综述 McKenna & Gagnon, 2019、Wagner 与 Klein 的综述 Wagner & Klein, 2020,以及 VanHorn 与 Morris 的综述 VanHorn & Morris, 2021。
谱系追踪技术
谱系追踪旨在推断所观测细胞之间的祖先与后代关系,主要需要考虑规模和分辨率两个方面。经典方法主要依赖直接观察。例如,20 世纪 70 年代,Sulston 及其同事研究秀丽隐杆线虫 C. elegans,通过在显微镜下细致观察细胞分裂,首次绘制了它的发育谱系 Sulston et al., 1983。这类方法虽然在该领域的发展中发挥了不可或缺的作用,但无法推广到发育谱系更具随机性的复杂生物。
过去二十年间,测序技术与微流控设备的发展推动了多种新型谱系追踪方法的出现 Wagner & Klein, 2020。这些方法可分为两类:“前瞻性(prospective)”或“回溯性(retrospective)”:
前瞻性谱系追踪(prospective lineage tracing)方法能够追踪单个细胞的全部后代,即一个“克隆(clone)” 或“克隆群体(clonal population)”。通常,研究者向一个细胞引入可遗传标记,这个细胞称为“克隆始祖(clonal progenitor)”;标记随后随细胞分裂代代传递。
回溯性谱系追踪(retrospective lineage tracing)方法则利用细胞间的变异,例如自然发生的基因突变,推断谱系模型,即“系统发育(phylogeny)”,以概括克隆群体的细胞分裂历史。
已经开发出几种前瞻性追踪克隆群体的方法:例如,可以利用组织特异性启动子(promoter)下的重组酶来激活荧光标记,使其作为某一特定组织谱系的可遗传标记 Weissman & Pan, 2015,Nagy, 2000,Liu et al., 2020,Liu et al., 2020,He et al., 2017。另一种做法是通过慢病毒转导(lentiviral transduction),将随机 DNA 条形码(Barcode)整合进细胞基因组,作为可遗传标记,再通过测序识别细胞所属的克隆 Gerrits et al., 2010,Biddy et al., 2018,Weinreb et al., 2020,Yao et al., 2017。这些方法虽然可扩展性很高、而且往往不需要繁重的基因组工程,但它们只能报告克隆层面的性质,例如克隆的大小和组成。
回溯性追踪方法突破了上述限制,还能揭示克隆内部的 亚克隆动态。传统方法利用细胞间的天然变异重建细胞分裂历史,例如单核苷酸变异(single-nucleotide variant, SNV)Vogelstein et al., 2013,Turajlic & Swanton, 2016,Bailey et al., 2021,Gerstung et al., 2020,Abyzov & Vaccarino, 2020,Bizzotto et al., 2021,Ju et al., 2017 或拷贝数变异(copy-number variation, CNV)Patel et al., 2014,Gao et al., 2021。这些方法已广泛用于研究人类肿瘤和组织发育史,但研究者很难控制突变发生的频率和位置。在实验模型中,可以设计演化型谱系追踪系统,在保留回溯性方法优势的同时改善这些局限。通常,研究者会在细胞中引入能够积累突变的“记录区”(scratchpad,也称靶位点,target site)Wagner & Klein, 2020,McKenna & Gagnon, 2019。例如,本章重点介绍的方法利用 Cas9 在靶位点引入插入缺失(insertion and deletion, indel)McKenna et al., 2016,Spanjaard et al., 2018,Chan et al., 2019,Frieda et al., 2017,Kalhor et al., 2018,Alemany et al., 2018。细胞谱系由此随时间积累可遗传突变。研究者通过高通量测序读取这些突变,再推断描述细胞谱系的系统发育模型。在此基础上,一些新技术进一步提高了记录的可解释性,例如 peCHYRON Loveless et al., 2021 和 DNA Typewriter Choi et al., 2022 等方法能够按顺序引入编辑,从而提高谱系历史推断的可信度。
两类谱系追踪方法都受益于单细胞多组学(multi-omics)测量技术的发展。例如,研究者已常用单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)同时读取单个细胞的功能状态及其谱系关系 Raj et al., 2018,Chan et al., 2019,Weinreb et al., 2020,Wagner & Klein, 2020,Spanjaard et al., 2018。这种多模态(multimodal)的读出,为新的计算方法创造了机会,我们将在下文详述。
如上所述,本章我们提供 一份详细的操作指南,讲解如何分析来自基于 CRISPR/Cas9 的演化型谱系追踪器的数据。
为方便初次接触本领域的读者,下面汇总上述几个术语的含义:
克隆群体(或称克隆):某个祖细胞的全部后代。
克隆始祖:产生某个克隆群体的最初那个单细胞。
亚克隆分辨率(subclonal resolution):分辨克隆群体内部不同细胞子集之间关系的能力。
系统发育关系:一个克隆群体的细胞分裂史模型,以树的形式表示。
记录区(或称靶位点):一段人工合成的外源区域,能够在演化型谱系追踪技术中积累定向变异。
演化型谱系追踪数据分析流程概览
在深入分析我们的示例数据集之前,我们先概述一下用于分析演化型追踪器所生成数据的计算流程(基于 Jones et al., 2020)。这类分析通常从靶位点的 扩增子(amplicon)文库(library)的原始测序数据开始,数据常来自 10X Chromium 等常规 scRNA-seq 平台。扩增子长度通常为 150–300 bp,具体取决于实验技术。对于基于 CRISPR/Cas9 的演化型追踪系统,每条读段(Read)包含一个或多个 Cas9 切割位点。预处理时,需要将 Reads 比对到参考序列,并识别 indel 等突变。
虽然这些数据集的预处理是关键的一步,但限于篇幅,我们着重介绍以预处理后的测序数据作为输入的分析流程,并请读者参阅一份外部的预处理教程,其地址见 此处。
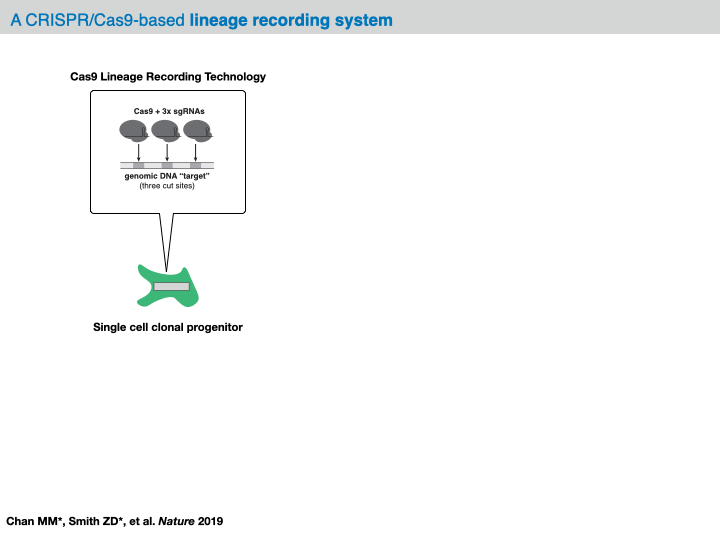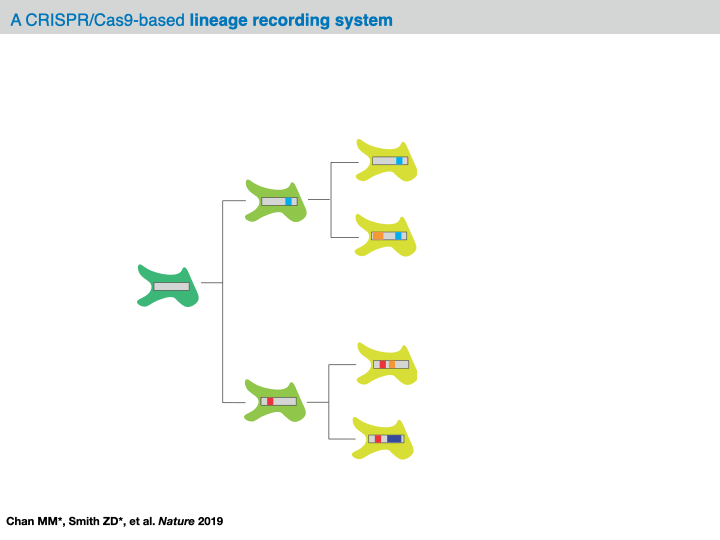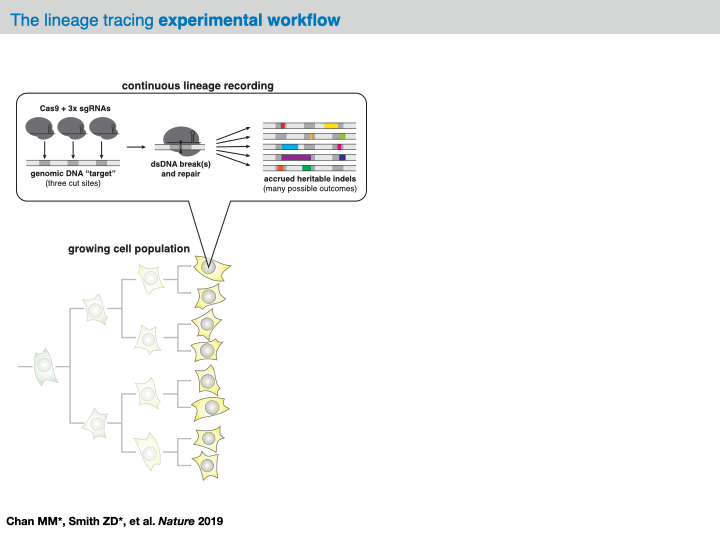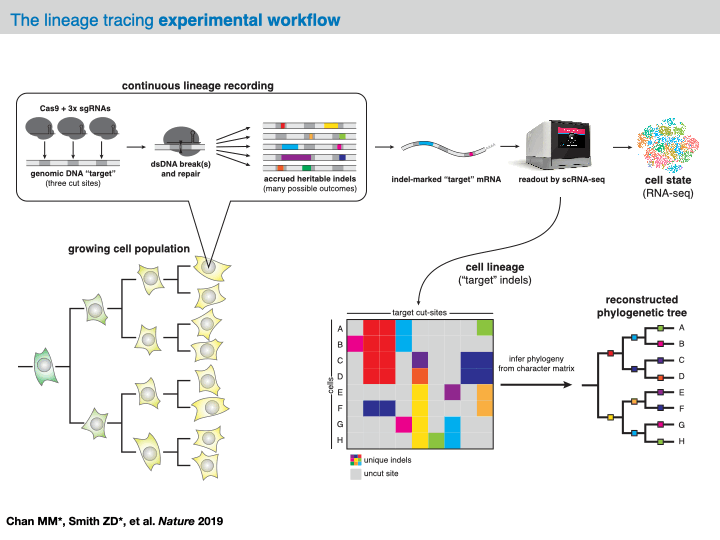
在多数分析框架中,原始 Reads 经预处理后会转换为 性状矩阵(character matrix),用于汇总每个细胞各靶位点上的突变。矩阵每行代表一个细胞(样本),每列代表一个靶位点(性状,character);矩阵元素是分类变量,表示该细胞相应切割位点上的 indel 类型(性状状态,character state)。不同技术生成的矩阵通常包含 100–10,000 个样本和最多约 100 个性状。
性状矩阵将不同实验技术的细节抽象为统一表示,使我们能够通过计算推断细胞的 系统发育树(phylogenetic tree)。目标是构建一个涵盖矩阵中全部细胞的层次树结构:每个节点代表一个样本,每条边代表一种谱系关系。通常,我们实际观测到的只有树的 叶节点(leaves),未观测到的内部节点则称为 祖先(ancestral)节点。这里对“系统发育树”采用较宽泛的用法;严格来说,推断结果往往是概括细胞间关系的分支图(cladogram)。
从性状矩阵推断系统发育树的算法大体分为基于性状和基于距离两类:
基于性状(character-based)的方法:在可能的树拓扑中进行组合搜索,优化根据性状定义的目标函数,例如观测到相应突变时某段进化史的似然。
最大简约法(Maximum Parsimony, MP)Cavalli-Sforza & Edwards, 1963:寻找突变次数最少的树。
最大似然法(Maximum Likelihood, ML)Felsenstein, 1981:寻找具有最大突变历史似然的树(谱系追踪专用算法 GAPML 见 Feng et al., 2021)。
贝叶斯系统发育推断(Bayesian Phylogenetic Inference)Huelsenbeck et al., 2001:找到一棵在给定观测突变的条件下、使进化史后验概率(posterior probability)最大化的树。
基于距离(distance-based)的方法:使用细胞间距离的概念(例如它们共享的编辑数目,记作 )来推断系统发育树,通常以多项式时间运行。基于距离的方法虽然能快得多,但需要迭代地寻找最佳的细胞间相异度函数,而这同样可能很耗时。
邻接法(neighbor joining, NJ)Saitou & Nei, 1987:通过迭代地寻找“按特定准则使分支长度最小”的细胞对,从给定的细胞间相异度矩阵生成一棵树。
非加权算术平均配对法(unweighted pair group method with arithmetic mean, UPGMA)Sokal, 1958:从细胞间相异度矩阵生成树,速度比邻接法更快,但要获得准确结果,需要满足更严格的假设。
传统上,从这类数据推断系统发育是颇具挑战的,往往需要应用可扩展性很差的组合算法。当把这类算法应用到前面所述的单细胞演化型谱系追踪器时,这些问题会进一步恶化,因为被采样的细胞数往往比传统系统发育研究中所评估的物种数大一个数量级。非随机的缺失数据和不均匀的编辑分布,又使这些挑战雪上加霜。幸运的是,近来已经出现了一些算法进展,用于应对演化型谱系追踪器的建模挑战 Jones et al., 2020,Feng et al., 2021,Gong et al., 2021,以及借助深度分布式计算把推断扩展到极其庞大的树 Konno et al., 2022。实际应用中,多数研究使用最大简约法的变体或邻接法等基于距离的方法推断树结构。这一领域仍在快速发展,进一步讨论见“结论”。
在完成系统发育树重建之后,有几种选择可用于 下游分析,例如估计发育过程中细胞状态变化的速率,或群体内各细胞分裂的相对倾向。下面通过代码示例串联这些步骤,分析细胞谱系背后的动态过程。
Cassiopeia 用于谱系追踪分析
本教程将主要使用 Cassiopeia;它是少数用于谱系追踪分析的软件包之一 Jones et al., 2020。
总体而言,Cassiopeia 是一个软件套件,用于处理和分析演化型谱系追踪的测序数据。该软件包含四个主要模块:
将演化型谱系追踪数据(如基于 CRISPR/Cas9 的追踪数据)中的 Reads 预处理为性状矩阵。
利用软件提供的多种算法,从性状矩阵重建系统发育树。
通过分析工具从重建的系统发育树中提取生物学信息。
模拟接近真实情况的系统发育树与谱系追踪数据,用于基准测试。
这些模块既可以组合成 Cassiopeia 分析流程,也可以独立使用。例如,用户可以用其他软件推断谱系,再用 Cassiopeia 提供的工具完成重建后的分析。
关于更多的安装指南和补充文档,请读者参阅 此处。
在小鼠肺癌模型中追踪肿瘤发育
本案例使用以下研究的数据 Yang et al., 2022。研究者将基于 CRISPR/Cas9 的演化型谱系追踪系统整合进非小细胞肺癌(non-small-cell lung cancer, NSCLC)的 KP 小鼠模型 DuPage et al., 2009。具体来说,这个小鼠模型携带致癌性的 Kras 和 Tp53 突变,通常处于未激活状态。通过吸入慢病毒引入 Cre 重组酶后,肺气道上皮的单个细胞中这些致癌突变被激活,诱导肿瘤形成。谱系追踪系统受到类似调控,因而与肿瘤诱导同时启动。
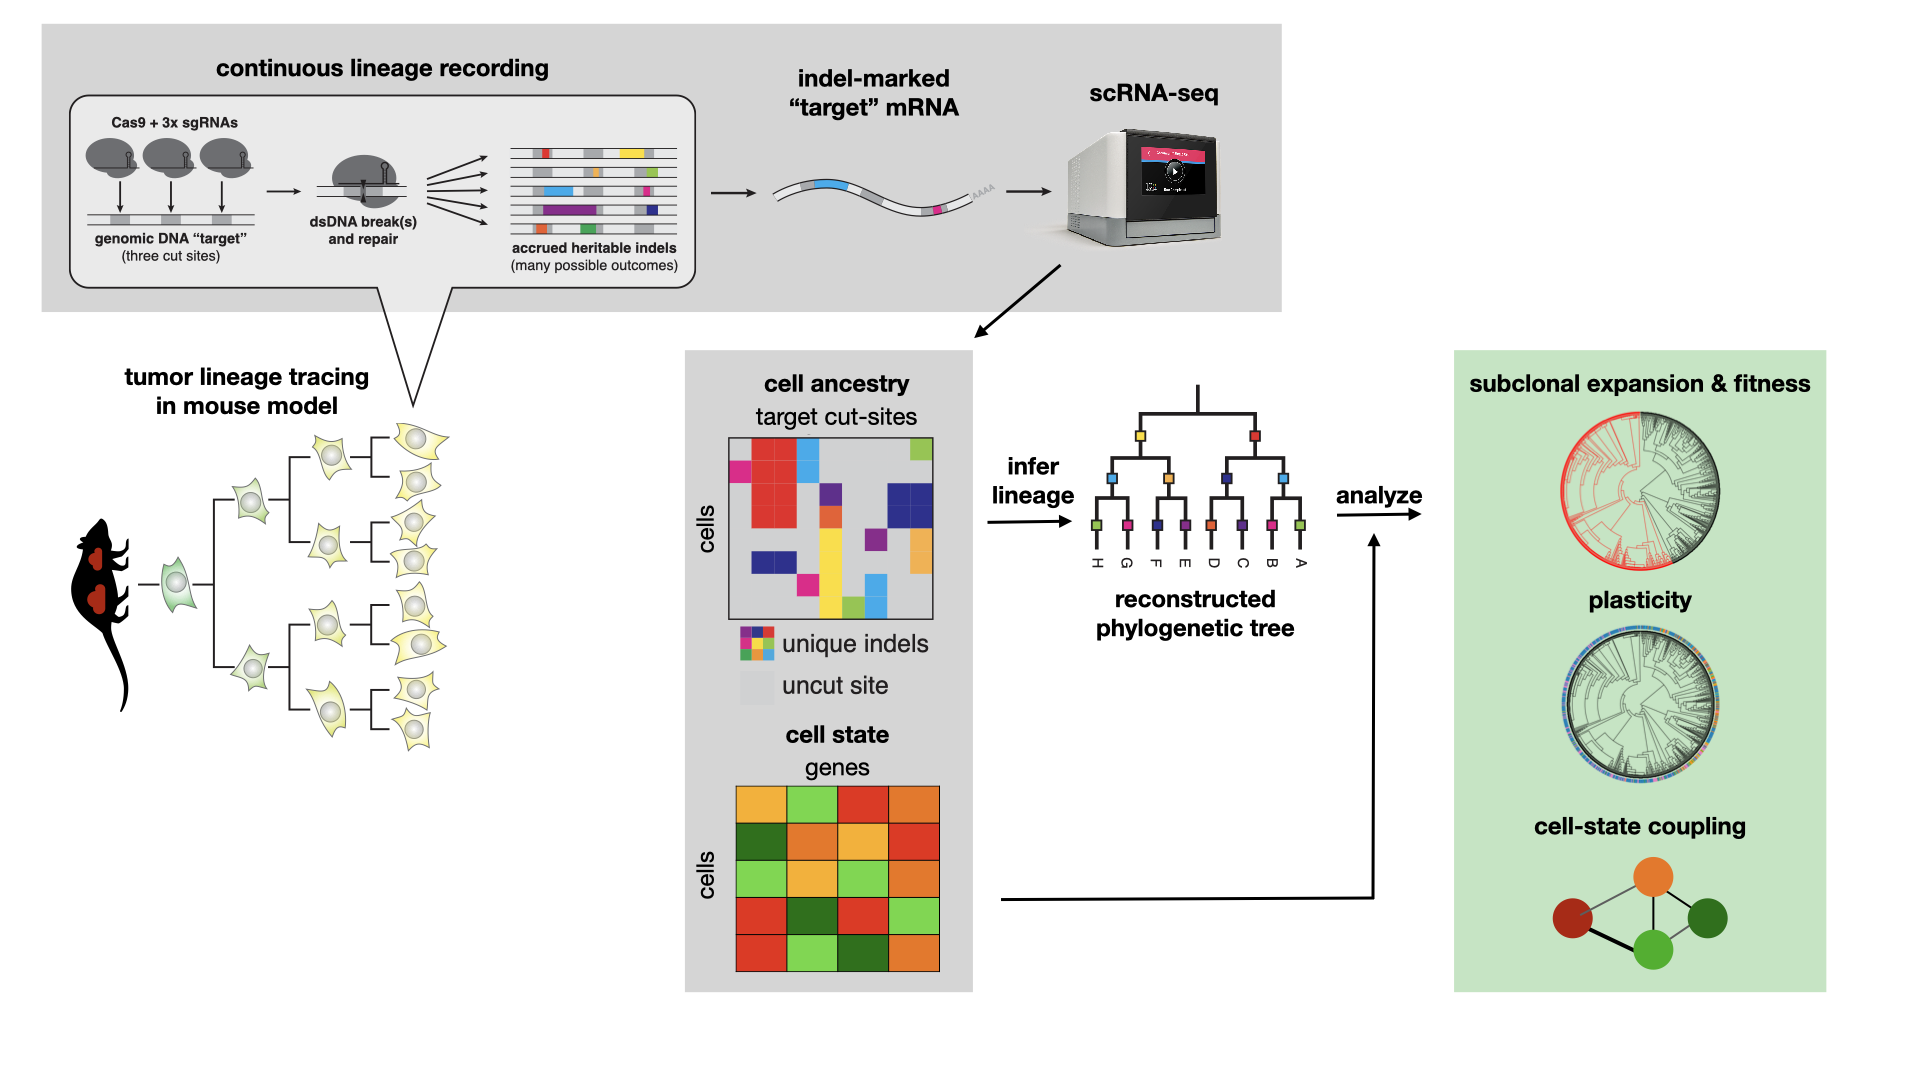
研究者利用该系统,从肿瘤的单细胞起源开始追踪约 4.5–6 个月,随后采集具有侵袭性和转移能力的肿瘤。肿瘤解离后,同时测量单个细胞的谱系追踪靶位点和 RNA,最终获得覆盖 100 多个肿瘤、70,000 多个细胞的谱系及 scRNA-seq 数据。
在本教程中,我们将展示用户如何利用处理好的靶位点数据,来研究谱系的一些有趣的动态特性。在整个案例研究中,每个谱系都对应于从小鼠肺中采样的一个原发性肿瘤。
分析前,需要明确两类输入数据:scRNA-seq 计数矩阵(Count Matrix),以及独立的谱系追踪数据。后者可有多种形式,本例从 等位基因表(allele table)开始,其中汇总了每个细胞各靶位点上的 indel,详见下文。两类数据分别处理:谱系追踪数据用于重建谱系,scRNA-seq 数据用于解释这些谱系的生物学行为。
下述数据中,每个细胞约有 10 个经过工程改造引入的靶位点,每个靶位点串联包含 3 个 Cas9 切割位点,并由唯一的整合条形码(Integration Barcode, intBC)标识。因此,每个细胞预期有 3 × 靶位点数个性状,可通过积累突变记录谱系信息。测序盒结构的详细说明见 Chan, Smith et al. Molecular recording of mammalian embryogenesis. Nature 2019。
!wget "https://zenodo.org/record/5847462/files/KPTracer-Data.tar.gz?download=1"输出
--2022-06-30 10:28:22--  https://zenodo.org/record/5847462/files/KPTracer-Data.tar.gz?download=1
Resolving zenodo.org (zenodo.org)... 137.138.76.77
Connecting to zenodo.org (zenodo.org)|137.138.76.77|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 1304975216 (1.2G) [application/octet-stream]
Saving to: ‘KPTracer-Data.tar.gz?download=1’

KPTracer-Data.tar.g 100%[===================>]   1.21G  1.49MB/s    in 7m 3s

2022-06-30 10:35:27 (2.94 MB/s) - ‘KPTracer-Data.tar.gz?download=1’ saved [1304975216/1304975216]
!tar -xvzf KPTracer-Data.tar.gz?download=1环境设置
在进入本笔记本的分析之前,我们先搭建好运行环境。
import cassiopeia as cas
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import scanpy as sc
from cassiopeia.preprocess import lineage_utils查看数据
在对靶位点测序数据进行预处理之后,Cassiopeia 使用一个 allele_table 来汇总在每个靶位点整合上观察到的突变。
如上所述,每个细胞约有 10 个靶位点,每个靶位点包含 3 个 Cas9 切割位点。表中的 intBC 列标识靶位点,r* 列记录该靶位点上的 Cas9 切割位点。每个切割位点的突变以简洁比对表示(Concise Idiosyncratic Gapped Alignment Report, CIGAR)字符串保存,描述 indel 的大小和类型。
表中还可保存其他元数据(metadata),包括该靶位点分子对应的唯一分子标识符(Unique Molecular Identifier, UMI)总数和 Read 总数、分子来源细胞,以及细胞所属的肿瘤。
allele_table = pd.read_csv(
    "KPTracer-Data/KPTracer.alleleTable.FINAL.txt", sep="\t", index_col=0
)

allele_table.head(5)
输出
/var/folders/kt/wk3kbll507v4h18f8nmbzkl80000gq/T/ipykernel_65366/3031588044.py:1: DtypeWarning: Columns (12) have mixed types. Specify dtype option on import or set low_memory=False.
  allele_table = pd.read_csv("KPTracer-Data/KPTracer.alleleTable.FINAL.txt", sep='\t', index_col = 0)
我们将聚焦于没有任何额外扰动的 KP 肿瘤数据:
all_tumors = allele_table["Tumor"].unique()
primary_nt_tumors = [
    tumor
    for tumor in all_tumors
    if "NT" in tumor and tumor.split("_")[2].startswith("T")
]

primary_nt_allele_table = allele_table[allele_table["Tumor"].isin(primary_nt_tumors)]
如上所述,我们预计每个肿瘤群体约有 10 个不同的 整合条形码(integration barcode, intBC)(即靶位点)。下面汇总该数据集的几个关键统计量。
每个肿瘤的 intBC 数量
分析人员感兴趣的一个统计量是 每个肿瘤的 intBC 数,因为它能反映出每个克隆群体的信息容量。
在近期应用中(Yang et al., 2022),高质量克隆通常包含 5–30 个 intBC,对应 15–90 个性状。绘制每个肿瘤的 intBC 数,有助于发现需要在重建前过滤的异常肿瘤。
primary_nt_allele_table.groupby(["Tumor"]).agg({"intBC": "nunique"}).plot(kind="bar")
plt.ylabel("Number of unique intBCs")
plt.title("Number of intBCs per Tumor")
plt.show()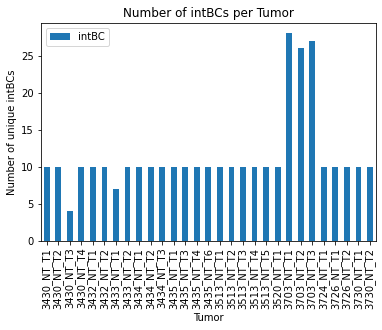
正如所料,我们观察到大多数肿瘤有大约 10 个 intBC,而有一个肿瘤观察到的 intBC 很少,另有少数报告超过 25 个 intBC。接下来,我们将讨论过滤掉低质量肿瘤的策略。
每个肿瘤的大小
我们还需要检查待重建肿瘤的细胞数。常见克隆包含 100–10,000 个细胞,需特别排查规模过小、不适合重建的克隆,通常指少于 100 个细胞的克隆。
primary_nt_allele_table.groupby(["Tumor"]).agg({"cellBC": "nunique"}).sort_values(
    by="cellBC", ascending=False
).plot(kind="bar")
plt.yscale("log")
plt.ylabel("Number of cells (log)")
plt.title("Size of each tumor")
plt.show()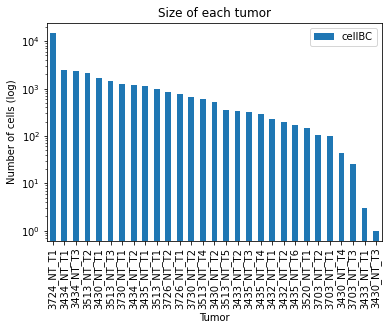
我们看到,有一个非常大的克隆(约 30,000 个细胞),其余克隆都在预期范围内,报告的细胞数在 1,000 到 5,000 之间。
为谱系重建准备数据
基于 Cas9 的追踪器有一个普遍特点:某些插入和缺失要比其他的常见得多。这可能是一个重要的建模隐患,因为高概率的编辑可能彼此独立地多次发生,从而可能让分析者错误地认为两个细胞彼此相关。
Cassiopeia 内置了一个实用工具,通过统计某个 indel 在不相关的肿瘤或 intBC 中出现的次数,来估计插入和缺失的先验概率(prior probability)。
从 indel 频率可以看到,少数小片段插入或缺失在多个克隆中频繁出现,另一些编辑仅见于一个克隆。下游分析应考虑这些突变频率差异造成的偏差。
indel_priors = cas.pp.compute_empirical_indel_priors(
    allele_table, grouping_variables=["intBC", "MetFamily"]
)

indel_priors.sort_values(by="count", ascending=False).head()indel_priors.sort_values(by="count").head(5)过滤低质量肿瘤
在肿瘤重建之前,我们会过滤掉那些 (i) 谱系追踪动力学较差、或 (ii) 太小而不值得分析的肿瘤。
在以往研究中(Quinn et al., 2021 和 Yang et al., 2022),我们发现,查看以下统计量有助于判断肿瘤的质量:
独特状态比例:肿瘤中独特谱系状态所占的百分比。
切割比例:这是在一群细胞中发生突变的 Cas9 靶位点所占的百分比。
耗尽比例:在所有细胞中均相同、因而无法再区分细胞的靶位点所占的比例。
肿瘤大小:肿瘤中的细胞数量。
# utility functions for computing summary statistics


def compute_percent_indels(character_matrix):
    """Computes the percentage of sites carrying indels in a character matrix.

    Args:
        character_matrix: A pandas Dataframe summarizing the mutation status of each cell.

    Returns:
        A percentage of sites in cells that contain an edit.
    """
    all_vals = character_matrix.values.ravel()
    num_not_missing = len([n for n in all_vals if n != -1])
    num_uncut = len([n for n in all_vals if n == 0])

    return 1.0 - (num_uncut / num_not_missing)


def compute_percent_uncut(cell):
    """Computes the percentage of sites uncut in a cell.

    Args:
        A vector containing the edited sites for a particular cell.

    Returns:
        The number of sites uncut in a cell.
    """
    uncut = 0
    for i in cell:
        if i == 0:
            uncut += 1
    return uncut / max(1, len([i for i in cell if i != -1]))


def summarize_tumor_quality(
    allele_table,
    minimum_intbc_thresh=0.2,
    minimum_number_of_cells=2,
    maximum_percent_uncut_in_cell=0.8,
    allele_rep_thresh=0.98,
):
    """Compute QC statistics for each tumor.

    Computes statistics for each clone that will be used for filtering tumors for downstream lineage reconstruction.

    Args:
        allele_table: A Cassipoeia allele table summarizing the indels on each molecule in each cell.
        min_intbc_thresh: The minimum proportion of cells that an intBC must appear in to be considered
            for downstream reconstruction.
        minimum_number_of_cells: Minimum number of cells in a tumor to be processed in this QC pipeline.
        maximum_percent_uncut_in_cell: The maximum percentage of sites allowed to be uncut in a cell. If
            a cell exceeds this threshold, it is filtered out.
        allele_rep_thresh: Maximum allele representation in a single cut site allowed. If a character has
            less diversity than allowed, it is filtered out.

    Returns:
        A pandas Dataframe summarizing the quality-control information for each tumor.
    """
    tumor_statistics = {}
    NUMBER_OF_SITES_PER_INTBC = 3

    # iterate through Tumors and compute summary statistics
    for tumor_name, tumor_allele_table in allele_table.groupby("Tumor"):
        if tumor_allele_table["cellBC"].nunique() < minimum_number_of_cells:
            continue

        tumor_allele_table = allele_table[allele_table["Tumor"] == tumor_name].copy()
        tumor_allele_table["lineageGrp"] = tumor_allele_table["Tumor"].copy()
        lineage_group = lineage_utils.filter_intbcs_final_lineages(
            tumor_allele_table, min_intbc_thresh=minimum_intbc_thresh
        )[0]

        number_of_cutsites = (
            len(lineage_group["intBC"].unique()) * NUMBER_OF_SITES_PER_INTBC
        )

        character_matrix, _, _ = cas.pp.convert_alleletable_to_character_matrix(
            lineage_group, allele_rep_thresh=allele_rep_thresh
        )

        # We'll hit this if we filter out all characters with the specified allele_rep_thresh
        if character_matrix.shape[1] == 0:
            character_matrix, _, _ = cas.pp.convert_alleletable_to_character_matrix(
                lineage_group, allele_rep_thresh=1.0
            )

        number_dropped_intbcs = number_of_cutsites - character_matrix.shape[1]
        percent_uncut = character_matrix.apply(
            lambda x: compute_percent_uncut(x.values), axis=1
        )

        # drop normal cells from lineage (cells without editing)
        character_matrix_filtered = character_matrix[
            percent_uncut < maximum_percent_uncut_in_cell
        ]

        percent_unique = (
            character_matrix_filtered.drop_duplicates().shape[0]
            / character_matrix_filtered.shape[0]
        )
        tumor_statistics[tumor_name] = (
            percent_unique,
            compute_percent_indels(character_matrix_filtered),
            number_dropped_intbcs,
            1.0 - (number_dropped_intbcs / number_of_cutsites),
            character_matrix_filtered.shape[0],
        )

    tumor_clone_statistics = pd.DataFrame.from_dict(
        tumor_statistics,
        orient="index",
        columns=[
            "PercentUnique",
            "CutRate",
            "NumSaturatedTargets",
            "PercentUnsaturatedTargets",
            "NumCells",
        ],
    )

return tumor_clone_statistics计算并可视化肿瘤统计量
tumor_clone_statistics = summarize_tumor_quality(primary_nt_allele_table)NUM_CELLS_THRESH = 100
PERCENT_UNIQUE_THRESH = 0.05
PERCENT_UNSATURATED_TARGETS_THRESH = 0.2
low_qc = tumor_clone_statistics[
(tumor_clone_statistics["PercentUnique"] <= PERCENT_UNIQUE_THRESH)
| (
tumor_clone_statistics["PercentUnsaturatedTargets"]
<= PERCENT_UNSATURATED_TARGETS_THRESH
)
].index
small = tumor_clone_statistics[
(tumor_clone_statistics["NumCells"] < NUM_CELLS_THRESH)
].index
unfiltered = np.setdiff1d(tumor_clone_statistics.index, np.union1d(low_qc, small))
h = plt.figure(figsize=(6, 6))
plt.scatter(
tumor_clone_statistics.loc[unfiltered, "PercentUnsaturatedTargets"],
tumor_clone_statistics.loc[unfiltered, "PercentUnique"],
color="black",
)
plt.scatter(
tumor_clone_statistics.loc[low_qc, "PercentUnsaturatedTargets"],
tumor_clone_statistics.loc[low_qc, "PercentUnique"],
color="red",
label="Poor QC",
)
plt.scatter(
tumor_clone_statistics.loc[small, "PercentUnsaturatedTargets"],
tumor_clone_statistics.loc[small, "PercentUnique"],
color="orange",
label="Small lineages",
)
plt.axhline(y=PERCENT_UNIQUE_THRESH, color="red", alpha=0.5)
plt.axvline(x=PERCENT_UNSATURATED_TARGETS_THRESH, color="red", alpha=0.5)
plt.xlabel("Percent Unsaturated")
plt.ylabel("Percent Unique")
plt.title("Summary statistics for Tumor lineages")
plt.legend(loc="lower right")
plt.show()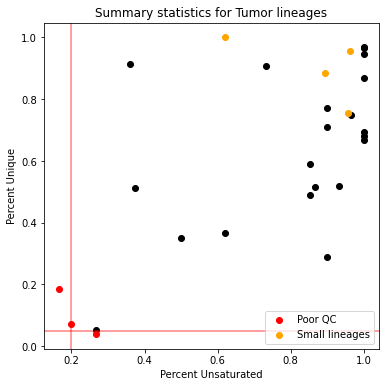
这张图概括了我们质量控制(quality control, QC)过滤的工作。每个点对应一个肿瘤,其颜色表示它的过滤状态:
被标为 红色 的肿瘤会被过滤,因为独特状态或可用于重建的性状太少。
被标为 橙色 的肿瘤会被过滤,因为细胞数不足以进行重建;这里的阈值为 100 个细胞。
被标为 黑色 的肿瘤已通过我们的质量控制过滤,将被纳入重建考虑。
肿瘤 3726_NT_T1 的谱系追踪数据质量较好,下面使用 Cassiopeia 重建其谱系。
重建所选肿瘤(3726_NT_T1)
重建谱系前,需要将所选肿瘤的等位基因(allele)表转换为性状矩阵,汇总每个细胞各靶位点上的突变。默认以 0 表示未切割位点,-1 表示缺失位点,其余数值分别对应不同的 indel。
肿瘤 3726_NT_T1 的谱系追踪数据质量较好,下面使用 Cassiopeia 重建其谱系。
tumor = "3726_NT_T1"

tumor_allele_table = primary_nt_allele_table[primary_nt_allele_table["Tumor"] == tumor]

n_cells = tumor_allele_table["cellBC"].nunique()
n_intbc = tumor_allele_table["intBC"].nunique()

print(
    f"Tumor population {tumor} has {n_cells} cells and {n_intbc} intBCs ({n_intbc * 3} characters)."
)
Tumor population 3726_NT_T1 has 772 cells and 10 intBCs (30) characters.
(
    character_matrix,
    priors,
    state_to_indel,
) = cas.pp.convert_alleletable_to_character_matrix(
    tumor_allele_table, allele_rep_thresh=0.9, mutation_priors=indel_priors
)

character_matrix.head(5)
Dropping the following intBCs due to lack of diversity with threshold 0.9: ['ACTCTGCTCCAGATr2', 'ACTCTGCTCCAGATr3', 'GCCTACTTAAGTCCr1', 'GTTTATTTCCGTATr3', 'TATGATTAGTCGCGr1', 'TATGATTAGTCGCGr2', 'TGATATAAATCTTTr2', 'TTCCCTATTTGCTAr2', 'TGTTTTTGTCTGCAr1', 'ACAGGTGCTCAAATr1', 'ACAGGTGCTCAAATr2', 'ACAGGTGCTCAAATr3']
重建谱系
多种系统发育推断算法都能接收 Cassiopeia 使用的通用性状矩阵格式。Cassiopeia 已实现其中若干算法,其他算法也可以通过通用的 CassiopeiaSolver 应用程序编程接口(application programming interface, API) 接入。常用算法包括:
VanillaGreedy:一个简单高效、基于启发式的算法,适合作为谱系重建的初步尝试。它基于经典的 Gusfield 算法 Gusfield, 1991,相关描述见 Jones et al., 2020。
邻接法:经典的基于距离的算法,详见 Saitou & Nei, 1987。
UPGMA:高效的基于距离的算法,对样本之间的关系有特定假设,最早见于 Sokal, 1958。
ILPSolver:斯坦纳树(Steiner Tree)优化推断算法的一种实现,详见 Jones et al., 2020。这个算法很慢(通常无法扩展到约 1500 个细胞以上),但很精确。
HybridSolver:采用分治(divide and conquer)策略的混合算法,先用贪心算法(greedy algorithm)自顶向下划分数据,再用精确算法 ILPSolver 求解各子问题。详见 Jones et al., 2020。
对于手头这个教程,我们将使用 VanillaGreedySolver。其余的求解器来自 Cassiopeia 代码库,也可以作为替代方案接入。
为了进行推断,我们会实例化一个 CassiopeiaTree,用于保存性状矩阵和谱系元数据,并提供树操作工具。接着实例化 VanillaGreedySolver,用它推断树结构并写入 tree 字段;该字段属于 CassiopeiaTree 对象。
选择算法时,应同时考虑数据规模和已有基准测试结果,并用几种算法进行比较。根据经验,HybridSolver 在可扩展性和精度之间取得了不错的平衡,而 邻接法(Neighbor-Joining, NJ)便于作为对照。邻接法属于基于距离的方法,与基于性状的方法不同,因此可能揭示谱系的不同部分。本教程采用 GreedySolver:它速度快,适合先做初步分析,再视需要使用更精确但更慢的算法。
tree = cas.data.CassiopeiaTree(character_matrix=character_matrix, priors=priors)greedy_solver = cas.solver.VanillaGreedySolver()运行 greedy_solver.solve 即可完成树推断,并将结果写入 tree 字段;该字段属于 CassiopeiaTree 对象。
推断完成后,我们可以借助 Cassiopeia 的可视化库来研究得到的树结构。我们会注意到推断中存在一些错误,但总体而言,大群细胞似乎都被正确地放置了。如上所述,在部署更耗时、更复杂的算法之前,这可以作为对数据的一次很好的初步分析。
greedy_solver.solve(tree)

cas.pl.plot_matplotlib(tree, orient="right", allele_table=tumor_allele_table)100%|██████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 30/30 [00:11<00:00, 2.71it/s]
(<Figure size 504x504 with 1 Axes>, <AxesSubplot:>)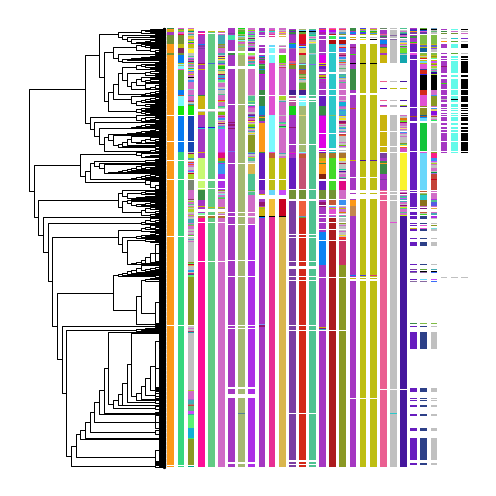
这种重建的可视化表示,对于评估算法性能非常有用。评估这些重建的性能可能相当困难,但随着实践会变得容易些。开始评估性能时的一个好技巧是:选定某一列,看某个给定的 indel 是否在彼此不相关的细胞组中出现了不止一次。这可能意味着存在算法错误。
可以看到,大多数细胞(热图中的行)都位于编辑状态相似的细胞邻域中。因此,某些切割位点上的 indel 会形成边界清晰的分组,例如左起第 4 列的粉色等位基因。如果多个等位基因都把同一批细胞归在一起,我们也会更有信心认为重建结果可靠,例如第 4 列的粉色等位基因、第 6 列的浅紫色等位基因等。
不过,从这次重建中也能看出一些错误。例如,在第 4 列中,有两组都共享一个紫色等位基因的细胞被分开了。热图中还有其他等位基因表明它们本应被聚在一起,这说明这里存在一个算法错误。
正如我们上面所讨论的,由于分析者可以选用好几种算法, 应用几种算法来作比较,往往是有益的。
从树中量化动态特性
谱系树还能帮助我们量化具有生物学意义的群体性质,例如:
发生时间 和 位置,对应“扩张”事件,即某个群体的生长速度超过周围细胞群体的事件。
单个细胞的适应度(fitness)(即相对生长速率)
群体中 细胞状态 的变化次数(即可塑性(plasticity))
细胞群体中常见的 分化程序。
还存在其他几项下游分析任务,而且这是一个不断壮大的研究领域。
下面给出若干示例,说明如何使用 Cassiopeia 推断其中一些参数。
推断扩张事件
我们将使用 compute_expansion_pvalues 评估树中某个内部节点是否产生了生长更快的群体。该方法最早见于 Yang et al., 2022:它通过深度优先搜索(depth-first search, DFS)遍历树,为各内部节点计算在中性进化模型(neutral model of evolution)下产生相应后代数目的概率。值得关注的超参数包括:
min_clade_size:纳入考虑的进化枝(clade,即某个内部节点之下的叶数)的最小规模。常见的情况是,过小的进化枝信息量不足。min_depth:扩张起点的最小深度。将min_depth设为 0 时,根节点也可被判定为扩张起点;更合理的设置为 1,即从根节点的下一层开始。
通过这一流程,我们可以筛查各个节点,并标出正在发生扩张的位置。例如,在 Yang et al., 2022 中,作者提出了一种标出最重要扩张事件的策略。下面,我们用红色标出一个有趣的扩张事件。
cas.tl.compute_expansion_pvalues(tree, min_clade_size=(0.15 * tree.n_cell), min_depth=1)# this specifies a p-value for identifying expansions unlikely to have occurred
# in a neutral model of evolution
probability_threshold = 0.01
expanding_nodes = []
for node in tree.depth_first_traverse_nodes():
if tree.get_attribute(node, "expansion_pvalue") < probability_threshold:
expanding_nodes.append(node)cas.pl.plot_matplotlib(tree, clade_colors={expanding_nodes[6]: "red"})(<Figure size 504x504 with 1 Axes>, <AxesSubplot:>)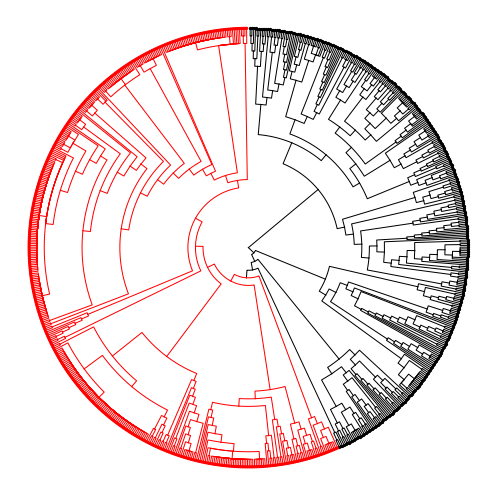
在标出扩张发生位置的同时,我们可以把树划分为侵袭性更强和更弱的亚群。我们用红色突出其中一个可能更具侵袭性的群体,因为它是一个被检测到的扩张。
在原始研究中,作者发现 特定转录模式 与 扩张区域 相关,这些转录模式可能赋予细胞适合度优势。
推断树的可塑性
该模型的肿瘤包含处于不同转录状态的细胞。可以通过统一流形近似与投影(Uniform Manifold Approximation and Projection, UMAP)等低维投影观察数据的异质性:
kptracer_adata = sc.read_h5ad("KPTracer-Data/expression/adata_processed.nt.h5ad")
sc.pl.umap(
    kptracer_adata,
    color="Cluster-Name",
    show=False,
    title="Cluster Annotations, full dataset",
)
plt.show()

# plot only tumor of interest
fig = plt.figure(figsize=(10, 6))
ax = plt.gca()
sc.pl.umap(kptracer_adata[tree.leaves, :], color="Cluster-Name", show=False, ax=ax)
sc.pl.umap(
    kptracer_adata[np.setdiff1d(kptracer_adata.obs_names, tree.leaves), :],
    show=False,
    ax=ax,
    title=f"Cluster Annotations, {tumor}",
)
plt.show()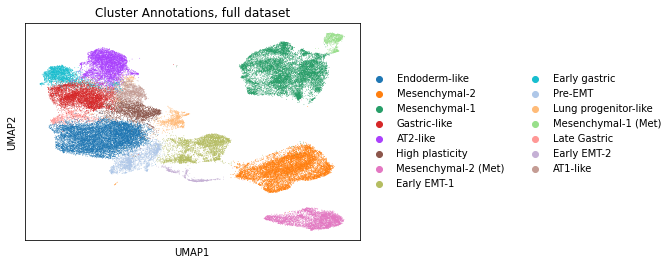
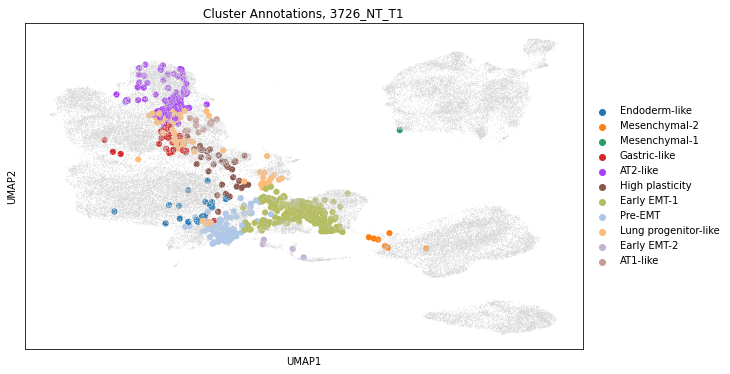
把单细胞转录组聚类在 UMAP 上可视化,会揭示出一个 连续的细胞状态谱。这些状态此前已有报道,符合作者的预期,也提示基于 CRISPR/Cas9 的记录过程并未明显扰乱肿瘤发育。
我们也可以只取出我们感兴趣的肿瘤中的细胞,会观察到即便在这个 单个肿瘤中,细胞 也占据着各不相同的转录状态。
另外,我们可以把细胞状态的分配叠加到树的层次结构上,评估细胞状态的可遗传性。在可视化中可以看到,谱系的某些部分比其他部分更为混杂。
tree.cell_meta = pd.DataFrame(
    kptracer_adata.obs.loc[tree.leaves, "Cluster-Name"].astype(str)
)

cas.pl.plot_matplotlib(tree, meta_data=["Cluster-Name"])
(<Figure size 504x504 with 1 Axes>, <AxesSubplot:>)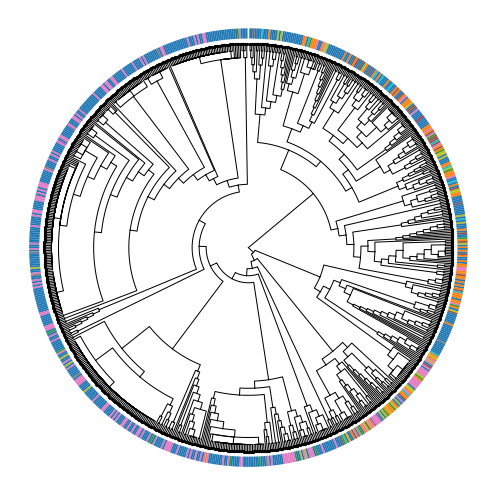
在上面的可视化中,树外侧的颜色条代表每个细胞的聚类注释。如果状态在几代之间非常稳定,我们会预期相邻细胞之间的状态分配高度一致。然而,从上图可以看到,细胞的状态往往与它最近的邻居不同(尤其是在系统发育树的右侧)。
细胞状态的不稳定性 被称为 “有效可塑性(effective plasticity)”,可以用多种算法量化。例如,Fitch–Hartigan 最大简约算法估计产生当前观测模式至少需要多少次细胞状态改变。Cassiopeia 已实现该功能,调用如下:
parsimony = cas.tl.score_small_parsimony(tree, meta_item="Cluster-Name")

plasticity = parsimony / len(tree.nodes)

print(f"Observed effective plasticity score of {plasticity}.")
Observed effective plasticity score of 0.2356902356902357.
这个有效可塑性分数是一个介于 0 到 1 之间的分数,表示谱系整体的混杂程度。0 分表示完全没有混杂,1 分表示每个细胞的状态都与它的姊妹细胞不同。
我们往往更关心有效可塑性的单细胞层面度量。我们可以按如下方式计算单细胞可塑性分数:
# compute plasticities for each node in the tree
for node in tree.depth_first_traverse_nodes():
    effective_plasticity = cas.tl.score_small_parsimony(
        tree, meta_item="Cluster-Name", root=node
    )
    size_of_subtree = len(tree.leaves_in_subtree(node))
    tree.set_attribute(
        node, "effective_plasticity", effective_plasticity / size_of_subtree
    )

tree.cell_meta["scPlasticity"] = 0
for leaf in tree.leaves:
    plasticities = []
    parent = tree.parent(leaf)
    while True:
        plasticities.append(tree.get_attribute(parent, "effective_plasticity"))
        if parent == tree.root:
            break
        parent = tree.parent(parent)

    tree.cell_meta.loc[leaf, "scPlasticity"] = np.mean(plasticities)
cas.pl.plot_matplotlib(tree, meta_data=["scPlasticity"])
kptracer_adata.obs["scPlasticity"] = np.nan
kptracer_adata.obs.loc[tree.leaves, "scPlasticity"] = tree.cell_meta["scPlasticity"]
# plot only tumor of interest
fig = plt.figure(figsize=(10, 6))
ax = plt.gca()
sc.pl.umap(kptracer_adata[tree.leaves, :], color="scPlasticity", show=False, ax=ax)
sc.pl.umap(
kptracer_adata[np.setdiff1d(kptracer_adata.obs_names, tree.leaves), :],
show=False,
ax=ax,
)
plt.title(f"Single-cell Effective Plasticity, {tumor}")
plt.show()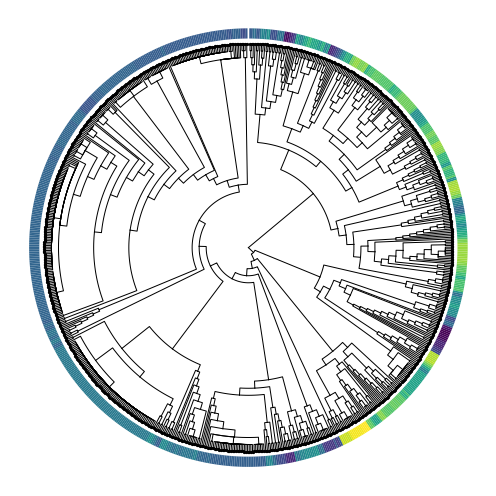
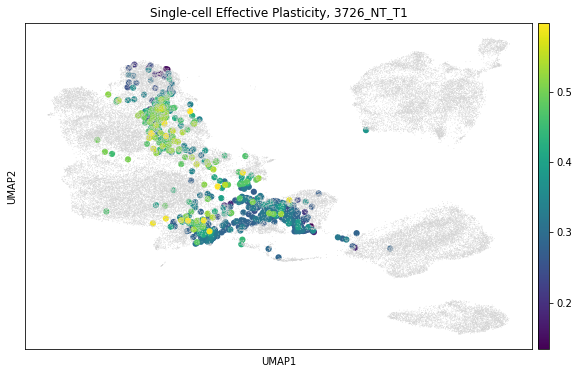
将树结构与低维可视化中的 推断得到的有效可塑性 进行比较,可以看到:转录状态混杂越明显的区域,有效可塑性越高,符合预期。“AT1-like”和“High-Plasticity”等中间阶段细胞群也表现出较高的有效可塑性。
关于这些模式的进一步讨论,我们建议读者参阅原始研究 Yang et al., 2022。
结论
本章介绍了谱系追踪技术,并利用一项研究的数据演示了基于 CRISPR/Cas9 的分析流程。最后,我们补充一些 资源,供谱系追踪分析与工具开发参考,并汇总 关键要点 供新用户参考。
谱系追踪仍是一个新兴领域。预计未来将出现更多大规模时间序列数据,以及针对这类数据开发的计算工具,相关讨论见 Rodriguez-Fraticelli & Morris, 2022 和 Mukhopadhyay, 2022。未来的重要方向,是整合基因表达与谱系信息,更完整地刻画研究对象的生物学特征,并利用时间序列数据进行轨迹推断(trajectory inference, TI)。
新方向
新的系统发育推断算法
在新的谱系推断算法方面,有许多有前景的方向:
可扩展的贝叶斯推断(Bayesian inference):与传统系统发育算法的发展趋势类似,一个方向是让贝叶斯方法能够处理更大的数据集。多数贝叶斯算法使用马尔可夫链蒙特卡洛(Markov Chain Monte Carlo, MCMC)估计后验分布 Huelsenbeck et al., 2001,而变分推断(Variational Inference, VI)的进展有望显著提高贝叶斯算法的可扩展性 Zhang & Matsen IV, 2018。这些概率方法既支持高通量评估树推断的不确定性,也便于与 单细胞变分推断(single-cell variational inference, scVI) 等单细胞转录组贝叶斯方法结合 Lopez et al., 2018。
改进的基于距离的算法:基于距离的算法的一个基本方面,是根据样本的突变数据和数据集的已知属性,来估计样本之间的相异度。有鉴于此,一个有前景的方向是:通过考虑突变发生的方式特性、以及特定突变可能性的先验,为演化型谱系追踪器开发统计上更稳健、更一致的相异度函数。这一点在 DCLEAR 上已经被证明是成功的 Gong et al., 2021 和 Fang et al., 2022。这一领域的持续进展将带来极大帮助,因为基于距离的算法能在多项式时间内运行,并在有了合适的相异度函数后产生非常准确的树。
用于解读时间序列谱系追踪数据的计算工具
包含时间序列信息的谱系追踪研究日益复杂,必须辅以能够把分析延伸到系统发育树构建之外的计算方法。也就是说,需要把多组学测量与谱系追踪和时间信息相结合的方法,从而能够还原出支配细胞状态、分化和行为的程序 Mukhopadhyay, 2022。
由于这一领域才刚刚起步,现有工具的数量仍然有限,但仍值得介绍几种领先的方法:
LineageOT用于基于 CRISPR/Cas9 的演化型场景 Forrow & Schiebinger, 2021:一种通用方法,用于从带有谱系信息的 scRNA-seq 时间序列(每个时间点都配有谱系信息)中推断发育轨迹,适用于基于 CRISPR/Cas9 的演化型场景。该方法被提出作为 Waddington-OT Schiebinger et al., 2019 算法的扩展,在将细胞从较早时间点映射到较晚时间点时纳入谱系关系。计算两个时间点之间的转移矩阵时,LineageOT 根据谱系相似性校正较晚时间点的表达谱。该方法已成功用于重建 C. elegans 的发育时间序列。模拟结果还表明,LineageOT能够准确恢复那些仅凭细胞状态测量无法恢复的复杂轨迹结构。欲了解更多细节和教程,请读者参阅 https://lineageot .readthedocs .io。 CoSpar用于静态 Barcode 谱系追踪数据 Wang et al., 2022:结合单细胞转录组与静态 Barcode 谱系追踪数据,推断细胞动态。该方法依赖两个假设:(i)状态相似的细胞具有相似行为;(ii)细胞只发生有限的状态转变,因此转移关系是稀疏的。CoSpar已应用于造血、重编程和定向分化数据。这些实例表明,CoSpar能够识别此前未被检测到的早期命运偏倚,预测与命运抉择相关的转录因子(transcription factor, TF)和受体。文档和详细示例见 https://cospar .readthedocs .io/。
开发新计算方法的资源
虽然目前这套分析工具已经相当强大,但仍有很大的进一步发展空间。为便于今后的工作,我们介绍几种用于对算法做基准测试的工具:
Allen 研究所近期举办的 Lineage Reconstruction DREAM 挑战赛 Gong et al., 2021 生成了三个用于评估新算法的基准数据集。其中两个数据集是合成的(即模拟的),另一个则用 intMEMOIR Chow et al., 2021 技术生成。最近发表的结果,既揭示了成功算法的行为特征,也提供了获取这些基准数据集的途径 Gong et al., 2021。
Cassiopeia-benchmark是 Cassiopeia 中的一个模块,允许用户高效地生成模拟谱系数据,用于对新的谱系重建算法做基准测试。虽然它很侧重于基于 CRISPR/Cas9 的演化型追踪器模拟,但其通用的模拟器 API 可以扩展以适应其他技术上的考量。作者提供了一份使用这套基准测试工具的详细操作指南,见 其网站。TedSim是一个模拟框架,既可模拟 Barcode 数据,也可沿给定谱系模拟转录组数据 Pan et al., 2022。这个模拟框架对于测试下游分析工具非常有用,例如那些旨在从谱系追踪数据推断发育轨迹的工具。
- Woodworth, M. B., Girskis, K. M., & Walsh, C. A. (2017). Building a lineage from single cells: genetic techniques for cell lineage tracking. Nature Reviews Genetics, 18(4), 230–244.
- Gong, W., Granados, A. A., Hu, J., Jones, M. G., Raz, O., Salvador-Martı́nez, I., Zhang, H., Chow, K.-H. K., Kwak, I.-Y., Retkute, R., & others. (2021). Benchmarked approaches for reconstruction of in vitro cell lineages and in silico models of C. elegans and M. musculus developmental trees. Cell Systems, 12(8), 810–826.
- McKenna, A., & Gagnon, J. A. (2019). Recording development with single cell dynamic lineage tracing. Development, 146(12), dev169730.
- Wagner, D. E., & Klein, A. M. (2020). Lineage tracing meets single-cell omics: opportunities and challenges. Nature Reviews Genetics, 21(7), 410–427.
- VanHorn, S., & Morris, S. A. (2021). Next-generation lineage tracing and fate mapping to interrogate development. Developmental Cell, 56(1), 7–21.
- Sulston, J. E., Schierenberg, E., White, J. G., & Thomson, J. N. (1983). The embryonic cell lineage of the nematode Caenorhabditis elegans. Developmental Biology, 100(1), 64–119.
- Weissman, T. A., & Pan, Y. A. (2015). Brainbow: new resources and emerging biological applications for multicolor genetic labeling and analysis. Genetics, 199(2), 293–306.
- Nagy, A. (2000). Cre recombinase: the universal reagent for genome tailoring. Genesis, 26(2), 99–109.
- Liu, K., Jin, H., & Zhou, B. (2020). Genetic lineage tracing with multiple term`DNA` recombinases: A user’s guide for conducting more precise cell fate mapping studies. Journal of Biological Chemistry, 295(19), 6413–6424.
- Liu, K., Tang, M., Jin, H., Liu, Q., He, L., Zhu, H., Liu, X., Han, X., Li, Y., Zhang, L., & others. (2020). Triple-cell lineage tracing by a dual reporter on a single allele. Journal of Biological Chemistry, 295(3), 690–700.
- He, L., Li, Y., Li, Y., Pu, W., Huang, X., Tian, X., Wang, Y., Zhang, H., Liu, Q., Zhang, L., & others. (2017). Enhancing the precision of genetic lineage tracing using dual recombinases. Nature Medicine, 23(12), 1488–1498.
- Gerrits, A., Dykstra, B., Kalmykowa, O. J., Klauke, K., Verovskaya, E., Broekhuis, M. J., de Haan, G., & Bystrykh, L. V. (2010). Cellular barcoding tool for clonal analysis in the hematopoietic system. Blood, The Journal of the American Society of Hematology, 115(13), 2610–2618.
- Biddy, B. A., Kong, W., Kamimoto, K., Guo, C., Waye, S. E., Sun, T., & Morris, S. A. (2018). Single-cell mapping of lineage and identity in direct reprogramming. Nature, 564(7735), 219–224.
- Weinreb, C., Rodriguez-Fraticelli, A., Camargo, F. D., & Klein, A. M. (2020). Lineage tracing on transcriptional landscapes links state to fate during differentiation. Science, 367(6479), eaaw3381.
- Yao, Z., Mich, J. K., Ku, S., Menon, V., Krostag, A.-R., Martinez, R. A., Furchtgott, L., Mulholland, H., Bort, S., Fuqua, M. A., & others. (2017). A single-cell roadmap of lineage bifurcation in human ESC models of embryonic brain development. Cell Stem Cell, 20(1), 120–134.