⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: surface-protein
channels:
  - conda-forge
dependencies:
  - python=3.13
  - scanpy=1.12
  - muon=0.1.9
  - python-igraph=1.0.0
  - ipykernel=7.2.0
  - pip==26.0.1
  - pip:
      - lamindb==2.3.1
      - harmonypy==0.0.9
      - ipywidgets==8.1.8
🗄️ 获取数据和笔记本
本书使用 lamindb 存储、共享和加载数据集与笔记本,托管实例为 theislab
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
按照 说明注册并登录
验证你的设置
下面用 Python API 检查连接;命令行方式可使用
lamin connect:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
运行后应显示最多 100 条已保存的数据集记录。
访问数据集(Artifact)
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
加载后的对象可直接在内存中分析。如需指定数据版本,可调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")中的 ID。访问笔记本(Transform)
加载笔记本:
lamin load <notebook url>该命令将笔记本下载到当前工作目录。与
Artifacts类似,可通过指定 ID 获取旧版本。
研究动机
单细胞分析不仅可以测量转录组,还能通过带标签的抗体测量表面蛋白。常用方案是通过测序对转录组和表位进行细胞索引(Cellular Indexing of Transcriptomes and Epitopes by Sequencing, CITE-seq)Stoeckius et al., 2017。其中的抗体衍生标签(Antibody-Derived Tags, ADTs)提供蛋白读出,其数据分布与 RNA 不同,需要相应的预处理。本部分聚焦 ADT 的单模态分析;两种模态也可联合分析,详见 多模态整合章节。
单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)得到的转录本丰度与蛋白水平只有部分相关,其关系还会随细胞状态而变化 Liu et al., 2016。直接测量单细胞蛋白水平,可以补充对细胞分化与命运、信号转导、疾病进展、扰动响应及临床诊断相关过程的认识 Xie & Ding, 2022。
转录组能够识别许多细胞群体,但对细胞身份和动态过程的描述仍不完整。蛋白合成及周转会使蛋白水平与转录本水平存在时间差,表面蛋白测量可提供互补信息。例如,一项研究发现,处理后细胞表面的免疫检查点蛋白 ICOS 增加,但其 信使 RNA(messenger RNA, mRNA) 丰度在处理组间并无相应差异 Peterson et al., 2017。此外,互斥细胞类型标记的共现可帮助发现转录组中不易识别的双细胞(Doublet)Sun et al., 2021,详见 Doublet 检测。
将核苷酸条形码(Barcode)连接到抗体后,先让抗体与细胞结合,再测序抗体标签及 RNA,即可联合获取两种读出。CITE-seq 与 RNA 表达和蛋白测序测定(RNA Expression and Protein Sequencing Assay, REAP-seq)采用不同的抗体–寡核苷酸偶联方式。原始 CITE-seq 方案使用链霉亲和素与生物素化 DNA Barcode 的非共价结合,REAP-seq 则将抗体与 DNA Barcode 共价连接 Peterson et al., 2017。后续方法还将蛋白测量扩展到更多模态。例如 DOGMA-seqMimitou et al., 2021 可在同一个细胞中测量染色质可及性(chromatin accessibility)、基因表达和蛋白。相关方法 ASAP-seq 借助桥接寡核苷酸,将单细胞染色质可及性测量与 ADT 读出结合 Mimitou et al., 2021,并支持表面及细胞内蛋白测量。下文将表面蛋白读出统称为 ADT 数据。
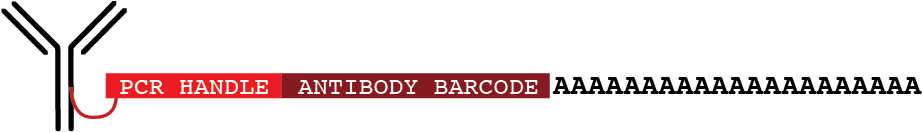
ADT 可测量流式细胞术(flow cytometry)中常用的标记,尤其适合区分免疫细胞群,并可与其他模态同时获取。与常见的 RNA 计数(Count)数据相比,ADT 通常较不稀疏,许多标记呈现阴性背景峰和阳性信号峰;阴性峰并不表示 Count 为负,也不能据此认定所有 ADT 都服从同一种分布 Zheng et al., 2022。抗体面板通常只有数十至数百个特征(feature),而 ADT 与 RNA 文库可分别分配测序资源,使单个 ADT 获得较深覆盖。与此同时,游离标签抗体和非特异性结合可在阴性细胞或空液滴(empty droplet)中产生背景 Count。
环境配置与数据
本例采用为 2021 年 NeurIPS 单细胞数据整合挑战生成的 CITE-seq 数据 Luecken et al., 2021,包含 12 位健康供体的骨髓单个核细胞(bone marrow mononuclear cell, BMMC),在四个测量地点采集 RNA 与 ADT,形成嵌套的批次效应(batch effect)。本教程使用完整数据集,蛋白面板包含 140 个标记。
本章使用 Scanpy 和 muonBredikhin et al., 2022 分析数据。先导入所需软件包。
import warnings

import muon as mu
import numpy as np
import pandas as pd
import scanpy as sc
import seaborn as sns
from scipy.stats import median_abs_deviation

warnings.filterwarnings("ignore")
sc.settings.verbosity = 0
sc.set_figure_params(
    dpi=80,
    facecolor="white",
    frameon=False,
)


import lamindb as ln

ln.track()
→ connected lamindb: theislab/sc-best-practices
→ found notebook quality_control.ipynb, making new version -- anticipating changes
→ created Transform('FATGTTa0bL500008', key='quality_control.ipynb'), re-started Run('HPJKfoKHttQ0YNhZ') at 2026-07-29 10:07:52 UTC
→ notebook imports: lamindb-core==2.3.1 muon==0.1.9 numpy==2.4.6 pandas==2.3.3 scanpy==1.12.3 scipy==1.16.3 seaborn==0.13.2
• recommendation: to identify the notebook across renames, pass the uid: ln.track("FATGTTa0bL50")
加载 CITE-seq 数据
加载 NeurIPS 2021 挑战数据 Luecken et al., 2021。数据以 MuData 对象保存,其中两个 AnnData 对象分别存放 RNA 和 ADT 模态。
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="surface-protein/cite_filtered.h5mu", is_latest=True
)
mdata = af.load()
mdata此处加载的是通过 Cell Ranger 预处理筛选的版本,共 122,016 个液滴 Barcode。RNA 模态包含 36,601 个基因条目,ADT 模态包含 140 个蛋白标记。包含基因条目并不意味着每个细胞都检测到了这些基因。
质量控制
质量控制(Quality Control, QC)需要识别 ADT 捕获不足的细胞。由于蛋白面板、背景信号及 Count 分布均与 RNA 不同,不能直接照搬转录组的全部质控指标和阈值。
识别捕获不足的细胞时,建议先检查检测到的蛋白标记数,再结合总 ADT Count。少数强阳性标记可显著提高总 Count,因此仅凭总 Count 可能掩盖其他标记捕获不足的问题。阈值还应结合面板组成和细胞类型选择。
CITE-seq 同时提供 ADT 和 RNA,下面结合两种模态完成质控与过滤。
先对全部样本采用宽松阈值,随后再按样本设置更细致的离群值规则。
sc.pp.calculate_qc_metrics(mdata["prot"], inplace=True, percent_top=None)
mdata["rna"].var["mt"] = mdata["rna"].var_names.str.startswith("MT-")
sc.pp.calculate_qc_metrics(
    mdata["rna"], qc_vars=["mt"], inplace=True, percent_top=[20], log1p=True
)
mdata先用 seaborn 绘制每个细胞检测到的蛋白标记数。本例多数细胞在 70–140 个标记上有非零 Count;这不等于这些蛋白都达到特异性阳性表达。
sns.displot(mdata["prot"].obs.n_genes_by_counts)<seaborn.axisgrid.FacetGrid at 0x7f4fe976ecf0>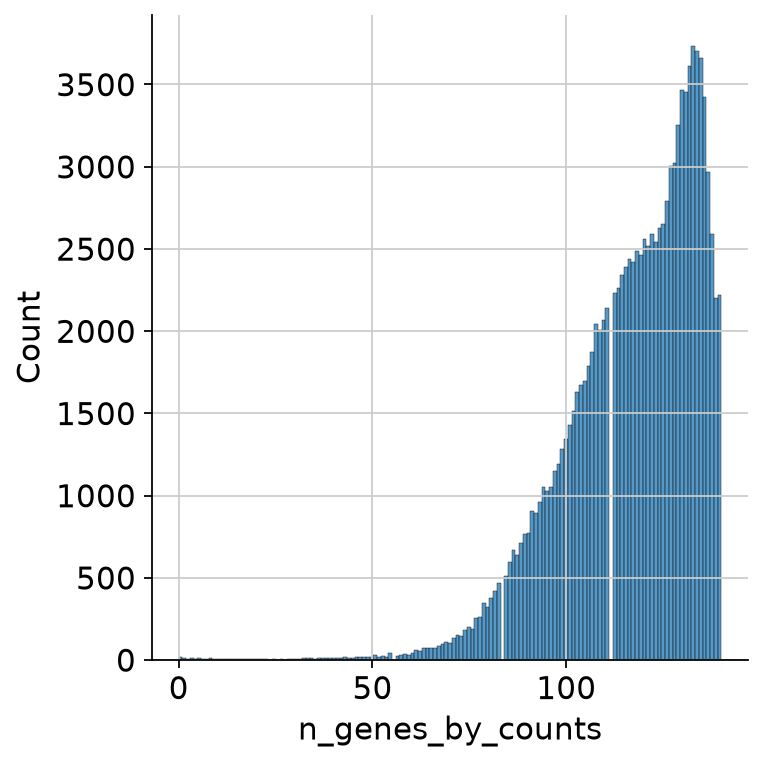
检测到的标记数异常少,可能提示捕获失败或低质量细胞,但不能单凭这一指标确定细胞失活。先放大分布低端,寻找适合本数据的过滤阈值:
sns.displot(
    mdata["prot"][mdata["prot"].obs.n_genes_by_counts < 70].obs.n_genes_by_counts
)
<seaborn.axisgrid.FacetGrid at 0x7f4f84ab8050>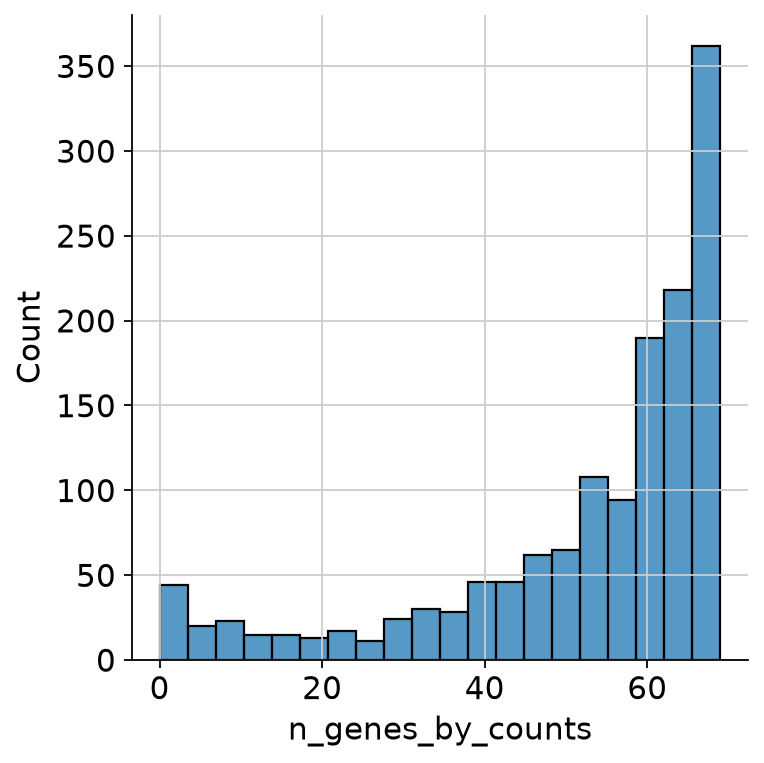
分布在约 55 个标记处出现低谷,本例据此设置阈值,保留检测到至少 55 个标记的细胞。
sc.pp.filter_cells(mdata["prot"], min_genes=55)接着检查每个细胞的 ADT 总 Count。
sns.displot(mdata["prot"].obs.total_counts)<seaborn.axisgrid.FacetGrid at 0x7f4f84b50550>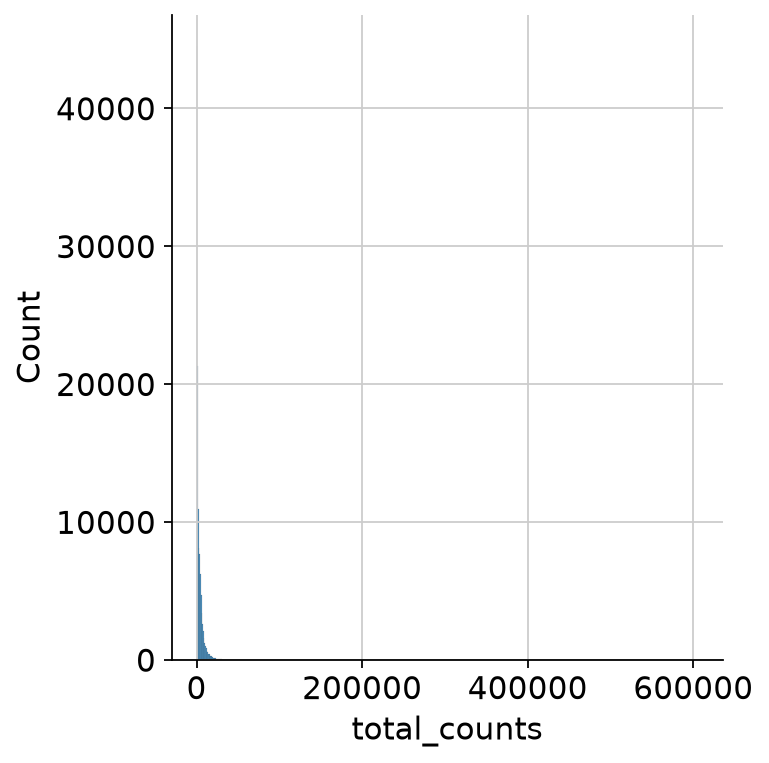
全范围直方图不便观察高 Count 尾部,因此放大该区域以选择上限。异常高的 ADT 总 Count 可能来自多个细胞共占液滴或抗体聚集,也可能受细胞类型与大小影响,需要结合其他信息判断。
sns.displot(
    mdata["prot"].obs.query("total_counts>20000 and total_counts<100000").total_counts
)
<seaborn.axisgrid.FacetGrid at 0x7f4f848e7d90>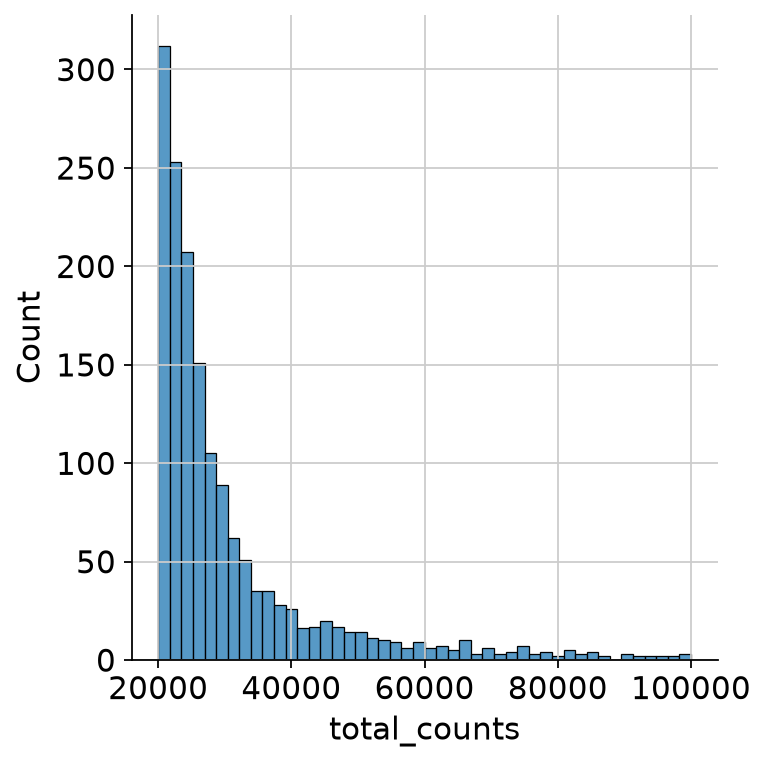
本例去除 ADT 总 Count 超过 100,000 的细胞,保留等于该阈值的细胞。这些极端值数量很少,作为疑似 Doublet 或抗体聚集进行过滤;高 Count 本身并不能确证其来源。
sc.pp.filter_cells(mdata["prot"], max_counts=100000)随后检查 RNA 总 Count,并应用相应上限。RNA 质控的详细说明见 质量控制。
sns.displot(
    mdata["rna"].obs.query("total_counts>20000 and total_counts<100000").total_counts
)
<seaborn.axisgrid.FacetGrid at 0x7f4fe3fdcb90>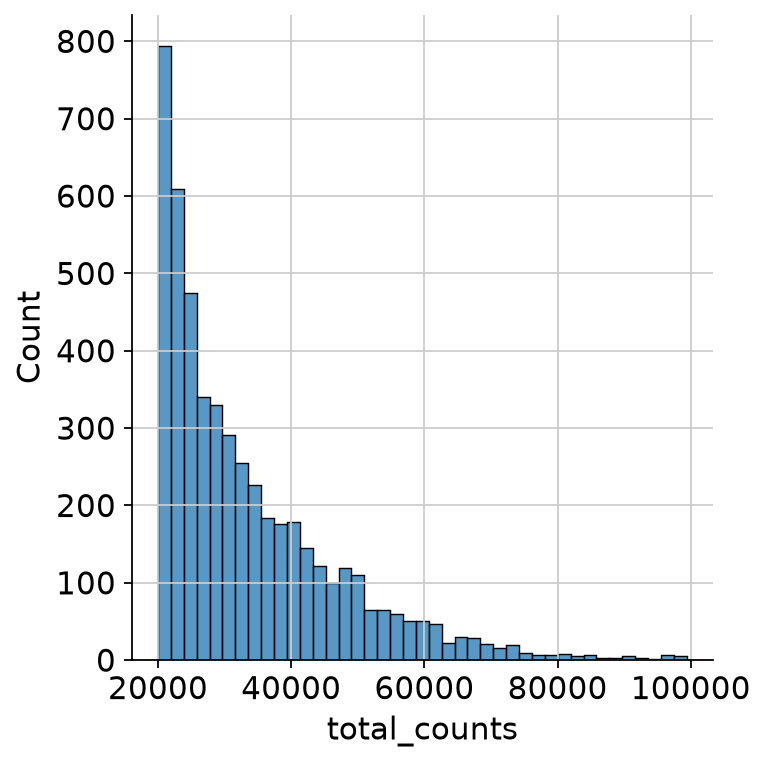
sc.pp.filter_cells(mdata["rna"], max_counts=100000)再检查 RNA 模态中的线粒体 Count 占比。
sns.displot(mdata["rna"].obs.pct_counts_mt)<seaborn.axisgrid.FacetGrid at 0x7f4fe947d310>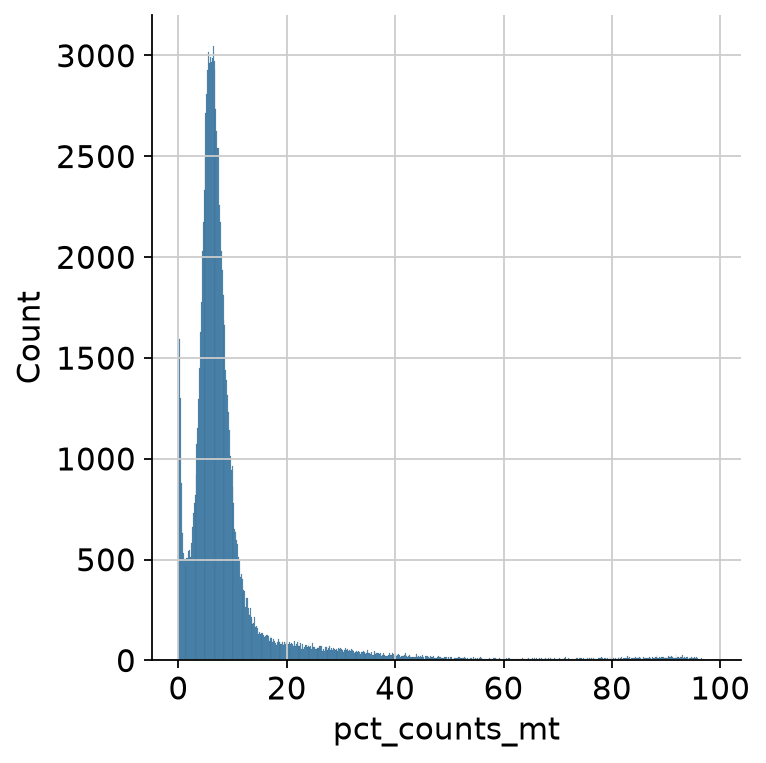
下方代码仅保留线粒体 Count 占比小于 40% 的细胞,即等于或超过 40% 的细胞均被去除。该阈值是本例的分析选择。随后取 RNA 与蛋白模态通过过滤的 Barcode 交集。
mu.pp.filter_obs(mdata["rna"], "pct_counts_mt", lambda x: x < 40)mdata.update()
mu.pp.filter_obs(mdata, mdata["prot"].obs_names)
mu.pp.filter_obs(mdata, mdata["rna"].obs_names)
mdata按样本质控
接下来按样本检查更细致的离群值阈值。不同样本的读段(Read)总量、液滴数和细胞组成可能不同,因此不宜对所有样本使用同一个严格的 Count 阈值。
sns.boxplot(y=mdata["prot"].obs.total_counts, x=mdata["prot"].obs["donor"])<Axes: xlabel='donor', ylabel='total_counts'>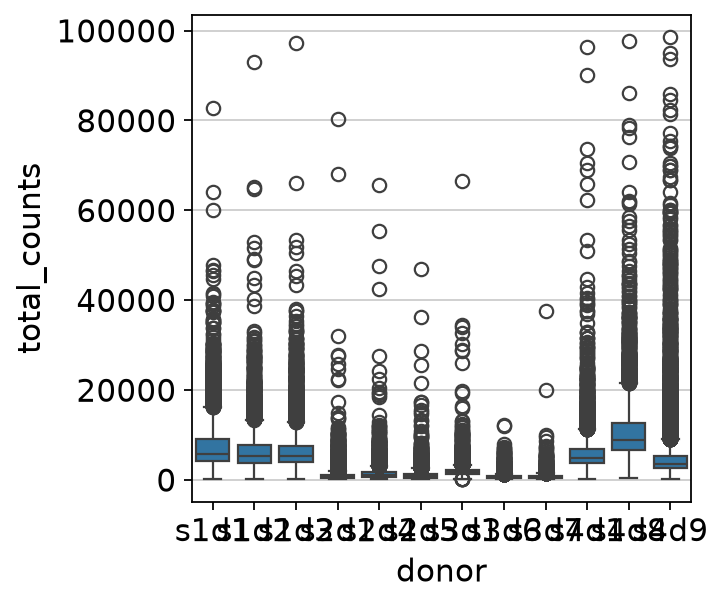
各样本的 Count 分布存在差异。例如,s3d7 中的离群值可能落在 s4d8 的主要分布范围内,因此需要在各样本内部判断异常。
这里以绝对中位差(Median Absolute Deviation, MAD)自动标记各样本的离群值:两种模态的 log1p 总 Count 与 log1p 检测 feature 数使用 5 MAD,RNA 线粒体占比使用 7 MAD。代码对两侧尾部均进行判断,方法可参照 RNA 质量控制。
def is_outlier(adata, metric: str, nmads: int):
    M = adata.obs[metric]
    outlier = (M < np.median(M) - nmads * median_abs_deviation(M)) | (
        np.median(M) + nmads * median_abs_deviation(M) < M
    )
    return outlier
prot_outliers = []
rna_outliers = []
for sample in np.unique(mdata["prot"].obs["donor"]):
# --- protein modality ---
prot_temp = mdata["prot"][mdata["prot"].obs["donor"] == sample].copy()
prot_temp.obs["outlier"] = is_outlier(
prot_temp, "log1p_total_counts", 5
) | is_outlier(prot_temp, "log1p_n_genes_by_counts", 5)
prot_outliers.append(prot_temp.obs["outlier"])
print(
f"{sample} (prot): outliers {prot_temp.obs.outlier.value_counts().get(True, 0)}"
)
# --- rna modality ---
rna_temp = mdata["rna"][mdata["rna"].obs["donor"] == sample].copy()
rna_temp.obs["outlier"] = (
is_outlier(rna_temp, "pct_counts_mt", 7)
| is_outlier(rna_temp, "log1p_total_counts", 5)
| is_outlier(rna_temp, "log1p_n_genes_by_counts", 5)
)
rna_outliers.append(rna_temp.obs["outlier"])
print(
f"{sample} (rna): outliers {rna_temp.obs.outlier.value_counts().get(True, 0)}"
)s1d1 (prot): outliers 163
s1d1 (rna): outliers 483
s1d2 (prot): outliers 142
s1d2 (rna): outliers 1102
s1d3 (prot): outliers 200
s1d3 (rna): outliers 933
s2d1 (prot): outliers 168
s2d1 (rna): outliers 435
s2d4 (prot): outliers 108
s2d4 (rna): outliers 424
s2d5 (prot): outliers 27
s2d5 (rna): outliers 639
s3d1 (prot): outliers 324
s3d1 (rna): outliers 963
s3d6 (prot): outliers 437
s3d6 (rna): outliers 490
s3d7 (prot): outliers 297
s3d7 (rna): outliers 753
s4d1 (prot): outliers 224
s4d1 (rna): outliers 789
s4d8 (prot): outliers 168
s4d8 (rna): outliers 558
s4d9 (prot): outliers 466
s4d9 (rna): outliers 1166
汇总各样本的离群标签;任一模态被标记为离群值的细胞都会被过滤。
mdata["prot"].obs["outliers"] = pd.concat(prot_outliers)
mdata["rna"].obs["outliers"] = pd.concat(rna_outliers)
mdata.update()

# Combined outliers: a cell is dropped if it's an outlier in EITHER modality
combined_outliers = mdata["prot"].obs["outliers"].reindex(mdata.obs_names).fillna(
    False
) | mdata["rna"].obs["outliers"].reindex(mdata.obs_names).fillna(False)


mdata = mdata[~combined_outliers].copy()
mdata本例过滤后保留 106,515 个细胞,相比起始的 122,016 个去除了约 1.55 万个,约占 13%。
sns.boxplot(y=mdata["prot"].obs.total_counts, x=mdata["prot"].obs["donor"])<Axes: xlabel='donor', ylabel='total_counts'>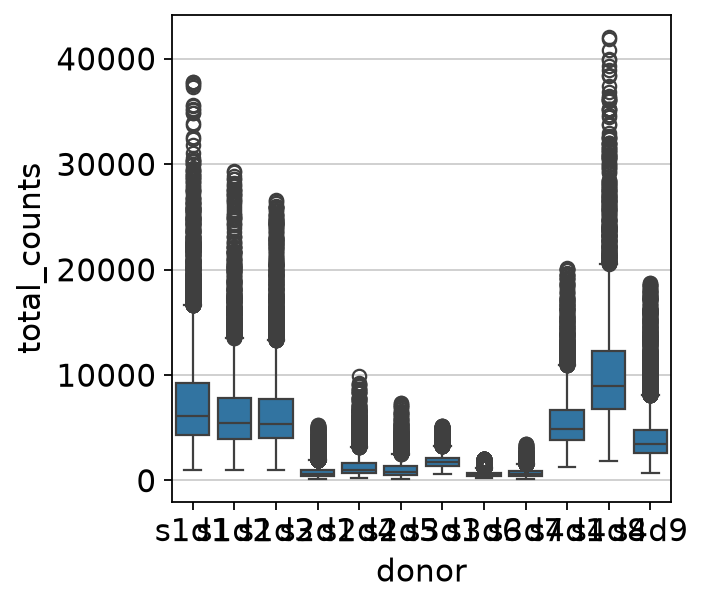
过滤后,各样本的极端离群值有所减少。接下来通过归一化(normalization)处理技术尺度差异;归一化不能保证消除所有批次效应,也不要求真实生物学分布完全一致。
af_quality_control = ln.Artifact.from_mudata(
    mdata,
    key="surface-protein/cite_quality_control.h5mu",
    description="CITE-seq filtered data after quality control",
)
af_quality_control.save()
输出
→ returning artifact with same hash: Artifact(uid='t7ppYU464BQN5AHa0005', key='surface-protein/cite_quality_control.h5mu', description='CITE-seq filtered data after quality control', suffix='.h5mu', kind='dataset', otype='MuData', size=1407368865, hash='WYSCTqkvwmcSW5ILZm4DtZ', n_files=None, n_observations=106515, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=105, schema_id=None, created_by_id=7, created_at=2026-07-29 09:58:15 UTC, is_locked=False, version_tag=None, is_latest=True); to track this artifact as an input, use: ln.Artifact.get()
Artifact(uid='t7ppYU464BQN5AHa0005', key='surface-protein/cite_quality_control.h5mu', description='CITE-seq filtered data after quality control', suffix='.h5mu', kind='dataset', otype='MuData', size=1407368865, hash='WYSCTqkvwmcSW5ILZm4DtZ', n_files=None, n_observations=106515, branch_id=1, created_on_id=1, space_id=1, storage_id=1, run_id=105, schema_id=None, created_by_id=7, created_at=2026-07-29 09:58:15 UTC, is_locked=False, version_tag=None, is_latest=True)ln.finish()输出
• please hit CTRL + s to save the notebook in your editor .... still waiting .....
 ✓
! returning transform  with same hash & key: Transform(uid='FATGTTa0bL500007', key='quality_control.ipynb', description='Quality control', kind='notebook', hash='r7-F3eKT_IgL2ZuHD9ERAg', reference=None, reference_type=None, environment=None, plan=None, branch_id=1, created_on_id=1, space_id=1, created_by_id=7, created_at=2026-07-29 09:56:33 UTC, is_locked=False, version_tag=None, is_latest=False)
• new latest Transform version is: FATGTTa0bL500007
→ finished Run('HPJKfoKHttQ0YNhZ') after 56s at 2026-07-29 10:08:49 UTC
→ go to: https://lamin.ai/theislab/sc-best-practices/transform/FATGTTa0bL500007
→ to update your notebook from the CLI, run: lamin save /groups/nils/members/javier/single-cell-best-practices/jupyter-book/surface_protein/quality_control.ipynb
贡献者
我们衷心感谢以下人员的贡献:
作者
Javier Marchena-Hurtado
Daniel Strobl
Ciro Ramírez-Suástegui
Anna Schaar
审阅者
Lukas Heumos
- Stoeckius, M., Hafemeister, C., Stephenson, W., Houck-Loomis, B., Chattopadhyay, P. K., Swerdlow, H., Satija, R., & Smibert, P. (2017). Simultaneous epitope and transcriptome measurement in single cells. Nature Methods, 14(9), 865–868. 10.1038/nmeth.4380
- Liu, Y., Beyer, A., & Aebersold, R. (2016). On the Dependency of Cellular Protein Levels on mRNA Abundance. Cell, 165(3), 535–550. 10.1016/j.cell.2016.03.014
- Xie, H., & Ding, X. (2022). The Intriguing Landscape of Single-Cell Protein Analysis. Advanced Science, n/a(n/a), 2105932. 10.1002/advs.202105932
- Peterson, V. M., Zhang, K. X., Kumar, N., Wong, J., Li, L., Wilson, D. C., Moore, R., McClanahan, T. K., Sadekova, S., & Klappenbach, J. A. (2017). Multiplexed quantification of proteins and transcripts in single cells. Nature Biotechnology, 35(1010), 936–939. 10.1038/nbt.3973
- Sun, B., Bugarin-Estrada, E., Overend, L. E., Walker, C. E., Tucci, F. A., & Bashford-Rogers, R. J. M. (2021). Double-jeopardy: scRNA-seq doublet/multiplet detection using multi-omic profiling. Cell Reports Methods, 1(1), 100008. 10.1016/j.crmeth.2021.100008
- Mimitou, E. P., Lareau, C. A., Chen, K. Y., Zorzetto-Fernandes, A. L., Hao, Y., Takeshima, Y., Luo, W., Huang, T.-S., Yeung, B. Z., Papalexi, E., Thakore, P. I., Kibayashi, T., Wing, J. B., Hata, M., Satija, R., Nazor, K. L., Sakaguchi, S., Ludwig, L. S., Sankaran, V. G., … Smibert, P. (2021). Scalable, multimodal profiling of chromatin accessibility, gene expression and protein levels in single cells. Nature Biotechnology, 39(1010), 1246–1258. 10.1038/s41587-021-00927-2
- Zheng, Y., Jun, S.-H., Tian, Y., Florian, M., & Gottardo, R. (2022). Robust Normalization and Integration of Single-cell Protein Expression across CITE-seq Datasets. bioRxiv. 10.1101/2022.04.29.489989
- Luecken, M. D., Burkhardt, D. B., Cannoodt, R., Lance, C., Agrawal, A., Aliee, H., Chen, A. T., Deconinck, L., Detweiler, A. M., Granados, A. A., Huynh, S., Isacco, L., Kim, Y. J., Klein, D., KUMAR, B. D., Kuppasani, S., Lickert, H., McGeever, A., Mekonen, H., … Bloom, J. M. (2021). A sandbox for prediction and integration of DNA, RNA, and proteins in single cells. Thirty-Fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2). https://openreview.net/forum?id=gN35BGa1Rt
- Bredikhin, D., Kats, I., & Stegle, O. (2022). MUON: multimodal omics analysis framework. Genome Biology, 23(1). 10.1186/s13059-021-02577-8