🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在你的系统中。
保存 yml 内容:
将 yml 选项卡中的内容保存为文件
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
研究动机
单细胞技术可将适应性免疫受体库(Adaptive Immune Receptor Repertoire, AIRR)测序与转录组等模态配对。对于 B、T 细胞,基因表达(Gene Expression, GEX)反映其当前状态,适应性免疫受体(Adaptive Immune Receptor, AIR)序列则提供抗原识别能力的线索。两类信息相互补充,可帮助研究感染或疫苗接种后的细胞反应,但受体序列本身并不完全决定细胞命运。
数据准备
先按细胞标识合并 GEX 与 AIR 数据。这一步也可在预处理早期完成,以便利用受体信息辅助识别双细胞(Doublet)或检查细胞注释。本章以 GEX 细胞为基准执行左连接(left join),保留所有 GEX 细胞并加入可匹配的 AIR 信息。合并与过滤的顺序仍可能影响保留的细胞及后续统计,不能仅因采用左连接就认为顺序无关。
import warnings

warnings.filterwarnings(
    "ignore",
    ".*IProgress not found*",
)
warnings.simplefilter(action="ignore", category=FutureWarning)
warnings.simplefilter(action="ignore", category=UserWarning)

import numpy as np
import pandas as pd
import scanpy as sc
import scirpy as ir

warnings.simplefilter(action="ignore", category=pd.errors.DtypeWarning)
path_data = "./data"
path_gex_tcr = f"{path_data}/TCR_00_GEX.h5ad"
path_gex_bcr = f"{path_data}/BCR_00_GEX.h5ad"
path_tcr = f"{path_data}/TCR_01_preprocessed.h5ad"
path_bcr = f"{path_data}/BCR_01_preprocessed.h5ad"
path_tmp = f"{path_data}/tmp"
path_res = f"{path_data}/res"先加载原作者处理后的 GEX 数据,完整数据集可从以下地址下载:https://
! wget -O $path_bcr_input -nc https://
! wget -O $path_bcr_input -nc https://
加载 GEX 和已注释的 T 细胞受体(T-Cell Receptor, TCR)数据后,使用本章旧版 Scirpy 接口合并两个 AnnData 对象。AIR 字段写入 adata.obs,GEX 矩阵保存在 adata.X。合并按细胞条形码(cell barcode, CB)匹配,以 GEX 对象为左表。具有 GEX 但没有 AIR 的细胞仍保留,可能是不表达受体的细胞,也可能是受体未捕获;仅有 AIR 而缺少 GEX 的记录不进入这次转录组主导的分析。跨样本合并时还需保证 Cell Barcode 唯一。
adata_tc = sc.read(path_gex_tcr)
adata_tcr = sc.read(path_tcr)

ir.pp.merge_with_ir(adata_tc, adata_tcr)
在 T 细胞的表达表示上构建近邻图(nearest-neighbor graph),再进行 Leiden 聚类(clustering)。
sc.pp.neighbors(adata_tc)
sc.tl.leiden(adata_tc)
用统一流形近似与投影(Uniform Manifold Approximation and Projection, UMAP)展示总体结构,并分别按原始细胞注释、受体检出标记和新 Leiden 标签着色。
sc.tl.umap(adata_tc)
sc.pl.umap(adata_tc, color=["full_clustering", "has_ir", "leiden"], ncols=1)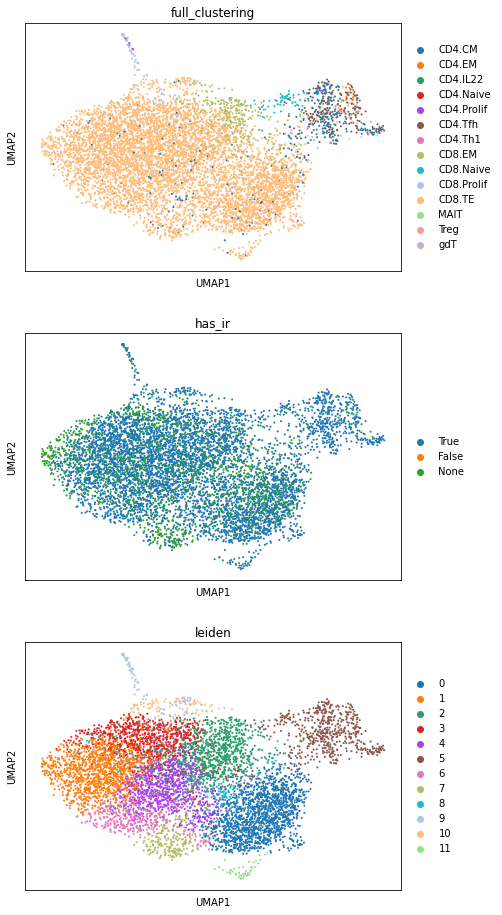
原教程图中,CD8+ 效应 T 细胞占较大比例,多数细胞检测到 TCR。受体信息可辅助区分细胞类型。如果分选的 T 细胞中有整个群体缺少 TCR,应结合转录组检查分选或注释,也应考虑捕获效率、受体重建和 Barcode 匹配问题。
同样合并 B 细胞的 GEX 与 B 细胞受体(B-Cell Receptor, BCR)信息,再构建邻居图、聚类并显示 UMAP。
adata_bc = sc.read(path_gex_bcr)
adata_bcr = sc.read(path_bcr)

ir.pp.merge_with_ir(adata_bc, adata_bcr)
sc.pp.neighbors(adata_bc)
sc.tl.leiden(adata_bc)
sc.tl.umap(adata_bc)
sc.pl.umap(adata_bc, color=["full_clustering", "has_ir", "leiden"], ncols=1)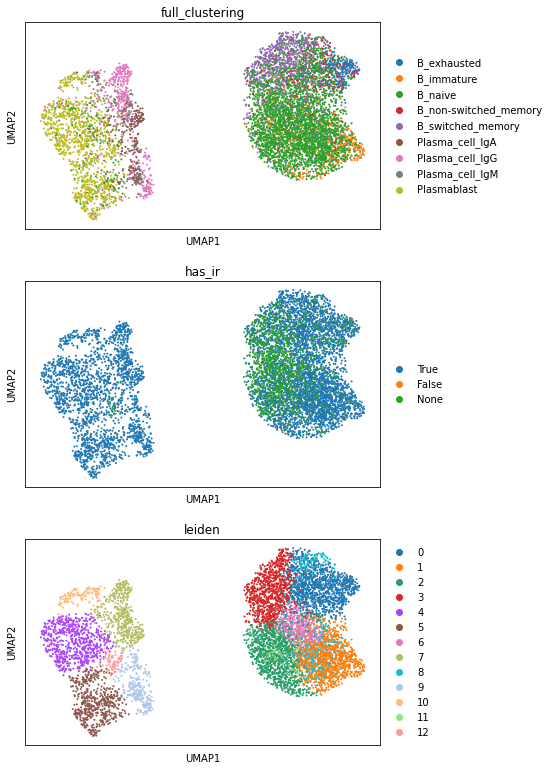
本例中,浆母细胞(plasmablast)与其他 B 细胞在转录组表示上明显分离;浆母细胞本身也属于 B 细胞谱系。
借助另一模态分组进行单模态分析
一种常见做法是分别分析两个模态,用其中一个提供细胞分组,再研究另一个。例如,按受体克隆型(clonotype)定义细胞群,比较该群在不同时间点的基因表达变化,以研究对扰动的响应。跨条件的差异表达分析仍需考虑供体和生物学重复(biological replicate),不能把同一供体的每个细胞都当作独立重复。
本书前面已介绍这些单模态方法。本节聚焦如何在 AIRR 与转录组之间使用分组信息,具体算法可参阅相应章节。
在 RNA 分组中分析 AIR
前面的 克隆型分析 介绍了受体序列和多样性分析。有了配对数据,就可以在转录组定义的细胞群中应用这些方法。分组方式应围绕研究问题选择,例如:
Leiden 聚类:根据处理后的 GEX 表示及邻居图划分细胞群,再用标记基因(marker gene)解释状态,随后分析感兴趣群体的 AIRR。不能只凭聚类就认定某群具有疾病特异性。
标记基因:根据与增殖、活化或抑制等状态相关的基因选择细胞,也可以使用一组标记基因构成的评分。
细胞类型:B、T 细胞可分为不同层级的亚型。在转录组或其他模态上完成注释后,可比较同一样本不同细胞类型的受体库,或跨样本比较同一类型,例如 CD8+ 效应 T 细胞在疾病与健康条件下的受体库组成。
Leiden 聚类:用前面得到的 leiden 列为谱型分析(spectratype analysis)分组,比较各表达簇中受体连接区的长度分布。这里通过 color="leiden" 指定分组。
ir.pl.spectratype(
    adata_bc,
    color="leiden",
    viztype="curve",
    curve_layout="shifted",
    fig_kws={"figsize": [8, 4]},
    kde_kws={"kde_norm": False},
)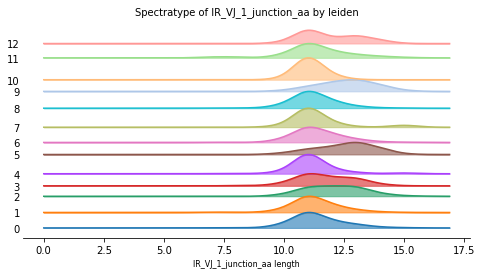
原教程中,多数 Leiden 簇的 BCR 连接区长度分布相近,5、9 号簇偏向较长序列,并与浆母细胞或浆细胞注释有关。这里不是整条 BCR 的长度。长度分布差异可提示需要进一步检查的群体,但不能单独证明免疫反应;原文也注明,最终确定样本子集后应更新这一解读。
标记基因:也可根据单个基因分组。这里用编码干扰素 γ(Interferon Gamma, IFN-γ)的 IFNG 作为炎症相关状态的示例标记,但 IFNG 高表达并不等同于所有细胞都在启动同一种抗原应答。
sc.pl.umap(adata_tc, color="IFNG")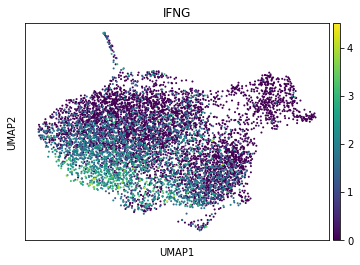
本例 IFNG 主要在一部分 CD8 效应 T 细胞中表达。下面按实际代码选择 .X 中 IFNG 表达值严格大于 3 的细胞,生成 elevated_IFNG 并转为字符串标签,用于绘图;原文写的 2.5 与代码不一致。该阈值依赖当前表达数据的尺度,是示例设置。
adata_tc.obs["elevated_IFNG"] = adata_tc[:, "IFNG"].X.todense() > 3
adata_tc.obs["elevated_IFNG"] = adata_tc.obs["elevated_IFNG"].astype(str)
sc.pl.umap(adata_tc, color="elevated_IFNG", groups="True")
... storing 'elevated_IFNG' as categorical
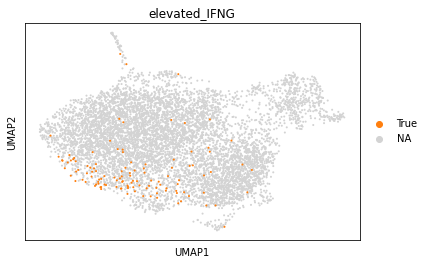
接着比较 IFNG 高表达与其余细胞的受体序列模式。先保留具有 β 链互补决定区 3(complementarity-determining region 3 of the beta chain, CDR3β)注释的细胞,再按 elevated_IFNG 分组,使用所有已保留序列中出现最多的一条作为 centroid,分别构建序列基序图。
from IPython.display import SVG
from palmotif import compute_pal_motif, svg_logo

df_sequences = adata_tc[~adata_tc.obs["IR_VDJ_1_junction_aa"].isna()].obs[
    ["IR_VDJ_1_junction_aa", "elevated_IFNG"]
]

seqs_elevated = df_sequences[df_sequences["elevated_IFNG"] == "True"][
    "IR_VDJ_1_junction_aa"
]
seqs_background = df_sequences[df_sequences["elevated_IFNG"] == "False"][
    "IR_VDJ_1_junction_aa"
]
centroid = df_sequences["IR_VDJ_1_junction_aa"].value_counts().index[0]

motif_ifng, _ = compute_pal_motif(
    seqs=seqs_elevated,
    centroid=centroid,
)
motif_back, _ = compute_pal_motif(
    seqs=seqs_background,
    centroid=centroid,
)

svg_logo(motif_ifng, "tmp/motif_ifng.svg")
svg_logo(motif_back, "tmp/motif_back.svg")
display(SVG("tmp/motif_ifng.svg"))
display(SVG("tmp/motif_back.svg"))本例两组在部分氨基酸位置上的频率略有差异,但图中没有清晰分离的主导基序。这一可视化未提供充分的共同表位证据,也不能据此证明两组不存在共同特异性;结果还受到样本量和扩增克隆重复计入的影响。
细胞类型:还可以按 full_clustering 比较各类型的克隆多样性。原教程将增殖型和效应型 CD8+ T 细胞较低的多样性与较大的克隆联系起来,但下方 alpha_diversity 调用仍被注释,当前代码不会生成这一结果。实际比较时需先有一致的克隆型定义,并考虑采样量。
# TODO: remove clonotype definition once this is handled by clonotype chapter
# ir.pl.alpha_diversity(adata_tc, groupby="full_clustering", target_col="clone_id", figsize=[8, 4])
在 AIR 分组中分析 GEX
也可以按 AIR 信息分组后开展 差异基因表达(differential gene expression, DGE)。例如:
克隆型:若细胞数量足够,可比较同一克隆型在时间、治疗或刺激条件下的状态变化。克隆型为受体关联提供线索,但并非对抗原特异性的完整测定。
克隆型网络:将序列相近的受体分组,可扩大候选细胞群;这些记录不一定属于同一克隆谱系,也不保证具有相同特异性。
候选抗原特异性:利用数据库匹配得到的候选注释,比较相关 B、T 细胞的表达状态。数据库没有某个 AIR–表位配对记录,不表示该受体一定不结合该表位;匹配本身也可能有误。
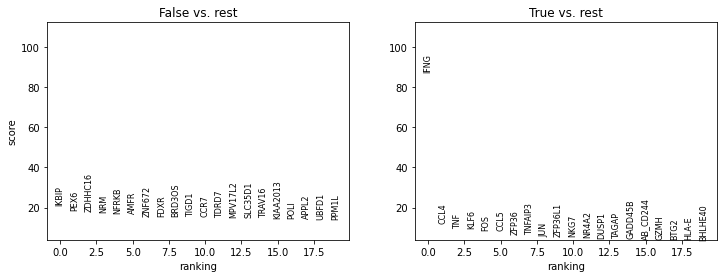
具体分组取决于研究问题,可使用前面保存在 adata.obs 中的注释。原文此处仍留有待办:下面实际按 elevated_IFNG 比较表达,而不是按 AIR 克隆型或疾病特异性分组。由于标签本身来自 IFNG 表达,这一比较还存在基因表达定义分组所带来的选择效应,不能当作独立验证。
# todo change once load clonotype annotated data
sc.tl.rank_genes_groups(adata_tc, groupby="elevated_IFNG")
sc.pl.rank_genes_groups(adata_tc, groupby="elevated_IFNG")
WARNING: Default of the method has been changed to 't-test' from 't-test_overestim_var'
# TODO adapt to disease specific cells => Covid B cells against rest多模态整合
将一种模态用于分组、再分析另一种模态,是利用配对数据的直接方式。更进一步,可以联合 AIR 与 GEX 建模,得到共享表示或分组。其依据是受体识别与细胞状态可能相关,但识别同一抗原的细胞仍可因组织、时间或刺激背景不同而处于不同状态。
原教程将下面的方法作为较新的探索性方向介绍,而不是已确立的统一最佳实践。应用时应核对论文与当前实现的评估范围,并分别检查受体与转录组信息是否得到合适保留。
整合 TCR 与 GEX
本节介绍三种面向 TCR 与 GEX 的联合分析方法,它们的目标不同:
在 scRNA-seq 监督下估计 TCR 功能结构(TCR functional landscape estimation supervised with scRNA-seq analysis, TESSA):通过贝叶斯模型(Bayesian model)关联序列表示与表达信息并形成分组。
克隆型邻居图分析(clonotype neighbor graph analysis, CoNGA):比较 GEX 与 TCR 的邻域结构,寻找跨模态关联。
mvTCR:使用多视图变分自编码器(Variational Autoencoder, VAE),学习 GEX 和 TCR 的联合嵌入(Embedding)。
本节示例需要细胞层面的配对 GEX 与受体信息。先保留具有 CDR3β 的 T 细胞,后续再按各工具的要求补充筛选;这不意味着所有多模态方法都只能处理完全配对数据。
adata_tc = adata_tc[~adata_tc.obs["IR_VDJ_1_junction_aa"].isna()].copy()TESSA
Zhang 等人提出的 TESSA Zhang et al., 2021 通过贝叶斯建模关联 TCR 序列与转录组。首先用预训练自编码器(Autoencoder)将 CDR3β 压缩为 30 维数值表示,再根据表达信息学习各潜在维度的权重,并迭代更新分组。权重作用于潜在表示的维度,不能直接解读为某个氨基酸位置的重要性;收敛也不意味着达到全局最优对齐。
原作者在具有已知表位信息的 Genomics, 2019 数据上报告,TESSA 的分组纯度优于单模态方法 GLIPH Glanville et al., 2017。研究还将网络中心性与克隆扩增(clonal expansion)及较高的抗体衍生标签(Antibody-Derived Tag, ADT)计数(Count)相联系,用于支持较强综合结合力(avidity)的解释;这些相关读出不等于直接测定单分子亲和力。将模型用于 Yost et al., 2019 的数据时,作者识别了与 PD-1 阻断应答有关的 T 细胞群。这些是对应数据与评估条件下的结果。
代码和安装说明见 项目文档。
数据预处理
TESSA 需要按指定格式保存受体序列与 GEX 文件。
先创建包含以下信息的 CSV:
contig_id:本例用 Cell Barcode 作为索引列。
cdr3:本例去掉首尾残基后的 CDR3β 序列;应先确认输入确实包含所需去除的边界字符。
df_tcr = adata_tc.obs
df_tcr.index.name = "contig_id"

# trimm cdr3 sequence
df_tcr["cdr3"] = [seq[1:-1] for seq in df_tcr["IR_VDJ_1_junction_aa"]]

# select only columns needed
df_tcr = df_tcr[["cdr3"]]

df_tcr.to_csv(f"{path_tmp}/TESSA_tcrs.csv")
df_tcr.head(5)参考 TESSA 示例,选择约 10% 的高变基因(Highly Variable Genes, HVGs)。代码以当前基因数除以 10 后向下取整,作为 n_top_genes。
n_genes = adata_tc.shape[1] // 10
sc.pp.highly_variable_genes(adata_tc, n_top_genes=n_genes)
adata_tessa = adata_tc[:, adata_tc.var["highly_variable"]].copy()
将所选 GEX 矩阵保存为 CSV,并转置为“基因×细胞”。行名是基因,列名是 Cell Barcode。这里导出的是当前 .X 中的表达值,不能仅因变量名叫 count_mat 就认定其为原始 Count;同时应确保细胞名称与受体输入一致。
count_mat = adata_tessa.X.A
df_counts = pd.DataFrame(count_mat)

df_counts.index = adata_tessa.obs.index
df_counts.index.name = ""
df_counts.columns = adata_tessa.var.index

df_counts = df_counts.transpose()

df_counts.to_csv(f"{path_tmp}/TESSA_gex.csv")
df_counts.head()运行模型
将输入文件、预训练模型及输出路径汇总到设置字典中。
settings_full = {
    # Input files
    "tcr": f"{path_tmp}/TESSA_tcrs.csv",
    "exp": f"{path_tmp}/TESSA_gex.csv",
    # TESSA models
    "model": "TESSA/BriseisEncoder/TrainedEncoder.h5",
    "embeding_vectors": "TESSA/BriseisEncoder/Atchley_factors.csv",
    # Output files
    "output_TCR": f"{path_res}/TESSA_tcr_embedding.csv",
    "output_log": f"{path_res}/TESSA_log.log",
    "output_tessa": f"{path_res}",
    "within_sample_networks": "FALSE",
}
指定运行环境,并将设置逐项加入 TESSA 命令。
cmd_tessa = "source ~/.bashrc &&"
cmd_tessa += "conda activate TESSA && "

cmd_tessa += "python TESSA/Tessa_main.py"
for key, value in settings_full.items():
    cmd_tessa += f" -{key} {value}"
cmd_tessa
'source ~/.bashrc &&conda activate TESSA && python TESSA/Tessa_main.py -tcr ./data/tmp/TESSA_tcrs.csv -exp ./data/tmp/TESSA_gex.csv -model TESSA/BriseisEncoder/TrainedEncoder.h5 -embeding_vectors TESSA/BriseisEncoder/Atchley_factors.csv -output_TCR ./data/res/TESSA_tcr_embedding.csv -output_log ./data/res/TESSA_log.log -output_tessa ./data/res -within_sample_networks FALSE'调用命令后,运行时间取决于数据量与计算资源。由于日志较多,示例使用 %%capture 这一单元 魔术命令(magic) 捕获输出;调试时可移除首行以查看日志。
%%capture
!$cmd_tessa输出
运行成功后,主要使用以下三个输出文件:
TESSA_tcr_embedding.csv:仅由 TCR 序列生成的 Embedding,不含 GEX。
result_meta.csv:逐细胞的分组注释。
tessa_final.RData:推断的模型参数,例如权重向量 b。
下面读取前两个文件,并将序列 Embedding 放入 AnnData。本例按 Embedding 整行去重,以减少后续展示中的重复记录;这是模型运行后的整理,不能改变已经完成的 TESSA 分组,也不严格等同于按完整受体定义克隆。构建 AnnData 前,应将 obs 按 Embedding 的索引重排,单用 isin 筛选不会保证行序一致。
tessa_embedding = pd.read_csv(f"{path_res}/TESSA_tcr_embedding.csv", index_col=0)
tessa_embedding = tessa_embedding.drop_duplicates()
tessa_obs = adata_tc[adata_tc.obs.index.isin(tessa_embedding.index)].obs
tessa_embedding = sc.AnnData(X=tessa_embedding.values, obs=tessa_obs)
再加入 TESSA 分组。代码尝试将输出 Barcode 中的点替换为连字符以恢复匹配;应核对实际名称,且注意 pandas 不同版本的 str.replace 正则默认行为。下面以 .values 赋值前必须按细胞索引对齐 clustering,否则标签可能错配;这段代码没有另外执行“簇内 TCR 去重”。
clustering = pd.read_csv(f"{path_res}/result_meta.csv", index_col=0)
clustering.index = clustering.index.str.replace(".", "-")
clustering = clustering[clustering.index.isin(tessa_embedding.obs.index)]
tessa_embedding.obs["TESSA_cluster"] = clustering["cluster_number"].values

print(f"Unique clones: {tessa_embedding.obs['cdr3'].nunique()}")
print(f"Unique clusters: {tessa_embedding.obs['TESSA_cluster'].nunique()}")
Unique clones: 751
Unique clusters: 134
原教程报告 751 个克隆分为 144 个组;这些数量取决于数据、去重和分组设置。下面在 TCR Embedding 上运行 t 分布随机邻居嵌入(t-distributed Stochastic Neighbor Embedding, t-SNE),突出显示去重后记录数最多的十个组。
sc.pp.neighbors(tessa_embedding)
sc.tl.tsne(tessa_embedding)

top_10_clusters = tessa_embedding.obs["TESSA_cluster"].value_counts().head(10).index
tessa_embedding.obs["TESSA_cluster_top10"] = tessa_embedding.obs["TESSA_cluster"].apply(
    lambda x: x if x in top_10_clusters else np.nan
)

sc.pl.tsne(tessa_embedding, color="TESSA_cluster_top10")
WARNING: Consider installing the package MulticoreTSNE (https://github.com/DmitryUlyanov/Multicore-TSNE). Even for n_jobs=1 this speeds up the computation considerably and might yield better converged results.
... storing 'TESSA_cluster' as categorical
... storing 'TESSA_cluster_top10' as categorical
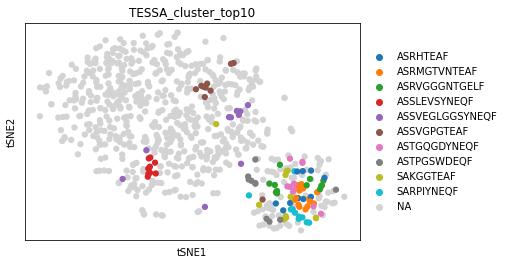
为在 GEX 空间显示这些分组,按 CDR3β 将标签映射回原始 AnnData。若同一 CDR3β 对应多个分组,简单字典会覆盖重复键,映射前应核对唯一性。
mapping_dict = dict(
    tessa_embedding.obs[["IR_VDJ_1_junction_aa", "TESSA_cluster_top10"]].values
)
adata_tc.obs["TESSA_cluster_top10"] = adata_tc.obs["IR_VDJ_1_junction_aa"].map(
    mapping_dict
)
sc.pl.umap(adata_tc, color="TESSA_cluster_top10")
... storing 'cdr3' as categorical
... storing 'TESSA_cluster_top10' as categorical
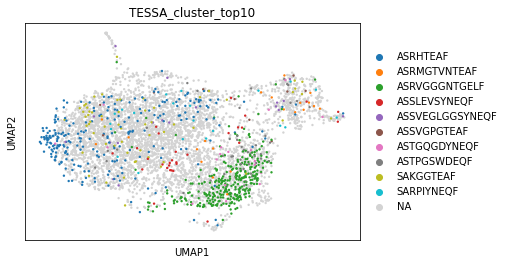
两种可视化可共同显示序列与表达之间的关联,但单一模态未必呈现完整的联合分组结构。这些群体可用于后续表达或基序分析;它们的相似性不能单独确证共同表位,且 GEX 已参与训练,不能再把同一 GEX 上的分离当作独立验证。
CoNGA
CoNGA Schattgen et al., 2022 在克隆型层面分别构建 GEX 与 TCR 邻居图,受体侧使用 TCRdist Dash et al., 2017。通过比较两种图的邻域及相应分组,寻找序列和表达共同支持的关联。原研究发现一些群体可富集相近的受体理化性质或已知特异性,但联合分组本身不等于功能确证。流程各步骤详见 项目文档;这里主要演示输入转换及主流程调用。
数据准备
CoNGA 支持 h5ad 等 GEX 输入。受体侧先将 Cell Ranger contig 表限制到所选细胞,再运行预处理脚本生成 clone_file。
df_tcr = pd.read_csv(
    f"{path_data}/TCR_00_read_aligned.csv",
    # index_col='barcode',
)
df_tcr = df_tcr.drop("Unnamed: 0", axis=1)
df_tcr = df_tcr[df_tcr["barcode"].isin(adata_tc.obs.index)]

path_reduced_tcr = f"{path_tmp}/conga_tcrs.csv"
df_tcr.to_csv(path_reduced_tcr)

path_conga_clones = f"{path_tmp}/conga_clone_file.tsv"
cmd_conga_pp = (
"python conga/scripts/setup_10x_for_conga.py "
f"--filtered_contig_annotations_csvfile {path_reduced_tcr} "
f"--output_clones_file {path_conga_clones} "
"--organism human"
)%%capture
!$cmd_conga_ppCoNGA 的这一流程要求未经对数转换的表达输入。下面用 expm1 撤销当前矩阵的 log1p,再另存为 h5ad。该逆变换只能恢复取对数前的数值,不能撤销更早的归一化(normalization)或缩放,因此通常无法从已归一化数据重建原始 Count。分析自己的数据时,应优先提供保留的原始 Count,并核对工具的输入要求。
path_conga_gex = f"{path_tmp}/conga_gex.h5ad"

adata_conga = adata_tc.copy()
adata_conga.X = np.expm1(adata_tc.X)
sc.write(adata=adata_conga, filename=path_conga_gex)
执行 CoNGA
下面的命令指定 GEX、克隆文件、物种和输出前缀,并开启图与图、图与特征(feature)等分析。
cmd_conga = f"cd {path_res} && "

cmd_conga += (
    "python ../../conga/scripts/run_conga.py "
    f"--graph_vs_graph --graph_vs_graph_stats --graph_vs_features --tcr_clumping --find_hotspot_features "
    f"--gex_data ../../{path_conga_gex} --gex_data_type h5ad "
    f"--clones_file ../../{path_conga_clones} "
    f"--organism human --outfile_prefix conga"
)
%%capture
!$cmd_conga输出
运行成功后,结果摘要写入 ./data/res/conga_results_summary.html,各项结果附有说明。原文另列了路径 ./data/res_conga/,但上面设置的 path_res 为 ./data/res,实际文件应以该次运行的输出设置为准。完整结果解释可参阅生成的网页报告和项目的 Colab 教程。
mvTCR
An 等人提出的 mvTCR 用多视图 VAE 将 TCR 序列与 GEX 压缩到联合低维空间 An et al., 2021。序列侧采用 Transformer,表达侧采用多层感知机(Multi-Layer Perceptron, MLP),再整合两类表示。训练后可将适用范围内的新数据映射到同一空间,但需要兼容的输入处理和特征集合。
作者在 Genomics, 2019 的数据上报告,多模态表示在相关特异性预测与聚类任务中优于单模态表示;在 Fischer et al., 2021 的 SARS-CoV-2 数据上,也观察到细胞类型和受体相关信息的保留。结果适用于相应评估设置。代码及说明见 项目文档。
mvTCR 使用 AnnData,并提供受体编码、数据拆分等预处理函数。下面先准备训练输入。
import sys

sys.path.append("mvTCR")
sys.path.append(".")

import tcr_embedding.utils_training as utils
from tcr_embedding.models.model_selection import run_model_selection
from tcr_embedding.utils_preprocessing import encode_tcr, group_shuffle_split
训练对象需要克隆型标签,定义方法见 克隆型分析。本例保留两条主链都有序列的细胞,并按两类主链定义 clonotype。原文仍留有将前面章节的统一注释接入此处的待办。
adata_mvtcr = adata_tc[~adata_tc.obs["IR_VJ_1_junction_aa"].isna()].copy()# todo delete once data is unified
ir.tl.define_clonotypes(
adata_mvtcr, key_added="clonotype", receptor_arms="all", dual_ir="primary_only"
)100%|██████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 728/728 [00:00<00:00, 795.39it/s]
对 CDR3α 和 CDR3β 做数值编码,指定对应的氨基酸序列列。pad 用于统一序列长度;本例取当前两类链的最大长度。若后续要映射新数据,还需预先考虑更长序列及模型的长度限制。
pad = max(
    adata_mvtcr.obs["IR_VJ_1_junction_aa"].str.len().max(),
    adata_mvtcr.obs["IR_VDJ_1_junction_aa"].str.len().max(),
)
encode_tcr(
    adata_mvtcr,
    column_cdr3a="IR_VJ_1_junction_aa",
    column_cdr3b="IR_VDJ_1_junction_aa",
    pad=pad,
)
训练集和验证集分别标为 train 和 val,保存在 adata.obs['set'] 中。下面按 clonotype 分组,将约 20% 的克隆型分到验证集,同一克隆型不跨训练与验证集;这不等于恰好 20% 的细胞。用于模型选择的验证集也不是独立的最终测试集。
train, val = group_shuffle_split(adata_mvtcr, group_col="clonotype", val_split=0.2)
adata_mvtcr.obs["set"] = "train"
adata_mvtcr.obs.loc[val.obs.index, "set"] = "val"
设置实验名称、模型类型、按 clonotype 平衡采样和结果路径。model_name="moe" 指混合专家(mixture of experts, MoE);原代码注释中的 “Export” 是拼写笔误。
params_experiment = {
    "study_name": "test_haniffa",  # Name that identifies the study
    "model_name": "moe",  # Type of mixture model used during training, authors suggest using Mixture of Export (moe)
    "balanced_sampling": "clonotype",  # Column containing the id for clonotypes
    "comet_workspace": None,  # Can be used to log experiments via comet-ml
    "save_path": path_res,  # Output path, were the selected models are stored
}
mvTCR 可通过超参数搜索选择模型。本例使用 pseudo_metric 模式,根据潜在表示保留多种标签的能力评分。两项标签为克隆型(clonotype)和细胞类型(原文记作 functional.cluster,实际代码为 full_clustering),评分权重均为 1。这些是模型选择指标的权重,不是直接给两种原始模态乘上的系数。若表示偏向某一模态,可调整评估目标并扩大搜索,但需另行验证。
params_optimization = {
    "name": "pseudo_metric",
    "prediction_labels": {"clonotype": 1, "full_clustering": 1},
}
下面只运行一次模型选择试验,用于演示接口;这不等同于充分的超参数搜索。训练通常受益于 GPU,实际时间取决于数据量、模型和设备。
n_runs = 1
run_model_selection(adata_mvtcr, params_experiment, params_optimization, n_runs)
输出
[I 2022-11-17 13:46:07,144] A new study created in RDB with name: test_haniffa
100%|███████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 200/200 [08:12<00:00,  2.46s/it]
[I 2022-11-17 13:54:41,499] Trial 0 finished with value: 1.681318287535559 and parameters: {'dropout': 0.1, 'activation': 'linear', 'rna_hidden': 1500, 'hdim': 200, 'shared_hidden': 100, 'rna_num_layers': 1, 'tfmr_encoding_layers': 4, 'loss_weights_kl': 4.0428727350273357e-07, 'loss_weights_tcr': 0.034702669886504146, 'lr': 1.0994335574766187e-05, 'zdim': 50, 'tfmr_embedding_size': 16, 'tfmr_num_heads': 8, 'tfmr_dropout': 0.15000000000000002}. Best is trial 0 with value: 1.681318287535559.
Study statistics:
  Number of finished trials: 1
  Number of pruned trials: 0
  Number of complete trials: 1
Best trial:
  trial_0
  Value: 1.681318287535559
训练成功后,加载本次试验中保存的模型,用于生成同时包含 TCR 与 GEX 信息的表示。此处 best_trial=0 对应演示中的唯一一次试验。
best_trial = 0
path_model = f"../data/res/trial_{best_trial}/best_model_by_metric.pt"
model = utils.load_model(adata_mvtcr, path_model)
取得潜在表示并加入原始细胞注释;复制 .obs 前需保证潜在表示与输入细胞顺序一致。
mvtcr_embedding = model.get_latent(adata_mvtcr, metadata=[])
mvtcr_embedding.obs = adata_mvtcr.obs.copy()
该 Embedding 可用于下游分析。这里先选出细胞数最多的十个克隆型,作为可视化标签。
top_10_clones = mvtcr_embedding.obs["clonotype"].value_counts().head(10).index
mvtcr_embedding.obs["clonotypes_top10"] = mvtcr_embedding.obs["clonotype"].apply(
    lambda x: x if x in top_10_clones else np.nan
)
在联合表示上构建邻居图和 UMAP,分别显示细胞类型与前十个克隆型。
sc.pp.neighbors(mvtcr_embedding)
sc.tl.umap(mvtcr_embedding)
sc.pl.umap(mvtcr_embedding, color=["full_clustering", "clonotypes_top10"], ncols=1)
... storing 'clonotype' as categorical
... storing 'set' as categorical
... storing 'clonotypes_top10' as categorical
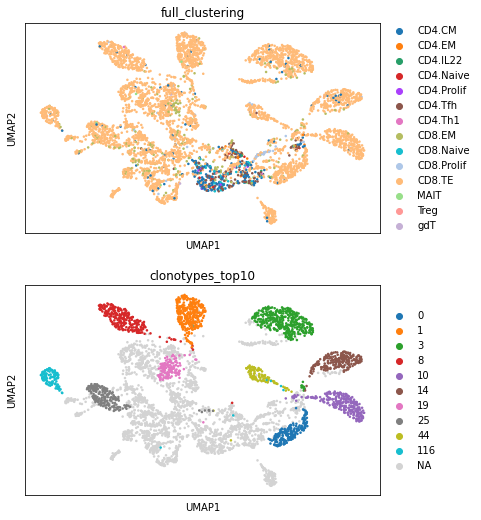
本例的联合表示按克隆型呈现分离,克隆内部还可见与 GEX 有关的结构。可以结合不同模态的保留程度调整模型选择目标,并进行更充分的参数搜索。随后可用 Scanpy 开展聚类等分析,但 UMAP 上的分离本身不足以证明所有生物学信息均被正确保留。
整合 BCR 与 GEX
上述方法原本面向 TCR。原论文并未全面验证 CoNGA、mvTCR 在 BCR 数据上的适用性,不能仅因受体结构相似就直接移用。TESSA 使用预训练 TCR 编码器,不宜直接用于 BCR。相关作者另提出 Benisse,用于 BCR 与 GEX 的联合分析 Zhang et al., 2022。
原教程同样将 BCR 多模态整合作为探索性方向。使用时应确认模型的数据要求和验证范围。
Benisse
Benisse 用预训练编码器将 BCR 重链 CDR3 表示为数值向量。本例按克隆汇总 GEX,以同一克隆内细胞的平均表达构成代表,再学习稀疏图,寻找在受体和表达层面相关的克隆。图中的相似关系并非已确定的祖先–后代关系。
输入准备与 TESSA 类似,下面重点说明不同之处。
为控制运行时间,先保留有重链 CDR3 的细胞,选择 sample_id 为 MH9143275 的样本,再以 random_state=0 抽取 1,000 个细胞。
adata_benisse = adata_bc[~adata_bc.obs["IR_VDJ_1_junction_aa"].isna()]
adata_benisse = adata_benisse[adata_benisse.obs["sample_id"] == "MH9143275"]
sc.pp.subsample(adata_benisse, n_obs=1000, random_state=0)
print(f"Amount of cells: {len(adata_benisse)}")
Amount of cells: 1000
df_bcr = adata_benisse.obs
df_bcr.index.name = "contigs"

df_bcr = df_bcr.rename(columns={"IR_VDJ_1_junction_aa": "cdr3"})

df_bcr = df_bcr[["cdr3"]]

df_bcr.to_csv(f"{path_tmp}/BENISSE_bcrs.csv")
df_bcr.head(5)参考项目示例,选择 1,000 个高变基因,并将当前表达矩阵转置为“基因×细胞”后导出。变量名 count_mat 不改变其实际归一化尺度。
sc.pp.highly_variable_genes(adata_benisse, n_top_genes=1000)
adata_benisse = adata_benisse[:, adata_benisse.var["highly_variable"]].copy()

count_mat = adata_benisse.X.A
df_counts = pd.DataFrame(count_mat)

df_counts.index = adata_benisse.obs.index
df_counts.index.name = ""
df_counts.columns = adata_benisse.var.index

df_counts = df_counts.transpose()

df_counts.to_csv(f"{path_tmp}/BENISSE_gex.csv")
df_counts.head()Benisse 还需要 Cell Ranger 格式的 contig 表。下面按刚刚实际选出的细胞 Barcode 过滤原始记录,使其与受体和 GEX 输入对应;不只是保留供体的全部记录。
path_bcr_contigs = f"{path_data}/BCR_00_read_aligned.csv"
df_bcr_contigs = pd.read_csv(path_bcr_contigs, index_col=0, low_memory=False)
df_bcr_contigs = df_bcr_contigs[df_bcr_contigs["barcode"].isin(adata_benisse.obs.index)]
df_bcr_contigs.to_csv(f"{path_tmp}/BENISSE_bcr_contigs.csv")运行模型
先调用预训练编码器生成 BCR 表示。示例设置 cuda="True",要求相应的 GPU 运行环境。
settings_embedding = {
    "input_data": f"{path_tmp}/BENISSE_bcrs.csv",
    "output_data": f"{path_res}/BENISSE_encoded_bcrs.csv",
    "cuda": "True",
}
cmd_bcr_embedding = "source ~/.bashrc && "
cmd_bcr_embedding += "conda activate BENISSE && "
cmd_bcr_embedding += "python Benisse/AchillesEncoder.py"
for key, value in settings_embedding.items():
cmd_bcr_embedding += f" --{key} {value}"
cmd_bcr_embedding'source ~/.bashrc && conda activate BENISSE && python Benisse/AchillesEncoder.py --input_data ./data/tmp/BENISSE_bcrs.csv --output_data ./data/res/BENISSE_encoded_bcrs.csv --cuda True'%%capture
!$cmd_bcr_embedding再调用 R 脚本构建图。本例沿用原作者示例参数,并将最大迭代次数设为 100;这些值不代表对当前数据已充分调优。
max_iter = 100
cmd_benisse = [
    "source ~/.bashrc &&",
    "conda activate BENISSE &&",
    "export R_LIBS=$CONDA_PREFIX/lib/R/library &&",
    "Rscript Benisse/Benisse.R",
    f"{path_tmp}/BENISSE_gex.csv",
    f"{path_tmp}/BENISSE_bcr_contigs.csv",
    f"{path_res}/BENISSE_encoded_bcrs.csv",
    f"{path_res}",
    f"1610 1 {max_iter} 1 1 10 1e-10",
]
cmd_benisse = " ".join(cmd_benisse)
cmd_benisse
'source ~/.bashrc && conda activate BENISSE && export R_LIBS=$CONDA_PREFIX/lib/R/library && Rscript Benisse/Benisse.R ./data/tmp/BENISSE_gex.csv ./data/tmp/BENISSE_bcr_contigs.csv ./data/res/BENISSE_encoded_bcrs.csv ./data/res 1610 1 100 1 1 10 1e-10'即使限制迭代次数,运行仍可能需要数分钟或更久,取决于数据及硬件。
%%capture
!$cmd_benissefrom IPython.display import IFrame
IFrame(f"{path_res}/connectionplot.pdf", width=600, height=600)连接图展示 Benisse 学到的图结构,以克隆型为节点,关系同时参考 BCR 与 GEX 相似性。图上的邻近或连接不能直接解释为发育方向。
benisse_clusters = pd.read_csv(f"{path_res}/clone_annotation.csv", index_col=0)
benisse_clusters.index = [el.replace(".", "-") for el in benisse_clusters.index]
adata_benisse_out = adata_benisse[
    adata_benisse.obs.index.isin(benisse_clusters.index)
].copy()
adata_benisse_out.obs["benisse_clusters"] = benisse_clusters.loc[
    adata_benisse_out.obs.index
]["graph_label"]
sc.pp.neighbors(adata_benisse_out)
sc.tl.umap(adata_benisse_out)

top_10_clusters = (
    adata_benisse_out.obs["benisse_clusters"].value_counts().head(10).index
)
adata_benisse_out.obs["clusters_top10"] = adata_benisse_out.obs[
    "benisse_clusters"
].apply(lambda x: x if x in top_10_clusters else np.nan)
sc.pl.umap(adata_benisse_out, color="clusters_top10")
... storing 'benisse_clusters' as categorical
... storing 'clusters_top10' as categorical
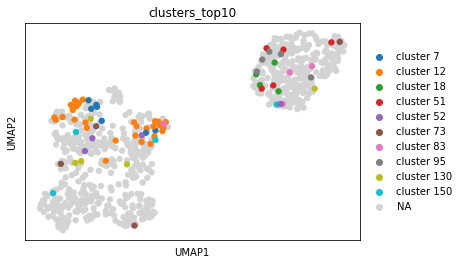
下面将细胞数最多的十个图分组映射到 GEX 的 UMAP 上。有些分组在表达空间聚集,有些则跨越多个状态。这些标签可用于后续受体或转录组分析;若要推断祖先关系,还需专门的谱系模型及序列演化证据,不能只凭这张相似性图确定。
测验
- Zhang, Z., Xiong, D., Wang, X., Liu, H., & Wang, T. (2021). Mapping the functional landscape of T cell receptor repertoires by single-T cell transcriptomics. Nature Methods, 18(1), 92–99.
- 10x Genomics. (2019). A New Way of Exploring Immunity–Linking Highly Multiplexed Antigen Recognition to Immune Repertoire and Phenotype. Tech. Rep.
- Glanville, J., Huang, H., Nau, A., Hatton, O., Wagar, L. E., Rubelt, F., Ji, X., Han, A., Krams, S. M., Pettus, C., & others. (2017). Identifying specificity groups in the T cell receptor repertoire. Nature, 547(7661), 94–98.
- Yost, K. E., Satpathy, A. T., Wells, D. K., Qi, Y., Wang, C., Kageyama, R., McNamara, K. L., Granja, J. M., Sarin, K. Y., Brown, R. A., & others. (2019). Clonal replacement of tumor-specific T cells following PD-1 blockade. Nature Medicine, 25(8), 1251–1259.
- Schattgen, S. A., Guion, K., Crawford, J. C., Souquette, A., Barrio, A. M., Stubbington, M. J., Thomas, P. G., & Bradley, P. (2022). Integrating T cell receptor sequences and transcriptional profiles by clonotype neighbor graph analysis (CoNGA). Nature Biotechnology, 40(1), 54–63.
- Dash, P., Fiore-Gartland, A. J., Hertz, T., Wang, G. C., Sharma, S., Souquette, A., Crawford, J. C., Clemens, E. B., Nguyen, T. H., Kedzierska, K., & others. (2017). Quantifiable predictive features define epitope-specific T cell receptor repertoires. Nature, 547(7661), 89–93.
- An, Y., Drost, F., Theis, F., Schubert, B., & Lotfollahi, M. (2021). Jointly learning T-cell receptor and transcriptomic information to decipher the immune response. bioRxiv.
- Fischer, D. S., Ansari, M., Wagner, K. I., Jarosch, S., Huang, Y., Mayr, C. H., Strunz, M., Lang, N. J., D’Ippolito, E., Hammel, M., & others. (2021). Single-cell RNA sequencing reveals ex vivo signatures of SARS-CoV-2-reactive T cells through ‘reverse phenotyping.’ Nature Communications, 12(1), 1–14.
- Zhang, Z., Chang, W. Y., Wang, K., Yang, Y., Wang, X., Yao, C., Wu, T., Wang, L., & Wang, T. (2022). Interpreting the B-cell receptor repertoire with single-cell gene expression using Benisse. Nature Machine Intelligence, 1–9.