🧠 关键要点
rapids-singlecell 在图形处理器(Graphics Processing Unit, GPU)上复刻 Scanpy 的应用程序编程接口(Application Programming Interface, API),因此大多数预处理和聚类(clustering)流程只需把 sc 替换为 rsc,再通过 rsc.get.anndata_to_GPU 将 AnnData 移至 GPU。
只选择一种分配器策略:数据能装入显存(Video Random-Access Memory, VRAM)时使用池分配器(pool allocator),否则使用托管内存(managed memory),也称统一内存。混用两者会造成内存碎片,并削弱加速效果。
某一步骤不再需要 GPU 后,用 rsc.get.anndata_to_CPU 将数据移回主机内存,释放中间 CuPy 数组,并调用 cp.get_default_memory_pool().free_all_blocks() 归还不再使用的 VRAM。
对于超出单块 GPU 显存容量的数据集,可将 dask-cuda 与 read_elem_lazy AnnData 读取器结合使用,以分块方式把数据流式传入 GPU;质量控制(Quality Control, QC)、高变基因(highly variable gene, HVG)选择、缩放和 主成分分析(principal component analysis, PCA) 等步骤偶尔会形成同步点并强制触发计算。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: rapids_singlecell
channels:
  - conda-forge
  - bioconda
dependencies:
  - python=3.14
  - conda-forge::scanpy=1.12.1
  - pip
  - pip:
      - --extra-index-url=https://pypi.nvidia.com
      - rapids-singlecell-cu13[rapids]
      - lamindb
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
本书的大多数章节都在 中央处理器(central processing unit, CPU) 上运行,数据集规模为数万到数十万个细胞。如今的细胞图谱已达到数百万个细胞;同一套 scanpy 风格的流程,在笔记本电脑上几分钟就能跑完,在工作站上却可能耗费数小时,甚至在结束前就因内存耗尽而崩溃。
rapids-singlecell(RSC)是 scverse 核心软件包之一,它将 scanpy 应用程序编程接口(application programming interface, API) 移植到 图形处理器(graphics processing unit, GPU),底层采用 RAPIDS、CuPy 和 cuML Dicks et al., 2026Nolet et al., 2024。它还提供了部分 squidpy Palla et al., 2022、decoupler Mompel et al., 2022 和 pertpy Heumos et al., 2025 等例程的 GPU 实现。相对于 CPU 版 scanpy,标准的预处理和聚类(clustering)流程通常可获得 10–20× 的端到端加速,而 统一流形近似与投影(uniform manifold approximation and projection, UMAP)、t 分布随机邻域嵌入(t-distributed stochastic neighbor embedding, t-SNE)、Leiden 等单个步骤的运行速度可快 50–200×。
GPU 何时才划算?
当计算任务规整、且规模大到足以摊薄主机到设备的传输成本时,GPU 才有帮助。对于单细胞数据,大致的经验法则是:
约 5 万个细胞以下:用 CPU 版 scanpy 即可,此时传输开销可能占主导。只有当你在方法开发过程中需要快速迭代时,才使用 GPU。
单块 GPU 上 5 万至 100 万个细胞:这是最佳区间。单块 24–80 GB 的 GPU 即可交互式地运行整条标准流程。
超过 100 万个细胞或显存(video random-access memory, VRAM)压力较大:将 RSC 与 dask-cuda 结合,用于核外计算(out-of-core computation)或多 GPU 执行(见下文)。
单块 GPU 的主要瓶颈是 VRAM,而不是计算。一个 1M 细胞 × 30k 基因的稠密 float32 表达矩阵约为 120 GB——根本放不下。正是稀疏的 压缩稀疏行格式(compressed sparse row, CSR) 格式让 GPU 上的单细胞分析变得可行,而下面的大多数最佳实践,都是关于如何让矩阵尽可能长时间地保持稀疏、并待在正确的位置上。
安装
最近的 RSC 发行版提供了预编译的 wheel 包,覆盖 统一计算设备架构(Compute Unified Device Architecture, CUDA) 12 和 13,以及从 Turing 到 Blackwell 的各代 GPU 架构。请使用 [rapids] 可选项进行安装,这样完整的 RAPIDS 堆栈(cuDF、cuML、cuGraph、RMM、CuPy)就会连同预编译的内核一起被拉取进来:
# CUDA 13
pip install 'rapids-singlecell-cu13[rapids]' --extra-index-url=https://pypi.nvidia.com

# CUDA 12
pip install 'rapids-singlecell-cu12[rapids]' --extra-index-url=https://pypi.nvidia.com
该 --extra-index-url 是必需的,因为 RAPIDS 的 wheel 包托管在 NVIDIA 的 PyPI 索引上,而不是公共索引上。在较旧的 RSC 版本中,你还必须额外安装 RAPIDS 的 conda 包;现在已不再需要这一步。
验证安装
在运行任何繁重任务之前,先确认 CuPy 能识别到你的 GPU:
import cupy as cp
print(cp.cuda.runtime.getDeviceCount(), cp.cuda.Device(0).name)
如果这里抛出 CUDARuntimeError,说明你的驱动版本早于 wheel 中的 CUDA 运行时——请更新 NVIDIA 驱动,而不是 CUDA 工具包。
使用 RMM 管理内存
RSC 的所有 GPU 分配都要经由 RAPIDS 内存管理器(RAPIDS Memory Manager, RMM)NVIDIA RAPIDS, 2024。导入 rapids_singlecell 已经把默认的 CuPy 分配器替换为基于 RMM 的分配器,但默认仍是普通的 CUDA 分配器:每次分配都是一次 cudaMalloc,而每次释放都是一次 cudaFree。单细胞流程会不断进行分配(每个 scanpy 函数都会产生一个临时数组),因此这个默认设置会白白浪费大量性能。
有两种策略,并且应该只选择其中一种:
池分配器(pool allocator)——RMM 会预先抓取一大块 VRAM,并从中满足后续的内存分配。这是迄今为止最快的方案,但它会把你限制在 VRAM 能容纳的范围内。只要你的数据集放得下,就使用此方案。
托管(统一)内存 ——分配由 CUDA 托管内存(managed memory)支持,因此驱动程序会在主机 RAM 与显存之间透明地换入换出数据。这正是你能在一块 40 GB GPU 上分析 200 GB 数据集的原因。它的单次操作较慢(缺页并非没有代价),但通常仍快于 CPU 版 scanpy。
请在 notebook 的 最顶部、在创建任何 CuPy 数组之前,配置池分配器。在 CuPy 已经分配之后再重新初始化 RMM,会泄漏旧的分配。
import cupy as cp
import rmm
from rmm.allocators.cupy import rmm_cupy_allocator

rmm.reinitialize(
    pool_allocator=True,
    managed_memory=False,
    initial_pool_size="4GB",  # size to expected peak — growth events defeat the pool's purpose
    maximum_pool_size="32GB",  # leave headroom for plotting libraries, etc.
)
cp.cuda.set_allocator(rmm_cupy_allocator)
为什么要显式设置初始池大小?
当 pool_allocator=True 和 initial_pool_size=None,RMM 只会预先抓取一半的 VRAM,并在此基础上增长。每一次增长都会触发一次新的 cudaMalloc ——这恰恰是内存池本应避免的——并且由于新分配的块与旧块不连续,还会使内存池产生碎片。将 initial_pool_size 设为接近你预期的峰值(在专用 GPU 上通常为 VRAM 的 60–80%),这样内存池就几乎不增长,或只增长极少次。maximum_pool_size 才是真正的上限,并且是独立的,因此你并没有限制自己——你只是告诉 RMM 在第一次调用时该抓取多少。
如果你的数据集放不下,就改用托管内存。在搭载 Pascal 或更新架构 GPU 的 Linux 上,这是真正的统一内存,开箱即支持超额订阅(oversubscription);而在 WSL2 下的 Windows 上,它是模拟实现的,速度略慢一些。
rmm.reinitialize(
    pool_allocator=False,
    managed_memory=True,
)
cp.cuda.set_allocator(rmm_cupy_allocator)
配置好分配器之后,其余的导入看起来就和普通的 scanpy notebook 一样—— rapids_singlecell 通常简写为 rsc。
import warnings

warnings.filterwarnings("ignore")

import anndata as ad
import pooch
import rapids_singlecell as rsc
import scanpy as sc
GPU 上的 scanpy 分析流程
RSC 有意镜像了 scanpy 的模块布局:rapids_singlecell.pp 用于预处理,rapids_singlecell.tl 用于工具。大多数 scanpy 调用都有一个签名相同、一一对应的 RSC 对应函数,因此移植流程基本上只是替换前缀的问题。
思路很简单:
像平常一样读入 AnnData(位于 CPU 内存中,稀疏的
.X)。使用以下函数将其一次性移至 GPU:
rapids_singlecell.get.anndata_to_GPU。运行繁重的预处理和聚类步骤时,使用
rsc.*。使用以下函数将其移回主机:
rapids_singlecell.get.anndata_to_CPU用于绘图、保存,或其他任何仅限 CPU 的操作。
我们采用了与上游 RSC 教程相同的示例数据集——一个约 90k 细胞的 DLI 普查子集——因此这里的运行时间可以直接与以下文档中所报告的时间相比较:rapids-singlecell 文档。
path = pooch.retrieve(
    url="https://exampledata.scverse.org/rapids-singlecell/dli_census.h5ad",
    fname="dli_census.h5ad",
)
adata = ad.read_h5ad(path)
adata.var_names = adata.var.feature_name
adata
AnnData object with n_obs × n_vars = 216611 × 25430
obs: 'soma_joinid', 'dataset_id', 'assay', 'assay_ontology_term_id', 'cell_type', 'cell_type_ontology_term_id', 'development_stage', 'development_stage_ontology_term_id', 'disease', 'disease_ontology_term_id', 'donor_id', 'is_primary_data', 'observation_joinid', 'self_reported_ethnicity', 'self_reported_ethnicity_ontology_term_id', 'sex', 'sex_ontology_term_id', 'suspension_type', 'tissue', 'tissue_ontology_term_id', 'tissue_type', 'tissue_general', 'tissue_general_ontology_term_id', 'raw_sum', 'nnz', 'raw_mean_nnz', 'raw_variance_nnz', 'n_measured_vars'
var: 'soma_joinid', 'feature_id', 'feature_name', 'feature_type', 'feature_length', 'nnz', 'n_measured_obs', 'n_cells'rapids_singlecell.get.anndata_to_GPU 及其 anndata_to_CPU 对应函数仅作用于 .X 和 .layers — obs,var,obsm,以及 varm 始终留在主机上。默认只移动 .X;传入 convert_all=True 以同时移动所有层,或传入 layer="<name>" 以移动该层而非 .X。该传输会就地将矩阵转换为 CuPy CSR(或稠密的 cupy.ndarray),之后下游的 RSC 调用都从设备内存读取。
rsc.get.anndata_to_GPU(adata)质量控制
质量控制(quality control, QC) 指标和基因过滤在 rapids_singlecell.pp 中有 GPU 实现。对于基因家族的掩码本身,我们使用普通的 pandas startswith 直接作用于 adata.var_names:索引为主机侧的 pandas.Index 无论 .X 位于何处,因此再经过一层包装器并不会带来任何收益。
adata.var["MT"] = adata.var_names.str.startswith("MT-")
adata.var["RIBO"] = adata.var_names.str.startswith(("RPS", "RPL"))
rsc.pp.calculate_qc_metrics(adata, qc_vars=["MT", "RIBO"])

adata = adata[adata.obs["n_genes_by_counts"] < 5000]
adata = adata[adata.obs["pct_counts_MT"] < 20]
rsc.pp.filter_genes(adata, min_cells=3)
adata.shape
(213191, 25430)归一化、HVG 与缩放
这些函数是以下章节所述 scanpy 函数的一对一移植:归一化 和 特征选择。scanpy 的所有 flavor= 选项可用于 highly_variable_genes(seurat,seurat_v3,seurat_v3_paper,cell_ranger,pearson_residuals)且均支持 GPU。RSC 还提供 flavor="poisson_gene_selection",它是 M3Drop 解析式泊松基因选择(analytical Poisson gene selection)的 CUDA 内核移植版本,而 scanpy 中并没有与之对应的 CPU 版本。
rsc.pp.normalize_total(adata, target_sum=1e4)
rsc.pp.log1p(adata)
rsc.pp.highly_variable_genes(adata, n_top_genes=5000, flavor="cell_ranger")
adata.raw = adata
rsc.pp.filter_highly_variable(adata)
rsc.pp.scale(adata, max_value=10)
暂存到 .raw 会使 VRAM 瞬时翻倍
把 高变基因(highly variable gene, HVG) 之前的矩阵暂存起来的标准做法是存入 .raw 会复制 .X ——在 GPU 上,这份副本位于 VRAM 中,大致会使以下两步之间的内存占用翻倍:adata.raw = adata 和 rapids_singlecell.pp.scale。在一个 90k 细胞的示例上,这并不要紧;但在 100 万细胞的图谱上,这种瞬时的 2× 峰值正是会让你 内存不足(out of memory, OOM)的原因。如果你之后不需要 .raw 用于标记基因分析,或在差异表达分析中设置 use_raw=True,就直接删掉这一行。如果需要,就把 initial_pool_size 设置得足以覆盖峰值,或者在迁移到 GPU 之前,先在 CPU 上完成 归一化 → HVG → raw 这一循环。
PCA、近邻、UMAP 与聚类
主成分分析(principal component analysis, PCA) 会根据输入类型分派到不同实现:稠密矩阵(dense matrix)交给 cuML(PCA 用于 zero_center=True,TruncatedSVD 用于其他情况);chunked=True 时使用 cuML 的 IncrementalPCA。对于其他输入(稀疏矩阵(sparse matrix)和 Dask 输入),RSC 使用自己的 CUDA 内核实现:特征数不超过 8k 时走协方差特征分解路径,更宽的矩阵则走 Lanczos 奇异值分解(singular value decomposition, SVD)。近邻默认使用暴力精确 K 近邻(k-nearest neighbors, KNN),同时也为超大数据集提供若干由 cuVS 支持的近似方法。UMAP 由 cuML 支持;Leiden 则通过 cuGraph 运行。
rsc.tl.pca(adata, n_comps=50)
rsc.pp.neighbors(adata, n_neighbors=15, n_pcs=40)
rsc.tl.umap(adata)
rsc.tl.leiden(adata, resolution=0.6)
近似 KNN 以精度换取可扩展性
rapids_singlecell.pp.neighbors 通过以下方式暴露 cuVS 的近似最近邻后端:algorithm=:
brute(默认):精确 KNN,复杂度为 O(n²)。最适合约 50 万细胞以下的数据集;超过该规模后,二次方的代价将占主导,此时 近似近邻(approximate nearest neighbors, ANN) 后端更快。ivfflat:倒排文件 ANN。当brute变得太慢时,它是一个稳妥的默认选择——速度快、在聚类边界上表现良好,并且可通过n_lists/n_probes。all_neighbors:cuVS 的分批/聚类 ANN(底层使用nn_descent或ivf_pq),它会把数据集划分到多个簇、并分布到多块 GPU 上。当数据集超出 VRAM、或你有多块 GPU 可用时,这是正确的选择。ivfpq:与ivfflat类似,但通过乘积量化(product quantization)来压缩索引,以一定的精度代价支持超大数据集。cagra和nn_descent:基于图的 ANN 后端,可用于比较;nn_descent尤其在极高维度下表现出色。
所有这些方法都会在边缘处改变聚类分配。如果你用相同的工作流程重新运行,brute 再换用某个 ANN 后端运行,可以预期大部分细胞会落入相同的聚类,只有少数会发生变动——不要把这当作 bug。
绘图仍交由 scanpy 完成
RSC 刻意不重复 scanpy 的绘图 API。重计算完成后,你熟悉的 sc.pl.* 函数可直接使用—— obs,var,以及 obsm 中的嵌入已位于主机上,因此根据某个 obs 中的列或聚类标签为 UMAP 着色时,不需要任何传输。你只需要 rapids_singlecell.get.anndata_to_CPU,且仅当绘图从 .X 本身提取值时(例如按某个基因的表达着色,或绘制标记基因的点图)才需要。序列化也是如此:write_h5ad 和 write_zarr 要求矩阵位于主机端,因此写入前请调用 rapids_singlecell.get.anndata_to_CPU(adata),否则要么会报错,要么会持久化一个由 CuPy 支持的 .X,而它在仅有 CPU 的机器上将无法重新加载。
sc.pl.umap(adata, color=["leiden"], legend_loc="on data")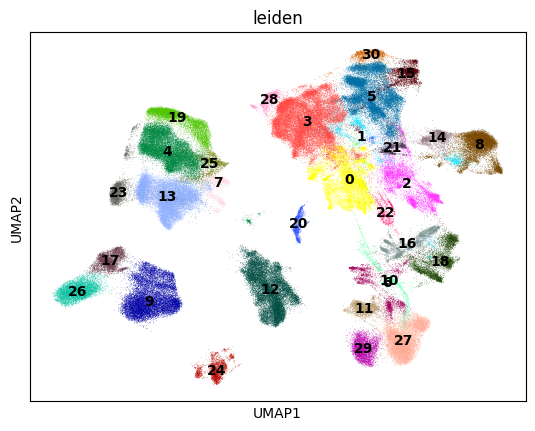
GPU 最佳实践
上面的流程在小数据集上几秒钟即可跑完。一旦扩大规模,下面这些习惯,正是区分高效工作流与频繁拖垮 GPU 的工作流的关键。
尽量减少主机↔设备之间的传输
每次 anndata_to_GPU / anndata_to_CPU 是一次 高速外设组件互连(Peripheral Component Interconnect Express, PCIe) 传输。一个 50 GB 的稀疏矩阵需要几秒钟才能移动,很容易就主导了那些本来很快的预处理步骤。
只移动一次,把所有 GPU 工作集中在一段连续的代码块中完成,然后再移动回来一次。避免在流程中间调用仅支持 CPU 的函数,从而强制触发一次隐式的数据迁移——如果必须混用,就把 CPU 端的工作批量处理。
显式释放中间结果
Python 的垃圾回收器并不会像你期望的那样积极地把 CuPy 内存归还给内存池。完成内存开销较大的步骤时(rapids_singlecell.pp.scale 作用于稠密数据、rapids_singlecell.pp.regress_out、对大型矩阵执行 PCA),请删除不再需要的层引用,并让 CuPy 将已释放的内存池块归还给驱动。
import gc

# Drop references to large intermediates first.
if "counts" in adata.layers:
    del adata.layers["counts"]
gc.collect()

# Then return any unused pool blocks to the driver.
cp.get_default_memory_pool().free_all_blocks()
cp.get_default_pinned_memory_pool().free_all_blocks()
监控 VRAM 使用情况
如果看不到设备上的情况,就很难为内存池设定合适的大小或诊断 OOM。有三种有用的查看方式:
# CuPy: what your process has allocated through the active pool.
pool = cp.get_default_memory_pool()
print(f"CuPy pool used: {pool.used_bytes() / 1e9:.2f} GB")
print(f"CuPy pool total: {pool.total_bytes() / 1e9:.2f} GB")

# CUDA: what the device reports as free vs total (across all processes).
free, total = cp.cuda.runtime.memGetInfo()
print(f"Device free: {free / 1e9:.2f} GB / {total / 1e9:.2f} GB")
CuPy pool used: 0.00 GB
CuPy pool total: 0.00 GB
Device free: 93.73 GB / 101.97 GB
在另一个终端中运行 nvidia-smi --query-gpu=memory.used,memory.free,utilization.gpu --format=csv -l 1 会按进程、每秒给你一次反馈——在调试一个跑了三步后突然 OOM 的流程时,这是不可或缺的。
留意 dtype(数据类型)
从 .h5ad 读取的 AnnData 对象通常为 float64。在 GPU 上,float64 会使你的内存占用翻倍,并且在消费级显卡上明显更慢(相比数据中心显卡,其 FP64 吞吐量受限)。
除非有特殊的数值精度要求,否则请转换为 float32 后再移到 GPU:
adata.X = adata.X.astype("float32")
rsc.get.anndata_to_GPU(adata)
RSC 在内部大多以 float64 进行归约计算,以在方差、PCA 等计算中保持数值稳定性,即便输入是 float32,因此你既能节省内存,又不会遭遇最坏情况下的精度损失。
为非确定性做好准备
GPU 的归约默认是非确定性的,因为浮点求和的顺序取决于线程调度。逐元素的差异极小,但可能让接近临界值的 HVG 排名发生翻转,或把某个细胞移到聚类边界的另一侧。如果精确的可复现性很重要,请设置 cp.random.seed(...) 并限制为单个 CUDA 流;但要接受这样一个事实:跨硬件得到逐比特一致的结果是不现实的。
使 NVIDIA 驱动程序与 CUDA 运行时相匹配
RSC 的 wheel 包固定了特定的 CUDA 运行时版本。你的 NVIDIA 驱动至少要和该运行时一样新;过旧的驱动会在加载 CuPy 时失败,并给出有误导性的错误。请更新驱动,而不是工具包——wheel 自带其工具包。
了解哪些功能尚未移植
严重依赖 R 软件包的工具(SoupX、scDblFinder、scran)以及那些并非瓶颈的工具(大多数绘图)都运行在 CPU 上。预期的模式是:在 GPU 上完成瓶颈步骤,其余则回到 CPU 处理。
注意共享服务器上的 MIG
如果你在共享服务器上,请检查是否启用了 多实例 GPU(Multi-Instance GPU, MIG)。MIG 会把单块 A100/H100 切分成更小的、相互隔离的 GPU,这对公平共享很有利,但也意味着你实际可用的 VRAM 可能比主机上 nvidia-smi 所显示的要少。
使用 dask-cuda 进行核外分析
即使使用托管内存也无法装入单块 GPU 时,RSC 会与 dask-cuda 集成,以通过一块或多块 GPU 流式处理矩阵的分块 Rocklin, 2015。AnnData 的惰性读取器(lazy reader)(read_elem_lazy 适用于 anndata ≥0.12;此前则使用 read_elem_as_dask),它会将 .X 以 Dask 数组的形式,直接从 Zarr 或 层次化数据格式第 5 版(Hierarchical Data Format version 5, HDF5) 存储中读取,而无需在主机 RAM 中将其完全实例化。
流程很短,但每一步都很关键。
from dask.distributed import Client
from dask_cuda import LocalCUDACluster

cluster = LocalCUDACluster(
    CUDA_VISIBLE_DEVICES="0",
    threads_per_worker=8,
    protocol="ucx",  # zero-copy GPU↔GPU comms over NVLink/InfiniBand if available
    rmm_pool_size="20GB",
    rmm_maximum_pool_size="40GB",
    rmm_allocator_external_lib_list="cupy",
)
client = Client(cluster)
输出
2026-05-06 11:21:24 | [INFO] To route to workers diagnostics web server please install jupyter-server-proxy: python -m pip install jupyter-server-proxy
2026-05-06 11:21:24 | [INFO] State start
2026-05-06 11:21:24 | [INFO] Found stale lock file and directory '/tmp/dask-scratch-space/scheduler-91l8od54', purging
2026-05-06 11:21:24 | [INFO] Found stale lock file and directory '/tmp/dask-scratch-space/worker-dmwfgw5g', purging
2026-05-06 11:21:24 | [WARNING] A CUDA context for device 0 (GPU-740d12cd-9ded-6e44-a5b5-5cd90037aebe) already exists on process ID 537888. This is often the result of a CUDA-enabled library calling a CUDA runtime function before Dask-CUDA can spawn worker processes. Please make sure any such function calls don't happen at import time or in the global scope of a program.
2026-05-06 11:21:24 | [INFO]   Scheduler at:     ucx://127.0.0.1:53865
2026-05-06 11:21:24 | [INFO]   dashboard at:  http://127.0.0.1:8787/status
2026-05-06 11:21:24 | [INFO] Registering Worker plugin shuffle
[1778059284.202777] [2cab62a-lcedt:537888:0]          parser.c:2359 UCX  WARN  unused environment variable: UCX_MEMTYPE_CACHE (maybe: UCX_MEMTYPE_CACHE?)
[1778059284.202777] [2cab62a-lcedt:537888:0]          parser.c:2359 UCX  WARN  (set UCX_WARN_UNUSED_ENV_VARS=n to suppress this warning)
2026-05-06 11:21:24 | [INFO]         Start Nanny at: 'ucx://127.0.0.1:47175'
2026-05-06 11:21:25 | [INFO] Register worker addr: ucx://127.0.0.1:52107 name: 0
2026-05-06 11:21:25 | [INFO] Starting worker compute stream, ucx://127.0.0.1:52107
2026-05-06 11:21:25 | [INFO] Starting established connection to ucx://127.0.0.1:53865
2026-05-06 11:21:25 | [INFO] Receive client connection: Client-f48fc233-492c-11f1-b520-bcfce74fad1a
2026-05-06 11:21:25 | [INFO] Starting established connection to ucx://127.0.0.1:53865
from pathlib import Path

import zarr
from anndata.experimental import read_elem_lazy

# The lazy reader operates on a zarr store, so convert the cached h5ad once.
# In a real workflow you'd already have a zarr atlas on disk or in object storage.
zarr_path = Path(path).with_suffix(".zarr")
if not zarr_path.exists():
    ad.read_h5ad(path).write_zarr(zarr_path)

store = zarr.open(zarr_path)
X_lazy = read_elem_lazy(store["X"], chunks=(20_000, store["X"].attrs["shape"][1]))

adata = ad.AnnData(
    X=X_lazy,
    obs=ad.io.read_elem(store["obs"]),
    var=ad.io.read_elem(store["var"]),
)
rsc.get.anndata_to_GPU(adata)
第一次使用 Dask 路径时,最容易踩到下面几个实践细节:
大多数操作采用惰性执行(lazy execution),但有些不是。过滤和 log1p 保持惰性,只是把工作排入队列。normalize_total 同样保持惰性,但 只有显式传入 target_sum= 时才如此;若保留默认值 target_sum=None,就必须计算每个细胞的总和,以找出文库大小的中位数,这会触发一次同步。calculate_qc_metrics,highly_variable_genes,scale,以及 pca 需要对整个矩阵做一次完整的归约,并触发同步——可以把它们看作 Dask 流程中天然的断点。
用布尔掩码过滤,而不要用 scanpy.pp.filter_cells。内置过滤辅助函数会将计数物化,以决定保留哪些细胞,从而破坏惰性执行。应当从 QC 指标中一次性算好掩码,并直接用 .copy() 应用它们,以保持 CSR 格式而非视图:
adata = adata[adata.obs["n_genes_by_counts"].between(200, 10_000)].copy()分块大小是你必须调节的一个旋钮。分块太小,会让调度器被海量任务淹没;分块太大,又会在同步时撑爆 VRAM。对于 24–80 GB 的 GPU,每块 20–50k 个细胞是一个合理的起点;如果某一步比预期慢,可用 Dask 仪表板进行性能分析。
超越预处理:在 GPU 上使用 decoupler、Squidpy 和 pertpy
RSC 还封装了另外三个 scverse 软件包中部分例程的 GPU 实现,每组都位于各自的命名空间:
rsc.dcg.*—decoupler 功能分析(ulm,mlm,aucell,waggr,zscore)。在百万细胞的图谱上,转录因子(transcription factor, TF)活性推断可从 CPU 上的数小时缩短到单块 GPU 上的几分钟。除命名空间不同外,CPU 与 GPU 的 API 完全相同;参见 通路和基因集分析章节。rsc.gr.*—squidpy 空间分析(spatial_autocorr,co_occurrence,ligrec)。Moran’s I/Geary’s C 空间自相关(spatial autocorrelation)以及配体–受体置换检验(permutation test),是最能从 GPU 中获益的例程;参见 空间邻域章节,以了解它们在概念上的作用。邻域图本身仍然使用squidpy.gr.spatial_neighbors在 CPU 上完成。rsc.ptg.*—pertpy 扰动距离,通过Distance类实现。目前只移植了edistance,更多指标也即将推出。该 GPU 实现会即时重新计算距离,而不是实例化一个 n×n 的细胞距离矩阵,因此在涉及数百种扰动的筛选中,自助法(bootstrap)方差估计变得切实可行;参见 扰动建模章节。
import decoupler as dc
net = dc.op.collectri(organism="human", license="academic")
rsc.dcg.ulm(adata, net=net, raw=False, bsize=10_000)

import squidpy as sq
sq.gr.spatial_neighbors(adata, coord_type="generic")  # still CPU
rsc.gr.spatial_autocorr(adata, mode="moran")

distance = rsc.ptg.Distance(metric="edistance", obsm_key="X_pca")
df = distance.pairwise(adata, groupby="perturbation")
并非整个上游 API 都被移植——RSC 专注于那些既足够耗时、值得移植到 GPU,又足够“易并行”(embarrassingly parallel)、能保持数值忠实的例程。当前的覆盖范围请查阅 RSC 的 API 参考文档。
另见
rapids-singlecell 文档——API 参考和教程,包括百万细胞和核外演示。
RAPIDS 内存管理器——更深入地介绍池分配器、托管分配器和竞技场(arena)分配器的背景。
dask-cuda——多 GPU 与核外配置。
cuML 用户指南——为 PCA、UMAP、t-SNE 和逻辑回归标记基因检验提供支持的 GPU 机器学习库。
NVIDIA 单细胞分析博客文章——与 CPU 版 scanpy 对照的基准测试。
测验
- Dicks, S., Heumos, L., May, L., Jimenez, S., Angerer, P., Gold, I., Virshup, I., Fischer, F., Gill, M., Boerries, M., Nolet, C. J., Chen, T. J., & Theis, F. J. (2026). GPU-accelerated single-cell analysis at scale with rapids-singlecell. arXiv Preprint arXiv:2603.02402. 10.48550/arXiv.2603.02402
- Nolet, C. J., Gala, D., Fender, A., Patro, J. E.-P., Raff, E., Zedlewski, J., Rees, B., & Riedel, T. (2024). cuML: A Library for GPU Accelerated Machine Learning. Software Available from Rapids.Ai. https://github.com/rapidsai/cuml
- Palla, G., Spitzer, H., Klein, M., Fischer, D., Schaar, A. C., Kuemmerle, L. B., Rybakov, S., Ibarra, I. L., Holmberg, O., Virshup, I., Lotfollahi, M., Richter, S., & Theis, F. J. (2022). Squidpy: a scalable framework for spatial omics analysis. Nature Methods, 19(2), 171–178. 10.1038/s41592-021-01358-2
- Badia-i Mompel, P., Vélez Santiago, J., Braunger, J., Geiss, C., Dimitrov, D., Müller-Dott, S., Taus, P., Dugourd, A., Holland, C. H., Ramirez Flores, R. O., & others. (2022). decoupleR: Ensemble of computational methods to infer biological activities from omics data. Bioinformatics Advances, 2(1), vbac016.
- Heumos, L., Ji, Y., May, L., Green, T. D., Peidli, S., Zhang, X., Wu, X., Ostner, J., Schumacher, A., Hrovatin, K., Müller, M., Chong, F., Sturm, G., Tejada, A., Dann, E., Dong, M., Pinto, G., Bahrami, M., Gold, I., … Theis, F. J. (2025). Pertpy: an end-to-end framework for perturbation analysis. Nature Methods. 10.1038/s41592-025-02909-7
- NVIDIA RAPIDS. (2024). RMM: RAPIDS Memory Manager. https://github.com/rapidsai/rmm
- Rocklin, M. (2015). Dask: Parallel computation with blocked algorithms and task scheduling. Proceedings of the 14th Python in Science Conference, 126–132. 10.25080/Majora-7b98e3ed-013