🧠 关键要点
主成分分析(Principal Component Analysis, PCA)是一种线性降维(linear dimensionality reduction)方法,可生成按方差排序且彼此不相关的主成分(principal component, PC);它易于解释、计算高效,但不太适合可视化高度非线性的单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)数据。
统一流形近似与投影(Uniform Manifold Approximation and Projection, UMAP)是一种非线性方法,通过构建并优化图表示,同时保留数据的局部与全局结构,因此非常适合单细胞数据的可视化和聚类(clustering)。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: preprocessing
channels:
  - bioconda
  - conda-forge
dependencies:
  - conda-forge::ipywidgets=8.1.5
  - conda-forge::leidenalg=0.10.2
  - conda-forge::numba=0.61.0
  - conda-forge::python=3.12.9
  - conda-forge::r-base=4.3.3
  - conda-forge::r-soupx=1.6.2
  - conda-forge::r-sctransform=0.4.1
  - conda-forge::r-glmpca=0.2.0
  - conda-forge::rpy2=3.5.11
  - conda-forge::scanpy=1.11.1
  - conda-forge::session-info=1.0.0
  - bioconda::anndata2ri=1.3.2
  - bioconda::bioconductor-scdblfinder=1.16.0
  - bioconda::bioconductor-scry=1.14.0
  - bioconda::bioconductor-scran=1.30.0
  - bioconda::bioconductor-glmgampoi=1.14.0
  - pip
  - pip:
      - lamindb[bionty,jupyter]
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq) 是一种高通量 测序 技术,它会产生在细胞数和基因数上都具有高维度的数据集。因此,scRNA-seq 数据深受“维度灾难(curse of dimensionality)”之苦。
维度的诅咒
“维度的诅咒”最早由 R. Bellman 提出 Bellman et al., 1957;这一概念指出,理论上高维数据包含更多信息,实践中却并非如此。维度越高,数据往往含有越多噪声和冗余,因此增加信息并不一定有益于下游分析。
并非所有基因都有信息量,因此并非所有基因对聚类(clustering)等任务都是必需的。我们此前已通过特征选择(feature selection)来降低数据的维度。下一步,我们将用降维(dimensionality reduction)算法进一步降低单细胞 RNA-seq 数据的维度。这些算法是预处理过程中的重要一步,用于降低数据复杂度并便于可视化。
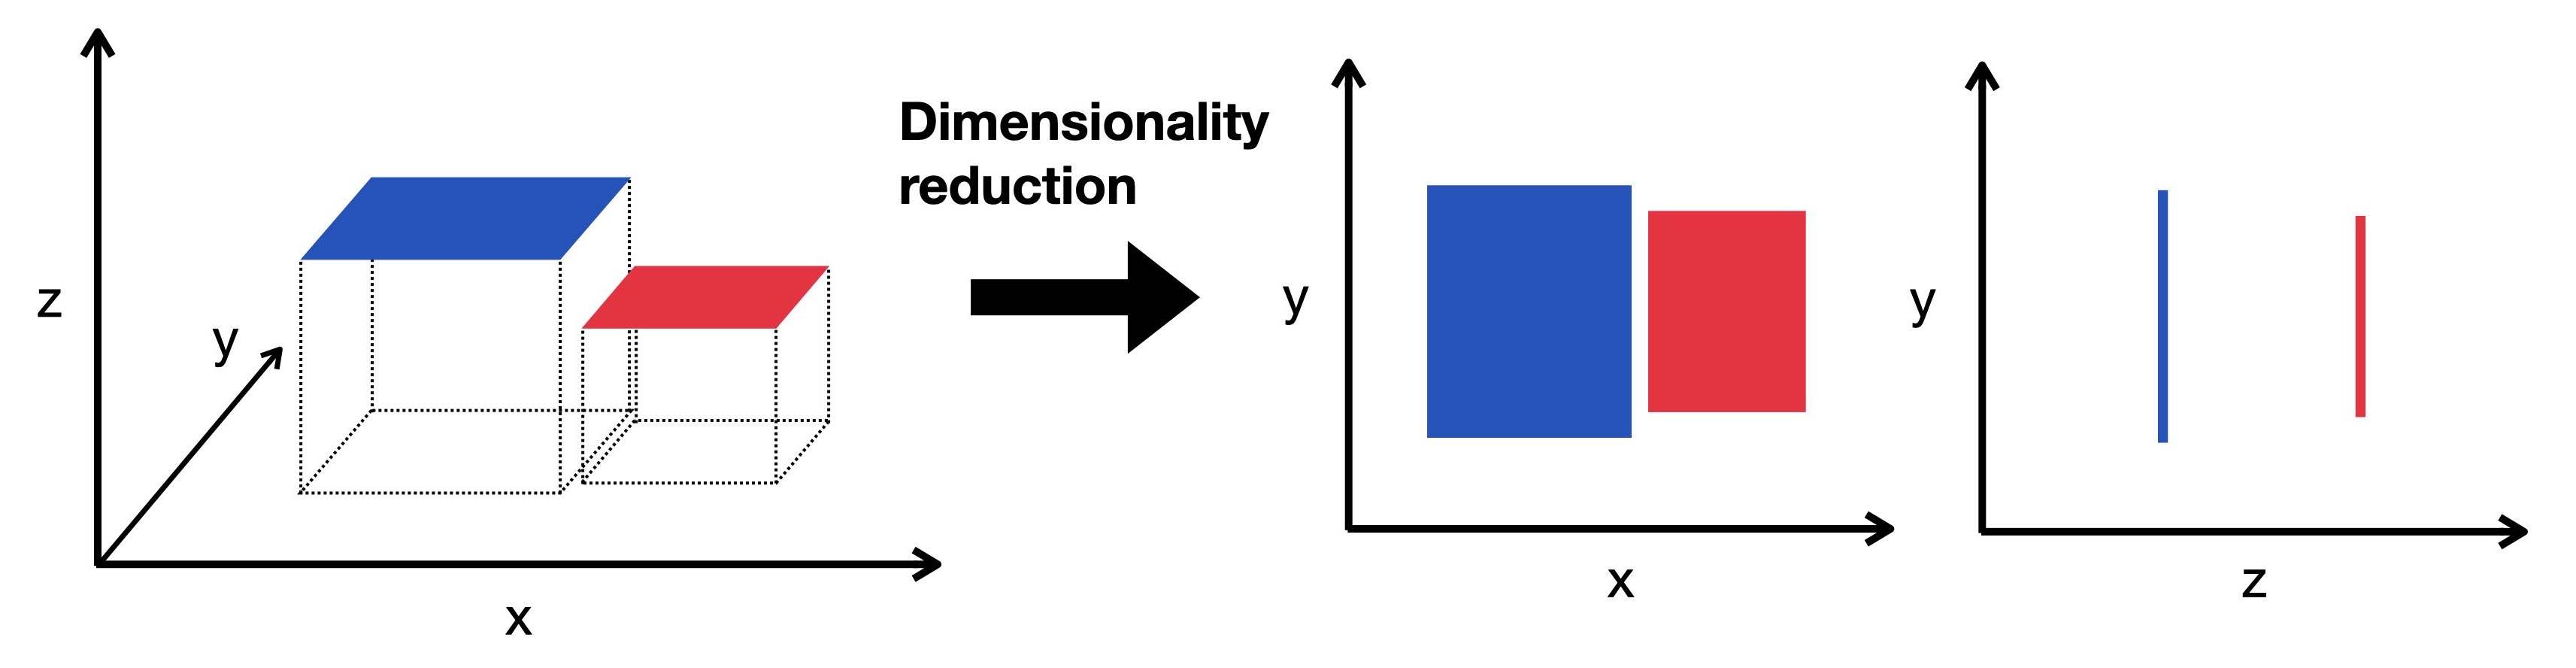
图 1:降维将高维数据嵌入(embedding)到一个低维空间中。这种低维表示在维度尽可能少的同时,仍能捕捉数据的底层结构。这里我们将一个三维物体投影到二维来加以展示。
Xiang 等人独立比较了 10 种不同降维方法的稳定性、准确性和计算成本 Xiang et al., 2021。他们建议使用 t 分布随机邻域嵌入(t-distributed stochastic neighbor embedding, t-SNE),因为它的整体表现最佳。统一流形近似与投影(uniform manifold approximation and projection, UMAP)则显示出最高的稳定性,并能最好地将原始细胞群分开。此外,还有一种值得一提的降维方法是主成分分析(principal component analysis, PCA),它至今仍被广泛使用。
一般来说,只要使用特定的初始化设置,t-SNE 和 UMAP 都非常稳健,并且在很大程度上是等价的。Kobak & Berens, 2019。
上述所有方法都在 scanpy 中实现。
现在,我们首先导入所有所需的 Python 软件包,然后加载数据集,该数据集已先后经过 质量控制(quality control, QC),归一化(normalization),以及 特征选择。
在 GPU 上运行
PCA、t-SNE、UMAP 以及近邻图(nearest-neighbor graph),是最能从 图形处理器(graphics processing unit, GPU) 加速中获益的步骤之列。在大型数据集上,rapids-singlecell 以近乎相同的 应用程序编程接口(application programming interface, API) 将它们的运行时间缩短 1–2 个数量级。
import lamindb as ln
import scanpy as sc

# Suppress verbose logging from Scanpy
sc.settings.verbosity = 0

# Set figure parameters for clean, minimal plots
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

assert ln.setup.settings.instance.slug == "theislab/sc-best-practices"

ln.track()
输出
→ connected lamindb: theislab/sc-best-practices
→ loaded Transform('liGMVGre4G5H0000'), re-started Run('ZFh04bqi...') at 2025-05-13 03:27:34 UTC
→ notebook imports: lamindb==1.3.2 scanpy==1.11.1
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="preprocessing_visualization/s4d8_feature_selection.h5ad", is_latest=True
)
adata = af.load()
我们将使用前一章保存的 scran 归一化层进行降维和可视化;该层已按 scran 估计的大小因子(size factor)缩放,并做了 log1p 变换。
为什么应当使用归一化数据来降维?
首先,基因表达数据通常严重右偏,含有大量零值和少数高表达基因。对数变换有助于将这一分布归一化,使其更对称,并减小极端值的影响,从而防止高表达基因主导任何距离计算。
其次,表达数据中的生物学信号往往遵循乘性而非加性模式。对数变换可将乘性关系转换为加性关系,而大多数降维算法(PCA、t-SNE、UMAP)正是为检测加性关系而设计的。
第三,原始表达数据的方差通常随平均表达水平而变化。对数变换可以稳定这种方差,防止高表达基因主导分析。对于零值(单细胞数据中常见的漏检(dropout)事件),通常会在对数变换之前加上一个伪计数(pseudocount)(log1p),以避免数学错误。
adata.X = adata.layers["scran_normalization"]下面开始具体分析:
PCA
在我们的数据集中,每个细胞都是一个 n_var 维向量空间中的一个向量,该空间由某组标准正交基(orthonormal basis)张成。由于 scRNA-seq 受“维度的诅咒”影响,我们知道并非所有特征对理解数据集的底层动态都重要,而且其中存在固有的冗余 Grün et al., 2014。PCA 通过对原始数据集进行正交变换(orthogonal transformation),构造出一组新的、互不相关的变量,即所谓的主成分(principal component, PC)。各主成分是原始数据集中各特征的线性组合,并按方差由大到小排序以定义该变换。在排序中,第一个主成分通常捕获最大的方差。方差最小的主成分会被舍弃,从而在不丢失信息的前提下有效降低数据的维度。
PCA 的优点是可解释性强、计算高效。然而,scRNA-seq 数据集因漏检事件而相当稀疏,从而呈现高度非线性,因此用 PCA 这种线性降维技术来做可视化并不十分合适。PCA 通常用于选出排名前 10–50 的主成分,供下游分析任务使用。
PCA 前是否应对基因进行缩放?
许多教程会在 PCA 前将每个基因转换为均值为 0、方差为 1 的 Z 分数(z-score),而本书有意不这样做。缩放会使所有基因在后续主成分中的权重相同,因此低表达基因可能贡献与高表达基因同等大小的方差。不缩放则能保留表达量级,使其可作为基因信息量的一个指标。
这两种做法孰优尚无共识。选择取决于下游分析中是否应让所有基因具有相同权重,还是应将表达量级本身视为信息;本书选择后者,以尽可能保留生物学信号。此前选择高偏差基因,已经把主成分分析限定在细胞间存在有意义变异的基因上。
这与中心化是两回事。sc.pp.pca 会在内部对数据进行中心化,因此即使此前没有缩放,PCA 仍有明确定义。
# setting highly variable as highly deviant to use scanpy 'use_highly_variable' argument in sc.pp.pca
adata.var["highly_variable"] = adata.var["highly_deviant"]
sc.pp.pca(adata, svd_solver="arpack", mask_var="highly_variable")
sc.pl.pca_scatter(adata, color="total_counts")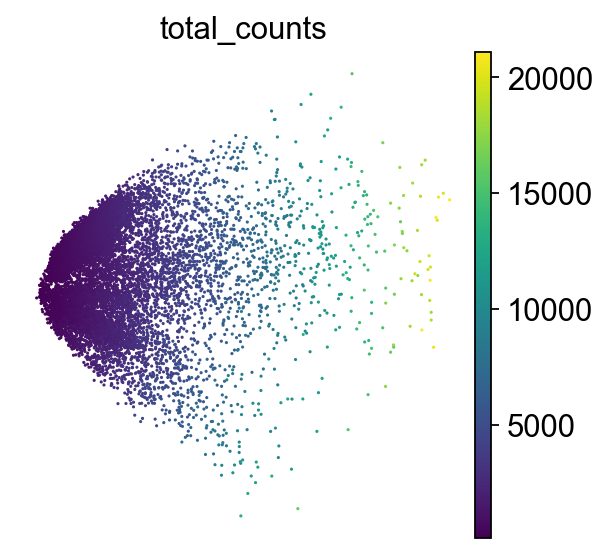
如何理解 PCA 散点图
PCA 寻找数据中细胞(或样本)取值差异最大的方向。
坐标轴:PC1 和 PC2 是第一和第二主成分(方向)。PC1 是数据最分散的方向,PC2 是与 PC1 垂直、变异性次之的方向。
点:每个点都是一个单细胞。每个点的颜色代表在该细胞中检测到的转录本总数(以 唯一分子标识符(unique molecular identifier, UMI) 计数表示)。
通过将数据投影到 PC1 和 PC2 上,我们用更少的维度就捕捉到了大部分有意义的变异。
现阶段我们并不打算直接从这张 PCA 图中解读生物学意义,但仍可观察到细胞异质性(cellular heterogeneity):表达谱相似的细胞往往聚集在一起,这可能反映了不同的细胞类型或状态。
t-SNE
t-SNE 是一种基于图的非线性降维技术,它将高维数据投影到 2D 或 3D 分量上。该方法依据数据点之间的高维欧氏距离(Euclidean distance)定义一个高斯分布(Gaussian distribution)。随后,用 Student t 分布(Student's t-distribution)在低维空间中重建该概率分布,并通过梯度下降(gradient descent)来优化低维嵌入。
sc.tl.tsne(adata, use_rep="X_pca")sc.pl.tsne(adata, color="total_counts")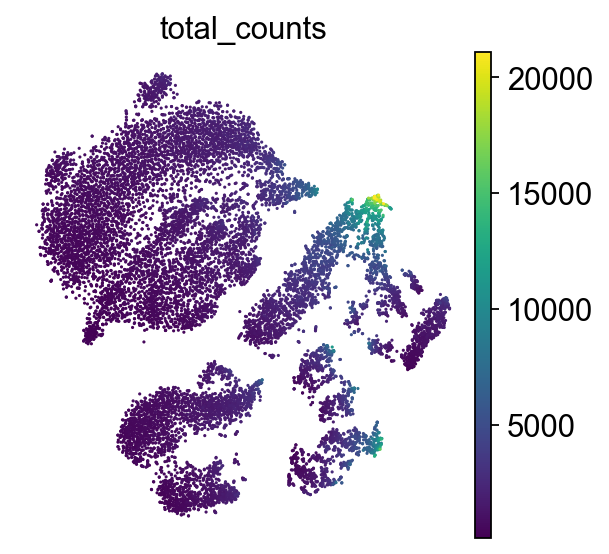
如何理解 t-SNE 图
坐标轴没有任何含义!
点:每个点代表一个单细胞。颜色代表在该细胞中检测到的转录本总数(UMI)。
这种图有助于揭示细胞亚群:紧密的聚类可能对应于不同的细胞类型或状态。与保留全局方差的 PCA 不同,t-SNE 强调局部结构。因此,最佳实践是用 PCA 来初始化 t-SNE,以降低噪声并提高嵌入的稳定性。
UMAP
UMAP 是一种基于图的非线性降维技术,原理上与 t-SNE 类似。它构建数据集的高维图表示,并优化低维图表示,使其在结构上尽可能与原始图相似。
我们首先计算 PCA,然后基于数据创建一个邻域图。
sc.pp.neighbors(adata)
sc.tl.umap(adata)
sc.pl.umap(adata, color="total_counts")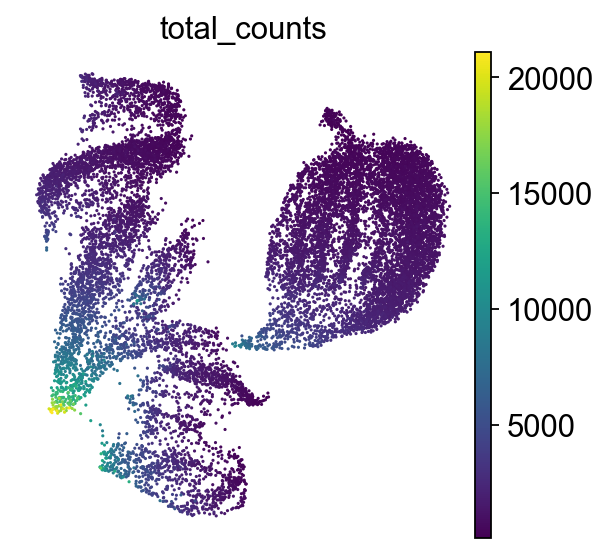
如何理解 UMAP 图
坐标轴没有任何含义!
点:每个点代表一个细胞。
颜色表示在该细胞中检测到的转录本总数(UMI)。
UMAP 既强调局部结构,也兼顾部分全局结构,相比 t-SNE 往往能更好地保留数据的整体形状,即相似的聚类彼此更接近。它基于 PCA 降维后的数据构建邻域图,然后优化一个低维布局,使其反映原始高维空间中的关系。UMAP 被广泛用于可视化单细胞数据中的细胞聚类与轨迹。
检查质量控制指标
现在,我们还可以在 PCA、t-SNE 或 UMAP 图中检查先前计算的质量控制指标,从而有可能识别出低质量细胞。
sc.pl.umap(
    adata,
    color=["total_counts", "pct_counts_mt", "scDblFinder_score", "scDblFinder_class"],
)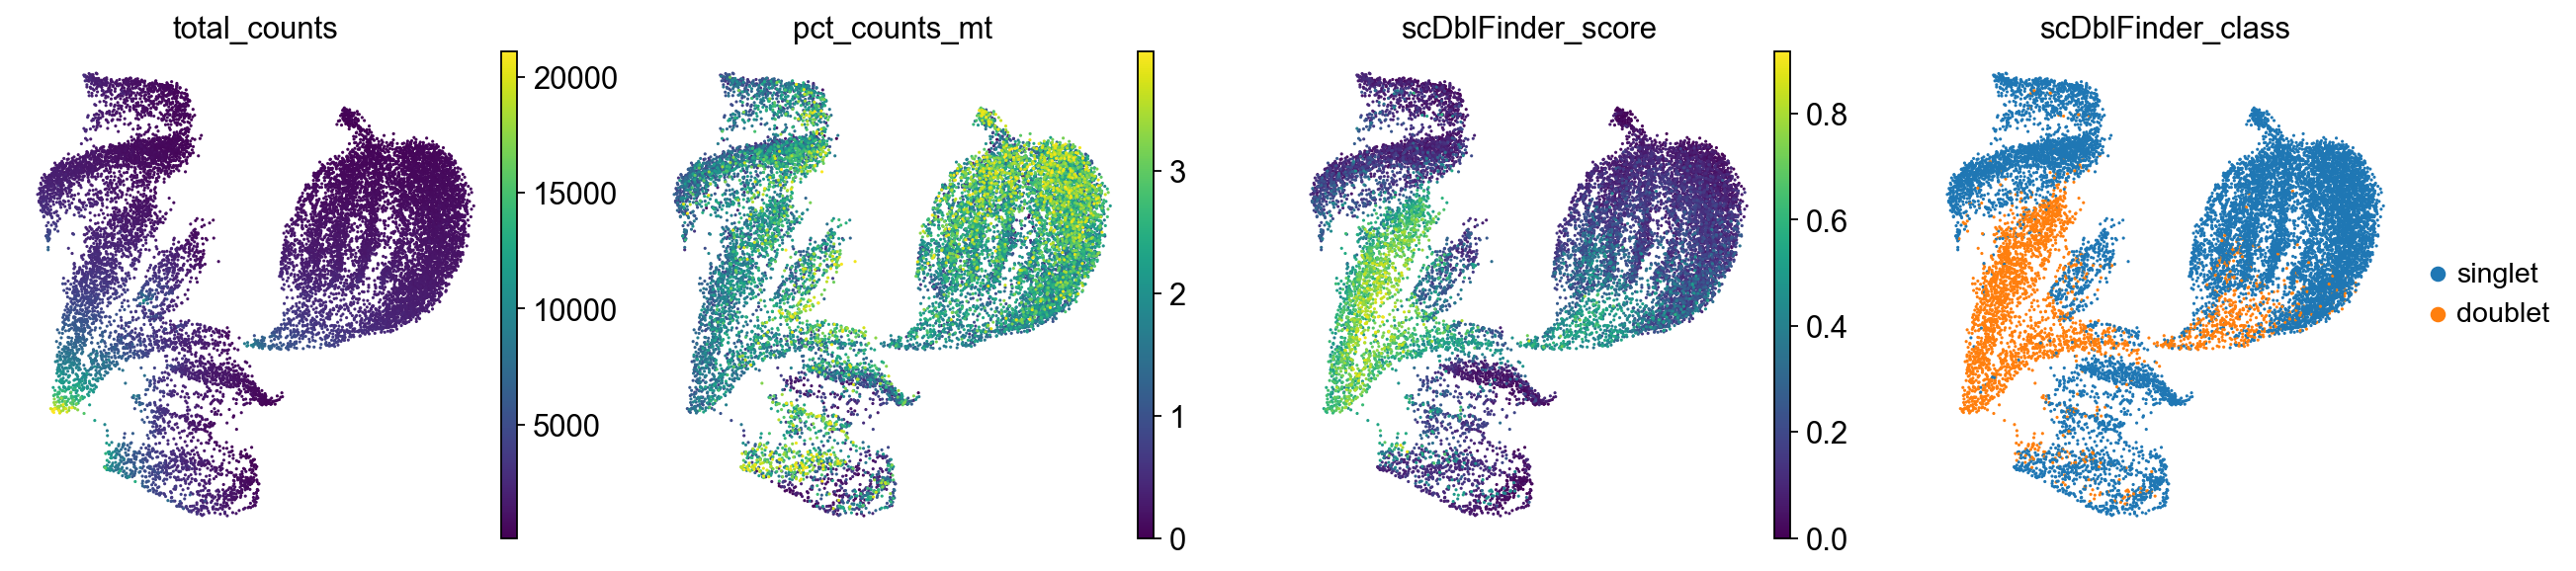
双细胞(Doublet)得分较高的细胞会被投影到 UMAP 中的同一区域。我们暂时把它们保留在数据集中,但一般来说,这提示可能需要重新审视质量控制策略,以确保尽量少地保留双细胞。
af = ln.Artifact(
    adata,
    key="preprocessing_visualization/s4d8_dimensionality_reduction.h5ad",
    description="anndata after dimensionality reduction",
).save()
af
输出
→ creating new artifact version for key='preprocessing_visualization/s4d8_dimensionality_reduction.h5ad' (storage: 's3://lamin-eu-central-1/VPwcjx3CDAa2')
! The cache path /Users/seohyon/Library/Caches/lamindb/lamin-eu-central-1/VPwcjx3CDAa2/preprocessing_visualization/s4d8_dimensionality_reduction.h5ad already exists, replacing it.
Artifact(uid='6MXF3Uy8DkG9wy720002', is_latest=True, key='preprocessing_visualization/s4d8_dimensionality_reduction.h5ad', description='anndata after dimensionality reduction', suffix='.h5ad', otype='AnnData', size=4530494307, hash='E-h2bZDOxSnEFWk1reXptw', space_id=1, storage_id=1, run_id=10, created_by_id=5, created_at=2025-05-13 03:31:03 UTC)- Bellman, R., Bellman, R. E., & Corporation, R. (1957). Dynamic Programming. Princeton University Press. https://books.google.de/books?id=rZW4ugAACAAJ
- Xiang, R., Wang, W., Yang, L., Wang, S., Xu, C., & Chen, X. (2021). A Comparison for Dimensionality Reduction Methods of Single-Cell term`RNA`-seq Data. Frontiers in Genetics, 12. 10.3389/fgene.2021.646936
- Kobak, D., & Berens, P. (2019). The art of using t-SNE for single-cell transcriptomics. Nature Communications, 10(1), 5416. 10.1038/s41467-019-13056-x
- Grün, D., Kester, L., & Van Oudenaarden, A. (2014). Validation of noise models for single-cell transcriptomics. Nature Methods, 11(6), 637–640.