🧠 关键要点
单细胞分析主要有三套生态:基于 R 的 Bioconductor 和 Seurat,以及基于 Python 的 scverse。
这些生态都得到广泛使用;scverse 则凭借可扩展性(可处理 50 万个以上细胞),以及与 Python 数据和机器学习工具的良好互操作性(interoperability)而受到青睐。
AnnData 是 scverse 的核心数据结构。它把计数矩阵(count matrix)存储在 .X(细胞 × 基因)中,并分别在 .obs 和 .var 中保存细胞与基因注释。
AnnData 的设计注重内存效率:它支持稀疏矩阵(sparse matrix)、大型文件的 backed 读取(backed reading),以及基于视图(view)的取子集(subsetting);除非显式调用 .copy(),否则无需分配新内存。
Scanpy 是构建在 AnnData 之上的主要分析框架。它提供模块化的应用程序编程接口(Application Programming Interface, API):sc.pp 用于预处理、sc.tl 用于工具函数、sc.pl 用于绘图;完整工作流涵盖基础质量控制(quality control, QC)、降维(dimensionality reduction),以及后续章节介绍的多种高级分析。
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: fundamental_data_structures_and_frameworks
channels:
  - conda-forge
  - bioconda
dependencies:
  - conda-forge::anndata=0.12.7
  - conda-forge::python=3.13.12
  - conda-forge::scanpy=1.12
  - conda-forge::ipywidgets=8.1.8
  - pip
  - pip:
      - lamindb
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
单细胞分析框架与协作联盟
如前所述,在获得 计数矩阵(count matrix)之后,便进入探索性数据分析(exploratory data analysis, EDA)阶段。早期人们常用自定义脚本分析数据,而如今已有专为此目的而建的框架。最受欢迎的三种选择是基于 R 的 Bioconductor Huber et al., 2015 和 Seurat Hao et al., 2021 生态系统,以及基于 Python 的 scverse scverse, 2022 生态系统。它们的差异不仅在于所使用的编程语言,还在于底层的数据结构和可用的专门分析工具。
Bioconductor 是一个用于严谨、可复现的生物数据分析(包括单细胞分析)的开源项目。它最大的优势在于开发者与用户体验的一致性,以及详尽且易于上手的文档。Seurat 是一个广受好评的单细胞分析 R 包,涵盖了包括多模态和空间数据在内的所有分析步骤,以其撰写精良的配套教程(vignette)和庞大的用户群而著称。这两种 R 方案在处理超大数据集(50 万个以上细胞)时都可能力不从心,这促使 Python 社区开发了 scverse 生态系统。scverse 是一个致力于基础生命科学工具的组织,最初聚焦于单细胞领域。其主要优势包括可扩展性、可拓展性,以及与 Python 数据和机器学习生态系统之间的强互操作性(interoperability)。
所有这三个生态系统都参与了许多旨在实现相关框架互操作性的工作。这一点将在 “互操作性”一章 中讨论。本书始终聚焦于针对相应问题的最佳工具,因此会混合使用上述各个生态系统。不过,所有分析的基础都将是 scverse 生态系统,原因有二:
虽然本书中我们会经常切换生态系统乃至编程语言,但始终如一地使用相同的数据结构和工具有助于读者专注于概念本身,而非实现细节。
一本专门讲述 Bioconductor 生态系统的优秀著作 已经存在。我们鼓励只想学习用 Bioconductor 做单细胞分析的读者去阅读它。
在以下各节中,我们将更详细地介绍 scverse 生态系统,并重点围绕最重要的数据结构解释其核心概念。本章介绍基础数据结构 AnnData 和 scanpy 框架(见 scverse 生态系统概览图)。在后续章节中,我们将探索更高级的库。本导言无法涵盖这些数据结构和框架的方方面面,必要时请参阅各框架相应的教程和文档。
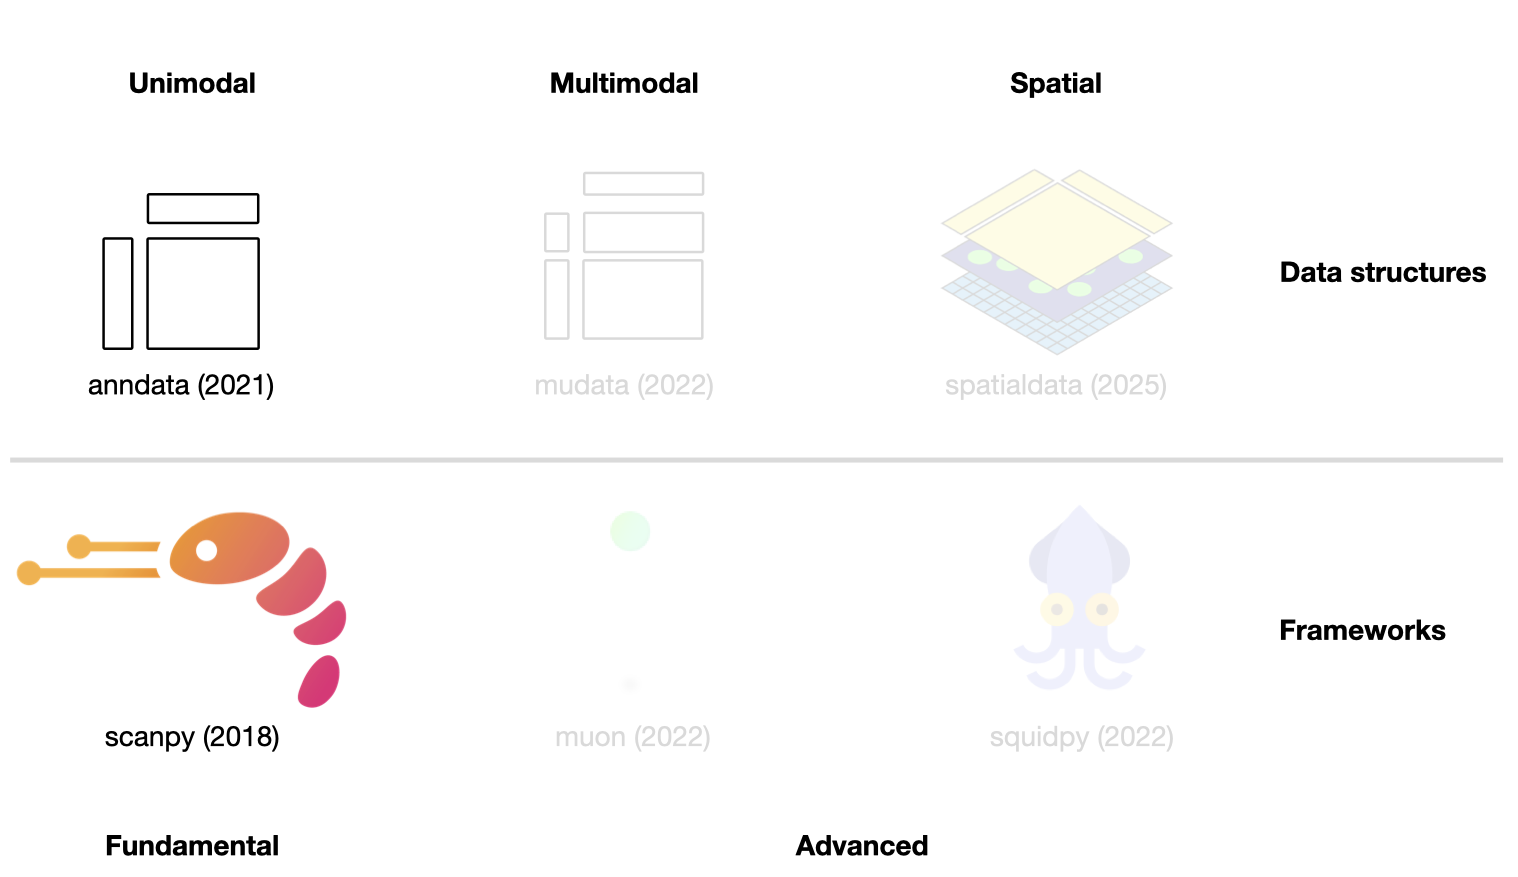
图 1:scverse 生态系统概览,突出显示本章涉及的库。括号内标注了各库被科学期刊发表的日期。各库的图标取自相应的 GitHub 页面 Virshup et al., 2021Wolf et al., 2018Bredikhin et al., 2022Palla et al., 2022Marconato et al., 2025。
使用 AnnData 存储单模态数据
如前所述,基因组数据通常会先经过比对和基因 注释,然后被汇总为一个特征矩阵。此矩阵的形状为 number_observations x number_variables。在 scRNA-seq 中,观测(observation)是细胞条形码(Cell Barcode),变量(variable)是注释过的基因。在整个分析过程中,该矩阵的观测和变量会被标注上计算得出的度量(例如质量控制(quality control, QC)指标或潜在空间(latent space)嵌入(Embedding))以及先验知识(例如来源供体或替代基因标识符)。在 scverse 生态系统中,AnnData Virshup et al., 2021 用于将数据矩阵与这些注释关联起来。为实现快速且省内存的变换,AnnData 还支持 稀疏矩阵(sparse matrix) 和部分读取。
虽然 AnnData 与 R 生态系统中的数据结构大致相似(例如,Bioconductor 的 SummarizedExperiment 或 Seurat 的对象),但 R 包使用的是转置后的特征矩阵。
AnnData 对象的核心是存储一个稀疏或稠密矩阵(dense matrix)(在 scRNA-seq 中即 Count 矩阵),该矩阵位于 X 中,维度为 obs_names x var_names;其中 obs(观测)对应细胞 Barcode,var(变量)对应基因标识符。主矩阵 X 旁边是 Pandas DataFrame obs 和 var,分别保存细胞和基因的注释。此外,AnnData 还可保存针对观测的计算结果矩阵(obsm)和针对变量的计算结果矩阵(varm),其维度分别与对应轴匹配。细胞间或基因间的图结构通常保存在 obsp 和 varp。任何无法归入其他槽位的非结构化数据,都会作为非结构化数据保存在 uns。还可以把更多形式的 X 存入 layers。其典型用例之一,是把原始的、未归一化(normalization)的 Count 数据存储在某个 counts 层中,而把归一化后的数据存储在未命名的默认层中。AnnData 主要为单模态数据(例如仅 scRNA-seq)设计。不过,AnnData 的一些扩展,例如 MuData(将在 下一章 中介绍),支持高效地存储和访问多模态数据。
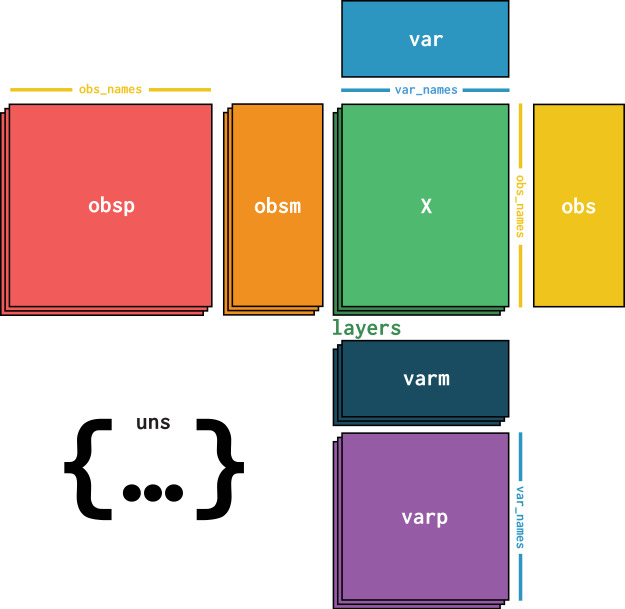
图 2:AnnData 概览。图片取自 Virshup et al., 2021。
安装
AnnData 可通过 PyPI 和 Conda 获取,使用以下任一命令即可安装。
pip install anndata
conda install -c conda-forge anndata
初始化 AnnData 对象
本节参考了 AnnData 的“入门”教程。下面创建一个简单的 AnnData 对象,其中采用 稀疏 格式的 Count 信息,例如基因表达计数。首先,我们导入所需的包。
import anndata as ad
import lamindb as ln
import numpy as np
import pandas as pd
from scipy.sparse import csr_matrix

ln.track()
输出
→ loaded Transform('zmuES9DakbmX0000', key='fundamental_data_structures_and_frameworks.ipynb'), re-started Run('pVMXOM3UaklSn6tp') at 2026-02-27 12:11:51 UTC
→ notebook imports: anndata==0.12.7 lamindb==2.0.1 numpy==2.3.5 pandas==2.3.3 scanpy==1.11.5 scipy==1.16.3
• recommendation: to identify the notebook across renames, pass the uid: ln.track("zmuES9DakbmX")
下一步,我们使用随机生成且 服从泊松分布(Poisson distribution) 的数据来初始化一个 AnnData 对象。按照不成文的惯例,会把分析中的主要 AnnData 对象命名为 adata。
counts = csr_matrix(
    np.random.default_rng().poisson(1, size=(100, 2000)), dtype=np.float32
)
adata = ad.AnnData(counts)
adata
AnnData object with n_obs × n_vars = 100 × 2000得到的 AnnData 对象有 100 个观测和 2000 个变量,相当于 100 个细胞、2000 个基因。我们传入的初始数据可以作为稀疏矩阵来访问,使用 adata.X。
adata.X<Compressed Sparse Row sparse matrix of dtype 'float32'
with 126197 stored elements and shape (100, 2000)>现在,我们分别为 obs 和 var 两个轴使用 .obs_names 和 .var_names 设置索引。
adata.obs_names = [f"Cell_{i:d}" for i in range(adata.n_obs)]
adata.var_names = [f"Gene_{i:d}" for i in range(adata.n_vars)]
print(adata.obs_names[:10])
Index(['Cell_0', 'Cell_1', 'Cell_2', 'Cell_3', 'Cell_4', 'Cell_5', 'Cell_6',
'Cell_7', 'Cell_8', 'Cell_9'],
dtype='object')
添加对齐的元数据
观测层面或变量层面
AnnData 对象的核心数据已经就位。下一步,我们在观测和变量两个层面添加元数据(metadata)。请记住,这类注释分别保存在 AnnData 对象的 .obs 和 .var 槽位中,前者用于细胞注释,后者用于基因注释。
ct = np.random.default_rng().choice(["B", "T", "Monocyte"], size=(adata.n_obs,))
adata.obs["cell_type"] = pd.Categorical(ct)  # Categoricals are preferred for efficiency
adata.obs如果现在再次查看 AnnData 对象的表示形式,就会发现它已经更新:cell_type 信息已加入 obs。
adataAnnData object with n_obs × n_vars = 100 × 2000
obs: 'cell_type'使用元数据进行子集化
我们也可以用随机生成的细胞类型对 AnnData 对象进行取子集(subsetting)。AnnData 对象的切片和掩码操作,与 Pandas DataFrame 或 R 矩阵中的数据访问方式类似。更多细节可参见 下文。
bdata = adata[adata.obs.cell_type == "B"]
bdata
View of AnnData object with n_obs × n_vars = 40 × 2000
obs: 'cell_type'观测/变量层面的矩阵
我们还可能在观测或变量层面拥有高维元数据,例如数据的 统一流形近似与投影(uniform manifold approximation and projection, UMAP) Embedding。AnnData 提供 .obsm/.varm 属性来存放这类元数据。我们用键(key)来标识插入的不同矩阵。它要求 .obsm/.varm 满足以下约束:.obsm 矩阵长度必须等于 .n_obs 和 .varm 矩阵长度必须等于 .n_vars。二者的维数可以各不相同。
让我们从一个随机生成的矩阵开始,可以把它理解为我们想要存储的数据的一个 UMAP Embedding,再加上一些随机的基因级元数据。
adata.obsm["X_umap"] = np.random.default_rng().normal(0, 1, size=(adata.n_obs, 2))
adata.varm["gene_stuff"] = np.random.default_rng().normal(0, 1, size=(adata.n_vars, 5))
adata.obsm
AxisArrays with keys: X_umapAnnData 的表示形式再次得到更新。
adataAnnData object with n_obs × n_vars = 100 × 2000
obs: 'cell_type'
obsm: 'X_umap'
varm: 'gene_stuff'关于 .obsm/.varm:
这种“类数组”的元数据可以来自 Pandas DataFrame、SciPy 稀疏矩阵或 NumPy 稠密数组。
使用 scanpy 时,这些矩阵的值(列)不易直接绘图,而
.obs中的项目则很容易绘制在 UMAP 图等可视化中。
非结构化元数据
如上所述,AnnData 有 .uns,可存储任意非结构化元数据,例如列表、字典或分析数据时有用的其他一般信息。请仅将无法高效存入其他槽位的数据放在这里。
adata.uns["random"] = [1, 2, 3]
adata.uns
OrderedDict([('random', [1, 2, 3])])层
最后,我们的原始核心数据可能有不同的形式,也许一种是归一化的、一种不是。它们可以存放在 AnnData 的不同层中。例如,我们对原始数据做对数变换,并将其存储在一个层里。
adata.layers["log_transformed"] = np.log1p(adata.X)
adata
AnnData object with n_obs × n_vars = 100 × 2000
obs: 'cell_type'
uns: 'random'
obsm: 'X_umap'
varm: 'gene_stuff'
layers: 'log_transformed'原始矩阵 X 未经修改,仍可访问。我们可以比较原始的 X 与新层来验证这一点(.nnz 返回布尔矩阵中非零元素的数量)。
(adata.X != adata.layers["log_transformed"]).nnz == 0False转换为 DataFrame
可以从其中某一层得到一个 Pandas DataFrame。
with pd.option_context("display.max_columns", 10):
display(adata.to_df(layer="log_transformed"))AnnData 对象的读写
AnnData 对象可以保存到磁盘上的分层数组存储中,例如 层次化数据格式第 5 版(Hierarchical Data Format version 5, HDF5) 或 Zarr,使磁盘存储与内存表示保持相似的结构。AnnData 自带基于 HDF5 的持久化文件格式:h5ad。如果包含少数几个类别的字符串列尚未转换为分类(categorical)类型,AnnData 会自动将其转换为分类类型。现在,我们将把 AnnData 对象保存为 h5ad 格式。
adata.write("my_results.h5ad", compression="gzip")……然后再将其读回。
adata_new = ad.read_h5ad("my_results.h5ad")
adata_new
AnnData object with n_obs × n_vars = 100 × 2000
obs: 'cell_type'
uns: 'random'
obsm: 'X_umap'
varm: 'gene_stuff'
layers: 'log_transformed'高效的数据访问
视图与副本
再来看一个元数据用例。设想这些观测来自某些仪器:在一项持续多年的研究中,仪器测量了取自不同地点、不同受试者样本的 10 项读出指标。我们通常会以某种格式获得这些信息,再将其存入 DataFrame:
obs_meta = pd.DataFrame(
    {
        "time_yr": np.random.default_rng().choice([0, 2, 4, 8], adata.n_obs),
        "subject_id": np.random.default_rng().choice(
            ["subject 1", "subject 2", "subject 4", "subject 8"], adata.n_obs
        ),
        "instrument_type": np.random.default_rng().choice(
            ["type a", "type b"], adata.n_obs
        ),
        "site": np.random.default_rng().choice(["site x", "site y"], adata.n_obs),
    },
    index=adata.obs.index,  # these are the same IDs of observations as above!
)
我们就是这样把读出数据与元数据连接起来的。当然,下面这次调用的第一个参数 X 也可以直接是 DataFrame。这样会得到一个能够跟踪全部信息的统一数据容器。
adata = ad.AnnData(adata.X, obs=obs_meta, var=adata.var)
adata
AnnData object with n_obs × n_vars = 100 × 2000
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'对联合数据矩阵进行子集化可能很重要,比如聚焦于变量或观测的某个子集,或为机器学习模型划分训练集/测试集。
与 NumPy 数组类似,AnnData 对象既可以持有实际数据,也可以引用另一个 AnnData 对象。在后一种情况下,它们被称为“视图(view)”。对 AnnData 对象进行子集化总是返回视图,这有两个好处:
不会分配新的内存。
可以修改底层 AnnData 对象。
您可以通过在视图上调用 .copy() 来从视图中获取一个实际的 AnnData 对象。通常并不需要这样做,因为对视图元素的任何修改(在视图的某个属性上调用 .[])在内部都会调用 .copy(),并使该视图成为持有实际数据的 AnnData 对象。见下例。
adataAnnData object with n_obs × n_vars = 100 × 2000
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'对 AnnData 进行索引时,会假定传给 [] 的整数参数其行为类似于 pandas 中的 .iloc,而字符串参数的行为则类似于 .loc。AnnData 始终假定索引是字符串。
adata_view = adata[:5, ["Gene_1", "Gene_3"]]
adata_view
View of AnnData object with n_obs × n_vars = 5 × 2
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'这是一个视图!可以通过再次查看 AnnData 对象来验证这一点。
adataAnnData object with n_obs × n_vars = 100 × 2000
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'AnnData 对象的维度没有改变,它仍然包含相同的数据。如果我们想要一个把数据保存在内存中的 AnnData,就必须对它调用 .copy()。
adata_subset = adata[:5, ["Gene_1", "Gene_3"]].copy()
adata_subset
AnnData object with n_obs × n_vars = 5 × 2
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'对于视图,我们也可以设置某一列的前三个元素。
print(adata[:3, "Gene_1"].X.toarray().tolist())
adata[:3, "Gene_1"].X = [0, 0, 0]
print(adata[:3, "Gene_1"].X.toarray().tolist())
[[1.0], [1.0], [2.0]]
[[0.0], [0.0], [0.0]]
如果尝试访问 AnnData 视图的一部分,其内容会被自动复制,并生成一个实际存储数据的对象。
adata_subset = adata[:3, ["Gene_1", "Gene_2"]]
adata_subset
View of AnnData object with n_obs × n_vars = 3 × 2
obs: 'time_yr', 'subject_id', 'instrument_type', 'site'adata_subset.obs["foo"] = range(3)现在 adata_subset 存储的是实际数据,不再只是对 adata 的引用。
adata_subsetAnnData object with n_obs × n_vars = 3 × 2
obs: 'time_yr', 'subject_id', 'instrument_type', 'site', 'foo'显然,你可以使用 pandas 的全部功能,用序列或布尔索引来切片。
adata[adata.obs.time_yr.isin([2, 4])].obs.head()大型数据的部分读取
如果单个 h5ad 文件很大,可以使用 磁盘后端映射模式(backed mode)将其部分读入内存。
adata = ad.read_h5ad("my_results.h5ad", backed="r")adata.isbackedTrue如果这样做,你需要记住:此时 AnnData 对象与所读取的文件之间保持着一个打开的连接。
adata.filenamePosixPath('my_results.h5ad')由于以只读模式使用,不会损坏任何数据。为继续本教程,我们仍需显式地将其关闭。
adata.file.close()使用 scanpy 进行单模态数据分析
既然我们已经理解了单模态单细胞分析的基础数据结构,那么问题仍然是:我们究竟该如何分析所存储的数据?在 scverse 生态系统中,有多种工具可用于分析特定的组学数据。例如,scanpy Wolf et al., 2018 为以 RNA-seq 为主的通用分析提供工具,squidpy Palla et al., 2022 专注于空间转录组学,而 scirpy Sturm et al., 2020 则提供分析 T 细胞受体(T-cell receptor, TCR)和 B 细胞受体(B-cell receptor, BCR)数据的工具。尽管面向各种数据模态的 scverse 扩展有很多,但它们通常都会在一定程度上使用 scanpy 的某些预处理和可视化功能。
更具体地说,scanpy 是构建在 AnnData 之上的 Python 包,用于便捷分析单细胞基因表达数据。通过 scanpy 可以使用多种方法,包括预处理、Embedding、可视化、聚类(clustering)、差异基因表达(differential gene expression, DGE) 检验、伪时间(pseudotime)和轨迹推断(trajectory inference),以及基因调控网络(gene regulatory network, GRN)模拟。scanpy 基于 Python 数据科学与机器学习库的高效实现,可扩展到数百万个细胞。一般而言,遵循最佳实践的单细胞数据分析是一个交互式过程,许多决策和分析步骤取决于前序步骤的结果,以及实验合作者可能提供的信息。诸如 scflow Khozoie et al., 2021 等分析流程会将一些下游分析步骤完全自动化。这些流程必须作出假设和简化,因而未必能得到最稳健的分析结果。因此,scanpy 专为交互式分析而设计,例如可配合 Jupyter Notebook 使用 Jupyter, 2022。
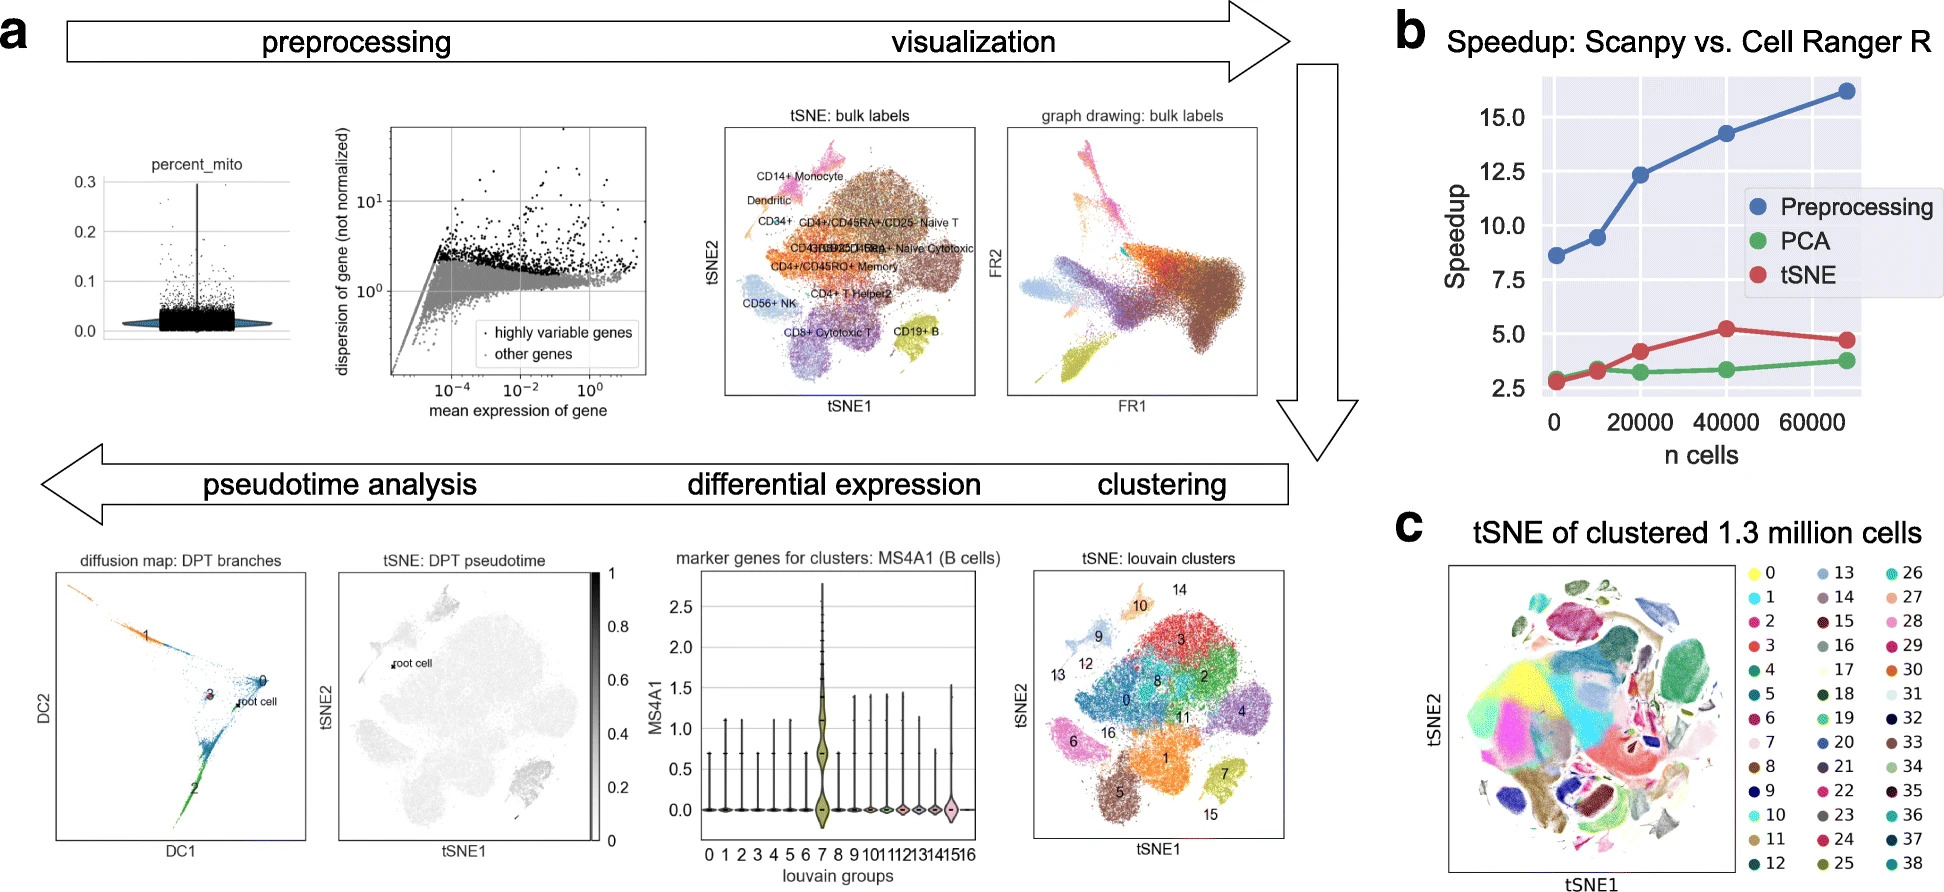
图 3:Scanpy 概览。图片取自 Wolf et al., 2018。
安装
Scanpy 可通过 PyPI 和 Conda 获取,使用以下任一命令即可安装。
pip install scanpy
conda install -c conda-forge scanpy
Scanpy API 设计
Scanpy 框架的设计方式是将属于同一步骤的功能归入相应的模块。例如,所有预处理函数都位于 scanpy.preprocessing 模块中;所有非预处理的数据矩阵变换都位于 scanpy.tools 中;所有可视化都位于 scanpy.plot 中。通常先通过 import scanpy as sc 导入 scanpy,再用相应缩写访问这些模块:scanpy.pp 用于预处理,scanpy.tl 用于工具,scanpy.pl 用于绘图。读写数据的模块可直接访问;此外,还有一个包含多种数据集的模块,即 scanpy.datasets。所有函数及其参数和可能的示例图,都记录在 scanpy 应用程序编程接口(application programming interface, API) 文档中 scanpy, 2022。
请注意,本教程只涵盖了 scanpy 特性和选项中的一小部分。我们强烈建议读者查阅 scanpy 文档 以了解更多细节。
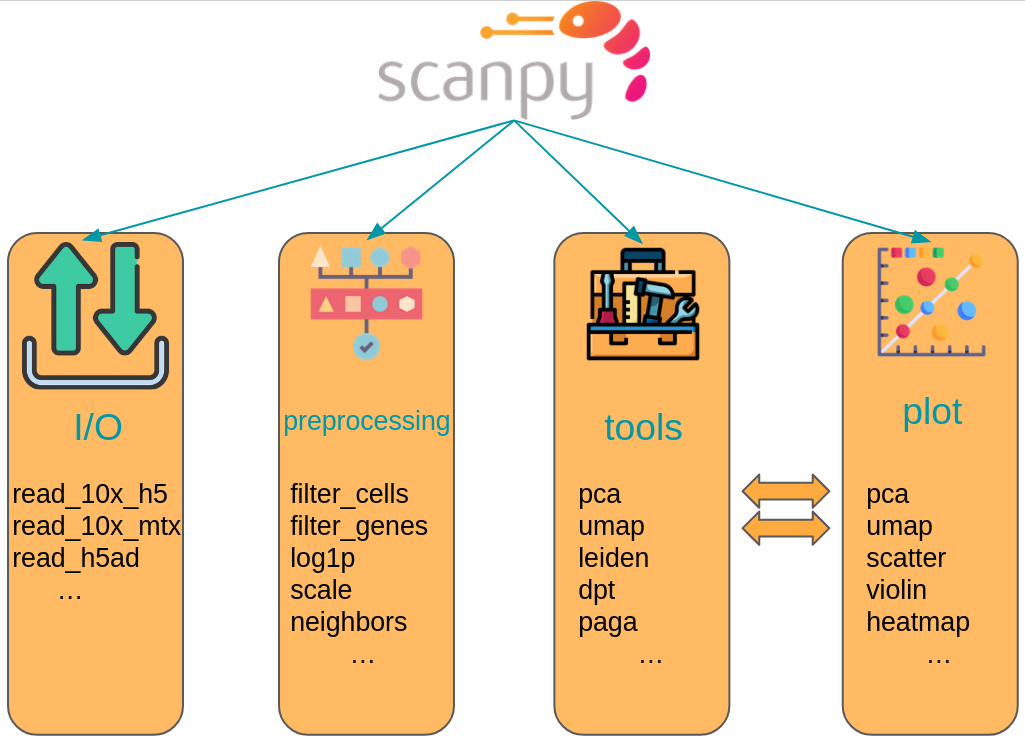
图 4:Scanpy API 概览。该 API 分为数据集、预处理(pp)、工具(tl)以及对应的绘图(pl)函数。
Scanpy 示例
在下面的单元格中,我们将简要演示使用 scanpy 进行分析的工作流程。我们特意不做完整分析,因为具体的分析步骤会在相应章节中介绍。
作为第一步,我们导入 scanpy 并为接下来的快速 scanpy 演示设定默认值。我们使用 scanpy 的 settings 对象来设置 Matplotlib 的绘图默认值(应用于 scanpy 的所有图),最后打印 scanpy 的头部信息(header)。该头部信息包含当前环境中所有相关 Python 包的版本,包括 scanpy 和 AnnData。在向 scverse 团队报告错误时,以及出于可复现性的考虑,这一输出尤其有用。
import scanpy as sc

sc.settings.set_figure_params(dpi=80, facecolor="white")
sc.logging.print_header()
输出
这里选用的数据集包含来自一名健康供体的 2700 个外周血单个核细胞(peripheral blood mononuclear cell, PBMC),并使用 Illumina NextSeq 500 完成测序。我们可以从 lamindb 加载该数据集;另一个获取方式是 scanpy.datasets.pbmc3k()。
adata = ln.Artifact.get(
    key="introduction/fundamental_data_structures_and_frameworks.h5ad", is_latest=True
).load()
adata
AnnData object with n_obs × n_vars = 2700 × 32738
var: 'gene_ids'返回的 AnnData 对象有 2700 个细胞、32738 个基因。其中 var 槽位还包含基因 ID。
adata.var如上所述,scanpy 的所有分析函数都可通过以下入口调用:sc.[pp, tl, pl]。作为了解数据的第一步,我们用 scanpy 展示在每个单细胞中、在所有细胞范围内贡献了最高 Count 比例的那些基因。我们只需调用 scanpy.pl.highest_expr_genes 函数,传入 AnnData 对象(它在几乎所有情况下都是任何 scanpy 函数的第一个参数),并指定我们希望展示表达量最高的前 20 个基因。
sc.pl.highest_expr_genes(adata, n_top=20)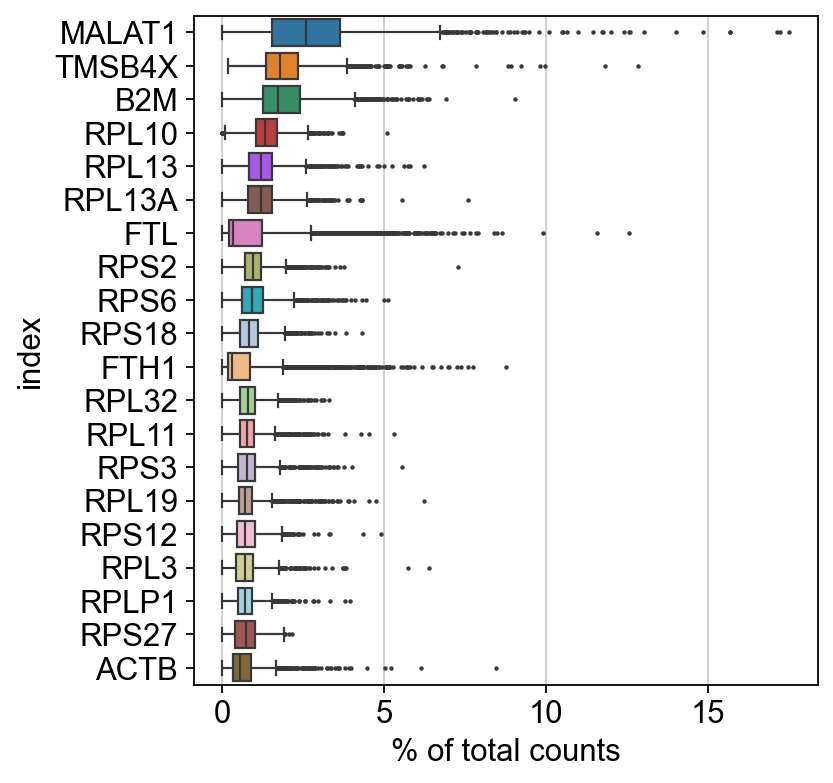
显然,MALAT1 是表达量最高的基因,在 poly-A 捕获的 scRNA-seq 数据中经常被检测到,且与具体方案无关。该基因已被证明与细胞健康呈负相关。死亡或濒死的细胞尤其会高表达 MALAT1。
现在,我们使用 scanpy 的预处理模块进行粗略质控:过滤掉检出基因少于 200 个的细胞,以及仅在少于 3 个细胞中检出的基因。
sc.pp.filter_cells(adata, min_genes=200)
sc.pp.filter_genes(adata, min_cells=3)
单细胞 RNA-seq 分析中的一个常见步骤是使用 主成分分析(principal component analysis, PCA) 等方法降维(dimensionality reduction),以揭示主要变异轴,同时降低数据噪声。scanpy 将 PCA 同时作为 preprocessing 或 tools 函数提供。二者是等价的。在这里,我们使用 tools 中的版本,没有特别的原因。
sc.tl.pca(adata, svd_solver="arpack")对应的绘图函数允许把基因传给 color 参数;相应数值会自动从 AnnData 对象中提取。
sc.pl.pca(adata, color="CST3")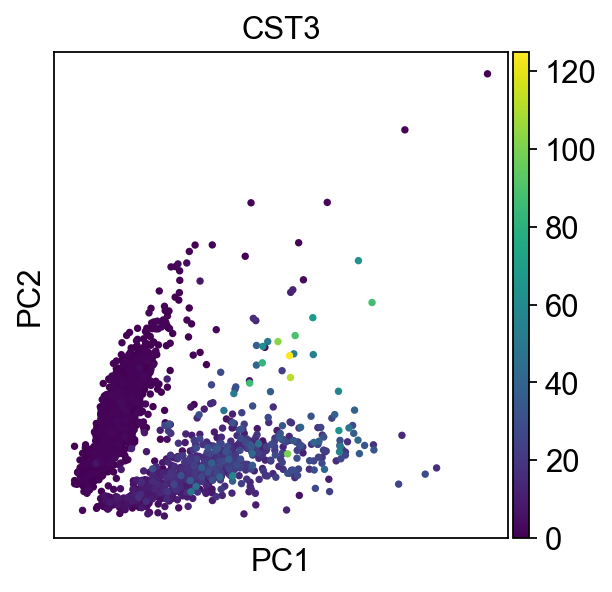
任何高级 Embedding 和下游计算的基础步骤,都是利用数据矩阵的 PCA 表示来计算近邻图(nearest-neighbor graph)。需要邻域图的其他工具会自动使用它,例如 UMAP 计算。
sc.pp.neighbors(adata, n_neighbors=10, n_pcs=40)我们现在使用计算好的邻域图,用 UMAP 来嵌入这些细胞——这是众多高级降维 算法 之一,已在 scanpy 中实现。
sc.tl.umap(adata)sc.pl.umap(adata, color=["CST3", "NKG7", "PPBP"])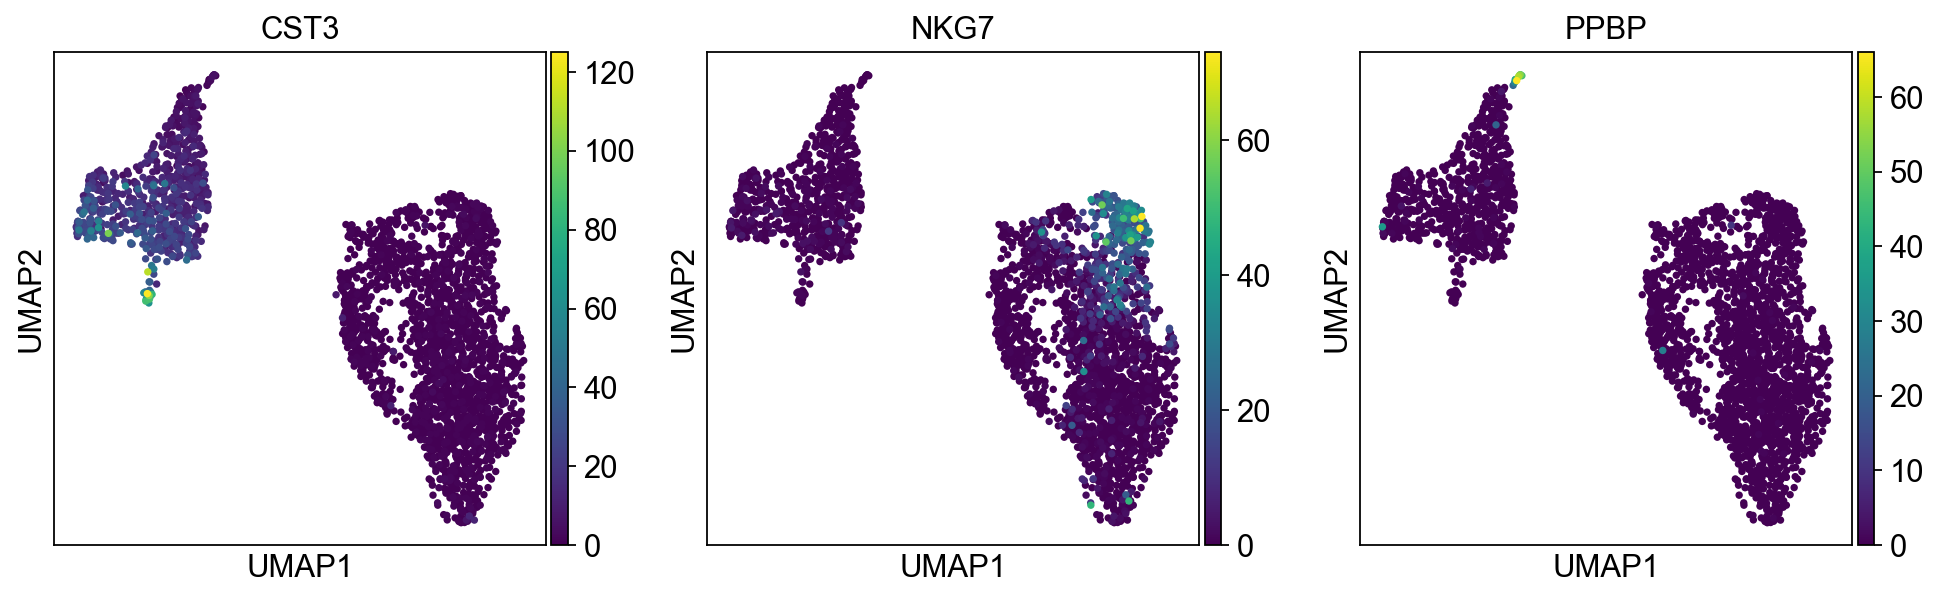
Scanpy 的文档也提供了 教程,适合需要复习 scanpy 或初次接触 scanpy 的读者。视频教程可前往 scverse YouTube 频道观看。
选择题
- Huber, W., Carey, V. J., Gentleman, R., Anders, S., Carlson, M., Carvalho, B. S., Bravo, H. C., Davis, S., Gatto, L., Girke, T., Gottardo, R., Hahne, F., Hansen, K. D., Irizarry, R. A., Lawrence, M., Love, M. I., MacDonald, J., Obenchain, V., Oleś, A. K., … Morgan, M. (2015). Orchestrating high-throughput genomic analysis with Bioconductor. Nature Methods, 12(2), 115–121. 10.1038/nmeth.3252
- Hao, Y., Hao, S., Andersen-Nissen, E., III, W. M. M., Zheng, S., Butler, A., Lee, M. J., Wilk, A. J., Darby, C., Zagar, M., Hoffman, P., Stoeckius, M., Papalexi, E., Mimitou, E. P., Jain, J., Srivastava, A., Stuart, T., Fleming, L. B., Yeung, B., … Satija, R. (2021). Integrated analysis of multimodal single-cell data. Cell. 10.1016/j.cell.2021.04.048
- scverse. (2022). scverse. https://scverse.org
- Virshup, I., Rybakov, S., Theis, F. J., Angerer, P., & Wolf, F. A. (2021). anndata: Annotated data. bioRxiv. 10.1101/2021.12.16.473007
- Wolf, F. A., Angerer, P., & Theis, F. J. (2018). SCANPY: large-scale single-cell gene expression data analysis. Genome Biology, 19(1), 15. 10.1186/s13059-017-1382-0
- Bredikhin, D., Kats, I., & Stegle, O. (2022). MUON: multimodal omics analysis framework. Genome Biology, 23(1), 42. 10.1186/s13059-021-02577-8
- Palla, G., Spitzer, H., Klein, M., Fischer, D., Schaar, A. C., Kuemmerle, L. B., Rybakov, S., Ibarra, I. L., Holmberg, O., Virshup, I., Lotfollahi, M., Richter, S., & Theis, F. J. (2022). Squidpy: a scalable framework for spatial omics analysis. Nature Methods, 19(2), 171–178. 10.1038/s41592-021-01358-2
- Marconato, L., Palla, G., Yamauchi, K. A., Virshup, I., Heidari, E., Treis, T., Vierdag, W.-M., Toth, M., Stockhaus, S., Shrestha, R. B., Rombaut, B., Pollaris, L., Lehner, L., Vöhringer, H., Kats, I., Saeys, Y., Saka, S. K., Huber, W., Gerstung, M., … Stegle, O. (2025). SpatialData: an open and universal data framework for spatial omics. Nature Methods, 22(1), 58–62. 10.1038/s41592-024-02212-x
- Sturm, G., Szabo, T., Fotakis, G., Haider, M., Rieder, D., Trajanoski, Z., & Finotello, F. (2020). Scirpy: a Scanpy extension for analyzing single-cell T-cell receptor-sequencing data. Bioinformatics, 36(18), 4817–4818. 10.1093/bioinformatics/btaa611
- Khozoie, C., Fancy, N., Marjaneh, M. M., Murphy, A. E., Matthews, P. M., & Skene, N. (2021). scFlow: A Scalable and Reproducible Analysis Pipeline for Single-Cell term`RNA` Sequencing Data. bioRxiv. 10.1101/2021.08.16.456499
- Jupyter, P. (2022). Jupyter. https://jupyter.org/
- scverse scanpy. (2022). Scanpy API. https://scanpy.readthedocs.io/en/stable/api.html#