🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: preprocessing
channels:
  - bioconda
  - conda-forge
dependencies:
  - conda-forge::ipywidgets=8.1.5
  - conda-forge::leidenalg=0.10.2
  - conda-forge::numba=0.61.0
  - conda-forge::python=3.12.9
  - conda-forge::r-base=4.3.3
  - conda-forge::r-soupx=1.6.2
  - conda-forge::r-sctransform=0.4.1
  - conda-forge::r-glmpca=0.2.0
  - conda-forge::rpy2=3.5.11
  - conda-forge::scanpy=1.11.1
  - conda-forge::session-info=1.0.0
  - bioconda::anndata2ri=1.3.2
  - bioconda::bioconductor-scdblfinder=1.16.0
  - bioconda::bioconductor-scry=1.14.0
  - bioconda::bioconductor-scran=1.30.0
  - bioconda::bioconductor-glmgampoi=1.14.0
  - pip
  - pip:
      - lamindb[bionty,jupyter]
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
分析单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq) 数据时,需要牢记两个基本特性。首先,scRNA-seq 数据存在 漏检(dropout),即由于 信使 RNA(messenger RNA, mRNA) 捕获效率有限,数据中会出现过多零值。其次,数据校正和质量控制(quality control, QC)的空间可能有限,因为数据中的技术因素可能与生物学信号混杂。因此,必须选择适合数据特征的预处理方法,既不过度校正,也不移除真实的生物学效应。
用于分析单细胞 RNA 测序数据的一整套工具正在快速发展,这得益于新的 测序 技术不断涌现,捕获的细胞、检测到的基因以及识别出的细胞群体数量也持续增长 Zappia & Theis, 2021。其中许多工具专用于预处理,旨在处理以下分析步骤:
双细胞(Doublet) 检测
质量控制
归一化(normalization)
特征选择(feature selection)
降维(dimensionality reduction)。
在整个过程中所选择的算法会严重影响下游的数据分析与解释。例如,如果在质量控制时过滤掉过多细胞,你可能会丢失稀有的细胞亚群,错过对有趣细胞生物学的洞见;反之,如果过于宽松,又会在预处理流程中未排除低质量细胞的情况下,使细胞注释变得困难。在许多情况下,你之后仍需重新评估预处理分析,并调整诸如过滤策略之类的设置。
本笔记本的起点是已按以下章节所述流程处理过的单细胞数据:原始数据处理章节。数据经过比对以获得分子计数矩阵(count matrix),即所谓的计数矩阵,或读段(Read)计数(读段矩阵)。计数矩阵与读段矩阵的区别取决于 唯一分子标识符(unique molecular identifier, UMI) 是否被纳入单细胞文库(library)构建方案中。读段矩阵和计数矩阵的维度为 number of barcodes x number of transcripts。需要注意的是,这里使用“条形码(Barcode)”而非“细胞”一词,因为一个条形码可能错误地标记了多个细胞(双细胞),也可能没有标记任何细胞(空液滴/空孔)。我们将在“双细胞检测”一节中对此作更详细的说明。
环境配置与数据
我们使用了一个 10x Multiome 数据集,它是为 2021 年 NeurIPS 会议上的一项单细胞数据整合挑战赛而生成的 Luecken et al., 2021。该数据集采集了来自 12 位健康人类供体骨髓单个核细胞的单细胞多组学(multi-omics)数据,样本在四个不同地点测得,从而获得嵌套式的 批次效应(batch effect)——这是一种分层的技术变异形式,其中批次(如不同地点)嵌套在生物学单元(如各个供体)之内,从而能够更细致地评估技术变异与生物学变异。在本教程中,我们将使用上述数据集中的一个批次,即供体 8 的样本 4,来展示 scRNA-seq 数据预处理的最佳实践。
虽然单细胞计数矩阵的预处理通常是一个线性流程,各项质量控制和预处理步骤也有清晰的顺序,但为了讲解某些具体步骤,我们有时需要提前使用后续小节才会介绍的方法。例如,背景游离 RNA(ambient RNA) 校正会用到聚类(clustering),而相关内容将在后文 聚类 章节中再介绍。
第一步,导入所需的软件包。
import lamindb as ln
import numpy as np
import scanpy as sc
import seaborn as sns
from rpy2.robjects import numpy2ri
from rpy2.robjects.conversion import localconverter
from scipy.sparse import csc_matrix
from scipy.stats import median_abs_deviation

# Suppress verbose logging from Scanpy
sc.settings.verbosity = 0

# Set figure parameters for clean, minimal plots
sc.settings.set_figure_params(dpi=80, facecolor="white", frameon=False)

assert ln.setup.settings.instance.slug == "theislab/sc-best-practices"

ln.track()
输出
→ loaded Transform('FATGTTa0bL500000'), re-started Run('ek9F27dk...') at 2025-11-10 02:21:08 UTC
→ notebook imports: lamindb==1.3.2 numpy==2.1.3 rpy2==3.5.11 scanpy==1.11.1 scipy==1.14.1 seaborn==0.13.2
我们可以使用以下工具加载该数据集:lamindb。
af = ln.Artifact.connect("theislab/sc-best-practices").get(
    key="preprocessing_visualization/quality_control_adata.h5ad", is_latest=True
)
adata = af.load()
adata
/Users/seohyon/miniconda3/envs/preprocessing/lib/python3.12/site-packages/anndata/_core/anndata.py:1758: UserWarning: Variable names are not unique. To make them unique, call `.var_names_make_unique`.
utils.warn_names_duplicates("var")
AnnData object with n_obs × n_vars = 16934 × 36601
    var: 'gene_ids', 'feature_types', 'genome', 'interval'
读取数据后,scanpy 会显示一条警告,提示并非所有变量名都是唯一的。这表明有些变量(这里指基因)出现了不止一次,可能导致下游分析任务出错或行为异常。我们执行其建议的函数 var_names_make_unique();该函数会在每个重复的索引元素后追加数字字符串,从而使变量名变得唯一,例如“1”“2”等。
adata.var_names_make_unique()
adata
AnnData object with n_obs × n_vars = 16934 × 36601
var: 'gene_ids', 'feature_types', 'genome', 'interval'数据集的形状为 n_obs 16,934 × n_vars 36,601,即 barcodes x number of transcripts。我们还进一步查看了 .var 中的更多信息,包括 gene_ids(Ensembl ID)、feature_types 和 genome。
后续大多数分析都假定数据集中的每项观测代表一个完整单细胞。然而,低质量细胞、游离 RNA(cell-free RNA) 污染或双细胞可能破坏这一假设。本教程将介绍如何校正或移除这些异常因素,以获得高质量数据集。
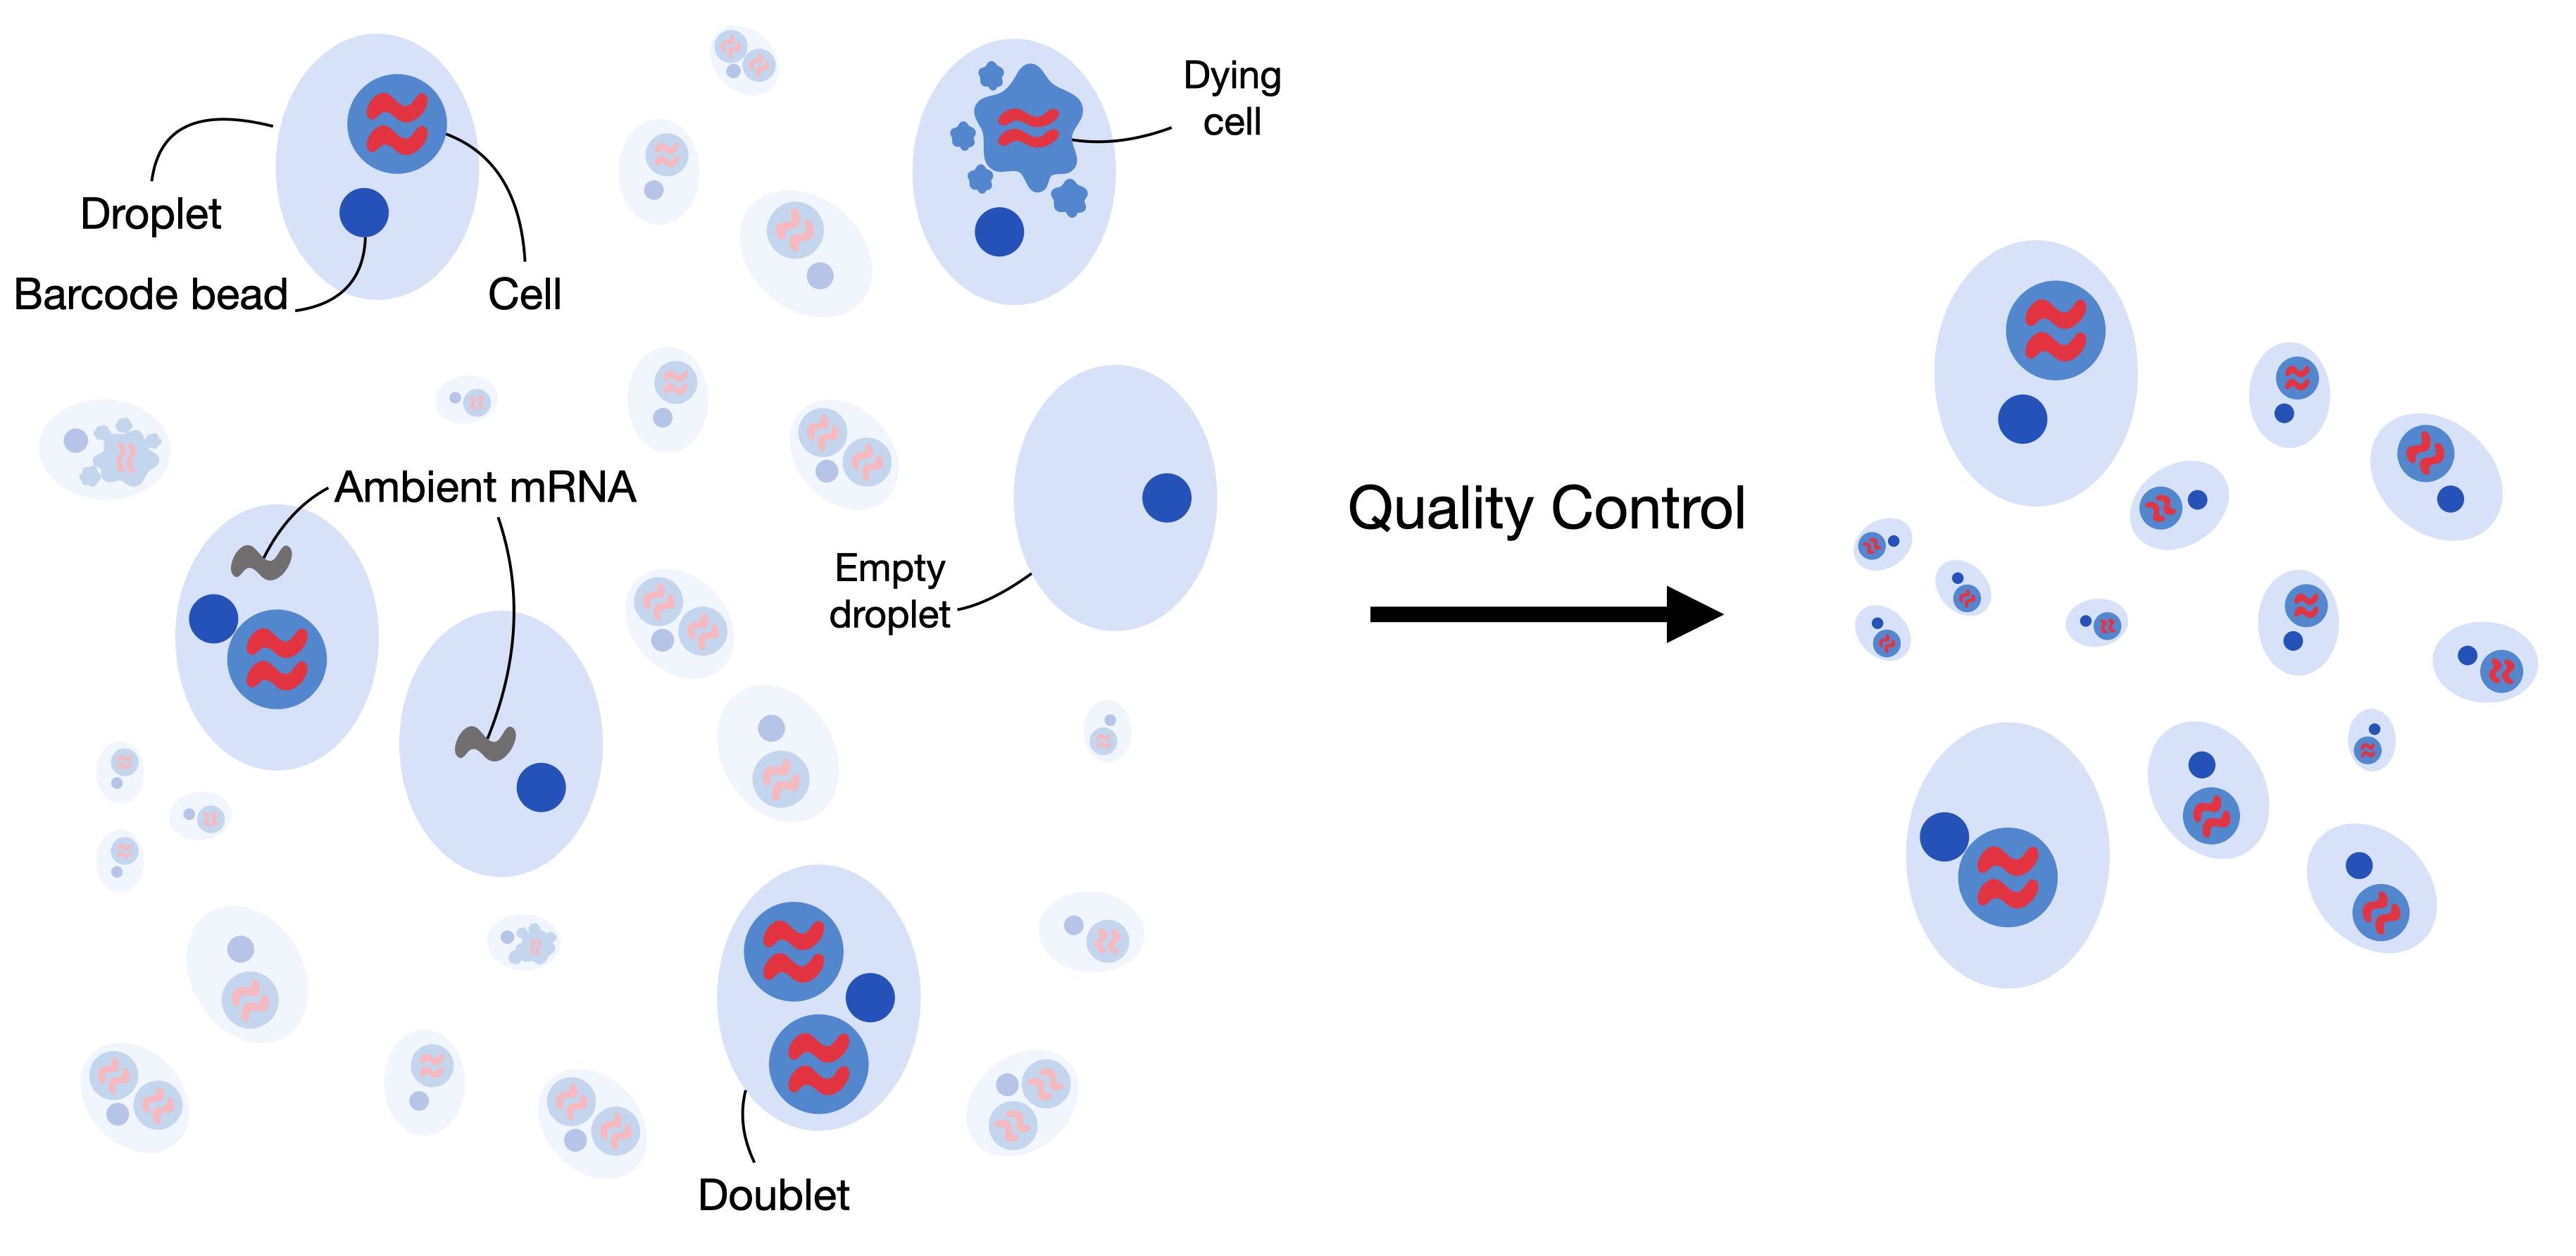
图 1:单细胞 RNA-seq 数据集可能包含低质量细胞、游离 RNA 和双细胞。质量控制旨在移除或校正这些因素,从而获得高质量数据集,使每项观测都代表一个完整的单细胞。
过滤低质量细胞
质量控制的第一步是从数据集中移除低质量细胞。当一个细胞检测到的基因数量较少、计数深度(count depth)较低且线粒体计数占比较高时,它的细胞膜可能已经破损,这可能表明这是一个正在死亡的细胞。由于这些细胞通常不是我们分析的主要目标,并且可能扭曲下游分析,因此我们在质量控制阶段将其移除。为了识别它们,我们定义细胞质量控制(QC)阈值。细胞 QC 通常基于以下三个 QC 协变量(covariate)进行:
每个条形码的计数数目(计数深度)
每个条形码检测到的基因数
每个条形码中线粒体基因计数所占的比例
在细胞质量控制中,通常通过设定阈值来过滤这些协变量异常的细胞,因为它们可能是濒死细胞。如上所述,这类细胞的细胞膜可能已经破损,胞质 mRNA 随之外泄,因而主要剩下线粒体内的 mRNA。它们往往表现为计数深度低、检测到的基因少、线粒体计数占比高。不过,必须综合考察这三个 QC 协变量,否则可能误读细胞信号。例如,线粒体计数占比较高的细胞可能正参与呼吸过程,不应直接滤除;计数偏低或偏高的细胞也可能分别对应静息细胞群体或体积较大的细胞。因此,即便针对单个协变量设定阈值,也最好结合多个协变量共同判断。总体而言,过滤应尽可能宽松、宁可少排除一些细胞,以免误删有活性的细胞群体或较小的亚群。
对于少量或小型数据集,QC 往往是人工完成的:查看不同 QC 协变量的分布,找出随后将被过滤掉的离群值。然而,随着数据集规模增大,这项工作变得越来越耗时,因此或许值得考虑通过 绝对中位差(median absolute deviation, MAD)来自动设定阈值。MAD 的定义为 ,其中 是相应观测的 QC 指标;MAD 是刻画该指标变异程度的稳健统计量。参照 Germain et al., 2020 的做法,如果某个细胞与中位数相差超过 5 个 MAD,就将其标记为离群值;这是一种相对宽松的过滤策略。需要强调的是,在完成细胞注释后重新评估过滤策略可能更为合理。
在 QC 中,第一步是计算 QC 协变量或指标。这里使用 scanpy 函数 scanpy.pp.calculate_qc_metrics,该函数还可以计算特定基因集合的计数占比。因此,我们先定义线粒体、核糖体和血红蛋白基因。需要注意的是,线粒体基因的前缀会随物种而异,可能是“mt-”或“MT-”。本笔记本使用人类骨髓数据,因此线粒体基因采用“MT-”前缀;小鼠数据集通常使用小写的“mt-”。按基因符号前缀匹配只是识别这些基因的一种方式,并依赖数据集自带的注释。如果基因符号缺失或采用其他命名约定,也可以根据基因所在染色体或经过整理的基因标识符列表来选择线粒体基因。
这里定义核糖体和血红蛋白基因是为了提供额外的诊断信息,而不是把它们作为过滤标准。血红蛋白计数占比较高提示可能存在红细胞污染;核糖体计数占比会随细胞状态变化,有助于解释后续区分不同聚类的因素。下面的过滤不会使用这两项指标,而是依据计数深度、检测到的基因数和线粒体计数占比。
# mitochondrial genes
adata.var["mt"] = adata.var_names.str.startswith("MT-")
# ribosomal genes
adata.var["ribo"] = adata.var_names.str.startswith(("RPS", "RPL"))
# hemoglobin genes.
adata.var["hb"] = adata.var_names.str.contains(r"^HB[ABDEGMQZ]\d*(?!\w)")
现在我们可以用 scanpy 计算相应的 QC 指标。
sc.pp.calculate_qc_metrics(
    adata, qc_vars=["mt", "ribo", "hb"], inplace=True, percent_top=[20], log1p=True
)
adata
AnnData object with n_obs × n_vars = 16934 × 36601
obs: 'n_genes_by_counts', 'log1p_n_genes_by_counts', 'total_counts', 'log1p_total_counts', 'pct_counts_in_top_20_genes', 'total_counts_mt', 'log1p_total_counts_mt', 'pct_counts_mt', 'total_counts_ribo', 'log1p_total_counts_ribo', 'pct_counts_ribo', 'total_counts_hb', 'log1p_total_counts_hb', 'pct_counts_hb'
var: 'gene_ids', 'feature_types', 'genome', 'interval', 'mt', 'ribo', 'hb', 'n_cells_by_counts', 'mean_counts', 'log1p_mean_counts', 'pct_dropout_by_counts', 'total_counts', 'log1p_total_counts'该函数在 .var 和 .obs 中添加了若干列。下面重点介绍其中几列:
n_genes_by_counts在.obs中表示细胞内计数为正的基因数;total_counts表示细胞的总计数,也称为文库大小(library size);pct_counts_mt是某个细胞总计数中属于线粒体的比例。
我们现在绘制这三个 QC 协变量 n_genes_by_counts,total_counts 和 pct_counts_mt,以评估各样本中的细胞捕获质量。
p1 = sns.displot(adata.obs["total_counts"], bins=100, kde=False)
p2 = sc.pl.violin(adata, "pct_counts_mt")
p3 = sc.pl.scatter(adata, "total_counts", "n_genes_by_counts", color="pct_counts_mt")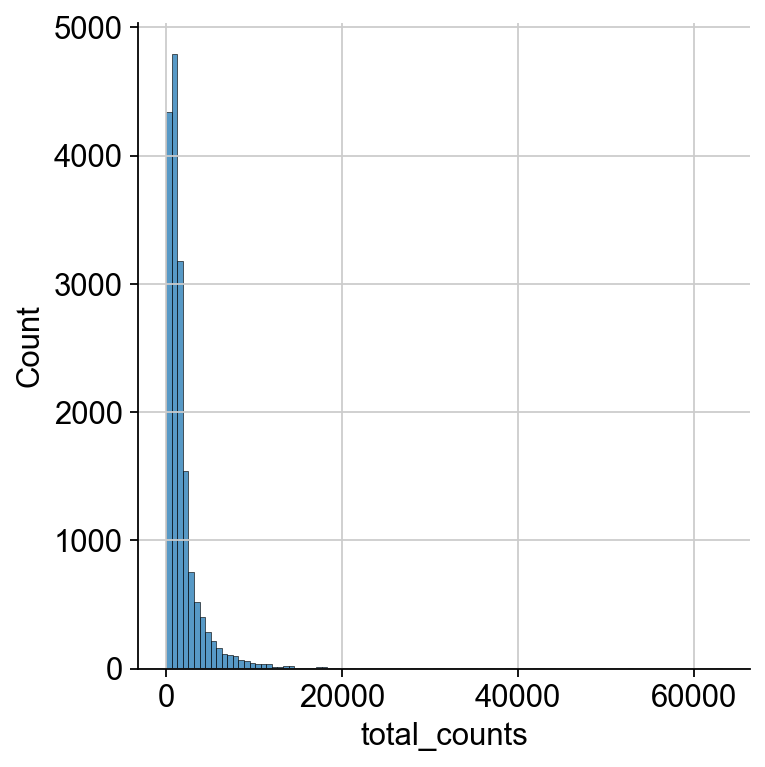
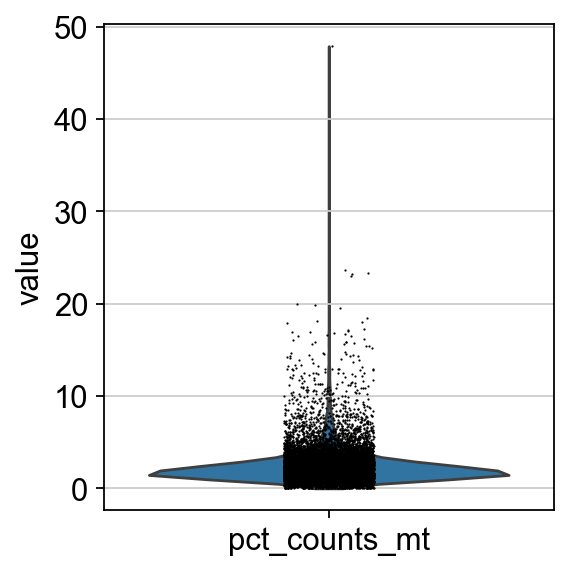
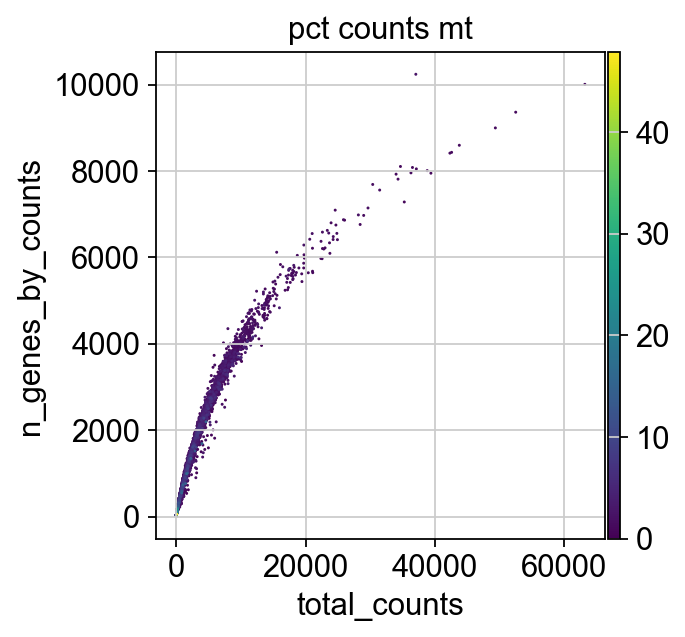
这些图表明,部分细胞的线粒体计数占比较高,而这种现象通常与细胞降解有关。不过,每个细胞的计数数目足够多,且大多数细胞的线粒体计数占比低于 20%,因此仍可继续处理这些数据。此时也可以根据图形手动设定细胞过滤阈值;下面则演示基于 MAD 自动设定阈值并进行过滤的质量控制方法。
首先,我们定义一个函数,它接受一个 metric,即对应的一列 .obs,以及 MAD 的数量(nmad),它在过滤策略中仍然较为宽松。
def is_outlier(adata, metric: str, nmads: int):
    M = adata.obs[metric]
    outlier = (M < np.median(M) - nmads * median_abs_deviation(M)) | (
        np.median(M) + nmads * median_abs_deviation(M) < M
    )
    return outlier
现在,将该函数应用于 log1p_total_counts,log1p_n_genes_by_counts 和 pct_counts_in_top_20_genes 这三个 QC 协变量,每个都使用 5 个 MAD 的阈值。
adata.obs["outlier"] = (
    is_outlier(adata, "log1p_total_counts", 5)
    | is_outlier(adata, "log1p_n_genes_by_counts", 5)
    | is_outlier(adata, "pct_counts_in_top_20_genes", 5)
)
adata.obs.outlier.value_counts()
outlier
False 16065
True 869
Name: count, dtype: int64pct_counts_mt 采用 3 个 MAD 进行过滤。此外,线粒体计数占比超过 8% 的细胞也会被滤除。
adata.obs["mt_outlier"] = is_outlier(adata, "pct_counts_mt", 3) | (
    adata.obs["pct_counts_mt"] > 8
)
adata.obs.mt_outlier.value_counts()
mt_outlier
False 15240
True 1694
Name: count, dtype: int64现在,根据这两个新增列过滤 AnnData 对象。
print(f"Total number of cells: {adata.n_obs}")
adata = adata[(~adata.obs.outlier) & (~adata.obs.mt_outlier)].copy()

print(f"Number of cells after filtering of low quality cells: {adata.n_obs}")
Total number of cells: 16934
Number of cells after filtering of low quality cells: 14814
p1 = sc.pl.scatter(adata, "total_counts", "n_genes_by_counts", color="pct_counts_mt")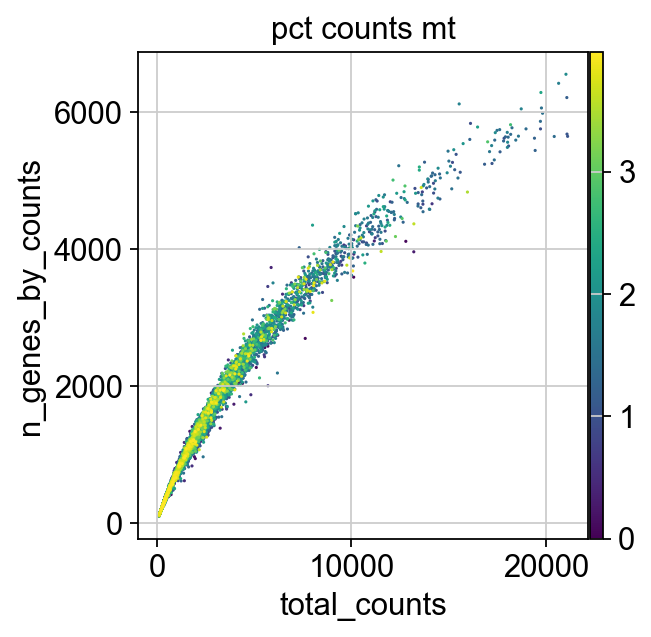
校正环境 RNA
与上面的过滤不同,环境 RNA 校正并非每项分析都必须进行,而且只适用于基于液滴的实验方案。这里之所以介绍它,是因为环境 RNA 污染与下文将讨论的双细胞一样,都会破坏“一个液滴对应一个细胞”的假设。是否值得进行校正,取决于数据集的污染程度以及下游分析对这种污染的敏感性。
对于基于液滴的单细胞 RNA-seq 实验,稀释液中会存在一定量的背景 mRNA,它们会随细胞一起被分配进液滴并一同被测序。其净效应是产生一种背景污染——它代表的并不是液滴内细胞的表达,而是容纳这些细胞的溶液的表达。
基于液滴的 scRNA-seq 会为跨多个细胞的基因生成 UMI 计数,旨在识别每个基因、每个细胞的分子数量。它假设每个液滴都包含来自单细胞的 mRNA。双细胞、空液滴和游离 RNA 会破坏这一假设。游离 mRNA 分子是稀释液中的背景 mRNA,会被分配进液滴并随之一同测序。输入溶液中的这种游离 mRNA 污染通常称为“Soup(背景游离 RNA 污染)”,由细胞裂解产生。
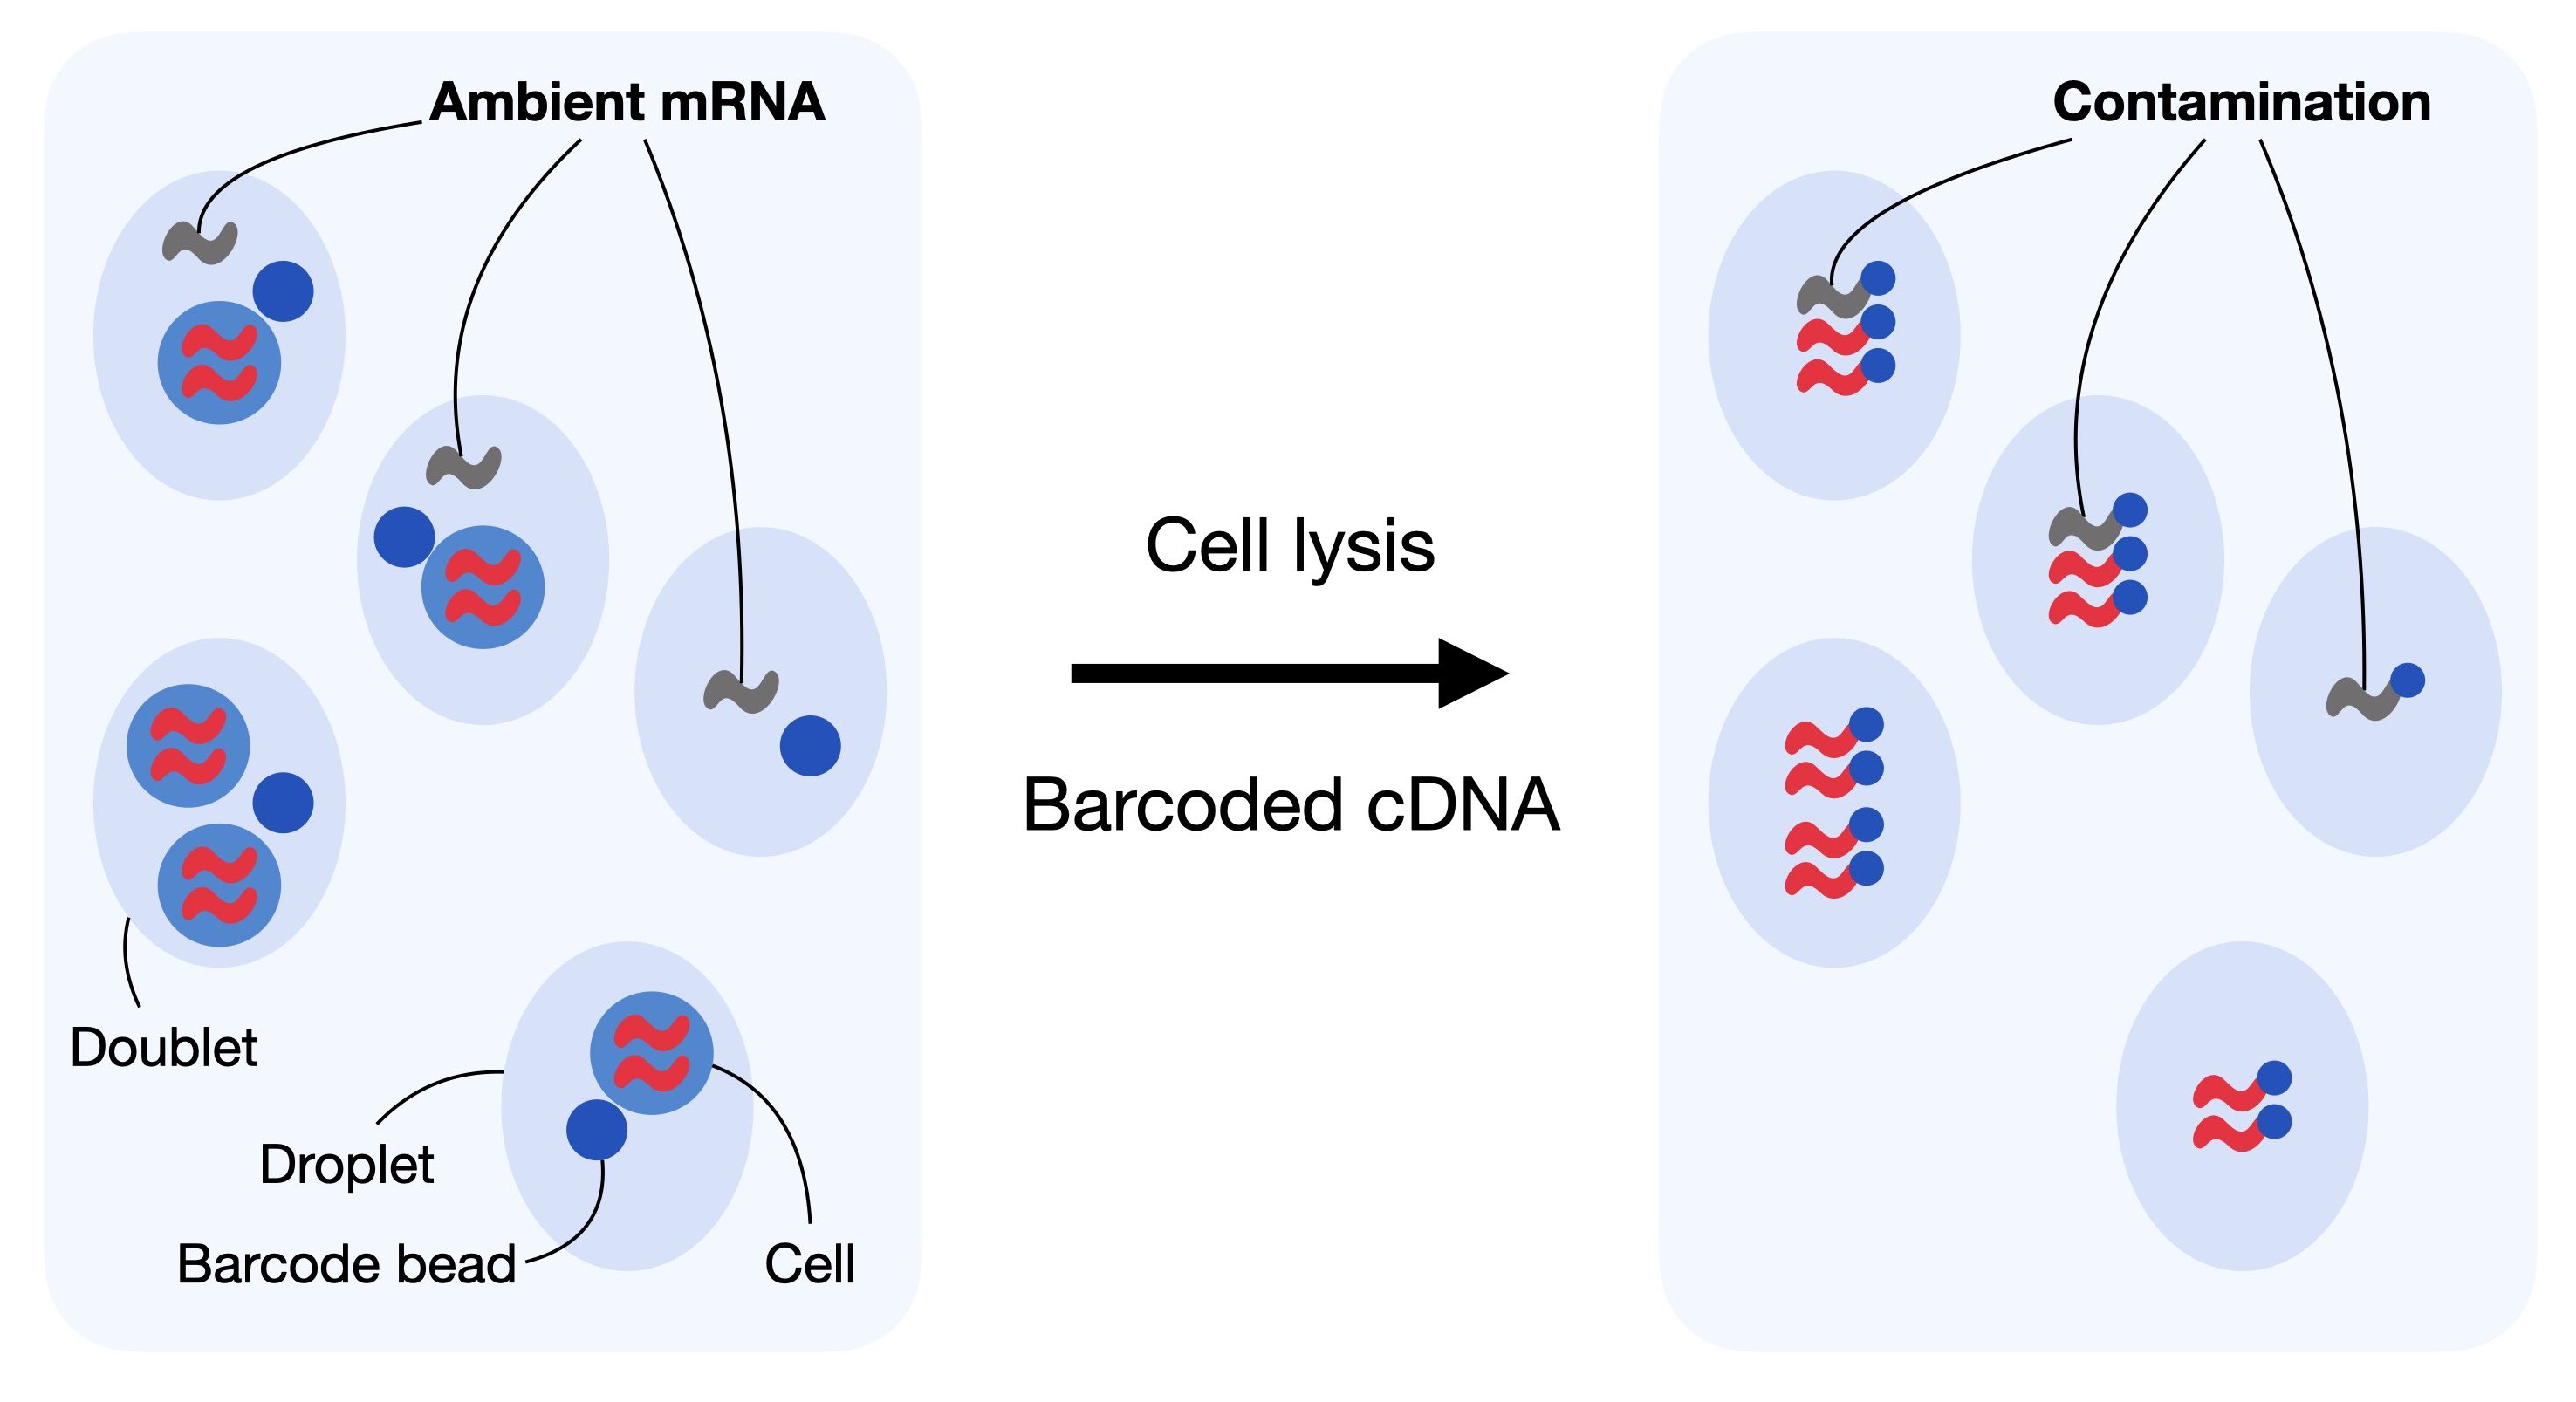
图 2:在基于液滴的测序技术中,液滴可能掺入环境 RNA 或形成双细胞(捕获了多个细胞的液滴)。污染性的环境 RNA 会与细胞自身的 mRNA 一起被加上条形码并计数,从而导致计数受到混淆。
游离 mRNA 分子也称为环境 RNA,它们会混淆观测计数,可视为一种背景污染。对基于液滴的 scRNA-seq 数据集进行游离 mRNA 校正可能非常重要,因为这类污染会影响下游分析对数据的解释。通常,每份输入溶液的“汤”各不相同,并取决于数据集中各个细胞的表达模式。去除环境 mRNA 的方法,例如 SoupX Young & Behjati, 2020 和 DecontX Yang et al., 2020 旨在估计这种“汤”的组成,并据此对计数表中与“汤”相关的表达进行校正。
作为第一步,SoupX 会计算 Soup(背景污染)的谱(profile)。它根据未过滤的 Cellranger 矩阵,从空液滴中估计背景游离 mRNA 的表达谱。接下来,SoupX 估计每个细胞特异性的污染比例。最后,它依据背景游离 mRNA 表达谱和估计出的污染来校正表达矩阵。
SoupX 的输出是经过校正的计数矩阵,可供任何下游分析工具使用。
我们现在加载运行 SoupX 所需的 Python 和 R 软件包。
import logging

import rpy2.rinterface_lib.callbacks as rcb
import rpy2.robjects as ro
from rpy2.robjects import pandas2ri

rcb.logger.setLevel(logging.ERROR)


%load_ext rpy2.ipython
The rpy2.ipython extension is already loaded. To reload it, use:
%reload_ext rpy2.ipython
%%R
library(SoupX)
输出
SoupX 可以在没有聚类信息的情况下运行,不过已有研究 Young & Behjati, 2020 表明,如果提供一个基础聚类,结果会更好。SoupX 既可以使用 Cellranger 生成的默认聚类,也可以手动定义聚类。本笔记本将展示后者,因为 SoupX 的结果对所用聚类并不十分敏感。
现在,复制 AnnData 对象,对副本进行归一化和降维,并计算默认的 Leiden 聚类。聚类章节 将更详细地介绍聚类。目前只需知道,Leiden 聚类会把数据集中的细胞划分为不同分区(社区)。我们将所得聚类保存为 soupx_groups,随后删除 AnnData 副本,以节省笔记本运行时的内存。
首先,我们生成 AnnData 对象的一个副本,对其进行归一化和 log1p 变换。此处我们采用的是简单的平移对数(shifted logarithm)归一化。有关不同归一化技术的更多信息,请参见 归一化章节。
adata_pp = adata.copy()
sc.pp.normalize_total(adata_pp, target_sum=1e4)
sc.pp.log1p(adata_pp)
接着,我们计算数据的主成分(principal component, PC),以获得一个更低维的表示。然后用这种表示生成数据的近邻图(nearest-neighbor graph),并在该 K 近邻(k-nearest neighbors, KNN) 图上运行 Leiden 聚类。我们将这些聚类添加为 soupx_groups 到 .obs,并将它们保存为一个向量。
sc.pp.pca(adata_pp)
sc.pp.neighbors(adata_pp)
sc.tl.leiden(
    adata_pp, key_added="soupx_groups", flavor="igraph", n_iterations=2, directed=False
)

# Preprocess variables for SoupX
adata.obs["soupx_groups"] = adata_pp.obs["soupx_groups"]
现在我们可以删除 AnnData 对象的副本了,因为我们已经生成了一个可用于 SoupX 的聚类向量。
del adata_pp接下来,我们保存细胞名称、基因名称,以及过滤后 Cellranger 输出的数据矩阵。SoupX 需要一个形状为“特征 × 条形码”的矩阵,因此我们必须转置 .X。
cells = adata.obs_names
genes = adata.var_names
data = adata.X.T
SoupX 还需要原始的“基因 × 细胞”矩阵,它通常被称为 raw_feature_bc_matrix.h5,位于 Cellranger 输出中。与前面相同,这里加载 filtered_feature_bc_matrix.h5,其中 lamindb 负责加载该文件;随后运行 .var_names_make_unique(),并转置相应的 .X。
adata_raw = af.load()
adata_raw.var_names_make_unique()

genes_raw = adata_raw.var_names
cells_raw = adata_raw.obs_names

data_tod = adata_raw.X.T
/Users/seohyon/miniconda3/envs/preprocessing/lib/python3.12/site-packages/anndata/_core/anndata.py:1758: UserWarning: Variable names are not unique. To make them unique, call `.var_names_make_unique`.
utils.warn_names_duplicates("var")
del adata_raw接下来,需要将数据转换成可供 R 使用的适当结构。
data_csc = data.tocsc()
data_tod_csc = data_tod.tocsc()

# Extract sparse components and cast to correct types
x = data_csc.data.astype(np.float64)
i = data_csc.indices.astype(np.int32)
p = data_csc.indptr.astype(np.int32)
dims = np.array(data_csc.shape, dtype=np.int32)

x_tod = data_tod_csc.data.astype(np.float64)
i_tod = data_tod_csc.indices.astype(np.int32)
p_tod = data_tod_csc.indptr.astype(np.int32)
dims_tod = np.array(data_tod_csc.shape, dtype=np.int32)

with localconverter(ro.default_converter + pandas2ri.converter + numpy2ri.converter):
    ro.globalenv["x"] = x
    ro.globalenv["i"] = i
    ro.globalenv["p"] = p
    ro.globalenv["dims"] = dims

    ro.globalenv["x_tod"] = x_tod
    ro.globalenv["i_tod"] = i_tod
    ro.globalenv["p_tod"] = p_tod
    ro.globalenv["dims_tod"] = dims_tod

    ro.globalenv["genes"] = np.array(genes)
    ro.globalenv["genes_raw"] = np.array(genes_raw)
    ro.globalenv["cells"] = np.array(cells)
    ro.globalenv["cells_raw"] = np.array(cells_raw)
    ro.globalenv["soupx_groups"] = adata.obs["soupx_groups"].to_numpy()
现在万事俱备,可以运行 SoupX 了。输入包括:形状为“条形码 × 细胞”的过滤后 Cellranger 矩阵、Cellranger 输出的原始液滴表(形状为 barcodes x droplets)、基因名和细胞名,以及通过简单 Leiden 聚类得到的聚类结果。输出将是校正后的计数矩阵。
我们首先构建一个所谓的 SoupChannel,它由液滴表和细胞表构建而成。接下来,我们向 SoupChannel 对象添加元数据(metadata),它可以是任何元数据,其形式为 data.frame。
%%R -o out

library(Matrix)

# Manually coerce types to avoid "array" class errors
x <- as.numeric(x)
i <- as.integer(i)
p <- as.integer(p)
dims <- as.integer(dims)

x_tod <- as.numeric(x_tod)
i_tod <- as.integer(i_tod)
p_tod <- as.integer(p_tod)
dims_tod <- as.integer(dims_tod)

# Reconstruct sparse matrices
data <- new("dgCMatrix",
            Dim = dims,
            x = x,
            i = i,
            p = p)

data_tod <- new("dgCMatrix",
                Dim = dims_tod,
                x = x_tod,
                i = i_tod,
                p = p_tod)

# Assign row and column names
rownames(data) <- genes
colnames(data) <- cells
rownames(data_tod) <- genes_raw
colnames(data_tod) <- cells_raw

# SoupX pipeline
sc = SoupChannel(data_tod, data, calcSoupProfile = TRUE)
sc = setClusters(sc, soupx_groups)
sc = autoEstCont(sc, doPlot = FALSE)
out = adjustCounts(sc, roundToInt = TRUE)
SoupX 成功推断出校正后的计数,我们现在可以将其作为额外的一层存储起来。在随后的所有分析步骤中,我们都希望使用 SoupX 校正后的计数矩阵,因此我们覆盖 .X 为 SoupX 校正后的矩阵。首先,正如之前从 Python 到 R 那样,我们再把矩阵从 R 转换回 Python。
with localconverter(ro.default_converter + pandas2ri.converter + numpy2ri.converter):
    out_py = ro.conversion.rpy2py(ro.globalenv["out"])

x = np.array(out_py.slots["x"])
i = np.array(out_py.slots["i"])
p = np.array(out_py.slots["p"])
shape = tuple(out_py.slots["Dim"])

out_matrix = csc_matrix((x, i, p), shape=shape)
adata.layers["counts"] = adata.X.copy()
adata.layers["soupX_counts"] = out_matrix.T
adata.X = adata.layers["soupX_counts"]接下来,再滤除未在至少 20 个细胞中检出的基因,因为这些基因缺乏足够的信息量。只在极少数细胞中检出的基因往往源于技术噪声、环境 RNA 污染或随机的低水平转录,而不是真实的生物学信号。保留这些低检出率基因会引入噪声、掩盖有意义的生物学模式,并使聚类、差异表达 检验或轨迹推断(trajectory inference)等下游分析更加复杂。设定最低检出阈值(例如 20 个细胞)后,分析将聚焦于在多个细胞中稳定观测到的基因,从而提高结果的可靠性和可解释性。
print(f"Total number of genes: {adata.n_vars}")

# Min 20 cells - filters out 0 count genes
sc.pp.filter_genes(adata, min_cells=20)
print(f"Number of genes after cell filter: {adata.n_vars}")
Total number of genes: 36601
Number of genes after cell filter: 20109
请注意,由于随机数生成器(random number generator, RNG)的状态不同,细胞过滤后的基因数可能在不同运行之间略有变化。
Doublet 检测
双细胞是指在同一个细胞条形码下被测序的两个细胞,例如它们被捕获在同一个液滴中。这正是我们至今一直使用“条形码”而非“细胞”一词的原因。如果一个双细胞由相同的细胞类型(但来自不同个体)构成,则称为同型(homotypic)双细胞,否则称为异型(heterotypic)双细胞。同型双细胞不一定能从计数矩阵中识别出来,并且常被认为影响不大,因为它们可以通过细胞哈希(cell hashing)或 单核苷酸多态性(single-nucleotide polymorphism, SNP) 来识别。因此,识别它们并不是双细胞检测方法的主要目标。
由不同细胞类型或状态形成的双细胞称为异型双细胞。识别它们至关重要,因为它们很可能被错误分类,并导致下游分析步骤失真。因此,双细胞检测与去除通常是最初的预处理步骤。双细胞既可以通过其读段数和检测到的特征数偏高来识别,也可以通过生成人工双细胞、再与数据集中的真实细胞作比较的方法来识别。双细胞检测方法在计算上很高效,已有若干软件包可完成这一任务。
Xi & Li, 2021 以 9 种不同的双细胞检测方法为基准,评估了它们在计算效率和双细胞检测精度方面的表现。他们还在该基准测试的增补中评估了 scDblFinder,它取得了最高的双细胞检测精度,以及良好的计算效率和稳定性 Xi & Li, 2021。
在本教程中,我们将展示 scDblFinder R 包。scDblFinder 会随机选择两个液滴,并通过对它们的基因表达谱取平均,从中生成人工双细胞。双细胞得分随后被定义为:在主成分空间中,每个液滴的 k 近邻图里人工双细胞所占的比例。
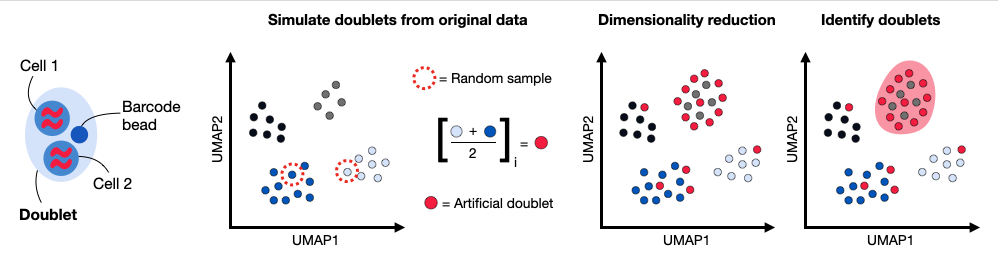
图 3:双细胞是包含一个以上细胞的液滴。常见的双细胞检测方法会随机抽取成对的细胞、并对其基因表达谱取平均,以生成人工双细胞的计数。这些人工双细胞会与其余的真实细胞一起被投影到一个更低维的主成分空间中。双细胞检测方法会根据 k 近邻图中人工双细胞邻居的数量,计算出一个双细胞得分。
首先,加载一些额外的 R 软件包。
%%R
library(Seurat)
library(scater)
library(scDblFinder)
library(SingleCellExperiment)
library(BiocParallel)
data_mat = adata.X.T现在,我们可以在一个 SingleCellExperiment 中以 data_mat 作为 scDblFinder 的输入,来启动双细胞检测。scDblFinder 会向 sce 的 colData 添加若干列。其中三个可能对分析有用:
sce$scDblFinder.score:最终双细胞得分(得分越高,该细胞越可能是双细胞)sce$scDblFinder.ratio:该细胞邻域中人工双细胞的比例sce$scDblFinder.class:分类结果(Doublet 或单细胞液滴(singlet))
我们只输出分类结果,并将其存入 AnnData 对象的 .obs。其他结果也可以用同样的方式添加到 AnnData 对象中。
同样,我们首先需要把矩阵从 Python 转换到 R。
data_mat = adata.X.T.tocsc()

x = data_mat.data.astype(np.float64)
i = data_mat.indices.astype(np.int32)
p = data_mat.indptr.astype(np.int32)
dims = np.array(data_mat.shape, dtype=np.int32)

with localconverter(ro.default_converter + numpy2ri.converter):
    ro.globalenv["x"] = x
    ro.globalenv["i"] = i
    ro.globalenv["p"] = p
    ro.globalenv["dims"] = dims
接下来运行:
%%R -o doublet_score -o doublet_class

x <- as.numeric(x)
i <- as.integer(i)
p <- as.integer(p)
dims <- as.integer(dims)

data_mat <- new("dgCMatrix", Dim = dims, x = x, i = i, p = p)

set.seed(123)
sce <- scDblFinder(SingleCellExperiment(list(counts = data_mat)))

doublet_score <- sce$scDblFinder.score
doublet_class <- sce$scDblFinder.class
scDblFinder 输出的分类包括 Singlet(1)和 Doublet(2)。我们将其添加到 AnnData 对象中的 .obs。
adata.obs["scDblFinder_score"] = doublet_score
adata.obs["scDblFinder_class"] = doublet_class
adata.obs.scDblFinder_class.value_counts()
scDblFinder_class
singlet 12322
doublet 2492
Name: count, dtype: int64建议暂时保留数据集中被标记为双细胞的细胞,并在后续可视化时进行人工核查。
在下游聚类过程中,重新评估质量控制及所选参数可能会有帮助,以便酌情多过滤或少过滤一些细胞。我们现在将把数据集保存到 lamindb,以便继续下一节:归一化章节。
af = ln.Artifact.from_anndata(
    adata,
    key="preprocessing_visualization/s4d8_quality_control.h5ad",
    description="anndata after quality control",
).save()
af
输出
→ creating new artifact version for key='preprocessing_visualization/s4d8_quality_control.h5ad' (storage: 's3://lamin-eu-central-1/VPwcjx3CDAa2')
... uploading Y8EIAWzUB42V1j3S0008.h5ad: 100.0%
! The cache path /Users/seohyon/Library/Caches/lamindb/lamin-eu-central-1/VPwcjx3CDAa2/preprocessing_visualization/s4d8_quality_control.h5ad already exists, replacing it.
Artifact(uid='Y8EIAWzUB42V1j3S0008', is_latest=True, key='preprocessing_visualization/s4d8_quality_control.h5ad', description='anndata after quality control', suffix='.h5ad', kind='dataset', otype='AnnData', size=526647603, hash='FVzbbtQN4UQapQ6u8T0IvK', n_observations=14814, space_id=1, storage_id=1, run_id=7, created_by_id=5, created_at=2025-11-10 02:25:43 UTC)- Zappia, L., & Theis, F. J. (2021). Over 1000 tools reveal trends in the single-cell RNA-seq analysis landscape. Genome Biology, 22(1), 301. 10.1186/s13059-021-02519-4
- Luecken, M. D., Burkhardt, D. B., Cannoodt, R., Lance, C., Agrawal, A., Aliee, H., Chen, A. T., Deconinck, L., Detweiler, A. M., Granados, A. A., Huynh, S., Isacco, L., Kim, Y. J., Klein, D., KUMAR, B. D., Kuppasani, S., Lickert, H., McGeever, A., Mekonen, H., … Bloom, J. M. (2021). A sandbox for prediction and integration of DNA, RNA, and proteins in single cells. Thirty-Fifth Conference on Neural Information Processing Systems Datasets and Benchmarks Track (Round 2). https://openreview.net/forum?id=gN35BGa1Rt
- Germain, P.-L., Sonrel, A., & Robinson, M. D. (2020). pipeComp, a general framework for the evaluation of computational pipelines, reveals performant single cell RNA-seq preprocessing tools. Genome Biology, 21(1), 227. 10.1186/s13059-020-02136-7
- Young, M. D., & Behjati, S. (2020). SoupX removes ambient term`RNA` contamination from droplet-based single-cell term`RNA` sequencing data. GigaScience, 9(12). 10.1093/gigascience/giaa151
- Yang, S., Corbett, S. E., Koga, Y., Wang, Z., Johnson, W. E., Yajima, M., & Campbell, J. D. (2020). Decontamination of ambient RNA in single-cell RNA-seq with DecontX. Genome Biology, 21(1), 57. 10.1186/s13059-020-1950-6
- Xi, N. M., & Li, J. J. (2021). Benchmarking Computational Doublet-Detection Methods for Single-Cell term`RNA` Sequencing Data. Cell Systems, 12(2), 176-194.e6. https://doi.org/10.1016/j.cels.2020.11.008
- Xi, N. M., & Li, J. J. (2021). Protocol for executing and benchmarking eight computational doublet-detection methods in single-cell RNA sequencing data analysis. STAR Protocols, 2(3), 100699. 10.1016/j.xpro.2021.100699