🧠 关键要点
测序技术经历了从 桑格测序(Sanger sequencing),到 高通量下一代测序(next-generation sequencing, NGS),再到 长读长实时测序(long-read real-time sequencing)的发展,对应第一代、第二代和第三代测序。
单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)能够在 单细胞水平(individual cell level)分析基因表达,从而揭示 bulk RNA-seq 往往掩盖的细胞异质性和稀有细胞类型。
在 scRNA-seq 中,转录本定量(transcript quantification)会把原始数据转换为每个细胞的估计转录本计数(transcript count)表。 全长方案(full-length protocol)捕获完整转录本; 标签式方案(tag-based protocol)则对转录本的 3′ 端或 5′ 端进行测序。
转录以 随机爆发(stochastic bursts) 的形式发生;一个典型哺乳动物细胞中共有约10 万至 100 万个信使 RNA(Messenger RNA, mRNA)分子。
我们根据细胞分离方式将 scRNA-seq 技术分为两大类:使用 液滴(droplet)(水相微滴),或使用 物理隔室(physical compartment)(如孔)。
本章简要介绍应用最广泛的单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq)测定(Assay)及相关的基础分子生物学概念。RNA 指核糖核酸(ribonucleic acid, RNA)。多模态 或空间 Assay 不在此处讨论,而是在相应的高级章节中介绍。所有 测序 Assay 都各有优势和局限,数据分析人员必须了解这些,才能意识到数据中可能存在的偏差。
生命的基本组成单位
正如我们所理解的,生命是区分生命体与死亡或无生命之物的特征。“生命”一词的大多数定义都共享一个共同的实体——细胞。细胞是开放系统,能够维持稳态、进行新陈代谢、生长、适应环境、繁殖、对刺激作出响应并实现自我组织。因此,细胞是生命的基本构成单元。它们最早于 1665 年由英国科学家 Robert Hooke 发现。Hooke 用一台十分简陋的显微镜观察了一薄片软木,惊讶地发现这层切片看上去很像蜂巢。他将这些微小的单元命名为“细胞”。
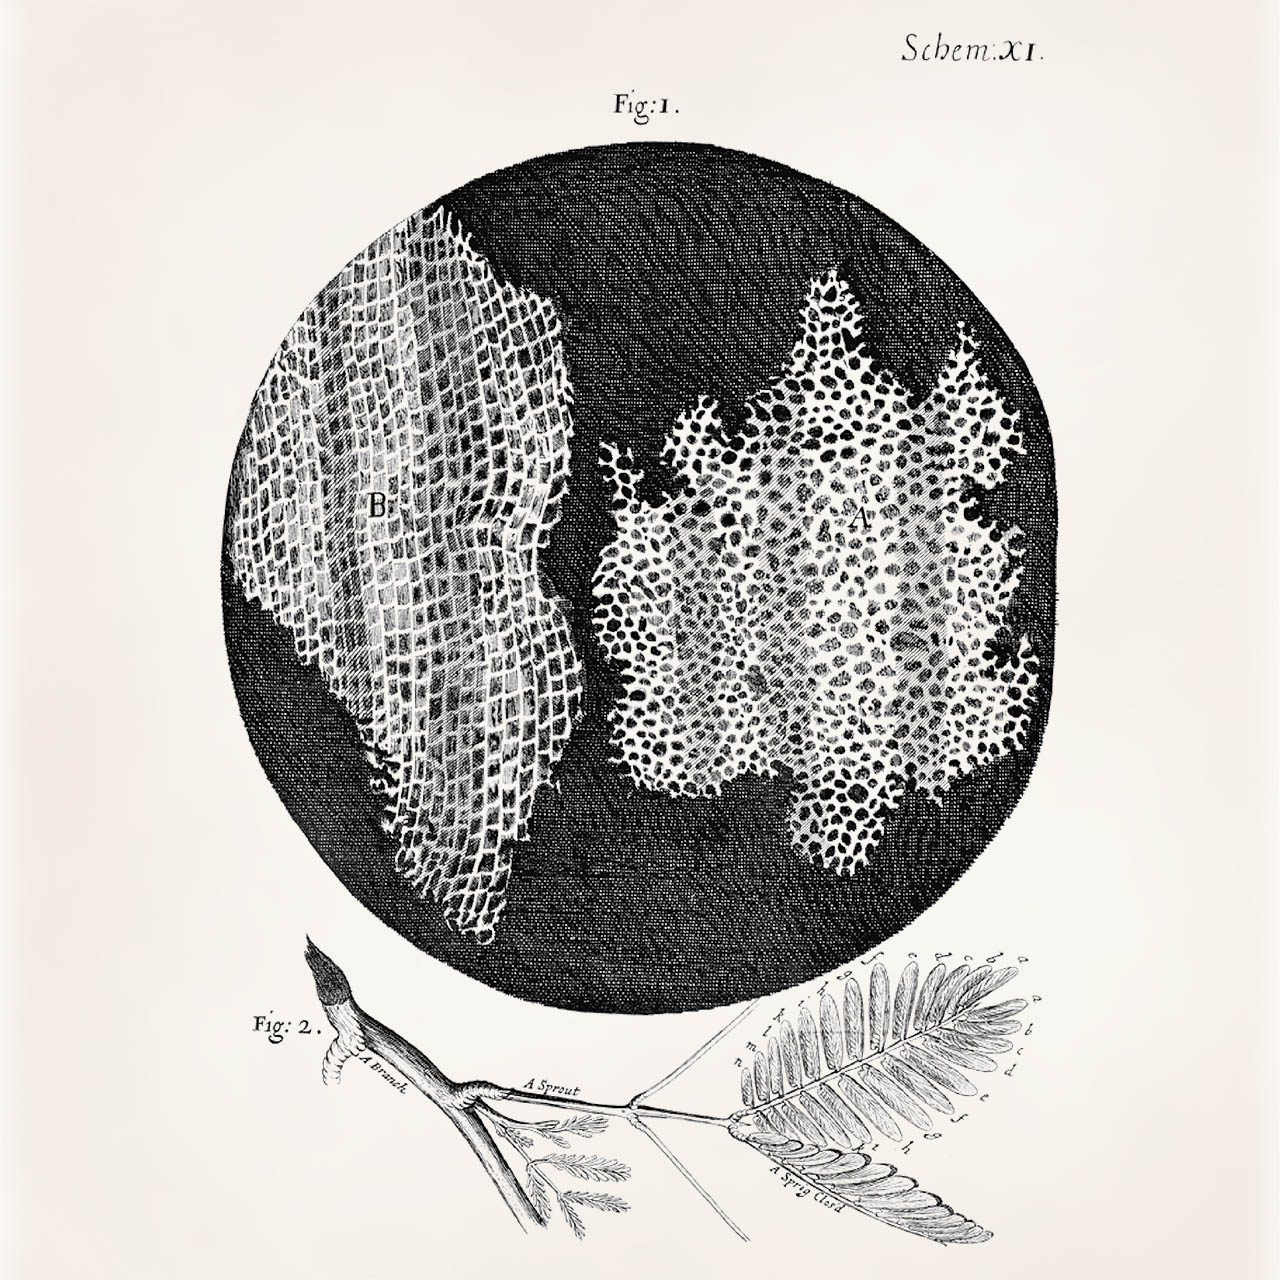
图 1:Robert Hooke 绘制的软木细胞图。图片取自《显微图谱》(Micrographia)。
1839 年,Matthias Jakob Schleiden 和 Theodor Schwann 首次提出了细胞学说,指出所有生物都由细胞构成。自细胞学说最初提出以来,研究人员发现所有细胞的化学组成几乎相同,并表现出一种动态的信息流动,即以脱氧核糖核酸(deoxyribonucleic acid, DNA)的形式将遗传密码从一个细胞传递到另一个细胞。细胞可分为两大类:真核生物(eukaryote)和原核生物(prokaryote)。真核细胞含有细胞核,核膜将染色体(chromosome)包裹其中;而原核细胞只有一个拟核区域,并没有真正的细胞核。细胞核中存放着细胞的基因组 DNA,这正是它们被称为真核生物的原因:Nucleus 在拉丁语中意为“果仁”或“种子”。DNA 复制机器读取储存在细胞核 DNA 中的遗传信息,从而完成自我复制,维持生命周期的延续。真核生物的 DNA 被分成若干条线性的束,称为染色体,在细胞核分裂时由微管纺锤体加以分离。理解隐藏在 DNA 中的遗传信息,是理解众多演化过程和疾病相关过程的关键。
测序是解读 DNA 核苷酸排列顺序的过程。它主要用于揭示某一特定 DNA 片段、一个完整基因组、乃至复杂微生物组所携带的遗传信息。DNA 测序使研究人员能够确定基因的位置、功能与调控方式。例如,它可以揭示诸如开放阅读框(open reading frame, ORF)、起始与终止密码子之间的蛋白质编码序列等遗传特征(feature),或 CpG 岛(CpG island),标志着 启动子(promoter) 区域。另一个广泛的应用领域是进化分析,即比较不同生物体的同源 DNA 序列。DNA 测序还可用于研究突变与疾病、甚至疾病抗性之间的关联,因此是最具价值的应用之一。
测序简史
第一代测序
尽管早在 1869 年 Friedrich Miescher 就首次分离出了 DNA,科学界却又花了 100 多年才发展出高通量测序技术。1953 年,Watson、Crick 和 Franklin 发现了 DNA 的结构;1965 年,Robert Holley 完成了第一个 转运 RNA(transfer RNA, tRNA) 的测序。七年之后,即 1972 年,Walter Fiers 首次对一个完整的基因(噬菌体 MS2 的外壳蛋白)完成了测序——他利用 RNase 消化病毒 RNA、分离寡核苷酸,最后借助电泳和色谱法将它们分离开来 Jou et al., 1972。与此同时,Frederick Sanger 开发了一种 DNA 测序方法,使用经放射性标记、部分消化的片段,称为“链终止法”,更通俗的叫法是“桑格测序(Sanger sequencing)”。尽管 Sanger 测序至今仍在使用,但它存在若干不足,包括缺乏自动化和耗时较长。1987 年,Leroy Hood 和 Michael Hunkapiller 开发了 ABI 370——一种使 Sanger 测序过程自动化的仪器。其最关键的创新成就,是用荧光染料代替放射性分子来自动标记 DNA 片段。这一变化不仅使该方法操作起来更安全,也让计算机得以分析所获得的数据 Hood et al., 1987。
👍 优势
Sanger 测序简单且经济实惠。
操作正确时,错误率非常低(<0.001%)。
👎 局限性
Sanger 方法只能测定约 300–1,000 个碱基对(base pair, bp)的短 DNA 片段。
Sanger 序列在前 15 至 40 个碱基处的质量往往较差,因为这正是引物结合的区域。
测序质量在 700 到 900 个碱基之后开始下降。
如果被测序的 DNA 片段经过克隆,部分克隆载体序列(一种用于复制、储存和扩增基因的 DNA 载体)可能会混入最终的序列中。
就每个测序碱基的成本而言,Sanger 测序比第二代或第三代测序更昂贵。
第二代测序
1996 年,也就是 Sanger 测序发表 9 年后,Mostafa Ronaghi、Mathias Uhlen 和 Pȧl Nyŕen 开发了焦磷酸测序(pyrosequencing),推动了 DNA 测序技术的变革,也标志着第二代测序的开端。第二代测序也称下一代测序(next-generation sequencing, NGS),主要依赖实验流程的进一步自动化、计算机的使用,以及反应体系的小型化。焦磷酸测序通过检测测序过程中焦磷酸释放所产生的发光信号来读出序列,这一过程也常被称为边合成边测序(sequencing by synthesis, SBS)。两年后,Shankar Balasubramanian 和 David Klenerman 在 Solexa 公司开发并改造了边合成边测序流程,引入了使用荧光染料的新方法。Solexa 的技术后来也成为 Illumina 测序仪的基础,而 Illumina 测序仪至今仍占据市场主导地位。2005 年推出的 Roche 454 测序仪,是第一台在单台自动化设备中完整实现焦磷酸测序流程的测序仪。Life Technologies 随后推出了其他平台,包括 2007 年的 SOLiD(一种“连接测序(sequencing by ligation, SBL)”系统)和 2011 年的 Ion Torrent(在新 DNA 合成过程中检测氢离子)。一般来说,边合成边测序是在不断延伸的 DNA 链上逐个加入单个核苷酸,并检测每一次加入;而边连接边测序则通过检测短 DNA 探针与片段的连接来确定序列。
👍 优势
就所需试剂而言,第二代测序通常是成本最低的选择。
即使是极少量的样本材料,仍可用作输入。
对低频变异检测灵敏度高,并能全面覆盖基因组。
支持样本多重(multiplexing),通量高。
能够同时对数千个基因进行测序。
👎 局限性
测序仪很昂贵,往往必须与同事共享。
第二代测序仪体积庞大且固定安装,并非为野外工作设计。
一般来说,第二代测序会产生许多较短的测序片段(reads),它们难以用于从头组装新基因组。
测序结果的质量取决于参考基因组。
第三代测序
第三代测序(现今也称下一代测序)为市场带来了两项创新。其一是长读长测序(long-read sequencing),它能检测到远比第二代测序所产生的片段更长的核苷酸片段。典型的 Illumina 短读长测序仪依型号不同产生 75 到 300 个碱基对的片段,而第三代测序仪可以读取数万个碱基对。这对于在没有参考基因组的情况下从头组装新基因组尤为重要。其二,实时测序能力是第三代测序的另一项重大进步。再结合体积小巧、且无需其他复杂仪器来完成测序化学反应的便携式测序仪,测序如今已“可现场进行”,甚至能在远离实验室的地方边采样边测序。
关于测序长度的说明
1 个 bp
1 千碱基对(kb)= 1,000 bp
1 兆碱基对(Mb)= 1,000,000 bp
1 吉碱基对(Gb)= 1,000,000,000 bp
太平洋生物科学(PacBio)于 2010 年推出零模波导测序。该技术使用仅容纳单个 DNA 聚合酶的纳米孔穴,使位于孔穴下方的检测器能够直接观测每次核苷酸掺入。不同种类的核苷酸带有不同的荧光染料标记,掺入时发出的荧光信号会被检测并转换为序列读出。PacBio 测序仪产生的 Read 通常长 8 至 15 kb,最长可达 70 kb。
Oxford Nanopore Technologies 于 2012 年首次推出了便携式的 MinION 设备。MinION 及其后续的 GridION 和 PromethION 产品线,是用于 DNA/RNA 的测序仪,能够产生超过 2 Mb 的 Read。通常,纳米孔单细胞文库(library)生成的 互补 DNA(complementary DNA, cDNA) 转录本长度一般为 900 bp 到 2.7 kb。值得注意的是,MinION 测序设备小到可以放在手掌中。Oxford Nanopore 测序仪的理念是:在核酸通过蛋白质纳米孔迁移时,检测电流的变化 Jain et al., 2016。
👍 优势
长 Read 使大型新基因组的组装成为可能。
测序仪便于携带,非常适合野外工作。
可直接检测 DNA 和 RNA 序列的表观遗传修饰。
速度快!这是第三代测序仪的一大优势。
👎 局限性
一些第三代测序仪的错误率高于第二代测序仪(例如,Roche 新推出的“扩展测序”技术就试图解决这一问题 Jain et al., 2016 Roche, 2025)。
试剂通常比第二代测序所用试剂更昂贵。
不同代际测序技术的比较
表 1:常见测序技术的性能比较,按最大读长排序。Sanger 测序的数据来自不同的来源(a, b, c, d),而所有其他方法的数据均来自 Logsdon et al. (2020)。
| 名称 | 最大 Read 长度(kb) | 准确率(%) | 成本(美元/Gb) | 吞吐量(Mb/年) | 代际 |
|---|---|---|---|---|---|
| Illumina NextSeq 550 | 0.15 | >99.9 | >47,782 | 50-63 | 2 |
| Illumina NovaSeq 6000 | 0.25 | >99.9 | 10-35 | >1,194,545 | 2 |
| Sanger 测序(例如 ThermoFisher) | 1b | 99.99a | 500,000c | 0.73d | 1 |
| PacBio(Sequel II,HiFi) | >20 | >99 | 43–86 | 10,220 | 3 |
| PacBio(Sequel II,CLR) | >200 | 87–92 | 13-26 | 93,440 | 3 |
| Nanopore(PromethION) | >1,000 | 87–98 | 21-42 | 3,153,600 | 3 |
| Nanopore(MinION/GridION) | >1,500 | 87–98 | 50-2,000 | 913-109,500 | 3 |
NGS 流程概览
尽管 NGS 技术多种多样,但对 DNA(以及由 RNA 逆转录(reverse transcription, RT)得到的 DNA)进行测序的一般步骤大体相同,差异主要在于各类测序技术所采用的化学原理。
样本与文库制备:第一步,文库 的制备过程是:先将 DNA 样本片段化,再为其连接 接头序列(adapter sequence)。这些接头参与文库片段与基质表面的杂交,并形成引物结合位点。
扩增与测序:在第二步中,文库被转化为单链分子。在扩增步骤(如聚合酶链式反应(polymerase chain reaction, PCR))中,会形成一个个 DNA 分子簇。在一次测序运行中,所有这些簇各自独立进行反应。
数据输出与分析:测序实验的输出取决于测序技术及其化学原理。有些测序仪产生荧光信号,并将其存储在特定的输出文件中;另一些则产生电信号,并将其存储为相应的文件格式。通常,实验生成的原始数据量十分庞大,需要复杂且计算密集的处理。原始数据处理一章将进一步讨论这一问题。
RNA 测序
到目前为止,我们在介绍测序时一直默认测序对象为 DNA。然而,仅知道某个生物体的 DNA 序列及其调控元件的位置,并不足以了解细胞动态的实时过程。RNA 测序(RNA sequencing, RNA-seq)使科学家能够在测序时刻获取细胞、组织或生物体的“快照”,并以基因表达谱的形式加以描述。这些信息可用于检测疾病状态在药物治疗、环境因素、基因型及其他实验条件下发生的变化。
RNA-Seq 大体遵循 DNA 测序方案,但增加了逆转录步骤,在该步骤中 cDNA 由 RNA 模板合成。与基于微阵列(microarray)的检测或定量逆转录 PCR(quantitative reverse transcription polymerase chain reaction, qRT-PCR) 等方法不同,现代 RNA 测序可以对转录本进行无偏采样;而前述方法需要设计探针来专门靶向感兴趣的区域。基于微阵列的检测 使用探针(即互补序列)来检测感兴趣的特定序列(如基因)。定量逆转录 PCR 通过监测 PCR 过程中互补 DNA(cDNA)分子的扩增情况,来测量目标 RNA 的量。
所获得的基因表达谱还可用于检测转录本异构体(isoform)、基因融合、单核苷酸变异(single-nucleotide variant, SNV),以及许多其他值得关注的特征。现代 RNA 测序不受先验知识限制,能够同时捕获已知和新发现的 feature,从而产生适合探索性数据分析的丰富数据集。
单细胞 RNA 测序
bulk 测序与单细胞 RNA 测序
RNA-Seq 主要有两种方式:一是对目标来源中所有细胞混合后的 RNA 进行测序(bulk 测序),二是分别对各个细胞的转录组进行测序(即单细胞测序)。在大多数情况下,将所有细胞的 RNA 混合在一起,比实验上更为复杂的 scRNA-seq 更便宜、也更简便。bulk RNA-Seq 得到的是细胞平均后的表达谱,通常更易于分析,但也掩盖了一部分复杂性,例如细胞表达谱的异质性——而这种异质性可能恰恰有助于回答所关心的问题。某些药物或扰动可能只影响特定的 细胞类型,或细胞类型之间的相互作用。例如在肿瘤学中,可能存在罕见的耐药肿瘤细胞导致疾病复发,而仅凭简单的 bulk RNA-Seq 很难识别它们,即便是在培养细胞上也是如此。
要揭示这类关系,在单细胞水平上考察基因表达至关重要。不过,scRNA-Seq 也存在若干需要注意之处。第一,单细胞实验通常更昂贵,也更难以正确实施。第二,下游分析 会因分辨率提高而更加复杂,也更容易得出错误结论。
单细胞实验大体遵循与 bulk RNA-Seq 实验相似的步骤(见上文),但需要作出若干调整。与 bulk 测序一样,单细胞测序也需要裂解、逆转录、扩增,并最终完成测序。此外,单细胞测序还需要分离细胞,将其置于更小的独立反应室中,或采用其他形式的细胞标记,以便日后将获得的转录组映射回来源细胞。大多数单细胞 Assay 的差异也正体现在这些环节:细胞分离、转录本扩增,以及随测序仪而异的测序步骤。但在深入讲解单细胞 RNA 测序之前,必须先理解在如此精细的分辨率下测量 信使 RNA(messenger RNA, mRNA) 时会遇到的生物学与技术挑战。
基因表达定量
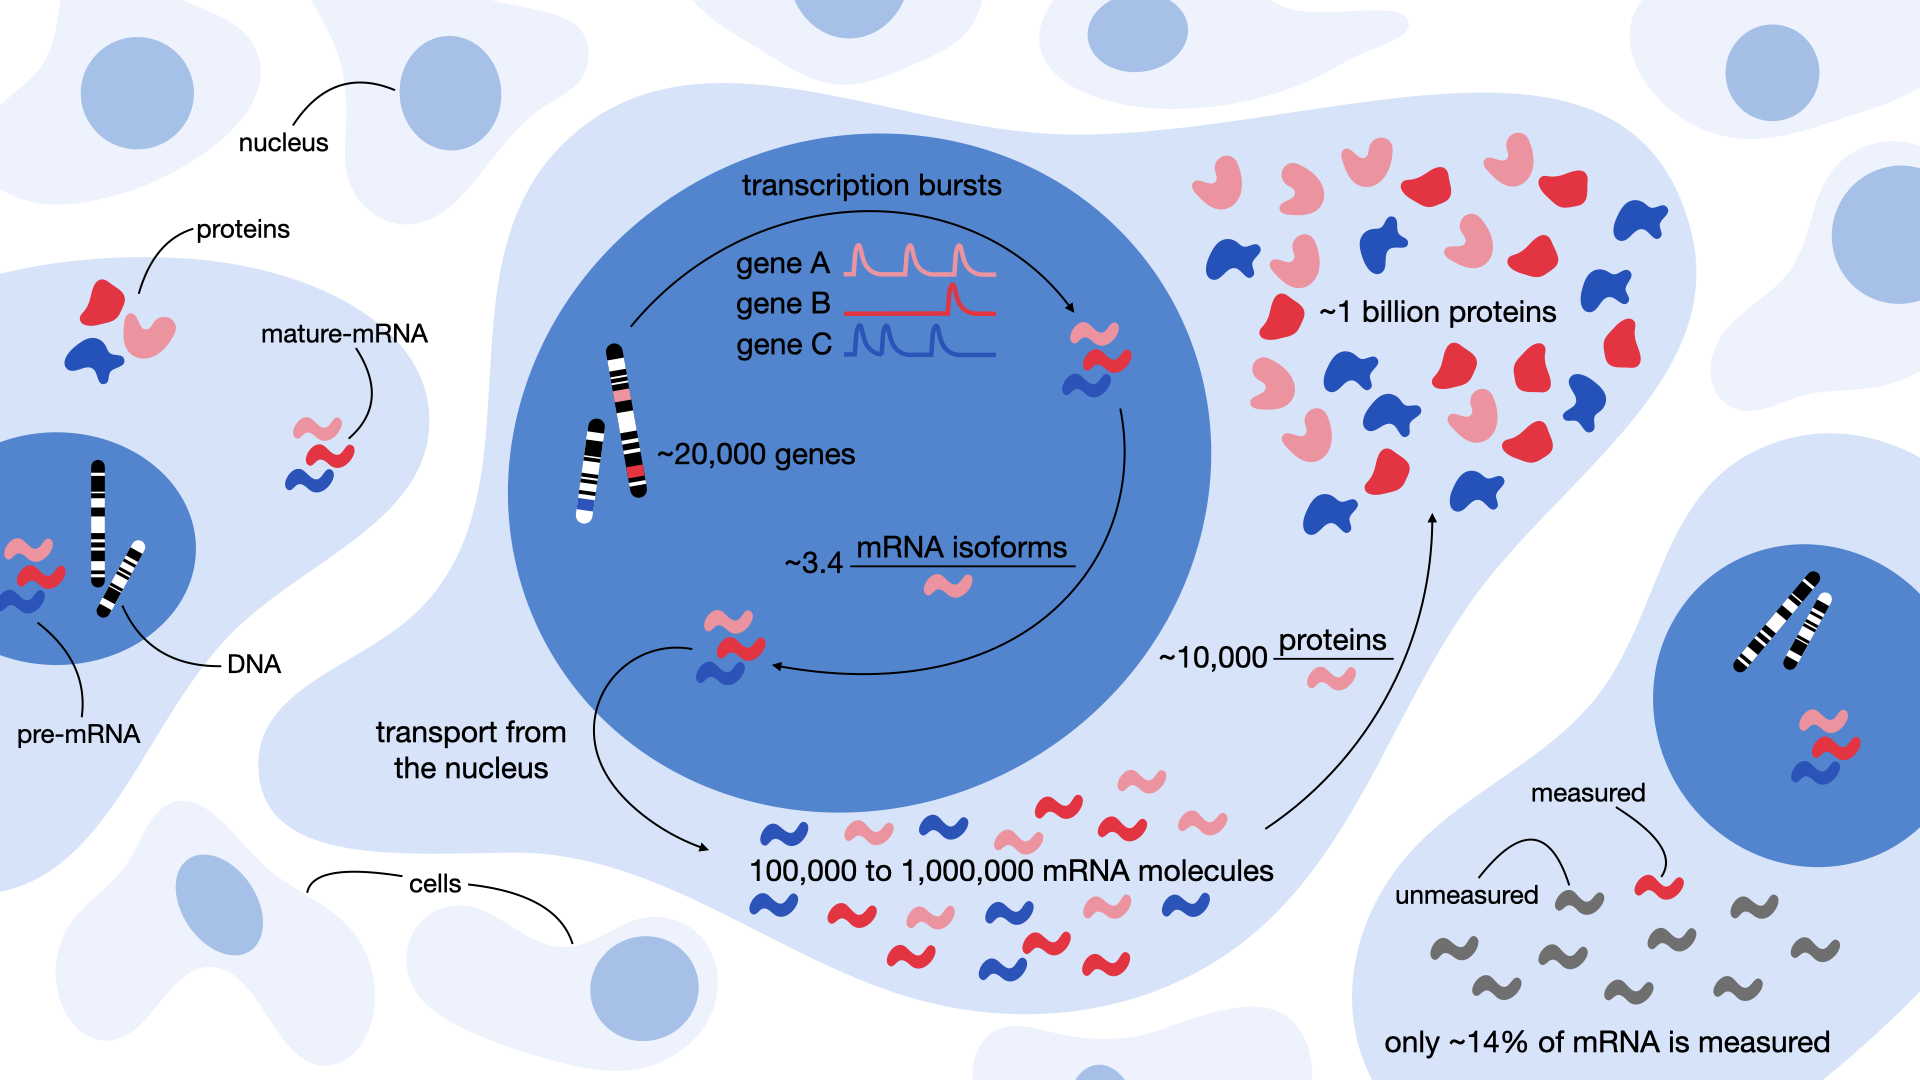
图 2:从转录爆发(transcriptional burst)到蛋白质合成,对基因表达进行定量。这些数值只是近似值,意在给出大致印象,可能因具体情境或随时间而有所不同。
测量“信使”
scRNA-Seq 的核心是一个根本性的问题:我们想测量的到底是 什么?在 RNA-seq 实验中,我们关注的是对单细胞内的 mRNA 进行定量。正如 Brenner、Jacob 和 Meselson 在 1961 年所描述的,这种分子是“一种不稳定的中间体,将信息从基因传递到核糖体以合成蛋白质”,他们也由此创造了“信使(messenger)”一词 Brenner et al., 1961。因此,mRNA 是连接 DNA 与蛋白质合成的关键纽带。然而,mRNA 只占细胞总 RNA 的一小部分。大约 3–7% 的 RNA 质量为 mRNA,而绝大多数是非编码 RNA(non-coding RNA, ncRNA):80–90% 为核糖体 RNA(ribosomal RNA, rRNA),10–15% 为 tRNA,约 1% 为其他非编码 RNA Palazzo & Lee, 2015 (非编码 RNA 概览)。据估计,一个典型的哺乳动物细胞中约含有 10 万到 100 万个 mRNA 分子,可覆盖多达约 50% 的基因 Velculescu et al., 1999Islam et al., 2014。这意味着在任何给定细胞中,都有相当一部分基因完全没有被转录——这反映了该细胞特定的身份与功能。然而,当前 scRNA-seq 技术的局限性进一步增加了测量难度。例如,10x Genomics 等主流平台每次运行最多只能捕获 65% 的细胞,且每个细胞仅能回收约 14% 的 mRNA AlJanahi et al., 2018。这些限制使低表达基因尤其难以检出。
透过这些数字来理解基因表达,不仅能揭示其生物学复杂性,也能暴露现有工具的局限(见 “基因表达定量”图)。为了更深入地体会这一点,让我们一步步从基因走到蛋白质。
从基因到蛋白质
我们的旅程从基因开始——它是 DNA 中一段特定的区域,充当 mRNA 合成的模板。尽管不同个体之间基因数目可能略有差异(约 70 个基因),但人类基因组平均约含有 22,000 个基因 Pertea & Salzberg, 2010。基因转录远非连续进行。相反,它以随机爆发的方式发生——在短暂而不规则的活跃期内,一个基因可能突然产生多条 mRNA 转录本,随后又重归沉默 Suter et al., 2011。这也是我们使用负二项分布(negative binomial distribution, NB)对 mRNA 转录建模的原因。它既能对事件计数(Count;此处指 mRNA 分子数)建模,又能刻画转录爆发造成的过度离散(overdispersion)(方差大于均值)Ren & Kuan, 2020Love, 2015。
为什么使用负二项分布?
固定区间内的事件 Count 通常用泊松分布(Poisson distribution)建模,但泊松分布只有一个参数,因此要求方差等于均值。转录爆发打破了这一假设:处于爆发期的细胞所含某基因转录本远多于爆发间歇期的细胞,因此观测到的 Count 比泊松分布所允许的更为分散。
如果允许泊松分布的发生率在细胞间变化,并假定该发生率服从伽马分布(gamma distribution),就会得到负二项分布。它仍可解释为 Count 数据,同时引入第二个参数——离散度——来吸收额外的变异。
假设某基因平均每个细胞产生 5 Count。在泊松分布下,方差同样为 5,几乎所有细胞的 Count 都应落在 0 到 11 之间。真实细胞中,同一个基因却经常既出现 0 Count 的细胞,也出现 30 Count 甚至更多的细胞,因为转录爆发使部分细胞的潜在发生率很高,而另一些细胞则接近于零。离散度使模型能够把这两种情况都视为正常观测,而不会将 30 Count 判为离群值。
最初的 RNA 转录本称为前体 mRNA(precursor messenger RNA, pre-mRNA),随后会经历可变剪接(alternative splicing)——这一过程使转录本的不同区域(称为内含子(intron)和外显子(exon))能够以多种方式拼接组合。这意味着单个基因可以产生多种不同的 mRNA 异构体。平均而言,每个人类基因约产生 3.4 种 mRNA 异构体 Lee & Rio, 2015。虽然所有人类基因都至少有两种可变异构体,但有些基因则将复杂性推向了极限。例如,人类的 basonuclin 2 基因有可能产生多达 90,000 种 mRNA 异构体,进而生成 2,000 多种不同的蛋白质 Vanhoutteghem & Djian, 2007。然而在某些情况下,可变剪接也可能产生没有功能的酶,并诱发疾病状态。最后,这种“成熟”的 mRNA 被翻译成蛋白质。这里的数字同样差异巨大。在哺乳动物中,蛋白质与 mRNA 的中位数比值估计约为每条 mRNA 对应 10,000 个蛋白质 Li et al., 2014。不过,具体数值会因基因、细胞类型及其他许多因素而异,每条转录本可对应数百至近百万个蛋白质 Edfors et al., 2016。最终,这一过程使单个人体细胞中约含有 10 亿个蛋白质 Milo, 2013。
理解这些层层环节——从转录爆发、可变剪接到蛋白质翻译——凸显出基因表达并不是一条静态的通路,而是一个动态且充满概率性的系统。在单细胞分辨率下对其进行测量,既能带来深刻的洞见,也暴露出当前技术的挑战与局限。
转录本定量
转录本定量(transcript quantification)是把原始数据转换为表格的过程,表中给出每个样本(bulk 测序)或每个细胞(单细胞测序)内各基因的估计转录本 Count。有关这一计算过程的更多细节,请参见 下一章。
转录本定量主要有两种方法:全长方案(full-length protocol)和基于标签(tag-based)法。全长方案力求用 Read 均匀覆盖整条转录本,而基于标签的方案只捕获 5′ 端或 3′ 端。定量方法会显著影响可捕获的基因,因此分析人员必须清楚实验采用了哪种方法。全长测序仅适用于基于平板的方案 (见下文),其文库制备与 bulk RNA-seq 测序方法相近。全长方案并不总能实现对转录本的均匀覆盖,因此基因体上某些特定区域仍可能存在偏差。全长方案的一大优势在于,它们能够检测剪接变体。
基于标签的方案只对转录本的 3′ 端或 5′ 端进行测序,代价是无法(或不一定能)覆盖完整的基因长度,因此难以将 Read 明确归属于某条转录本,也难以区分不同的异构体 Archer et al., 2016。然而,它支持使用唯一分子标识符(unique molecular identifier, UMI),有助于校正转录本扩增过程中产生的偏差。
转录本扩增过程是任何 RNA-seq 测序运行中的关键步骤,用以确保转录本足够丰富,便于进行质量控制和测序。在这一过程中,通常借助 PCR,会从同一个原始分子复制出多个拷贝。由于这些拷贝与原始分子无法区分,确定样本中原本存在多少分子便十分困难。UMI 是定量未经复制的原始分子的常用解决方案。
UMI 可用作分子条形码(Barcode),有时也称为随机 Barcode。这些 Barcode 是短的随机核苷酸序列,在样本中的每个分子上充当唯一标签。UMI 必须在扩增之前的文库构建阶段加入。准确识别 PCR 重复对下游分析至关重要,这样才能排除或至少意识到 扩增偏差(amplification bias) Aird et al., 2011。
扩增偏差是指某些 RNA/cDNA 序列被优先扩增,因而被更频繁地测序,最终导致 Count 偏高。它会损害基因表达分析,因为原本活性不高的基因可能突然显得高度表达。在 PCR 后期才被扩增的序列尤其容易出现这一问题,因为此时的错误率可能已明显高于 PCR 早期。虽然可以在计算上过滤比对坐标相同的 Read,以检测并去除这类序列,但只要条件允许,通常仍建议在实验设计中使用 UMI。使用 UMI 还能在不损失准确性的前提下对基因 Count 进行归一化 Kivioja et al., 2012。
单细胞测序方案
用于对单个细胞转录组进行测序的方案有很多。然而,相关术语往往含义模糊,对刚进入该领域的人来说尤其如此。为了厘清概念,我们根据细胞的分离方式,将这些技术分为两大类:
在液滴(droplet)中分离:这类方法将单个细胞包裹在乳液中的微小液滴内,从而实现高通量处理。
在物理隔室中分离:这些技术将细胞分离到各自独立的物理隔室中,这些隔室通常被称为“孔”(wells)。
每种方法在回收转录本的能力、测序的细胞数量以及许多其他方面都有所不同。在接下来的小节中,我们将简要讨论它们的工作原理、各自的优缺点,以及数据分析人员在使用相应方案时应当注意的潜在偏差。
在液滴中分离
最常用的方案
最常用的方案包括 inDrop Klein et al., 2015,Drop-seq Macosko et al., 2015 以及商业化的 10x Genomics Chromium Zheng et al., 2017。这些方案利用微流控(microfluidics)技术将细胞包裹在称为“液滴”的微小水珠中。每个液滴形成一个独立的空间,其中只包含一个细胞和所需的化学试剂(即微珠,beads)。上述方案每秒可生成数千个液滴。这种大规模并行的过程能以相对低廉的成本产生数量庞大的液滴。
尽管这三种方案在细节上各不相同,但用于包裹细胞的纳升级液滴始终被设计为同时捕获微珠和细胞。包裹过程使用专门的微珠完成,微珠上连接着引物,引物包含一个 PCR 接头、一个 Cell Barcode、一段 4–8 个碱基长的 UMI 以及一条 poly-T 尾(如果是 5′ 试剂盒,则为 poly-T 引物)。细胞裂解后,其 mRNA 会瞬间释放,并被连接在微珠上的带 Barcode 的寡核苷酸捕获。接着,收集液滴并将其打破,以释放出附着于微粒的单细胞转录组(single-cell transcriptomes attached to microparticles, STAMPs)。随后进行 PCR 和逆转录,以捕获并扩增转录本。最后进行片段化加标签(tagmentation):转录本被随机切断,并接上测序接头。如前所述,这一过程最终生成可供测序的测序文库。在基于液滴的方案中,每个细胞只有约 10% 的转录本能够被回收 Islam et al., 2014。值得注意的是,如此低的测序覆盖度也足以稳健地识别细胞类型。
这三种方法都会产生各自特有的偏差。所用微珠的材质在不同方案之间有所不同。Drop-seq 使用脆性树脂制作微珠。因此,这些微珠的包裹遵循 泊松分布,而 InDrop 和 10x Genomics 的微珠则可发生形变,因此微珠占用率超过 80% Zhang et al., 2019。
此外,捕获效率很可能还会受到 Drop-seq 所用表面连接(surface-tethered)引物的影响。inDrop 的引物通过光裂解释放,而 10x Genomics 则会溶解微珠。这一差异也会影响逆转录发生的位置:Drop-seq 在微珠离开液滴后进行逆转录,inDrop 和 10x Genomics 则在液滴内进行逆转录 Zhang et al., 2019。
Zhang 等人 2019 年的比较发现,在微珠质量方面,10x Genomics 优于 inDrop 和 Drop-seq,因为后两种系统的 Cell Barcode 存在明显错配。此外,来自有效 Barcode 的 Read 比例在 10x Genomics 中为 75%,在 inDrop 和 Drop-seq 中则分别只有 25% 和 30%。
10x Genomics 在灵敏度方面也表现出类似优势。在这项比较中,10x Genomics 平均从 3,000 个基因中捕获约 17,000 条转录本,Drop-seq 从 2,500 个基因中捕获约 8,000 条转录本,inDrop 则从 1,250 个基因中捕获约 2,700 条转录本。技术噪声以 10x Genomics 最低,其次是 Drop-seq 和 inDrop Zhang et al., 2019。
实际数据表现出明显的方案偏差。10x Genomics 更倾向于捕获和扩增较短及 GC 含量较高的基因,Drop-seq 则更偏好 GC 含量较低的基因。尽管 10x Genomics 在多个方面优于其他方案,但其每个细胞的成本也约为后者的两倍。除微珠外,Drop-seq 的其余部分均为开源,必要时更易调整方案;inDrop 则完全开源,连微珠也可在实验室中自行制造和改造。因此,inDrop 是三种方案中最灵活的一种。
👍 优势
能够以较低成本对大量细胞进行测序,从而识别组织的整体构成并刻画稀有细胞类型。
可以引入 UMI。
👎 局限性
与其他方法相比,转录本检出率较低。
只能捕获 3′ 端(或 5′ 端,取决于试剂盒),而非完整的转录本。
纳米孔测序与液滴技术的结合
长 Read 单细胞测序方法很少使用 UMI Singh et al., 2019,或者不进行 UMI 校正 Gupta et al., 2018,从而将一些 Read 错误地分配给了本不存在的 UMI。由于长读长测序仪的测序错误率较高,这会引发严重的问题 Lebrigand et al., 2020。Lebrigand 等人提出了 ScNaUmi-seq(带 UMI 的单细胞 Nanopore 测序),将 Nanopore 测序与 Cell Barcode 和 UMI 分配结合起来。Barcode 分配以 Illumina 数据为指导:将 Nanopore Read 中找到的 Cell Barcode 序列,与同一区域或基因的 Illumina Read 所恢复的 Barcode 序列进行比较 Lebrigand et al., 2020。然而,这实际上需要两个单细胞文库。ScCOLOR-seq 在全 Barcode 长度上使用核苷酸对互补,在计算中识别无错误的 Barcode。然后将这些 Barcode 用作指南,以纠正剩余的错误 Barcode Philpott et al., 2021。一种改进的、基于 UMI-tools 有向网络的方法可校正 UMI 序列的重复。
👍 优势
可恢复剪接和序列异质性信息
👎 局限性
Nanopore 试剂昂贵。
高 Cell Barcode 回收误差率。
根据方案,Barcode 分配以 Illumina 数据为指导,需要两个测序 Assay。
在物理隔室中分离
基于平板的方案
基于平板的方案通常会把细胞逐一分配到微孔板中。第一步是细胞分选,例如通过荧光激活细胞分选(fluorescence-activated cell sorting, FACS)按特定的细胞表面标志物进行分选,或通过显微移液完成。随后将选中的细胞分别放入含细胞裂解缓冲液的孔中,并在孔内进行逆转录。这样,一次实验可分析数百个细胞,每个细胞可捕获 5,000 至 10,000 个基因。
基于平板的测序方案包括但不限于 SMART-seq2、MARS-seq、QUARTZ-seq 和 SRCB-seq。总体而言,这些方案在多重标记(multiplexing)能力上有所不同。例如,MARS-seq 支持分子级、细胞级和平板级三种 Barcode 层级,具备强大的多重标记能力;相反,SMART-seq2 不支持早期多重标记,从而限制了细胞数量。Mereu 等人在 2020 年对各方案进行的系统比较表明,就每个细胞而言,QUARTZ-seq2 能比 SMART-seq2、MARS-seq 或 SRCB-seq 捕获更多基因 Mereu et al., 2020。这意味着 QUARTZ-seq2 能够很好地捕获细胞类型特异的标记基因,从而能够可靠地进行细胞类型注释。
👍 优势
每个细胞可回收大量基因,从而进行深入的刻画。
可以在文库制备前收集信息,例如通过 FACS 分选,把细胞大小、所用标记物的强度等信息与准确的孔位坐标关联起来。
可实现全长转录本的回收。
👎 局限性
基于平板的实验规模,受限于其单个处理单元较低的通量。
片段化步骤会丢失链特异性信息 Hrdlickova et al., 2017。
视具体方案而定,基于平板的方案可能属于劳动密集型,需要大量移液步骤,从而可能带来技术噪声以及 批次效应(batch effect)。
Fluidigm C1
商用的 Fluidigm C1 系统是一种微流控芯片,能以自动化方式将细胞加载并分离到小型反应室中。CEL-seq2 和 SMART-seq(第 1 版)方案在其工作流程中使用 Fluidigm C1 芯片,使 RNA 提取和文库制备步骤得以一并完成,从而减少所需的人工操作。不过,Fluidigm C1 要求细胞混合物相当均一,因为细胞会依据其大小到达微流控芯片上的不同位置,这可能引入潜在的位置偏差。由于扩增步骤在各个孔中单独进行,因此可以实现全长测序,有效降低了许多其他单细胞 RNA-seq 测序方案存在的 3′ 端偏差。该方案总体上也较为昂贵,因此主要适用于对特定细胞群体进行深入细致的考察。
👍 优势
可实现对全长转录本的覆盖。
可恢复剪接变体及 T/B 细胞受体库的多样性。
👎 局限性
只能对最多 800 个细胞进行测序 Fluidigm, 2022。
单个细胞的成本高于其他方案。
只能捕获约 10% 的提取细胞,因此不适用于稀有细胞类型或低起始量样本。
所使用的阵列只能捕获特定大小的细胞,这可能使所捕获的转录本产生偏差。
小结
总之,我们强烈建议湿实验与干实验研究人员根据研究目的选择测序方案。如果目标是深入刻画某一特定细胞群体,基于平板的方法可能更合适;相反,基于液滴的 Assay 更善于捕获异质性混合样本,因而能够更广泛地刻画所测序的细胞。如果预算有限,还应选择成本效益更高且更稳健的方案。分析数据时,务必留意不同测序 Assay 特有的偏差。如需全面比较各类单细胞测序方案,我们推荐 Mereu 等人的论文《Benchmarking single-cell RNA-sequencing protocols for cell atlas projects》Mereu et al., 2020。
单细胞与单细胞核
到目前为止,我们只讨论了单细胞 Assay,但也可以进行单细胞核 RNA 测序(single-nucleus RNA sequencing, snRNA-seq)。对于某些组织或器官(例如大脑),单细胞分析并不总能呈现无偏的细胞类型图景。在组织解离过程中,一些细胞类型较为脆弱,因而难以捕获。例如,在小鼠新皮层中,快速放电的小白蛋白阳性(parvalbumin-positive)中间神经元和向皮层下投射的谷氨酸能神经元,其观测比例就低于预期 Tasic et al., 2018。相反,非神经元细胞比神经元更能耐受解离,因而在成年人新皮层的单细胞悬液中占比偏高 Darmanis et al., 2015。此外,单细胞测序高度依赖新鲜组织,使得组织生物库难以派上用场。另一方面,细胞核对机械力的耐受性更强,可以在不使用组织解离酶的情况下,从冷冻组织中安全地分离出来 Krishnaswami et al., 2016。这两种方案对不同组织和样本类型的适用性各异,由此产生的偏差与不确定性仍未完全厘清。不过已有研究表明,细胞核能够准确反映细胞的整体转录模式 Ding et al., 2020。实验设计选择单细胞还是单细胞核测序,主要取决于组织样本类型。但在数据分析时必须注意,组织解离难易程度会显著影响可观测到的细胞类型。因此,我们强烈建议湿实验与干实验研究人员共同讨论实验设计。
另见
为了更深入地了解这些 Assay,我们推荐以下论文:
单细胞 RNA 测序方法的比较分析 Ziegenhain et al., 2017
单细胞 RNA 测序实验的功效分析 Svensson et al., 2017
在匹配的皮质细胞类型中比较单核与单细胞转录组 Bakken et al., 2018
单细胞 RNA 测序研究的实验设计指南 Lafzi et al., 2018
针对细胞图谱项目的单细胞 RNA 测序方案基准评测 Mereu et al., 2020
10x Genomics Chromium 与 Smart-seq2 的直接比较分析 Wang et al., 2021
实验室方法视频:
其他:
选择题
- Jou, W. M., Haegeman, G., Ysebaert, M., & Fiers, W. (1972). Nucleotide Sequence of the Gene Coding for the Bacteriophage MS2 Coat Protein. Nature, 237(5350), 82–88. 10.1038/237082a0
- Hood, L. E., Hunkapiller, M. W., & Smith, L. M. (1987). Automated DNA sequencing and analysis of the human genome. Genomics, 1(3), 201–212. 10.1016/0888-7543(87)90046-2
- Jain, M., Olsen, H. E., Paten, B., & Akeson, M. (2016). The Oxford Nanopore MinION: delivery of nanopore sequencing to the genomics community. Genome Biology, 17(1), 239. 10.1186/s13059-016-1103-0
- Roche. (2025). Sequencing by expansion (SBX) technology. https://sequencing.roche.com/global/en/article-listing/sequencing-platform-technologies.html
- Logsdon, G. A., Vollger, M. R., & Eichler, E. E. (2020). Long-read human genome sequencing and its applications. Nature Reviews Genetics, 21(10), 597–614. 10.1038/s41576-020-0236-x
- Brenner, S., Jacob, F., & Meselson, M. (1961). An unstable intermediate carrying information from genes to ribosomes for protein synthesis. Nature, 190, 576–581. 10.1038/190576a0
- Palazzo, A. F., & Lee, E. S. (2015). Non-coding RNA: what is functional and what is junk? Frontiers in Genetics, 6, 2. 10.3389/fgene.2015.00002
- Velculescu, V. E., Madden, S. L., Zhang, L., Lash, A. E., Yu, J., Rago, C., Lal, A., Wang, C. J., Beaudry, G. A., Ciriello, K. M., & others. (1999). Analysis of human transcriptomes. Nature Genetics, 23(4), 387–388. 10.1038/70487
- Islam, S., Zeisel, A., Joost, S., La Manno, G., Zajac, P., Kasper, M., Lönnerberg, P., & Linnarsson, S. (2014). Quantitative single-cell RNA-seq with unique molecular identifiers. Nature Methods, 11(2), 163–166. 10.1038/nmeth.2772
- AlJanahi, A. A., Danielsen, M., & Dunbar, C. E. (2018). An introduction to the analysis of single-cell RNA-sequencing data. Molecular Therapy Methods & Clinical Development, 10, 189–196. 10.1016/j.omtm.2018.07.003
- Pertea, M., & Salzberg, S. L. (2010). Between a chicken and a grape: estimating the number of human genes. Genome Biology, 11, 1–7. 10.1186/gb-2010-11-5-206
- Suter, D. M., Molina, N., Gatfield, D., Schneider, K., Schibler, U., & Naef, F. (2011). Mammalian genes are transcribed with widely different bursting kinetics. Science, 332(6028), 472–474. 10.1126/science.1198817
- Ren, X., & Kuan, P.-F. (2020). Negative binomial additive model for RNA-Seq data analysis. BMC Bioinformatics, 21, 1–15.
- Love, M. (2015). Deseq2: RNA-seq and Negative binomial distribution. https://support.bioconductor.org/p/74572/
- Lee, Y., & Rio, D. C. (2015). Mechanisms and regulation of alternative pre-mRNA splicing. Annual Review of Biochemistry, 84(1), 291–323. 10.1146/annurev-biochem-060614-034316