🧠 关键要点
⚙️ 环境设置
安装 conda:
在创建环境之前,请确保 conda 已安装在您的系统中。
保存 yml 内容:
将 yml 选项卡中的内容复制到名为
environment.yml。
创建环境:
打开终端或命令提示符。
运行以下命令:
conda env create -f environment.yml
激活环境:
创建好环境后,使用以下命令激活它:
conda activate <environment_name>请将
<environment_name>替换为environment.yml文件中指定的环境名称。该名称在 yml 文件中如下所示:name: <environment_name>
验证安装:
通过运行以下命令,检查环境是否创建成功:
conda env list
name: integration
channels:
  - conda-forge
  - bioconda
  - defaults
dependencies:
  - conda-forge::python=3.11
  - conda-forge::ipykernel=7.1.0
  - conda-forge::jupyterlab=4.5.1
  - conda-forge::scanpy=1.11.5
  - bioconda::anndata2ri=2.0
  - bioconda::bioconductor-singlecellexperiment=1.28.0
  - igraph=1.0.1
  - pip=25.3
  - python-igraph=1.0.0
  - conda-forge::r-base=4.4.3
  - r-sessioninfo=1.2.3
  - r-seurat=5.4.0
  - r-spatstat=3.5_0
  - rpy2=3.6.4
  - scikit-learn=1.8.0
  - scikit-misc=0.5.2
  - scvi-tools=1.4.1
  - session-info=1.0.0
  - pip:
      - scib==1.1.7
      - lamindb
      - bbknn
🗄️ 获取数据和笔记本
本书使用 lamindb 来存储、共享和加载数据集与笔记本,所用实例为 theislab/sc-best-practices 实例。我们感谢以下平台提供的免费托管:Lamin Labs。
安装 lamindb
安装 lamindb Python 软件包:
pip install lamindb可选择创建 Lamin 账户
请按照 相关说明注册并登录
验证你的设置
运行
lamin connect命令:
import lamindb as ln

ln.Artifact.connect("theislab/sc-best-practices").df()
你现在应该能看到最多 100 个已存储的数据集。
访问数据集(Artifact)
在以下页面搜索数据集:Artifacts 页面
加载一个 Artifact 及其对应的对象:
import lamindb as ln
af = ln.Artifact.connect("theislab/sc-best-practices").get(key="key_of_dataset", is_latest=True)
obj = af.load()
该对象现在已可在内存中访问,并可用于分析。请调整
lamindb.Artifact.connect("theislab/sc-best-practices").get("SOMEIDXXXX")后缀,以获取相应版本。访问笔记本(Transform)
在以下页面搜索笔记本:Transforms 页面
加载笔记本:
lamin load <notebook url>该命令会将笔记本下载到当前工作目录。与
Artifacts类似,你也可以调整后缀 ID 来获取旧版本。
研究动机
在大多数单细胞 RNA 测序(Single-Cell RNA Sequencing, scRNA-seq)数据分析中,批次效应(batch effect)都是一项核心挑战。批次效应是指细胞被分成不同组(即“批次(batch)”)处理后,测得的表达水平随之发生变化。例如,两个实验室即使从同一队列采集样本,若采用不同的解离方式,也可能产生批次效应。假设实验室 A 优化了解离方案,在解离样本细胞的同时尽量减轻应激,而实验室 B 没有,那么 B 组数据中的细胞很可能表达更多应激相关基因(JUN、JUNB、FOS 等,见 Brink et al., 2017),即使这些细胞在原始组织中本来具有相同的表达谱。一般来说,批次效应的来源多种多样,也难以查明。一些批次效应来源可能是技术性的,例如样品处理方式、实验方案或 测序 深度;而供体差异、组织来源或采样位置等生物学效应,也经常被视为批次效应 Luecken et al., 2021。生物学因素是否应视为批次效应,取决于实验设计和研究问题。去除批次效应对于联合分析至关重要:它使分析能够聚焦不同批次共有的数据结构,并支持跨数据集查询。通常,只有去除这些效应之后,才能识别此前被批次差异掩盖的稀有细胞群。跨数据集查询还使我们能够回答单独分析各数据集时无法回答的问题,例如 哪些细胞类型表达 SARS-CoV-2 的侵入因子?这种表达在个体之间又有何差异? Muus et al., 2021。
在从组学数据中去除批次效应时,必须做出两个核心选择:(1) 方法及其参数设置;(2) 批次协变量(covariate)。由于批次效应可能在不同层级(即样本、供体、数据集等)的细胞分组之间产生,批次协变量的选择决定了应保留哪一层级的变异、去除哪一层级的变异。批次分辨率越精细,被去除的效应就越多;然而,精细的批次变异也更可能与有生物学意义的信号相混淆。例如,样本通常来自不同的个体或组织的不同位置,这些效应也许值得研究。因此,批次协变量的选择将取决于你整合任务的目标:你想看到个体之间的差异,还是更关注细胞类型内部的共同变异?最近一项构建人类肺脏整合图谱的工作率先采用了一种基于定量分析的批次协变量选择方法,利用可归因于不同技术协变量的方差来做出这一选择 Sikkema et al., 2022。
整合模型的类型
scRNA-seq 批次效应去除方法通常包含至多三个步骤:
降维(dimensionality reduction)
对批次效应建模并将其去除
投影回高维空间
对批次效应建模并将其去除(步骤 2)是所有批次去除方法的核心;不过,许多方法会先把数据投影到低维空间(步骤 1),以提高信噪比(signal-to-noise ratio, SNR)(见 降维章节),再在该空间中执行批次校正(batch correction),以获得更好的性能(见 Luecken et al., 2021)。在第三步中,方法可以在去除拟合出的批次效应后,把数据投影回原始高维特征(feature)空间,从而输出经过批次校正的基因表达矩阵。
批次效应去除方法在上述三个步骤中都可能有所不同:它们可以采用不同的线性或非线性降维方法、线性或非线性批次效应模型,并输出不同格式的批次校正数据。总体而言,批次效应去除方法可按出现顺序分为四类:全局模型、线性嵌入(embedding)模型、图方法和深度学习(deep learning, DL)方法(图 I1)。
全局模型 源自 bulk 转录组学,将批次效应建模为所有细胞中一致的效应(加性、乘性或二者兼有)。常见例子是 ComBat Johnson et al., 2007。
线性嵌入模型 是最早专为单细胞数据设计的批次去除方法。这类方法通常使用奇异值分解(Singular Value Decomposition, SVD)的某种变体嵌入数据,再在嵌入空间中寻找不同批次间相似细胞的局部邻域,据此以局部自适应(非线性)方式校正批次效应。方法往往利用 SVD 载荷把数据投影回基因表达空间,但也可能只输出校正后的嵌入。这是最常见的一类方法,代表性例子包括开创性的互最近邻(Mutual Nearest Neighbors, MNN)方法 Haghverdi et al., 2018(该方法不执行降维)、Seurat 整合 Butler et al., 2018Stuart et al., 2019、Scanorama Hie et al., 2019、FastMNN Haghverdi et al., 2018 和 Harmony Korsunsky et al., 2019。
图方法 通常运行得最快。这类方法用近邻图(nearest-neighbor graph)表示各批次数据,通过强制连接不同批次的细胞来校正批次效应,再修剪这些强制边,以容纳各批次细胞类型组成的差异。其中最具代表性的方法是批次均衡 K 近邻(Batch-Balanced K-Nearest Neighbors, BBKNN)方法 Polański et al., 2019。
深度学习方法 是最新、也最复杂的批次效应去除方法,通常需要最多的数据才能取得良好性能。大多数深度学习整合方法基于自编码器网络(autoencoder network):要么在条件变分自编码器(Conditional Variational Autoencoder, CVAE)中,让降维以批次协变量为条件;要么在嵌入空间中拟合局部线性校正。DL 方法的代表性例子包括 单细胞变分推断(single-cell variational inference, scVI) Lopez et al., 2018,单细胞注释变分推断(single-cell annotation using variational inference, scANVI) Xu et al., 2021 和 scGen Lotfollahi et al., 2019。
有些方法可以利用细胞身份标签,为方法提供一个参考,告诉它哪些生物学变异不应作为批次效应被去除。由于批次效应去除通常是一项预处理任务,这类方法可能并不适用于许多整合场景,因为在这一阶段通常还没有标签可用。
有关批次效应去除方法的更详细综述,参见 Argelaguet et al., 2021 和 Luecken et al., 2021。
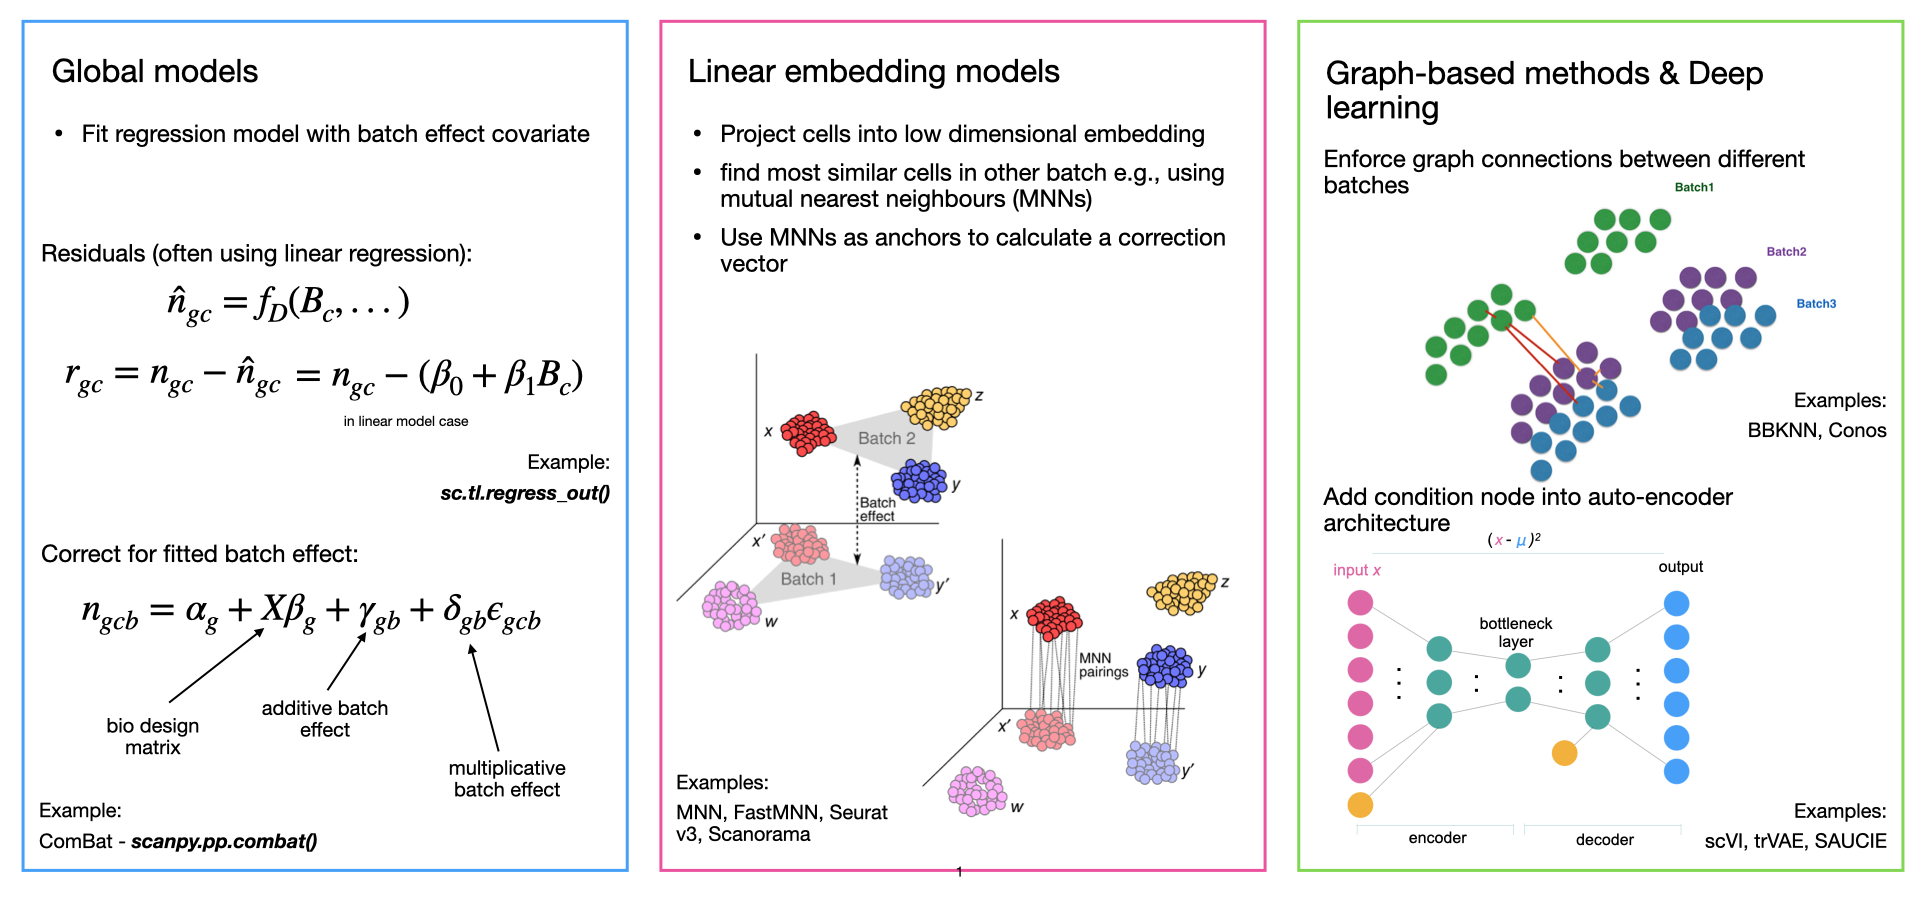 图 I1:不同类型整合方法的概览及示例。
批次去除的复杂性
scRNA-seq 数据中批次效应的去除,此前被分为两个子任务:批次校正和数据整合(data integration)Luecken & Theis, 2019。这两个子任务在所需去除的批次效应的复杂程度上有所不同。批次校正方法处理的是同一实验中各样本之间的批次效应,此时细胞身份的构成是一致的,效应往往近似线性。相比之下,数据整合方法处理的是数据集之间复杂的、往往是嵌套的批次效应——这些数据集可能用不同的实验方案生成,细胞身份也未必在各批次间共享。虽然我们在此对二者加以区分,但值得注意的是,在一般用法中这两个术语常常被混用。鉴于复杂程度上的差异,不同方法在这两个子任务上分别被评测为最优,也就不足为奇了。
数据整合方法的比较
此前已有若干基准测试评估过批次校正和数据整合方法的性能。在去除批次效应时,方法可能会过度校正,把有意义的生物学变异连同批次效应一起去除。正因如此,评估整合性能时必须同时考虑批次效应的去除程度与生物学变异的保留程度。
该 K 近邻批次效应检验(k-nearest-neighbor batch-effect test, kBET)是首个量化 scRNA-seq 数据批次校正效果的指标 Büttner et al., 2019。使用 kBET 后,作者发现 ComBat 在以全局模型为主的比较中优于其他批次校正方法。在此基础上,近期两项基准测试 Tran et al., 2020 和 Chazarra-Gil et al., 2021 还在批次较少、或生物学复杂度较低的批次校正任务上,对线性嵌入模型和深度学习模型进行了评测。这些研究发现,线性嵌入模型 Seurat Butler et al., 2018Stuart et al., 2019 和 Harmony Korsunsky et al., 2019 在简单的批次校正任务上表现良好。
由于数据集的规模和数量,以及场景的多样性,对复杂整合任务做基准测试会带来额外的挑战。最近,一项大型研究使用 14 个指标,在 5 个 RNA 任务和 2 个模拟上,对涵盖各整合方法类别的 16 种方法进行了评测 Luecken et al., 2021。虽然表现最好的方法因任务而异,但利用了细胞类型标签的方法在各项任务中总体表现更好。此外,深度学习方法 scANVI(使用标签)、scVI 和 scGen(使用标签),以及线性嵌入模型 Scanorama,表现最佳,尤其是在复杂任务上;而 Harmony 在复杂度较低的任务上表现良好。另一项专门整合视网膜数据集、构建 眼部巨型图谱(ocular mega-atlas)的类似基准测试也发现 scVI 优于其他方法 Swamy et al., 2021。
选择整合方法
尽管整合方法如今已经过广泛的基准测试,但并不存在适用于所有场景的最优方法。一些整合性能指标与评估流程的工具包,例如 单细胞整合基准评估(single-cell integration benchmarking, scIB) 和 batchbench 可用于在你自己的数据上评估整合性能。不过,许多指标(尤其是衡量生物学变异保留程度的那些)需要真实的(ground-truth)细胞身份标签。参数优化或许能把许多方法调到适用于特定任务,但总体而言可以说,Harmony 和 Seurat 在简单批次校正任务上一直表现良好,而 scVI,scGen,scANVI 和 Scanorama 在更复杂的数据整合任务上表现良好。选择方法时,建议优先考虑这些选项。此外,Open Problems 提供了基准测试平台,其中包括一个排行榜,汇总了批次整合等各类任务的结果 Luecken et al., 2025。
此外,整合方法的选择还可能取决于所需的输出数据格式(即:你需要的是校正后的基因表达数据,还是一个整合后的嵌入就够了?)。比较稳妥的做法是,在选定某种方法之前,先测试多种方法,并依据对“成功”的量化定义来评估其输出。关于如何选择数据整合方法的详尽指南,可参见 Luecken et al., 2021。
在本章余下的部分中,我们会演示几种表现最好的方法,并简要展示如何评估整合性能。
让我们静默一些不会影响代码的警告:
import warnings

# This looks for any warning containing this specific text
warnings.filterwarnings("ignore", message=".*encoding metadata.*")
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.simplefilter(action="ignore", category=FutureWarning)
warnings.filterwarnings(
    "ignore", message=".*The default of observed=False is deprecated.*"
)
现在来设置环境:
# Python packages
import anndata2ri
import bbknn
import lamindb as ln
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import scanpy as sc
import scib
import scvi

# R interface

%load_ext rpy2.ipython
anndata2ri.set_ipython_converter()

assert ln.setup.settings.instance.slug == "theislab/sc-best-practices"

ln.track("0VP4jDUT9P3E")
The rpy2.ipython extension is already loaded. To reload it, use:
%reload_ext rpy2.ipython
→ loaded Transform('0VP4jDUT9P3E0000', key='integration.ipynb'), re-started Run('zYZOfUIlcXImvYWR') at 2026-02-16 19:19:58 UTC
→ notebook imports: anndata2ri==2.0 bbknn==1.6.0 lamindb==2.0.1 matplotlib==3.10.8 numpy==2.3.5 pandas==2.3.3 scanpy==1.11.5 scib==1.1.7 scvi-tools==1.4.1 session-info==1.0.0
当前的环境依赖被固定在较旧版本的 Python 和 Scanpy 上,以保证与 BBKNN 的兼容性。在即将把 BBKNN 整合进 Scanpy 库之后,计划进行一次版本升级。
%%R
# R packages
library(Seurat)数据集
我们用来演示数据整合的数据集包含若干骨髓单核细胞样本。这些样本源自 Open Problems in Single-Cell Analysis 的 2021 年 NeurIPS 竞赛 Luecken et al., 2022Lance et al., 2022。10x Multiome 方案能够在同一批细胞中同时测量 RNA 表达(scRNA-seq)和单细胞转座酶可及染色质测序(single-cell assay for transposase-accessible chromatin using sequencing, scATAC-seq)信号。我们这里使用的数据版本已经过预处理,去除了低质量细胞。
让我们读入数据集,并使用 Scanpy 得到一个 AnnData 对象。
af = ln.Artifact.get(
    key="cellular_structure/openproblems_bmmc_multiome_genes_filtered.h5ad",
    is_latest=True,
)
adata_raw = af.load()
adata_raw.layers["logcounts"] = adata_raw.X
adata_raw
AnnData object with n_obs × n_vars = 69249 × 129921
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap'
layers: 'counts', 'logcounts'完整数据集包含 69,249 个细胞和 129,921 项特征的测量值。表达矩阵有两个版本:counts,其中包含原始计数值;另一个是 logcounts,其中包含归一化的对数计数(这些值也存储在 adata.X)。
该 obs 槽位包含多个变量,其中一部分在预处理(用于质量控制(quality control, QC))时计算,另一部分保存样本元数据(metadata)。这里关注的变量包括:
cell_type—— 每个细胞被注释的标签batch—— 每个细胞的测序批次
在真实的分析中,考虑更多变量会很重要,但为了让这里保持简单,我们只看这几个。
我们定义一些变量来保存这些名称,这样就能清楚地看出我们在代码中是如何使用它们的。这也有助于可复现性:因为如果出于任何原因决定修改其中之一,我们可以确保它在整个笔记本中都被一并改掉。
label_key = "cell_type"
batch_key = "batch"下面查看各批次及其细胞数。
adata_raw.obs[batch_key].value_counts()batch
s4d8 9876
s4d1 8023
s3d10 6781
s1d2 6740
s1d1 6224
s2d4 6111
s2d5 4895
s3d3 4325
s4d9 4325
s1d3 4279
s2d1 4220
s3d7 1771
s3d6 1679
Name: count, dtype: int64数据集中共有 13 个不同的批次。在这次实验中,研究者从一组供体采集了多个样本,并在不同的机构进行测序,因此这里的名称是样本编号(如“s1”)和供体(如“d2”)的组合。为简单起见,同时为了缩短计算时间,我们将选取其中三个样本来使用。
keep_batches = ["s1d3", "s2d1", "s3d7"]
adata = adata_raw[adata_raw.obs[batch_key].isin(keep_batches)].copy()
adata
AnnData object with n_obs × n_vars = 10270 × 129921
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap'
layers: 'counts', 'logcounts'在取子集、选出这些批次之后,我们还剩下 10,270 个细胞。
我们为这些特征存了两种注释,存储在 var:
feature_types——每个特征的类型(RNA 或 ATAC)gene_id——每个特征对应的基因
下面查看特征类型。
adata.var["feature_types"].value_counts()feature_types
ATAC 116490
GEX 13431
Name: count, dtype: int64可以看到,这里有超过 10 万个 ATAC 特征,但只有大约 13,000 个基因表达(“GEX”)特征。多种模态的整合是一个复杂的问题,我们将在 多模态整合(multimodal integration)章节 中介绍;因此现在我们先只取基因表达特征这一子集。我们还会做一次简单的过滤,确保没有计数全为零的特征(这是必要的,因为通过只选取部分样本,我们可能已经把所有表达某个特定特征的细胞都移除了)。
adata = adata[:, adata.var["feature_types"] == "GEX"].copy()
sc.pp.filter_genes(adata, min_cells=1)
adata
AnnData object with n_obs × n_vars = 10270 × 13431
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap'
layers: 'counts', 'logcounts'由于做了取子集,我们还需要对数据重新做归一化。这里我们只是用每个细胞的总计数做全局缩放来归一化。
adata.X = adata.layers["counts"].copy()
sc.pp.normalize_total(adata)
sc.pp.log1p(adata)
adata.layers["logcounts"] = adata.X.copy()
本章将使用该数据集演示整合。
大多数整合方法都需要一个包含所有样本的单一对象,以及一个批次变量(就像我们这里这样)。如果你的每个样本各自是一个独立对象,你可以用 anndata concat() 函数。详见 拼接教程 了解更多细节;其他生态系统也提供类似功能。
未整合数据
在进行任何整合之前,始终建议先查看原始数据。这能在一定程度上提示批次效应的大小,以及可能的成因(从而帮助判断应把哪些变量作为批次标签)。对于某些实验,如果样本本就已经重叠,它甚至可能提示并不需要整合。例如,对于来自单一实验室的小鼠或细胞系研究,这种情况并不少见——在那里,大多数导致批次效应的变量都可以被控制(也就是“批次校正”这一情形)。
正如前几章所示,我们将进行高变基因(Highly Variable Gene, HVG)选择、主成分分析(Principal Component Analysis, PCA),以及统一流形近似与投影(Uniform Manifold Approximation and Projection, UMAP)降维。
sc.pp.highly_variable_genes(adata)
sc.tl.pca(adata)
sc.pp.neighbors(adata)
sc.tl.umap(adata)
adata
AnnData object with n_obs × n_vars = 10270 × 13431
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism', 'log1p', 'hvg', 'pca', 'neighbors', 'umap'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'这会给我们的 AnnData 对象添加若干新内容。其中 var 槽现在包含了均值、离散度,以及选出的可变基因。在 obsp 槽中存放着 K 近邻图(k-nearest-neighbor graph, KNN graph)的距离和连接度(connectivities);而在 obsm 存放着 PCA 和 UMAP 的嵌入。
我们来绘制 UMAP,并按细胞身份和批次标签给点上色。如果数据集尚未被标注(这种情况很常见),我们就只能依据批次标签来看了。
adata.uns[batch_key + "_colors"] = [
    "#1b9e77",
    "#d95f02",
    "#7570b3",
]  # Set custom colours for batches
sc.pl.umap(adata, color=[label_key, batch_key], wspace=1)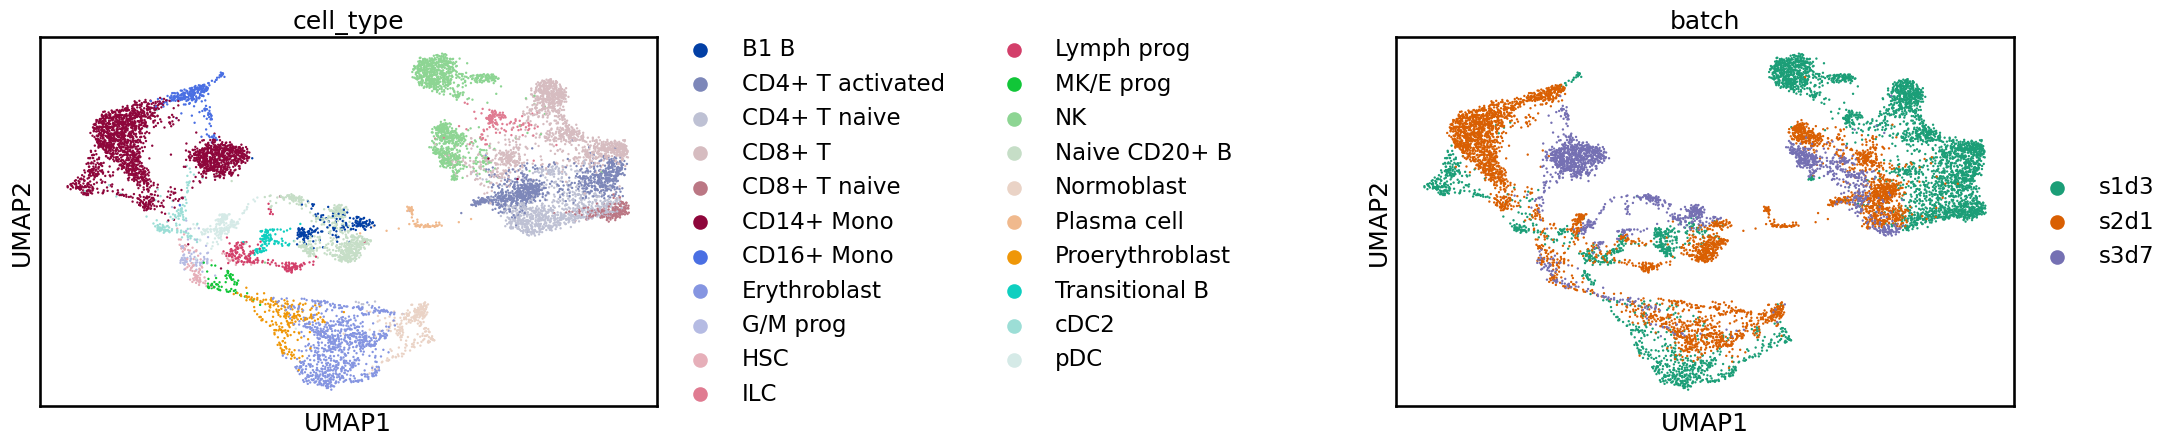
通常,在查看这些图时,你会注意到批次之间存在明显的分离。而在本例中,我们看到的情况更为微妙:虽然同一标签的细胞总体上彼此靠近,但批次之间存在一定的偏移。如果我们用这种原始数据来做聚类分析,很可能会得到一些只包含单一批次的聚类,这在注释阶段会很难解释。我们也很可能漏掉稀有细胞类型——它们在任何单个样本中都不够常见,因而无法形成自己的聚类。虽然 UMAP 常常能显示出批次效应,但在看待这些二维表示时,始终要注意不要过度解读。在真实的分析中,你应当用其他方式来确认整合效果,例如检查标记基因的分布。在下文“对你自己的整合做基准测试”一节中,我们会讨论用于量化整合质量的各种指标。
既然我们已经确认存在需要校正的批次效应,就可以着手尝试各种整合方法了。如果各批次彼此完美重叠,或者我们不做校正也能发现有意义的细胞聚类,那就没有必要进行整合。
批次感知特征选择
如 前面章节所示,为了降低噪声、缩短处理时间,我们通常会选取一部分基因用于分析。当我们有多个样本时,也采用同样的做法;不过至关重要的一点是,基因选择必须以“感知批次”(batch-aware)的方式进行。这是因为,在整个数据集上都表现出变异的基因,捕捉到的可能是批次效应,而不是我们感兴趣的生物学信号。这样做还有助于选出与稀有细胞身份相关的基因。
例如,如果某种细胞身份只存在于一个样本中,其标记基因可能不会在所有样本中都表现出变异,但应当会在该样本中出现。
我们可以通过在 Scanpy highly_variable_genes() 函数中设置 batch_key 参数,来执行批次感知的高变基因选择。Scanpy 随后会分别为每个批次计算 HVG,并通过选取“在最多批次中都高变”的那些基因来合并结果。我们这里使用 Scanpy 函数,因为它内置了对批次的感知。对于其他方法,我们就得分别在每个批次上运行,然后手动合并结果。
sc.pp.highly_variable_genes(
    adata, n_top_genes=2000, flavor="cell_ranger", batch_key=batch_key
)
adata.var我们可以看到,现在 var:
highly_variable_nbatches—— 每个基因被判定为高变的批次数目highly_variable_intersection—— 每个基因是否在每个批次中都高变highly_variable—— 在合并各批次的结果后,每个基因是否被选为高变基因
下面检查每个基因在多少个批次中具有高变性:
n_batches = adata.var["highly_variable_nbatches"].value_counts()
ax = n_batches.plot(kind="bar")
n_batches
highly_variable_nbatches
0 9931
1 1824
2 852
3 824
Name: count, dtype: int64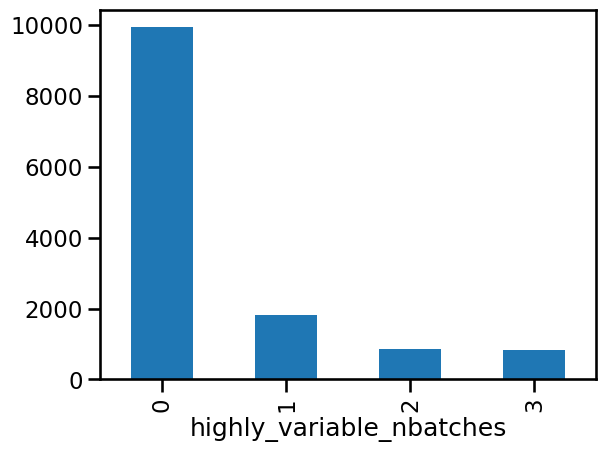
我们首先注意到,大多数基因并不是高变的。通常情况都是如此,但这也取决于我们要整合的样本之间差异有多大。随着我们加入更多样本,重叠会逐渐减少——只有相对较少的基因能在全部三个批次中都高变。通过选取前 2000 个基因,我们已经选入了所有在两个或三个批次中都出现的 HVG,以及大部分只在一个批次中出现的 HVG。
接下来创建一个仅包含所选基因的对象,用于整合。
adata_hvg = adata[:, adata.var["highly_variable"]].copy()
adata_hvg
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism', 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'batch_colors', 'cell_type_colors'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'基于变分自编码器(VAE)的整合
我们首先使用的整合方法是 scVI,它是一种基于 CVAE 的方法 Lopez et al., 2018,由 scvi-tools 软件包提供 Gayoso et al., 2022。变分自编码器(Variational Autoencoder, VAE) 是一类人工神经网络(neural network),旨在降低数据集的维度。其中“条件”指的是把这个降维过程以某个特定的协变量(这里就是批次)为条件,使得该协变量不会影响低维表示。在基准测试研究中 scVI 已被证明能在一系列数据集上都表现良好,在批次校正与保留生物学变异之间取得了不错的平衡 Luecken et al., 2021。scVI 直接对原始计数(raw counts)建模,因此我们必须向它提供一个计数矩阵(count matrix),而不是归一化后的表达矩阵。
首先复制一份数据集用于本次整合。通常并不需要复制;但由于这里要演示多种整合方法,使用副本更便于展示每种方法为对象添加了什么。
adata_scvi = adata_hvg.copy()数据准备
使用 scVI 的第一步,是准备我们的 AnnData 对象。此步骤会存储 scVI 所需的一些信息,比如要使用哪个表达矩阵、批次键(batch key)是什么。
scvi.model.SCVI.setup_anndata(adata_scvi, layer="counts", batch_key=batch_key)
adata_scvi
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker', '_scvi_batch', '_scvi_labels'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism', 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'batch_colors', 'cell_type_colors', '_scvi_uuid', '_scvi_manager_uuid'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'由 scVI 创建的字段均以 _scvi 开头。这些字段仅供内部使用,不应手动修改。scvi-tools 作者的一般建议是:在模型训练完成之前,不要改动对象。在其他数据集上,你可能会看到一条关于“输入表达矩阵包含未归一化计数数据”的警告。这通常意味着你应该检查传给 setup 函数的层是否确实包含计数值;不过,如果数值来自对全长方案数据进行的基因长度校正,或来自其他不产生整数计数的定量方法,也可能出现这条警告。
构建模型
我们现在可以构建一个 scVI 模型对象。除了我们这里使用的 scVI 模型之外,scvi-tools 软件包还包含各种其他模型(我们将使用 scANVI 模型,见下文)。
model_scvi = scvi.model.SCVI(adata_scvi)
model_scvi该 scVI 模型对象既包含所提供的 AnnData 对象,也包含模型自身的神经网络。目前该模型尚未训练。如果需要修改网络结构,可以在构造模型时传入额外参数;这里使用默认设置。
还可以打印更详细的模型说明,查看各项信息存储在关联 AnnData 对象中的什么位置。
model_scvi.view_anndata_setup()在这里,我们可以确切地看到 scVI 分配了哪些信息,包括诸如每个不同批次在模型中如何编码之类的细节。
训练模型
该模型将训练指定的训练轮次(epoch),也就是让每个细胞都通过一次网络的训练迭代。默认情况下,scVI 使用以下启发式规则来设定 epoch 数。对于少于 20,000 个细胞的数据集,会使用 400 个 epoch;当细胞数超过 20,000 之后,epoch 数会持续减少。其背后的道理是:随着网络在每个 epoch 中看到更多细胞,它能学到的信息量,与用更少细胞、更多 epoch 时学到的相当。
max_epochs_scvi = np.min([round((20000 / adata.n_obs) * 400), 400])
print(max_epochs_scvi)
400
现在我们按选定的 epoch 数训练模型(视你所用的计算机而定,这大约需要 20–40 分钟)。
model_scvi.train()输出
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
/Users/seohyon/miniconda3/envs/integration/lib/python3.11/site-packages/lightning/pytorch/trainer/connectors/data_connector.py:434: The 'train_dataloader' does not have many workers which may be a bottleneck. Consider increasing the value of the `num_workers` argument` to `num_workers=7` in the `DataLoader` to improve performance.
Epoch 400/400: 100%|██████████| 400/400 [27:37<00:00, 3.98s/it, v_num=1, train_loss=645]`Trainer.fit` stopped: `max_epochs=400` reached.
Epoch 400/400: 100%|██████████| 400/400 [27:37<00:00, 4.14s/it, v_num=1, train_loss=645]
提取嵌入
我们想从训练好的模型中提取的主要结果,是每个细胞的潜在表示(latent representation)。这是一个多维嵌入,其中批次效应已被去除;它的用法与我们分析单个数据集时使用 PCA 维度的方式类似。我们把它存到 obsm,键名为 X_scvi。
adata_scvi.obsm["X_scVI"] = model_scvi.get_latent_representation()计算批次校正后的 UMAP
现在我们像整合之前那样,把数据可视化。我们会计算一个新的 UMAP 嵌入,但这次不是在 PCA 空间里寻找最近邻,而是从校正后的表示出发——它来自 scVI。
sc.pp.neighbors(adata_scvi, use_rep="X_scVI")
sc.tl.umap(adata_scvi)
adata_scvi
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker', '_scvi_batch', '_scvi_labels'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism', 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'batch_colors', 'cell_type_colors', '_scvi_uuid', '_scvi_manager_uuid'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap', 'X_scVI'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'得到新的 UMAP 表示之后,我们就可以像之前一样,按批次和身份标签给它上色并绘图。
sc.pl.umap(adata_scvi, color=[label_key, batch_key], wspace=1)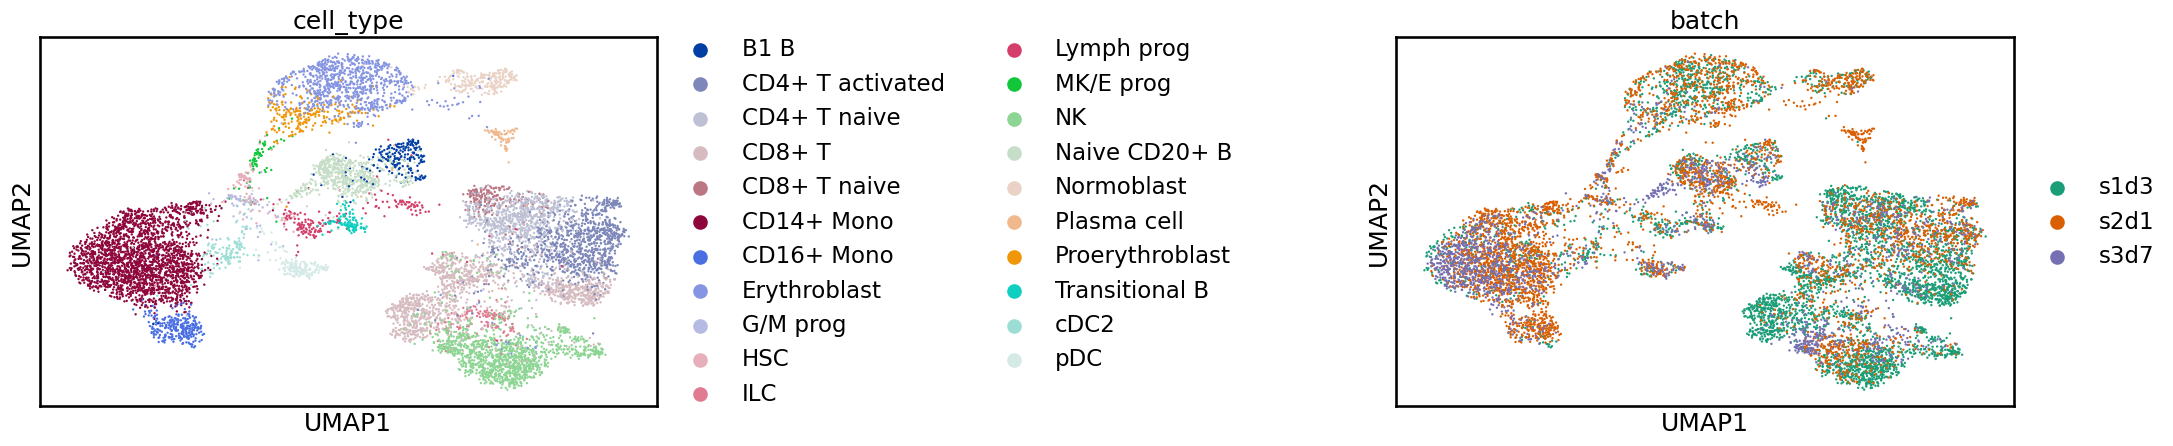
这看起来好多了!之前,各个批次彼此分离、错开;现在批次之间的重叠更多了,而且每个细胞身份标签都对应着聚成一团(blob)的点。
在很多情况下,我们本来并没有现成的身份标签,因此从这一步开始,我们会按其他章节所述,继续进行聚类、注释和后续分析。
使用细胞标签的 VAE 整合
在使用 scVI 进行整合时,我们假设事先没有任何细胞标签(尽管图中显示了这些标签)。这种情形虽然常见,但在某些情况下,我们确实预先掌握了一些细胞身份信息,最常见的场景是把一个或多个公开数据集与新研究的数据合并。当至少部分细胞已有标签时,就可以使用 scANVIXu et al., 2021。这是 scVI 模型的一个扩展,它既能纳入细胞身份标签信息,也能纳入批次信息。由于有了这份额外信息,它可以在去除批次效应的同时,尽量保留不同细胞标签之间的差异。基准测试表明,scANVI 往往能比 scVI 更好地保留生物学信号,但有时它在去除批次效应方面又没有那么有效 Luecken et al., 2021。本例中的所有细胞都有标签;在实践中,scANVI 也可以采用半监督学习(semi-supervised learning)方式,即只为部分细胞提供标签。
首先创建一个 scANVI 模型对象。请注意,由于 scANVI 是对一个已经训练好的 scVI 模型进行精炼,因此我们提供的是 scVI 模型,而不是 AnnData 对象。如果我们还没有训练过 scVI 模型,就需要先完成训练。我们还要提供一个键,指向 adata.obs,该列既包含我们的细胞标签,也包含对应于“未标注细胞”的那个标签。在本例中,我们所有细胞都有标签,因此只需提供一个占位值(dummy value)。但在大多数情况下,务必检查这一项设置是否正确,以便 scANVI 知道在训练时该忽略哪个标签。
# Normally we would need to run scVI first but we have already done that here
# model_scvi = scvi.model.SCVI(adata_scvi) etc.
model_scanvi = scvi.model.SCANVI.from_scvi_model(
    model_scvi, labels_key=label_key, unlabeled_category="unlabelled"
)
print(model_scanvi)
model_scanvi.view_anndata_setup()
这个 scANVI 模型对象,与我们之前看到的 scVI 非常相似。如前所述,我们可以修改模型网络的结构,但在这里我们只使用默认参数。
同样,对于训练 epoch 数的选择,我们也有一套启发式规则。注意,这次的 epoch 数比之前少得多,因为我们只是在微调 scVI 模型,而不是从头训练整个网络。
max_epochs_scanvi = int(np.min([10, np.max([2, round(max_epochs_scvi / 3.0)])]))
model_scanvi.train(max_epochs=max_epochs_scanvi)
输出
INFO Training for 10 epochs.
GPU available: False, used: False
TPU available: False, using: 0 TPU cores
/Users/seohyon/miniconda3/envs/integration/lib/python3.11/site-packages/lightning/pytorch/trainer/connectors/data_connector.py:434: The 'train_dataloader' does not have many workers which may be a bottleneck. Consider increasing the value of the `num_workers` argument` to `num_workers=7` in the `DataLoader` to improve performance.
Epoch 10/10: 100%|██████████| 10/10 [01:06<00:00, 6.74s/it, v_num=1, train_loss=637]`Trainer.fit` stopped: `max_epochs=10` reached.
Epoch 10/10: 100%|██████████| 10/10 [01:06<00:00, 6.61s/it, v_num=1, train_loss=637]
我们可以从模型中提取新的潜在表示,并创建新的 UMAP 嵌入,方法与以下示例相同:scVI。
adata_scanvi = adata_scvi.copy()
adata_scanvi.obsm["X_scANVI"] = model_scanvi.get_latent_representation()
sc.pp.neighbors(adata_scanvi, use_rep="X_scANVI")
sc.tl.umap(adata_scanvi)
sc.pl.umap(adata_scanvi, color=[label_key, batch_key], wspace=1)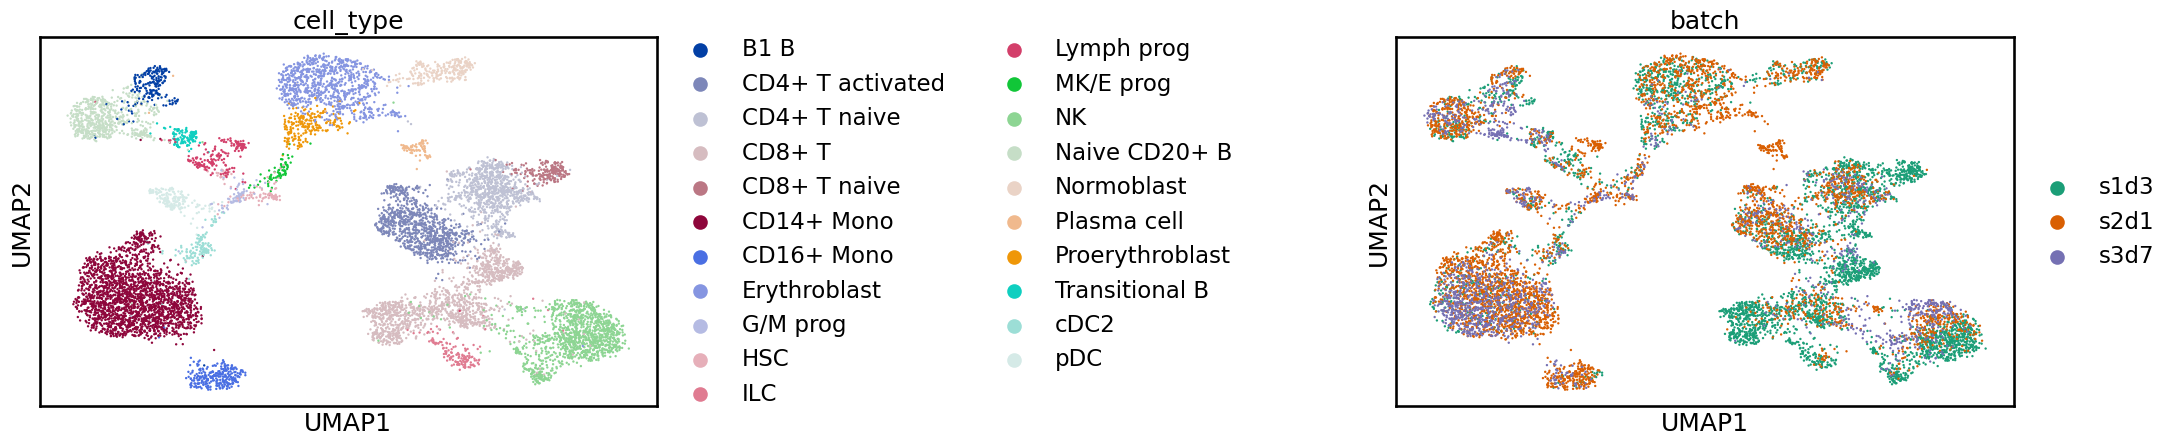
仅凭 UMAP 表示,很难分辨出 scANVI 和 scVI;但正如下文将看到的,当我们量化整合质量时,各项指标的得分存在差异。这再次提醒我们,不应过度解读这些二维表示,尤其是在比较不同方法时。
图方法整合
接下来介绍的方法是 BBKNN,即“BBKNN” Polański et al., 2019。这是一种与 scVI 截然不同的方法:它不像前面那样用神经网络把细胞嵌入到一个批次校正后的空间里,而是改变了 K 最近邻(KNN)图的构造方式——这种图用于聚类和嵌入。正如我们在 前面章节所示 中所看到的,标准的 KNN 过程会把每个细胞与整个数据集中最相似的那些细胞连接起来。而 BBKNN 所做的改变,是强制让细胞与来自其他批次的细胞相连。虽然这是一个简单的改动,但它可能相当有效,尤其是在批次效应非常强的时候。不过,由于其输出是一个整合后的图(graph),它在下游的用途比较有限,因为很少有软件包会接受它作为输入。
下面重点考虑 BBKNN 中的每批次邻居数。建议采用以下启发式规则:细胞数超过 100,000 时设为 25;少于 100,000 时使用默认值 3。
neighbors_within_batch = 25 if adata_hvg.n_obs > 100000 else 3
neighbors_within_batch3使用 BBKNN 之前,先像构建普通 KNN 图前那样执行 PCA。与 scVI(它在这里对原始计数建模)不同,我们从对数归一化(log-normalised)的表达矩阵出发。
adata_bbknn = adata_hvg.copy()
adata_bbknn.X = adata_bbknn.layers["logcounts"].copy()
sc.pp.pca(adata_bbknn)
我们现在可以运行 BBKNN,以替换对 Scanpy neighbors() 函数在标准工作流程中的调用。一个重要的区别在于要确保 batch_key 参数已设置;它指定了 adata_hvg.obs 中保存批次标签的列。
bbknn.bbknn(
    adata_bbknn, batch_key=batch_key, neighbors_within_batch=neighbors_within_batch
)
adata_bbknn
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
uns: 'ATAC_gene_activity_var_names', 'dataset_id', 'genome', 'organism', 'log1p', 'hvg', 'pca', 'neighbors', 'umap', 'batch_colors', 'cell_type_colors'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'与默认 Scanpy 函数不同,BBKNN 不允许指定用于存储结果的键,因此结果总是存储在默认的“neighbors”键下。
我们可以像使用普通 KNN 图那样,使用这个新的整合图来构建 UMAP 嵌入。
sc.tl.umap(adata_bbknn)
sc.pl.umap(adata_bbknn, color=[label_key, batch_key], wspace=1)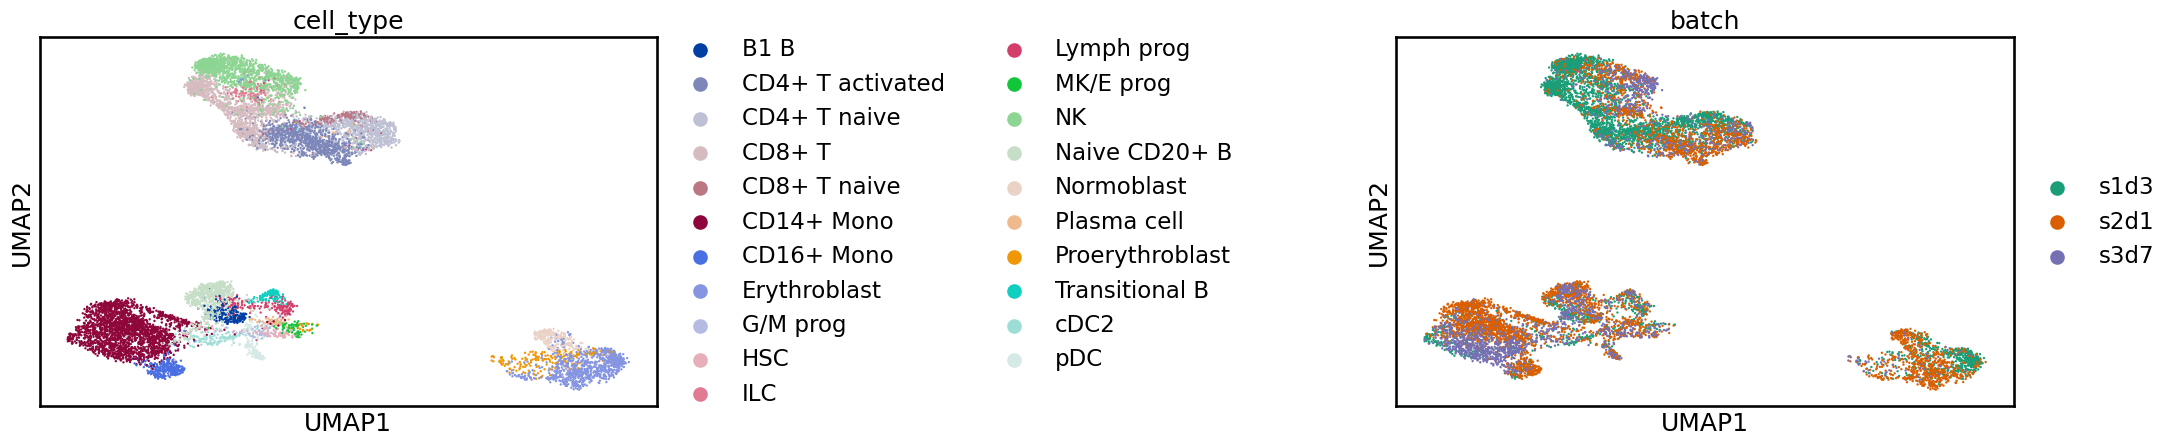
与未整合的数据相比,这次整合也有所改善:相同细胞身份的点聚到了一起,不过批次之间仍能看到一些偏移。
使用互最近邻(MNN)的线性嵌入整合
有些下游应用无法接受整合后的嵌入或邻域图,而需要校正后的表达矩阵。其中一种可生成这种输出的方法是 Seurat Satija et al., 2015Butler et al., 2018Stuart et al., 2019。Seurat 整合方法属于一类 线性嵌入模型(linear embedding model),这类模型利用了 互最近邻(Seurat 称之为 锚点(anchor))来校正批次效应 Haghverdi et al., 2018。互最近邻(mutual nearest neighbors)是指来自两个不同数据集的细胞对:当把这两个数据集放到同一个(潜在)空间中时,它们互为对方的邻居。找到这些细胞之后,就可以用它们来对齐两个数据集,并校正它们之间的差异。Seurat 在一些评估中也被发现是混合效果最好的方法之一 Tran et al., 2020。
由于 Seurat 是一个 R 包,因此我们必须把数据从 Python 转移到 R。这里我们先把 AnnData 准备好以便转换,使它能够被 rpy2 和 anndata2ri。
adata_seurat = adata_hvg.copy()
# Convert categorical columns to strings
adata_seurat.obs[batch_key] = adata_seurat.obs[batch_key].astype(str)
adata_seurat.obs[label_key] = adata_seurat.obs[label_key].astype(str)
# Delete uns as this can contain arbitrary objects which are difficult to convert
del adata_seurat.uns
adata_seurat
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts'
obsp: 'distances', 'connectivities'已经准备好的 AnnData,现在已作为一个 SingleCellExperiment 对象在 R 中可用,这要归功于 anndata2ri。注意,与 AnnData 对象相比,它是转置过来的,所以我们的观测(细胞)现在是列,而变量(基因)现在是行。
%%R -i adata_seurat
adata_seurat
class: SingleCellExperiment
dim: 2000 10270
metadata(0):
assays(3): X counts logcounts
rownames(2000): GPR153 TNFRSF25 ... TMLHE-AS1 MT-ND3
rowData names(9): feature_types gene_id ... highly_variable_nbatches
highly_variable_intersection
colnames(10270): TCACCTGGTTAGGTTG-3-s1d3 CGTTAACAGGTGTCCA-3-s1d3 ...
AGCAGGTAGGCTATGT-12-s3d7 GCCATGATCCCTTGCG-12-s3d7
colData names(28): GEX_pct_counts_mt GEX_n_counts ... QCMeds
DonorSmoker
reducedDimNames(8): ATAC_gene_activity ATAC_lsi_full ... PCA UMAP
mainExpName: NULL
altExpNames(0):
Seurat 用它自己的对象来存储数据。好在作者提供了一个从 SingleCellExperiment 转换的函数。我们只需提供这个 SingleCellExperiment 对象,并告诉 Seurat 哪些 assay(在我们的 AnnData 对象里就是 layer)包含原始计数、哪些包含归一化表达(Seurat 将其存储在名为“data”的槽中)。
%%R -i adata_seurat
seurat <- as.Seurat(adata_seurat, counts = "counts", data = "logcounts")
seurat
An object of class Seurat
2000 features across 10270 samples within 1 assay
Active assay: originalexp (2000 features, 0 variable features)
2 layers present: counts, data
8 dimensional reductions calculated: ATAC_gene_activity, ATAC_lsi_full, ATAC_lsi_red, ATAC_umap, GEX_X_pca, GEX_X_umap, PCA, UMAP
In addition: Warning messages:
1: In asMethod(object) :
  sparse->dense coercion: allocating vector of size 1.5 GiB
2: Keys should be one or more alphanumeric characters followed by an underscore, setting key from ATAC_gene_activity_ to ATACgeneactivity_
3: Keys should be one or more alphanumeric characters followed by an underscore, setting key from ATAC_lsi_full_ to ATAClsifull_
4: Keys should be one or more alphanumeric characters followed by an underscore, setting key from ATAC_lsi_red_ to ATAClsired_
5: Keys should be one or more alphanumeric characters followed by an underscore, setting key from ATAC_umap_ to ATACumap_
6: Keys should be one or more alphanumeric characters followed by an underscore, setting key from GEX_X_pca_ to GEXXpca_
7: Keys should be one or more alphanumeric characters followed by an underscore, setting key from GEX_X_umap_ to GEXXumap_
与我们见过的另一些方法不同——那些方法接收单个对象和一个批次键—— Seurat 整合函数需要一个对象列表。我们使用 SplitObject() 函数。
%%R -i batch_key
batch_list <- SplitObject(seurat, split.by = batch_key)
batch_list
$s1d3
An object of class Seurat
2000 features across 4279 samples within 1 assay
Active assay: originalexp (2000 features, 0 variable features)
2 layers present: counts, data
8 dimensional reductions calculated: ATAC_gene_activity, ATAC_lsi_full, ATAC_lsi_red, ATAC_umap, GEX_X_pca, GEX_X_umap, PCA, UMAP
$s2d1
An object of class Seurat
2000 features across 4220 samples within 1 assay
Active assay: originalexp (2000 features, 0 variable features)
2 layers present: counts, data
8 dimensional reductions calculated: ATAC_gene_activity, ATAC_lsi_full, ATAC_lsi_red, ATAC_umap, GEX_X_pca, GEX_X_umap, PCA, UMAP
$s3d7
An object of class Seurat
2000 features across 1771 samples within 1 assay
Active assay: originalexp (2000 features, 0 variable features)
2 layers present: counts, data
8 dimensional reductions calculated: ATAC_gene_activity, ATAC_lsi_full, ATAC_lsi_red, ATAC_umap, GEX_X_pca, GEX_X_umap, PCA, UMAP
现在我们可以用这个列表,为每一对数据集寻找锚点(anchors)。通常你会先识别出“感知批次”的高变基因(使用 FindVariableFeatures() 和 SelectIntegrationFeatures() 函数);但由于我们已经做过这一步,于是直接告诉 Seurat 使用对象中的所有特征。
%%R
anchors <- FindIntegrationAnchors(batch_list, anchor.features = rownames(seurat))
anchors
输出
| | 0 % ~calculating |+++++++++++++++++ | 33% ~02s |++++++++++++++++++++++++++++++++++ | 67% ~01s |++++++++++++++++++++++++++++++++++++++++++++++++++| 100% elapsed=02s
| | 0 % ~calculating |+++++++++++++++++ | 33% ~02m 30s |++++++++++++++++++++++++++++++++++ | 67% ~58s |++++++++++++++++++++++++++++++++++++++++++++++++++| 100% elapsed=02m 46s
An AnchorSet object containing 25352 anchors between 3 Seurat objects
This can be used as input to IntegrateData.
Scaling features for provided objects
Finding all pairwise anchors
Running CCA
Merging objects
Finding neighborhoods
Finding anchors
	Found 7195 anchors
Filtering anchors
	Retained 5146 anchors
Running CCA
Merging objects
Finding neighborhoods
Finding anchors
	Found 4619 anchors
Filtering anchors
	Retained 3588 anchors
Running CCA
Merging objects
Finding neighborhoods
Finding anchors
	Found 5575 anchors
Filtering anchors
	Retained 3942 anchors
Seurat 随后就可以利用这些锚点,计算一个把某个数据集映射到另一个数据集的变换。这个过程会两两进行,直到所有数据集都被合并。默认情况下,Seurat 会自动确定合并顺序,优先合并相似度较高的数据集;也可以自行指定该顺序。
%%R
integrated <- IntegrateData(anchors)
integrated
An object of class Seurat
4000 features across 10270 samples within 2 assays
Active assay: integrated (2000 features, 2000 variable features)
1 layer present: data
1 other assay present: originalexp
Merging dataset 3 into 2
Extracting anchors for merged samples
Finding integration vectors
Finding integration vector weights
0%   10   20   30   40   50   60   70   80   90   100%
[----|----|----|----|----|----|----|----|----|----|
**************************************************|
Integrating data
Warning: Layer counts isn't present in the assay object; returning NULL
Merging dataset 1 into 2 3
Extracting anchors for merged samples
Finding integration vectors
Finding integration vector weights
0%   10   20   30   40   50   60   70   80   90   100%
[----|----|----|----|----|----|----|----|----|----|
**************************************************|
Integrating data
Warning: Layer counts isn't present in the assay object; returning NULL
结果是另一个 Seurat 对象,但请注意,现在活动 assay 叫作“integrated”。它包含校正后的表达矩阵,也就是整合的最终输出。
这里我们提取该矩阵,并准备把它传回 Python。
%%R -o integrated_expr
# Extract the integrated expression matrix
integrated_expr <- GetAssayData(integrated)
# Make sure the rows and columns are in the same order as the original object
integrated_expr <- integrated_expr[rownames(seurat), colnames(seurat)]
# Transpose the matrix to AnnData format
integrated_expr <- t(integrated_expr)
print(integrated_expr[1:10, 1:10])
10 x 10 sparse Matrix of class "dgCMatrix"
TCACCTGGTTAGGTTG-3-s1d3 . -0.0005365199 1.032812e-02 -2.653187e-02
CGTTAACAGGTGTCCA-3-s1d3 0.0001382038 -0.1809919666 -1.454901e-02 3.608087e-03
ATTCGTTTCAGTATTG-3-s1d3 -0.0121073019 -0.0634131448 . 2.144075e-02
GGACCGAAGTGAGGTA-3-s1d3 . . 2.972292e-04 .
ATGAAGCCAGGGAGCT-3-s1d3 -0.0139047070 -0.0313151266 . 2.239855e-02
AGTGCGGAGTAAGGGC-3-s1d3 -0.0004299227 -0.0002657828 . -1.871410e-03
CTACCTCAGACACCGC-3-s1d3 -0.0055208619 -0.0398862165 7.182254e-06 8.240408e-03
CTTCAATTCACGAATC-3-s1d3 . -0.0109928444 . 1.935677e-04
CCATTGTGTAGACAAA-3-s1d3 . 0.0171909577 . 5.711312e-05
CCGTTACTCAATGTGC-3-s1d3 0.0139905520 0.0007981117 2.303345e-03 1.356206e-02
TCACCTGGTTAGGTTG-3-s1d3 -0.023237586 0.031938501 -0.003196878 0.01777767
CGTTAACAGGTGTCCA-3-s1d3 0.114149769 -0.013183394 0.038076742 0.80491293
ATTCGTTTCAGTATTG-3-s1d3 -0.054419899 0.010955781 -0.005951631 0.37223307
GGACCGAAGTGAGGTA-3-s1d3 0.002305526 0.011544715 0.011133475 0.02366670
ATGAAGCCAGGGAGCT-3-s1d3 -0.123505735 -0.009382413 0.002153629 -0.07013587
AGTGCGGAGTAAGGGC-3-s1d3 0.035848769 0.013858992 -0.000379393 0.05617137
CTACCTCAGACACCGC-3-s1d3 -0.003837946 0.082027593 -0.001109389 -0.06307770
CTTCAATTCACGAATC-3-s1d3 0.052970709 0.153601548 0.247920321 -0.01143158
CCATTGTGTAGACAAA-3-s1d3 -0.015445186 0.025763467 -0.003632830 0.02040172
CCGTTACTCAATGTGC-3-s1d3 -0.018025403 0.022560138 0.005755798 0.61496229
TCACCTGGTTAGGTTG-3-s1d3 -6.661644e-03 -0.0183198202
CGTTAACAGGTGTCCA-3-s1d3 5.079864e-02 0.0394717096
ATTCGTTTCAGTATTG-3-s1d3 6.600434e-02 0.0009021681
GGACCGAAGTGAGGTA-3-s1d3 7.172704e-04 0.0095352521
ATGAAGCCAGGGAGCT-3-s1d3 1.226039e-01 0.0063816141
AGTGCGGAGTAAGGGC-3-s1d3 -1.830964e-03 0.0008381943
CTACCTCAGACACCGC-3-s1d3 8.559358e-01 0.0102285084
CTTCAATTCACGAATC-3-s1d3 -5.318238e-06 -0.0341661907
CCATTGTGTAGACAAA-3-s1d3 -6.362298e-03 0.0232357004
CCGTTACTCAATGTGC-3-s1d3 -4.910884e-02 0.0317359591
[[ suppressing 10 column names ‘GPR153’, ‘TNFRSF25’, ‘TNFRSF9’ ... ]]
现在把校正后的表达矩阵作为一层(layer)存储到 AnnData 对象中,同时将 adata.X 设为该矩阵。
adata_seurat.X = integrated_expr
adata_seurat.layers["seurat"] = integrated_expr
print(adata_seurat)
adata.X
AnnData object with n_obs × n_vars = 10270 × 2000
obs: 'GEX_pct_counts_mt', 'GEX_n_counts', 'GEX_n_genes', 'GEX_size_factors', 'GEX_phase', 'ATAC_nCount_peaks', 'ATAC_atac_fragments', 'ATAC_reads_in_peaks_frac', 'ATAC_blacklist_fraction', 'ATAC_nucleosome_signal', 'cell_type', 'batch', 'ATAC_pseudotime_order', 'GEX_pseudotime_order', 'Samplename', 'Site', 'DonorNumber', 'Modality', 'VendorLot', 'DonorID', 'DonorAge', 'DonorBMI', 'DonorBloodType', 'DonorRace', 'Ethnicity', 'DonorGender', 'QCMeds', 'DonorSmoker'
var: 'feature_types', 'gene_id', 'n_cells', 'highly_variable', 'means', 'dispersions', 'dispersions_norm', 'highly_variable_nbatches', 'highly_variable_intersection'
obsm: 'ATAC_gene_activity', 'ATAC_lsi_full', 'ATAC_lsi_red', 'ATAC_umap', 'GEX_X_pca', 'GEX_X_umap', 'X_pca', 'X_umap'
varm: 'PCs'
layers: 'counts', 'logcounts', 'seurat'
obsp: 'distances', 'connectivities'
<Compressed Sparse Row sparse matrix of dtype 'float32'
	with 14348115 stored elements and shape (10270, 13431)>
现在有了整合的结果,我们就可以计算 UMAP,并像对其他方法那样把它画出来(这一步其实也可以在 R 里完成)。
# Reset the batch colours because we deleted them earlier
adata_seurat.uns[batch_key + "_colors"] = [
    "#1b9e77",
    "#d95f02",
    "#7570b3",
]
sc.tl.pca(adata_seurat)
sc.pp.neighbors(adata_seurat)
sc.tl.umap(adata_seurat)
sc.pl.umap(adata_seurat, color=[label_key, batch_key], wspace=1)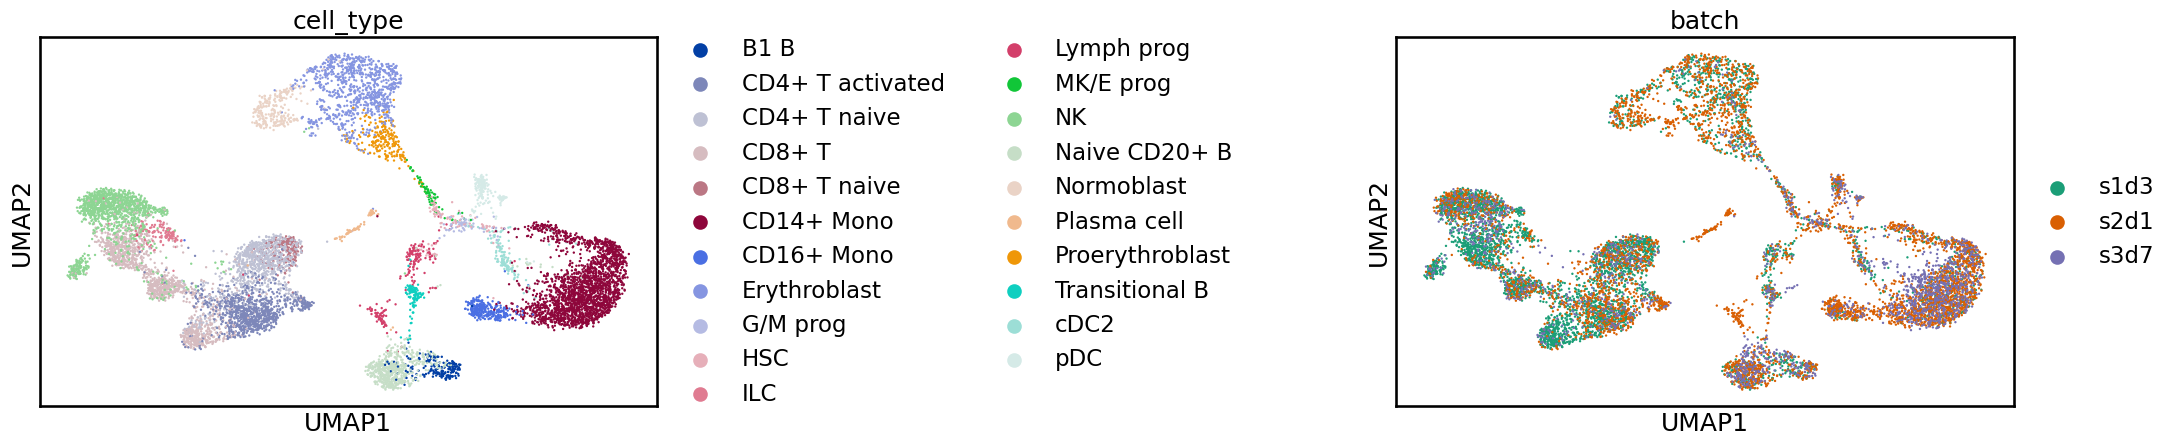
正如我们之前所见,批次混合在了一起,而标签彼此分开。仅凭 UMAP 来挑选某种整合方法是很有诱惑力的,但 UMAP 并不能完整反映整合的质量。在下一节中,我们会介绍一些更严格地评估整合方法的做法。
对你自己的整合进行基准测试
本章演示的方法依据基准测试结果选定,其中包括 scIB 项目 Luecken et al., 2021。该项目还开发了一个名为 scIB 的软件包,可用于运行一系列整合方法及相应的评估指标。本节将演示如何使用该软件包评估整合质量。
该 scIB 指标既可以单独运行,也可以通过封装函数一次运行多个指标。这里选取其中一部分计算较快的指标,并使用 metrics_fast() 函数。该函数需要几个参数:原始的未整合数据集、整合后的数据集、批次键和标签键。根据整合方法的输出,可能还需要提供额外参数;例如,这里为 scVI 和 scANVI 指定 embed 参数。你还可以通过额外参数控制某些指标的运行方式。另外请注意,可能需要检查对象的格式是否正确,以便 scIB 找到所需信息。
我们来为上面做过的每一种整合,以及未整合的数据(在高变基因选择之后),分别运行这些指标。
metrics_scvi = scib.metrics.metrics_fast(
    adata, adata_scvi, batch_key, label_key, embed="X_scVI"
)
metrics_scanvi = scib.metrics.metrics_fast(
    adata, adata_scanvi, batch_key, label_key, embed="X_scANVI"
)
metrics_bbknn = scib.metrics.metrics_fast(adata, adata_bbknn, batch_key, label_key)
metrics_seurat = scib.metrics.metrics_fast(adata, adata_seurat, batch_key, label_key)
metrics_hvg = scib.metrics.metrics_fast(adata, adata_hvg, batch_key, label_key)
输出
Silhouette score...
PC regression...
Isolated labels ASW...
Graph connectivity...
Silhouette score...
PC regression...
Isolated labels ASW...
Graph connectivity...
Silhouette score...
PC regression...
Isolated labels ASW...
Graph connectivity...
Silhouette score...
PC regression...
Isolated labels ASW...
Graph connectivity...
Silhouette score...
PC regression...
Isolated labels ASW...
Graph connectivity...
下面是其中一个指标在单次整合上的结果示例:
metrics_hvg每一行是一个不同的指标,数值表示该指标的得分。分数介于 0 到 1 之间,其中 1 表示表现良好、0 表示表现差(scIB 如有需要,也可以为某些指标返回未经缩放的分数)。由于我们这里只运行了那些计算很快的指标,因此有些指标的得分是 NaN 分数(即缺失值)。另外,有些指标无法用于某些输出格式,这也可能导致返回 NaN。
为了比较各种方法,把所有指标结果汇总到一张表里会很有用。下面这段代码会把它们合并起来,并整理成更便于查看的格式。
# Concatenate metrics results
metrics = pd.concat(
    [metrics_scvi, metrics_scanvi, metrics_bbknn, metrics_seurat, metrics_hvg],
    axis="columns",
)
# Set methods as column names
metrics = metrics.set_axis(
    ["scVI", "scANVI", "BBKNN", "Seurat", "Unintegrated"], axis="columns"
)
# Select only the fast metrics
metrics = metrics.loc[
    [
        "ASW_label",
        "ASW_label/batch",
        "PCR_batch",
        "isolated_label_silhouette",
        "graph_conn",
        "hvg_overlap",
    ],
    :,
]
# Transpose so that metrics are columns and methods are rows
metrics = metrics.T
# Remove the HVG overlap metric because it's not relevant to embedding outputs
metrics = metrics.drop(columns=["hvg_overlap"])
metrics现在我们把所有得分都放在了一张表里,指标作为列、方法作为行。给表格加上渐变配色,可以更容易地看出各分数之间的差异。
metrics.style.background_gradient(cmap="Blues")对于某些指标,分数往往落在一个相对较窄的范围内。为了突出方法之间的差异、并把每个指标放到同一标度上,我们对它们做缩放:让表现最差的得 0 分、表现最好的得 1 分,其余的则落在两者之间。
metrics_scaled = (metrics - metrics.min()) / (metrics.max() - metrics.min())
metrics_scaled.style.background_gradient(cmap="Blues")现在这些数值能更好地体现方法之间的差异(也与颜色标度更匹配)。不过需要注意的是,缩放后的分数只能用于比较这一组特定整合方法之间的相对表现。如果想再加入一种方法,就得重新做一次缩放。我们也不能断言某次整合一定“好”,只能说它比我们尝试过的其他方法更好。这种缩放会放大方法之间的差异。例如,如果某指标的原始得分是 0.92、0.94、0.96,缩放后就会变成 0、0.5、1.0。这会让第一种方法看起来差得多,尽管它其实只比另外两种略低,而且仍然是个很高的分数。当比较的方法数量较少、且它们的原始得分相近时,这种效应会更明显。你该看原始分数还是缩放后的分数,取决于你想关注的是绝对表现,还是方法之间的表现差异。
评估指标可以分为两类:衡量批次效应去除程度的指标,以及衡量生物学变异保留程度的指标。我们可以对每一类,取该组缩放值的平均,得到一个汇总分数。这种汇总分数若用原始数值来算就没有意义,因为有些指标的得分总是系统性地高于其他指标(因而会对平均值产生更大的影响)。
metrics_scaled["Batch"] = metrics_scaled[
    ["ASW_label/batch", "PCR_batch", "graph_conn"]
].mean(axis=1)
metrics_scaled["Bio"] = metrics_scaled[["ASW_label", "isolated_label_silhouette"]].mean(
    axis=1
)
metrics_scaled.style.background_gradient(cmap="Blues")把这两个汇总分数相互对照地画出来,可以看出每种方法各自的侧重点:有些方法偏向批次校正,而另一些则偏向保留生物学变异。
fig, ax = plt.subplots()
ax.set_xlim(0, 1)
ax.set_ylim(0, 1)
metrics_scaled.plot.scatter(
    x="Batch",
    y="Bio",
    c=range(len(metrics_scaled)),
    ax=ax,
)

for k, v in metrics_scaled[["Batch", "Bio"]].iterrows():
    ax.annotate(
        k,
        v,
        xytext=(6, -3),
        textcoords="offset points",
        family="sans-serif",
        fontsize=12,
    )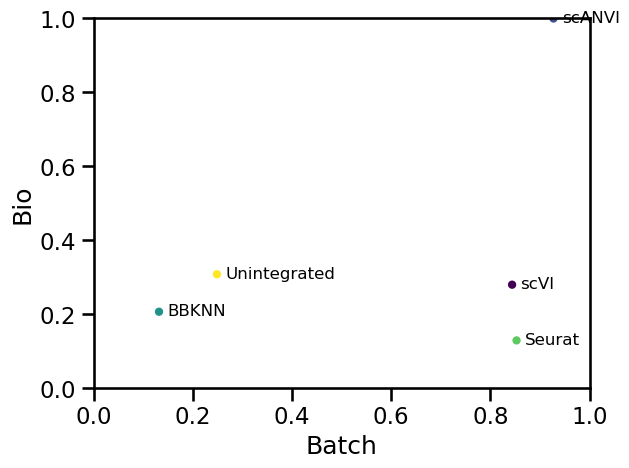
在我们这个小示例场景中,BBKNN 明显是表现最差的,在批次去除和生物学保留两方面都得分最低。另外三种方法的批次校正得分相近,其中 scANVI 在生物学保留方面得分最高,其次是 Seurat 和 scVI。
为了得到每种方法的总分,我们可以把这两个汇总分数结合起来。scIB 论文建议按 40% 批次校正、60% 生物学保留来加权,但你也可以根据自己数据集的侧重点采用不同的权重。
metrics_scaled["Overall"] = 0.4 * metrics_scaled["Batch"] + 0.6 * metrics_scaled["Bio"]
metrics_scaled.style.background_gradient(cmap="Blues")我们来快速画一张条形图,把整体表现可视化。
metrics_scaled.plot.bar(y="Overall")<Axes: >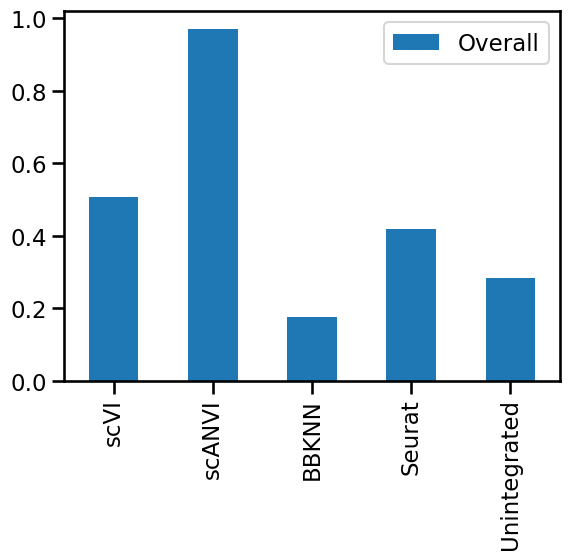
正如我们已经看到的,scANVI 表现最好,其次是 scVI 和 Seurat。必须指出的是,这只是一个示例,演示如何在这个特定数据集上运行这些指标,而不是对这些方法的正式评估。要做正式评估,你应当参考已有的基准测试论文。特别要说明的是,我们这里只运行了少数几种高性能方法和一部分指标。另外要记住,分数是相对于所用方法而言的,因此即便这些方法表现几乎一样好,细微的差异也会被放大。
已有的基准测试给出了一些总体表现良好的方法,但在不同场景下,性能也可能有相当大的波动。对于某些分析,自己对整合做一次评估也许是值得的。scIB 软件包让这个过程变得更容易,但它仍然可能是一项不小的工作,需要对真值(ground truth)有充分的了解,并能正确解读各项指标。
测验
会话信息
Python
import session_info

session_info.show()R
%%R
sessioninfo::session_info()
输出
─ Session info ───────────────────────────────────────────────────────────────
 setting  value
 version  R version 4.4.3 (2025-02-28)
 os       macOS 26.2
 system   x86_64, darwin13.4.0
 ui       unknown
 language (EN)
 collate  C.UTF-8
 ctype    C.UTF-8
 tz       Europe/Berlin
 date     2026-02-16
 pandoc   3.8.3 @ /Users/seohyon/miniconda3/envs/integration/bin/pandoc
 quarto   NA

─ Packages ───────────────────────────────────────────────────────────────────
 package              * version date (UTC) lib source
 abind                  1.4-8   2024-09-12 [1] CRAN (R 4.4.3)
 Biobase              * 2.66.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 BiocGenerics         * 0.52.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 cli                    3.6.5   2025-04-23 [1] CRAN (R 4.4.3)
 cluster                2.1.8.1 2025-03-12 [1] CRAN (R 4.4.3)
 codetools              0.2-20  2024-03-31 [1] CRAN (R 4.4.3)
 cowplot                1.2.0   2025-07-07 [1] CRAN (R 4.4.3)
 crayon                 1.5.3   2024-06-20 [1] CRAN (R 4.4.3)
 data.table             1.17.8  2025-07-10 [1] CRAN (R 4.4.3)
 DelayedArray           0.32.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 deldir                 2.0-4   2024-02-28 [1] CRAN (R 4.4.3)
 digest                 0.6.39  2025-11-19 [1] CRAN (R 4.4.3)
 dotCall64              1.2     2024-10-04 [1] CRAN (R 4.4.3)
 dplyr                  1.1.4   2023-11-17 [1] CRAN (R 4.4.3)
 farver                 2.1.2   2024-05-13 [1] CRAN (R 4.4.3)
 fastDummies            1.7.5   2025-01-20 [1] CRAN (R 4.4.3)
 fastmap                1.2.0   2024-05-15 [1] CRAN (R 4.4.3)
 fitdistrplus           1.2-4   2025-07-03 [1] CRAN (R 4.4.3)
 future               * 1.68.0  2025-11-17 [1] CRAN (R 4.4.3)
 future.apply           1.20.1  2025-12-09 [1] CRAN (R 4.4.3)
 generics               0.1.4   2025-05-09 [1] CRAN (R 4.4.3)
 GenomeInfoDb         * 1.42.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 GenomeInfoDbData       1.2.13  2026-01-09 [1] Bioconductor
 GenomicRanges        * 1.58.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 ggplot2                4.0.1   2025-11-14 [1] CRAN (R 4.4.3)
 ggrepel                0.9.6   2024-09-07 [1] CRAN (R 4.4.3)
 ggridges               0.5.7   2025-08-27 [1] CRAN (R 4.4.3)
 globals                0.18.0  2025-05-08 [1] CRAN (R 4.4.3)
 glue                   1.8.0   2024-09-30 [1] CRAN (R 4.4.3)
 goftest                1.2-3   2021-10-07 [1] CRAN (R 4.4.3)
 gridExtra              2.3     2017-09-09 [1] CRAN (R 4.4.3)
 gtable                 0.3.6   2024-10-25 [1] CRAN (R 4.4.3)
 htmltools              0.5.9   2025-12-04 [1] CRAN (R 4.4.3)
 htmlwidgets            1.6.4   2023-12-06 [1] CRAN (R 4.4.3)
 httpuv                 1.6.16  2025-04-16 [1] CRAN (R 4.4.3)
 httr                   1.4.7   2023-08-15 [1] CRAN (R 4.4.3)
 ica                    1.0-3   2022-07-08 [1] CRAN (R 4.4.3)
 igraph                 2.1.4   2025-01-23 [1] CRAN (R 4.4.3)
 IRanges              * 2.40.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 irlba                  2.3.5.1 2022-10-03 [1] CRAN (R 4.4.3)
 jsonlite               2.0.0   2025-03-27 [1] CRAN (R 4.4.3)
 KernSmooth             2.23-26 2025-01-01 [1] CRAN (R 4.4.3)
 later                  1.4.5   2026-01-08 [1] CRAN (R 4.4.3)
 lattice                0.22-7  2025-04-02 [1] CRAN (R 4.4.3)
 lazyeval               0.2.2   2019-03-15 [1] CRAN (R 4.4.3)
 lifecycle              1.0.5   2026-01-08 [1] CRAN (R 4.4.3)
 listenv                0.10.0  2025-11-02 [1] CRAN (R 4.4.3)
 lmtest                 0.9-40  2022-03-21 [1] CRAN (R 4.4.3)
 magrittr               2.0.4   2025-09-12 [1] CRAN (R 4.4.3)
 MASS                   7.3-65  2025-02-28 [1] CRAN (R 4.4.3)
 Matrix               * 1.7-4   2025-08-28 [1] CRAN (R 4.4.3)
 MatrixGenerics       * 1.18.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 matrixStats          * 1.5.0   2025-01-07 [1] CRAN (R 4.4.3)
 mime                   0.13    2025-03-17 [1] CRAN (R 4.4.3)
 miniUI                 0.1.2   2025-04-17 [1] CRAN (R 4.4.3)
 nlme                   3.1-168 2025-03-31 [1] CRAN (R 4.4.3)
 otel                   0.2.0   2025-08-29 [1] CRAN (R 4.4.3)
 parallelly             1.46.1  2026-01-08 [1] CRAN (R 4.4.3)
 patchwork              1.3.2   2025-08-25 [1] CRAN (R 4.4.3)
 pbapply                1.7-4   2025-07-20 [1] CRAN (R 4.4.3)
 pillar                 1.11.1  2025-09-17 [1] CRAN (R 4.4.3)
 pkgconfig              2.0.3   2019-09-22 [1] CRAN (R 4.4.3)
 plotly                 4.11.0  2025-06-19 [1] CRAN (R 4.4.3)
 plyr                   1.8.9   2023-10-02 [1] CRAN (R 4.4.3)
 png                    0.1-8   2022-11-29 [1] CRAN (R 4.4.3)
 polyclip               1.10-7  2024-07-23 [1] CRAN (R 4.4.3)
 progressr              0.18.0  2025-11-06 [1] CRAN (R 4.4.3)
 promises               1.5.0   2025-11-01 [1] CRAN (R 4.4.3)
 purrr                  1.2.0   2025-11-04 [1] CRAN (R 4.4.3)
 R6                     2.6.1   2025-02-15 [1] CRAN (R 4.4.3)
 RANN                   2.6.2   2024-08-25 [1] CRAN (R 4.4.3)
 RColorBrewer           1.1-3   2022-04-03 [1] CRAN (R 4.4.3)
 Rcpp                   1.1.0   2025-07-02 [1] CRAN (R 4.4.3)
 RcppAnnoy              0.0.22  2024-01-23 [1] CRAN (R 4.4.3)
 RcppHNSW               0.6.0   2024-02-04 [1] CRAN (R 4.4.3)
 reshape2               1.4.5   2025-11-12 [1] CRAN (R 4.4.3)
 reticulate             1.44.1  2025-11-14 [1] CRAN (R 4.4.3)
 rlang                  1.1.6   2025-04-11 [1] CRAN (R 4.4.3)
 ROCR                   1.0-11  2020-05-02 [1] CRAN (R 4.4.3)
 RSpectra               0.16-2  2024-07-18 [1] CRAN (R 4.4.3)
 Rtsne                  0.17    2023-12-07 [1] CRAN (R 4.4.3)
 S4Arrays               1.6.0   2024-10-29 [1] Bioconductor 3.20 (R 4.4.3)
 S4Vectors            * 0.44.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 S7                     0.2.1   2025-11-14 [1] CRAN (R 4.4.3)
 scales                 1.4.0   2025-04-24 [1] CRAN (R 4.4.3)
 scattermore            1.2     2023-06-12 [1] CRAN (R 4.4.3)
 sctransform            0.4.2   2025-04-30 [1] CRAN (R 4.4.3)
 sessioninfo            1.2.3   2025-02-05 [1] CRAN (R 4.4.3)
 Seurat               * 5.4.0   2025-12-14 [1] CRAN (R 4.4.3)
 SeuratObject         * 5.3.0   2025-12-12 [1] CRAN (R 4.4.3)
 shiny                  1.12.1  2025-12-09 [1] CRAN (R 4.4.3)
 SingleCellExperiment * 1.28.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 sp                   * 2.2-0   2025-02-01 [1] CRAN (R 4.4.3)
 spam                   2.11-3  2026-01-08 [1] CRAN (R 4.4.3)
 SparseArray            1.6.0   2024-10-29 [1] Bioconductor 3.20 (R 4.4.3)
 spatstat.data          3.1-9   2025-10-18 [1] CRAN (R 4.4.3)
 spatstat.explore       3.6-0   2025-11-22 [1] CRAN (R 4.4.3)
 spatstat.geom          3.6-1   2025-11-20 [1] CRAN (R 4.4.3)
 spatstat.random        3.4-3   2025-11-21 [1] CRAN (R 4.4.3)
 spatstat.sparse        3.1-0   2024-06-21 [1] CRAN (R 4.4.3)
 spatstat.univar        3.1-5   2025-11-17 [1] CRAN (R 4.4.3)
 spatstat.utils         3.2-0   2025-09-20 [1] CRAN (R 4.4.3)
 stringi                1.8.7   2025-03-27 [1] CRAN (R 4.4.3)
 stringr                1.6.0   2025-11-04 [1] CRAN (R 4.4.3)
 SummarizedExperiment * 1.36.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 survival               3.8-3   2024-12-17 [1] CRAN (R 4.4.3)
 tensor                 1.5.1   2025-06-17 [1] CRAN (R 4.4.3)
 tibble                 3.3.0   2025-06-08 [1] CRAN (R 4.4.3)
 tidyr                  1.3.2   2025-12-19 [1] CRAN (R 4.4.3)
 tidyselect             1.2.1   2024-03-11 [1] CRAN (R 4.4.3)
 UCSC.utils             1.2.0   2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 uwot                   0.2.4   2025-11-10 [1] CRAN (R 4.4.3)
 vctrs                  0.6.5   2023-12-01 [1] CRAN (R 4.4.3)
 viridisLite            0.4.2   2023-05-02 [1] CRAN (R 4.4.3)
 xtable                 1.8-4   2019-04-21 [1] CRAN (R 4.4.3)
 XVector                0.46.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 zlibbioc               1.52.0  2024-10-29 [1] Bioconductor 3.20 (R 4.4.2)
 zoo                    1.8-15  2025-12-15 [1] CRAN (R 4.4.3)

 [1] /Users/seohyon/miniconda3/envs/integration/lib/R/library
 * ── Packages attached to the search path.

──────────────────────────────────────────────────────────────────────────────
- van den Brink, S. C., Sage, F., Vértesy, Á., Spanjaard, B., Peterson-Maduro, J., Baron, C. S., Robin, C., & van Oudenaarden, A. (2017). Single-cell sequencing reveals dissociation-induced gene expression in tissue subpopulations. Nature Methods, 14(10), 935–936. 10.1038/nmeth.4437
- Luecken, M. D., Büttner, M., Chaichoompu, K., Danese, A., Interlandi, M., Mueller, M. F., Strobl, D. C., Zappia, L., Dugas, M., Colomé-Tatché, M., & Theis, F. J. (2021). Benchmarking atlas-level data integration in single-cell genomics. Nature Methods. 10.1038/s41592-021-01336-8
- Muus, C., Luecken, M. D., Eraslan, G., Sikkema, L., Waghray, A., Heimberg, G., Kobayashi, Y., Vaishnav, E. D., Subramanian, A., Smillie, C., Jagadeesh, K. A., Duong, E. T., Fiskin, E., Torlai Triglia, E., Ansari, M., Cai, P., Lin, B., Buchanan, J., Chen, S., … Human Cell Atlas Lung Biological Network. (2021). Single-cell meta-analysis of SARS-CoV-2 entry genes across tissues and demographics. Nature Medicine, 27(3), 546–559. 10.1038/s41591-020-01227-z
- Sikkema, L., Strobl, D. C., Zappia, L., Madissoon, E., Markov, N. S., Zaragosi, L.-E., Ansari, M., Arguel, M.-J., Apperloo, L., Becavin, C., Berg, M., Chichelnitskiy, E., Chung, M.-I., Collin, A., Gay, A. C. A., Kashani, B. H., Jain, M., Kapellos, T., Kole, T. M., … Theis, F. J. (2022). An integrated cell atlas of the human lung in health and disease. bioRxiv, 2022.03.10.483747. 10.1101/2022.03.10.483747
- Johnson, W. E., Li, C., & Rabinovic, A. (2007). Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics, 8(1), 118–127. 10.1093/biostatistics/kxj037
- Haghverdi, L., Lun, A. T. L., Morgan, M. D., & Marioni, J. C. (2018). Batch effects in single-cell RNA-sequencing data are corrected by matching mutual nearest neighbors. Nature Biotechnology. 10.1038/nbt.4091
- Butler, A., Hoffman, P., Smibert, P., Papalexi, E., & Satija, R. (2018). Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nature Biotechnology. 10.1038/nbt.4096
- Stuart, T., Butler, A., Hoffman, P., Hafemeister, C., Papalexi, E., Mauck, W. M., 3rd, Hao, Y., Stoeckius, M., Smibert, P., & Satija, R. (2019). Comprehensive Integration of Single-Cell Data. Cell, 177(7), 1888-1902.e21. 10.1016/j.cell.2019.05.031
- Hie, B., Bryson, B., & Berger, B. (2019). Efficient integration of heterogeneous single-cell transcriptomes using Scanorama. Nature Biotechnology. 10.1038/s41587-019-0113-3
- Korsunsky, I., Millard, N., Fan, J., Slowikowski, K., Zhang, F., Wei, K., Baglaenko, Y., Brenner, M., Loh, P.-R., & Raychaudhuri, S. (2019). Fast, sensitive and accurate integration of single-cell data with Harmony. Nature Methods. 10.1038/s41592-019-0619-0
- Polański, K., Park, J.-E., Young, M. D., Miao, Z., Meyer, K. B., & Teichmann, S. A. (2019). BBKNN: Fast Batch Alignment of Single Cell Transcriptomes. Bioinformatics. 10.1093/bioinformatics/btz625
- Lopez, R., Regier, J., Cole, M. B., Jordan, M. I., & Yosef, N. (2018). Deep generative modeling for single-cell transcriptomics. Nature Methods, 15(12), 1053–1058. 10.1038/s41592-018-0229-2
- Xu, C., Lopez, R., Mehlman, E., Regier, J., Jordan, M. I., & Yosef, N. (2021). Probabilistic harmonization and annotation of single-cell transcriptomics data with deep generative models. Molecular Systems Biology, 17(1), e9620. 10.15252/msb.20209620
- Lotfollahi, M., Wolf, F. A., & Theis, F. J. (2019). scGen predicts single-cell perturbation responses. Nature Methods, 16(8), 715–721. 10.1038/s41592-019-0494-8
- Argelaguet, R., Cuomo, A. S. E., Stegle, O., & Marioni, J. C. (2021). Computational principles and challenges in single-cell data integration. Nature Biotechnology, 1–14. 10.1038/s41587-021-00895-7